Stable Diffusion XL (SDXL) 模型训练指南及与SD1.5的差异
本文详解 SDXL 与 SD1.5 在架构、分辨率及文本编码上的核心差异,提供从数据集整理、显存优化到训练验证的完整实操指南,帮助用户避免常见误区,高效完成风格或角色微调。
训练 SDXL 时最常见的误区,是直接套用 SD1.5 的参数配置:仍按 512 像素准备图片,结果导致显存迅速耗尽,且生成的风格极不稳定。需明确一点:SDXL 并非仅仅是“放大版”的 SD1.5,其文本条件与图像尺寸条件均发生了根本变化,因此数据整理与显存规划必须同步调整。
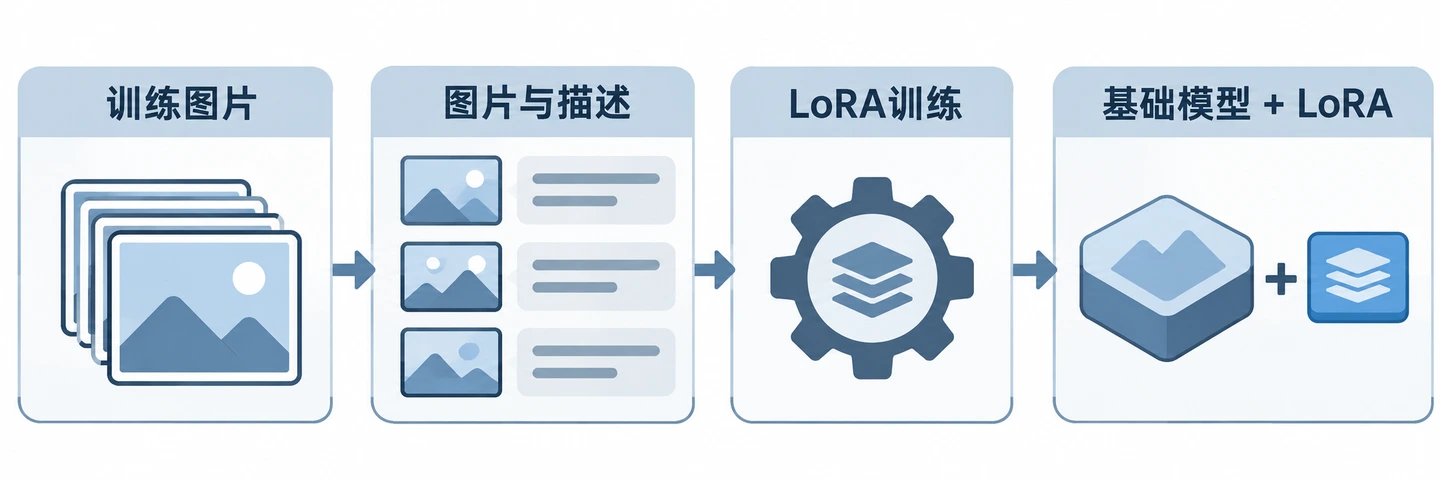
在进行个人风格或角色微调时,建议优先选择 LoRA 方案;仅当需要大幅改变模型基础能力时,才考虑全量微调。接下来,我们将从底模差异、数据集构建到训练策略,系统梳理 SDXL 的关键变化点。
SDXL 和 SD1.5,差别不止在分辨率
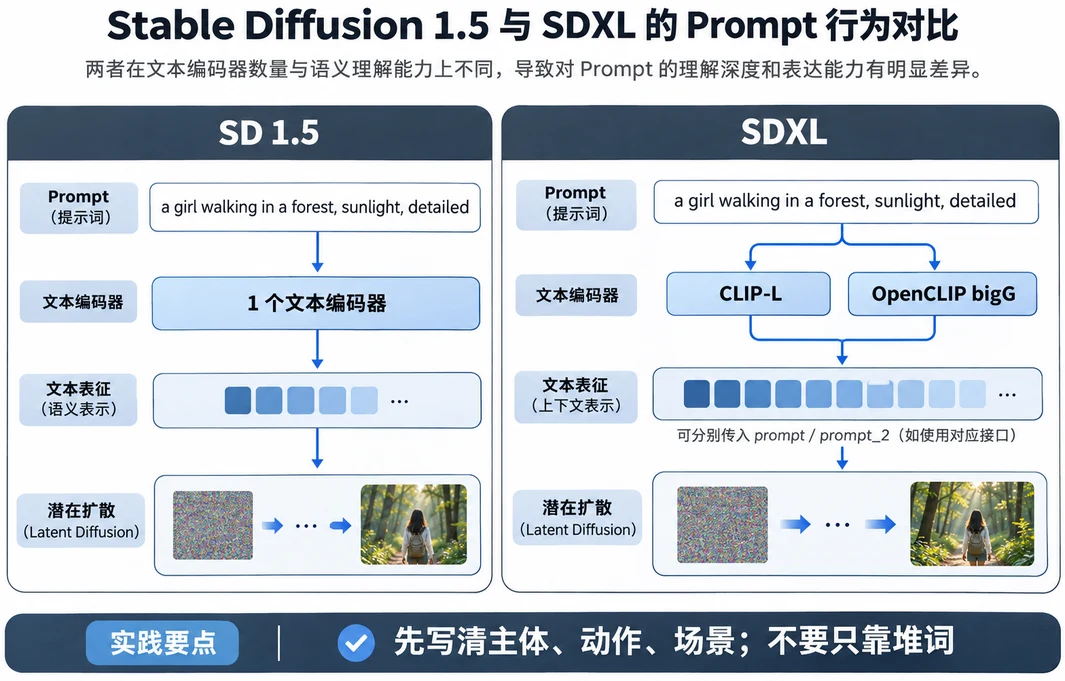
SDXL 1.0 基础模型面向约 1024 像素级的生成任务,其 U-Net 主干规模约为前代的三倍,并引入了第二个文本编码器。在训练和推理阶段,文本条件不再单一依赖某套编码器,模型还需接收原始图像尺寸、裁切位置及目标尺寸等微条件。因此,SD1.5 时代常见的 512 像素训练习惯,不能直接作为 SDXL 的默认标准。
这并不意味着每张训练图都必须强制裁剪为 1024×1024 的正方形。若数据集中包含横图、竖图和方图,强行正方裁剪容易丢失主体信息;建议根据目标训练器支持的分辨率桶(Resolution Buckets)进行整理,将长宽比相近的图片归为同一批次,并保留训练配置所需的尺寸与裁切信息。具体的桶尺寸取决于训练脚本和显存限制,切勿将特定配置误认为模型的硬性规格。
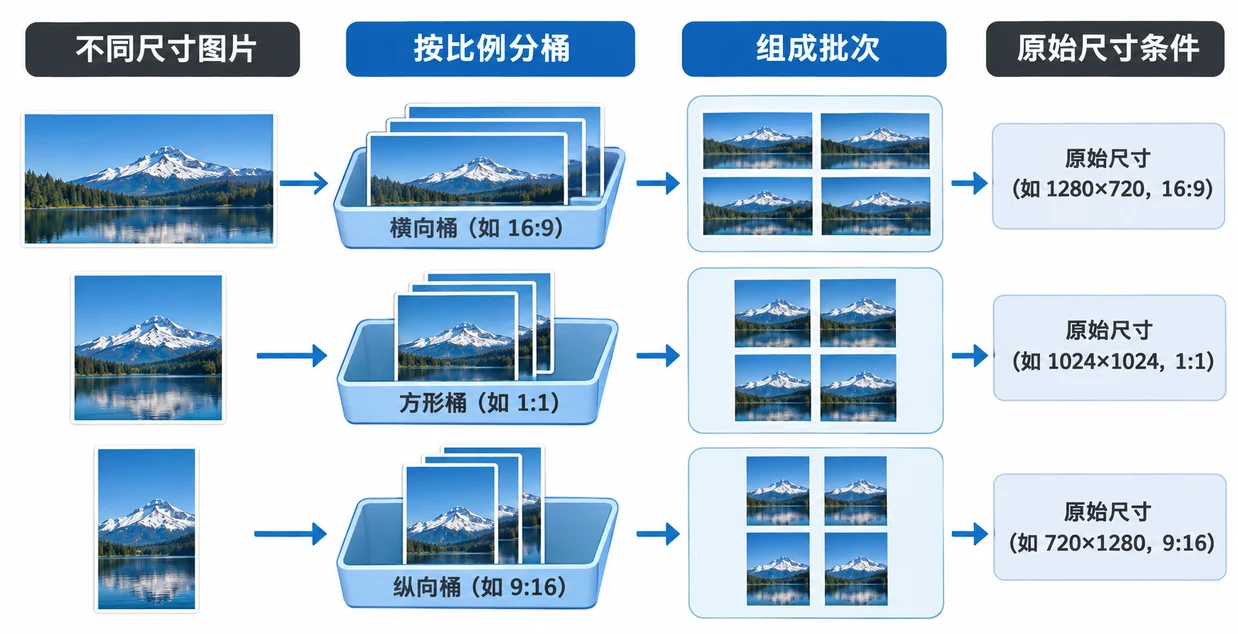
不同长宽比图片按桶整理为训练批次
先把图片和标注整理好
微调效果首要取决于数据集质量。应挑选主体清晰、风格统一且无大量近似重复的图片;特别是在训练角色或画风时,需严格检查图片中是否混入了服装、背景或画法等冲突特征。当数据量较少时,简单重复图片并不能增加有效信息,反而可能导致模型过度记忆背景或构图细节。
标注内容应紧密围绕训练目标展开。准确描述主体、服装、画面风格或需保留的场景特征,并确保词汇在不同图片间保持一致;若使用触发词,需确认训练工具能将其正确纳入文本输入。SDXL 的双文本编码器由模型架构和训练脚本自动处理,通常无需手动为同一张图片编写两份无关说明。开始训练前,务必确认所用工具已正确加载 SDXL 底模及其对应组件,避免混入 SD1.5 的模型文件或配置。
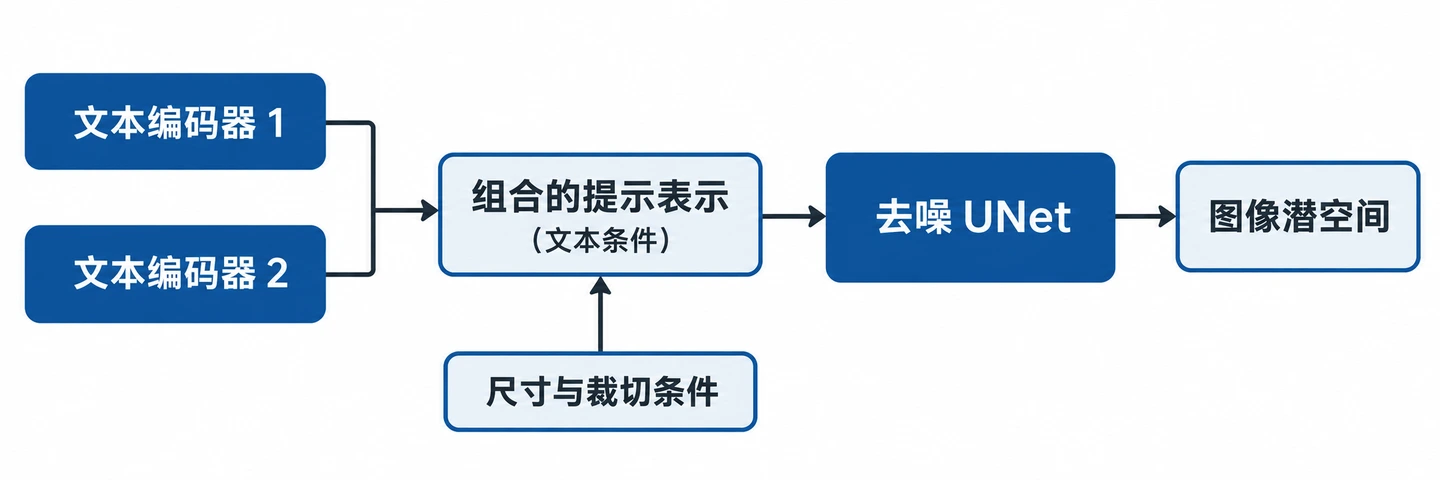
SDXL的文本编码与尺寸条件
显存紧张时先缩小训练负担
由于 SDXL 的网络结构和图像潜变量更为庞大,提升分辨率、增大批次或增加可训练模块都会显著增加显存需求。建议先从 LoRA 和较小的单卡批次起步,再根据训练器支持情况,尝试梯度检查点、混合精度、梯度累积或高效注意力机制。这些选项在速度、数值稳定性和显存占用上各有取舍,并非所有显卡都能适用同一组合。需注意,梯度累积虽能模拟更大的有效批次,但不会降低单步计算本身的负载。
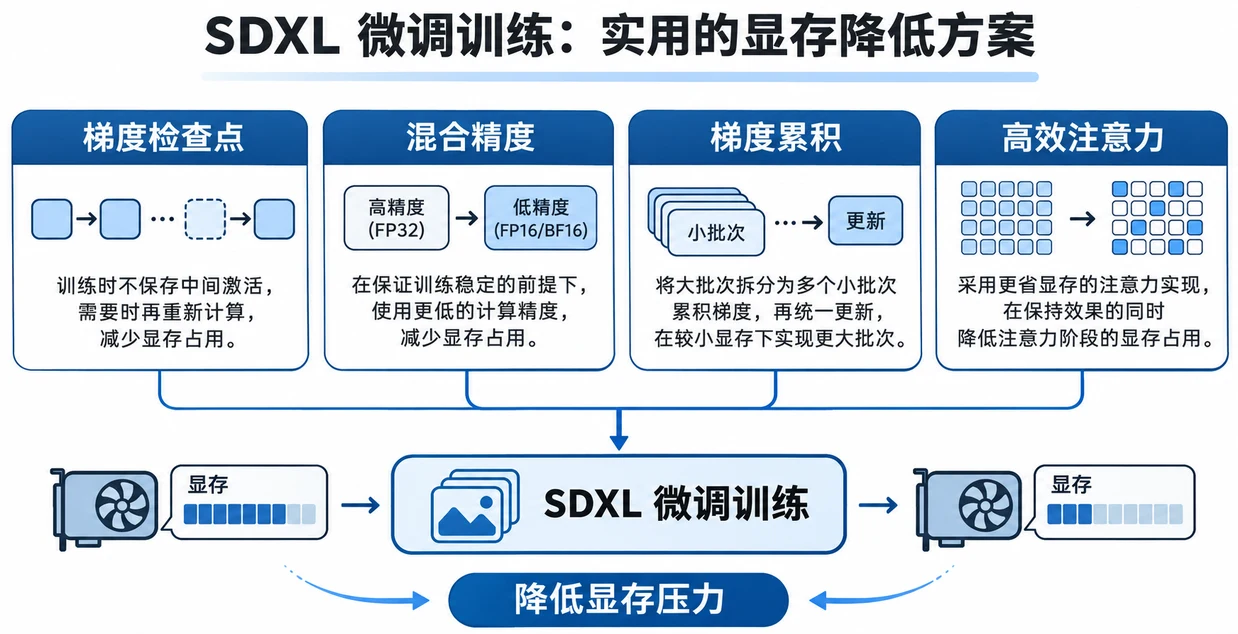
常见的SDXL训练显存优化思路
相比仅训练 LoRA,全量微调、训练文本编码器或同时训练多个模块会消耗更多资源;是否启用这些功能应由具体目标和工具配置决定。若显存不足,应优先降低单步批次大小、减少同时训练的模块数量,再评估分辨率或缓存设置。切记,“能启动训练”不等于“配置合适”,训练过程中需密切监控损失值是否异常,并定期使用固定提示词和采样设置检查输出效果。
用固定样例判断是否训对
准备一组覆盖目标主体、风格及常见场景的验证提示词,在训练前后使用相同设置生成对比图。若模型仅能复现训练图中的特定姿势或背景,通常需回头检查数据重复度、标注质量及训练时长;若触发词表现不稳定,则应先确认其已正确写入 caption,并检查训练器的文本处理逻辑。
从 SD1.5 迁移至 SDXL 的实用路径为:选定正确底模,整理适配的分辨率桶与标注,从轻量级微调入手,最后通过固定提示词观察变化。建议在每一步仅调整少数参数,通过对比明确各项改动对最终结果的具体影响。
通义灵码插件自定义提示词(Prompt)编写指南
2026-11-07 22:21:56
DeepSeek和ChatGPT核心区别:技术架构与模型能力对比
2026-11-07 21:39:54
Gemini深度研究实战:怎么用AI完成文献综述与市场分析报告
2026-11-07 21:24:33
Kimi辅助创意写作:怎么让它保持角色设定与风格统一
2026-11-07 20:22:31
Kimi长文档写作实战:上传资料后怎么提取信息并整合成文
2026-11-07 19:19:44