Stable Diffusion模型训练入门:硬件门槛与数据准备指南
本文旨在为初学者提供Stable Diffusion模型训练的入门指导,重点解析LoRA轻量微调的优势、硬件配置的灵活评估方法以及高质量数据集的准备规范。通过明确训练目标、优化数据标注和规划文件结构,帮助读者在有限资源下高效启动训练实验,避免盲目追求高配硬件或海量数据。
初涉 Stable Diffusion 模型训练时,建议先将目标聚焦于单一具体概念,并搜集一组具有代表性的图片,同时优先探索 LoRA 等轻量级微调方案。这种策略有助于更清晰地理解数据质量、训练参数与生成效果之间的关联。关于硬件门槛,并不存在放之四海而皆准的固定数值,因为显存占用受底模版本、训练算法、图像分辨率、批次大小及精度设置等多重因素影响。因此,比起盲目升级硬件,更明智的做法是先明确训练对象与所选工具,再依据官方文档核对具体配置要求。
先分清训练目标和训练方式
“模型训练”这一概念既包含对基础模型的全量微调,也涵盖在既有底模上训练 LoRA 等适配器的过程。对于初学者而言,LoRA 通常是更理想的起点:它仅学习一组额外的参数权重,在推理阶段与底模结合使用,不仅便于独立保存和切换,也利于对比不同版本的效果。相比之下,全量微调涉及庞大的参数量与存储空间,流程更为复杂;若目标仅是让模型掌握特定角色、物品或视觉风格,优先研究 LoRA 显然更具实操性。
建议先用简练的语言定义训练目标,例如“使模型识别某款特定花瓶”,随后审视图片素材是否足以支撑该目标。若训练集中混杂了多种主体、画风或拍摄条件,模型学到的特征将难以聚焦。目标定义越清晰,后续在筛选图片和编写描述时的判断标准就越明确,从而提升训练效率。
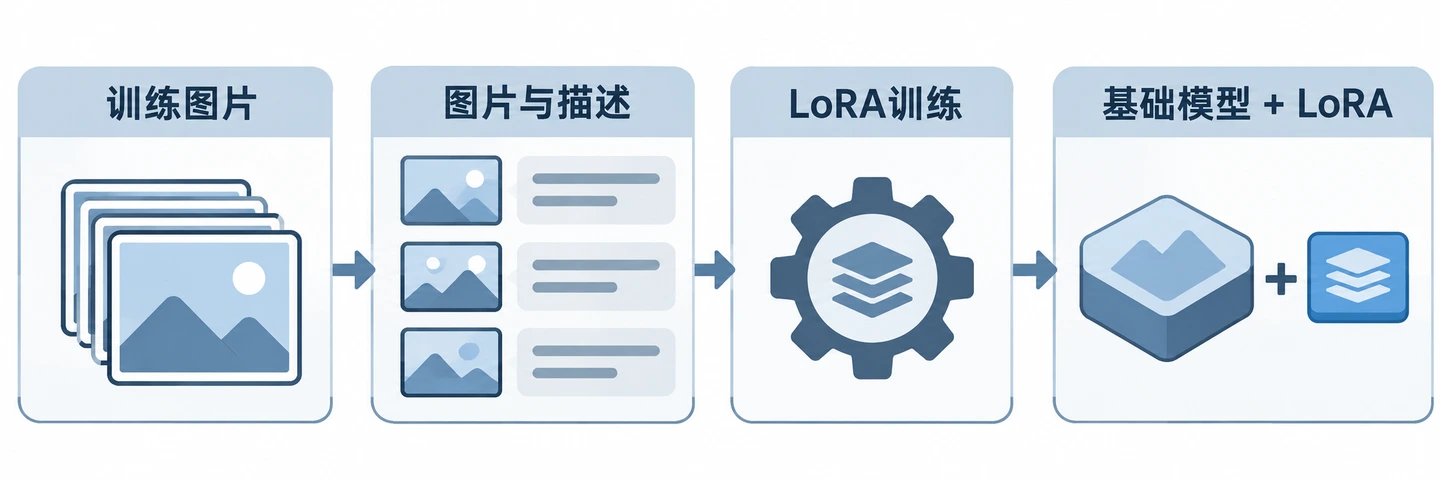
LoRA训练流程:适配器与基础模型配合使用。
硬件门槛要结合具体配置看
训练过程主要受限于显存、系统内存、存储容量及时间成本,其中显存往往是最先触及的瓶颈。通常情况下,底模体积越大、训练分辨率越高、单次处理样本越多,对显存的需求就越高;而混合精度训练、梯度累积及内存优化等技术手段也会显著影响资源占用与运行速度。因此,断言“某款显卡必然能跑”或“必须达到某固定显存值”均具误导性,实际可行性需结合具体的训练器、底模类型及参数配置综合评估。
在启动训练前,务必仔细阅读工具文档中关于操作系统、显卡驱动环境、显存需求及依赖库的说明。若本地硬件受限,可考虑使用可靠的云端 GPU 服务,但需综合考量数据上传耗时、磁盘租赁费、运行时长及结果下载成本。无论选择本地还是云端,都应预留充足的磁盘空间以存放训练素材、底模文件、缓存数据、检查点及最终生成的适配器。初次尝试建议采用保守配置,确保环境能正常启动并保存结果后,再逐步调整参数,切勿将网络教程中的特定配置视为通用标准。
数据集质量比盲目增加数量重要
训练图片应紧密围绕同一目标,同时保持适度的多样性。若训练特定物体,可在合理范围内变换主体的角度、距离、背景及光照条件;若所有图片构图过于雷同,模型可能仅记住画面布局而非物体特征。反之,若图片主题差异过大,则会导致目标特征模糊。整理数据集时,应先剔除重复、严重模糊、主体遮挡过多或与目标无关的图片,并确保拥有素材的合法使用权。
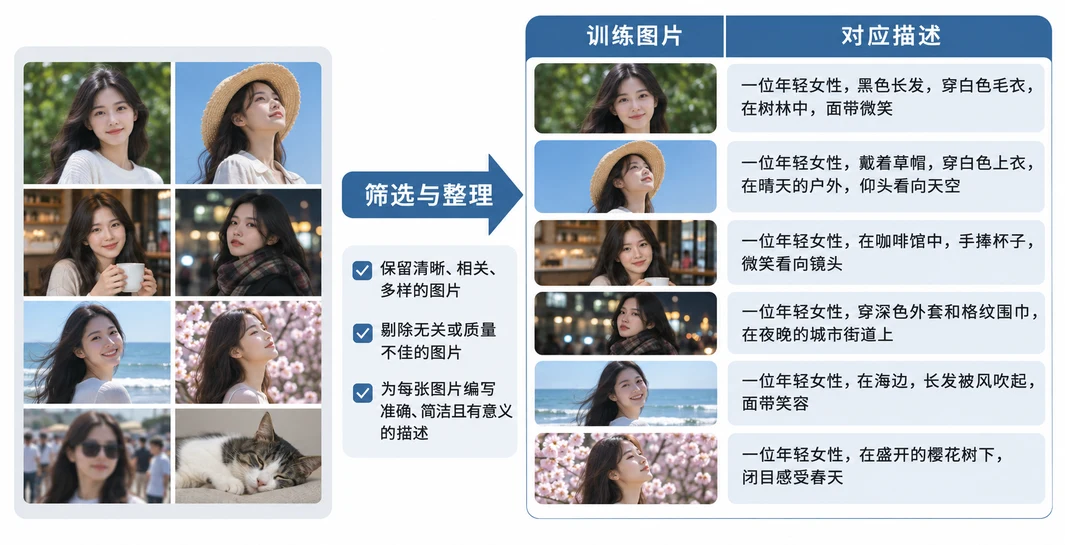
先筛选图片,再逐张核对描述是否匹配。
图像描述的核心作用是协助训练器区分“需学习的核心概念”与“图片中偶然变化的背景信息”。描述内容可涵盖主体特征、场景元素、视角或光线等,具体细节取决于所用训练工具及标注规范。关键在于保持整批数据标注风格的一致性,避免部分图片仅标注主体,而另一部分却详细描述无关背景。建议先抽样检查图文对应关系,确立统一的标注规则后再进行批量处理,发现不一致时及时修正。
文件和输出也要提前规划
训练前应建立清晰的目录结构,将原始图片、清洗后的训练集、描述文件、底模路径及输出结果分类存放。这不仅有助于防止误用临时文件作为训练数据,也便于后续重新运行实验。不同训练器对文件命名、描述格式及目录层级可能有特定要求,请严格遵循当前工具的文档指引,勿将其他教程的路径规范生搬硬套。
保存检查点时,务必记录其对应的数据版本及关键配置参数。每次调整数据或重要参数后,应使用独立的输出目录或文件名,以防覆盖既往成果。在初始训练阶段,建议每次仅调整少量变量,以便准确归因结果的变化来源。
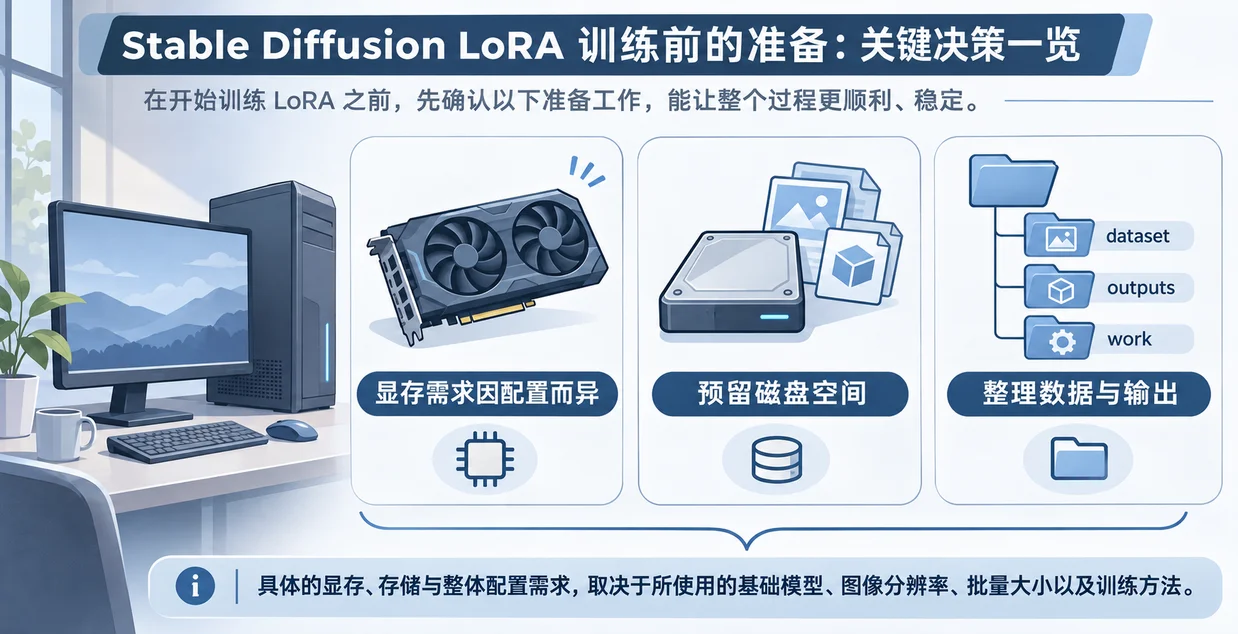
硬件资源和工作目录都应按所用训练配置规划。
什么时候不必从 LoRA 开始
若研究重点在于训练器底层机制、模型架构改进,或需大幅改变模型行为,LoRA 可能无法满足需求,此时需深入探索全量微调或其他高级训练方法。这类任务通常对工程经验、计算资源及实验管理能力有更高要求。反之,若仅需通过提示词生成多样化画面,或许无需训练;优先尝试现有模型、提示词工程及社区已有的适配器,能更高效地判断训练必要性。
从小实验开始形成判断
合理的入门路径为:明确单一目标,选定底模与训练工具,核验硬件与依赖环境,清洗图片并统一标注,最后通过小规模配置验证全流程。若结果未达预期,应优先排查数据一致性与描述准确性,再考虑调整训练参数。需注意,训练成功启动并不等同于模型已掌握预期内容,最终效果仍需通过固定的一组提示词进行生成测试来评估。
判断是否具备启动训练的条件,可考察三点:是否拥有权属清晰且具代表性的目标数据,工具文档是否确认本地或云端资源可用,以及能否完整保存并复现训练配置。若条件完备,再逐步扩大实验规模;否则,补充数据或熟悉工具比盲目追求高端显卡更为有效。
Three.js 添加光照后模型全黑或阴影不显示的原因
2026-11-05 23:45:06
利用Web Speech API的speechSynthesis实现前端文字转语音
2026-10-31 14:02:39
JavaScript TwoQueues 缓存模型实现与使用
2026-10-28 18:52:23
Three.js光照系统源码解析:Light、AmbientLight与DirectionalLight等核心类详解
2026-10-26 22:43:13
D3.js力导向图绘制详解:五种核心力模型与仿真控制
2026-10-25 23:34:28