Kimi长文档写作实战:上传资料后怎么提取信息并整合成文
本文介绍利用Kimi辅助长篇写作的实战流程,涵盖资料分组、分轮提取关键信息及人工核对等步骤,旨在提高写作效率并确保内容准确性。
长文档写作中最耗精力的环节,往往并非文字录入,而是在海量资料中反复检索特定信息:访谈细节为何、产品文档是否阐明限制、不同材料间是否存在矛盾。若将整套文件直接丢给 AI 并要求其生成文章,看似便捷,实则极易导致信息混杂,难以理清脉络。
更为稳妥的策略是让 Kimi 先扮演资料整理员,再转为写作助手。遵循“先分组、再提取、后整合”的步骤,确保每个环节都有据可查;这不仅能提升写作速度,更能将最终判断权保留在人类手中。
先把资料分组,别急着让它写全文
假设你需要撰写一篇产品体验或行业分析,手头拥有访谈记录、产品资料、用户反馈及零散网页内容。首先应按来源或用途对文件进行分类,并命名为易于识别的名称。例如,访谈记录对应“用户痛点”,产品资料对应“官方功能”,反馈材料对应“实际争议”。这一步骤虽基础,却能有效避免将宣传话术误作用户体验,或将个别观点当作普遍结论。
Kimi 官方帮助文档明确支持上传既有文档进行整理、编辑与改写。实际操作中,应仅选择当前任务必需的材料,并用简练语言说明写作目标、受众及输出范围。若素材杂乱,建议按主题分批处理;需注意,上传及输入能力受限于产品当前支持格式及账号权限,遇到不兼容格式时,应先转换为可用文档或摘录关键段落,切勿预设所有文件均可被直接解析。
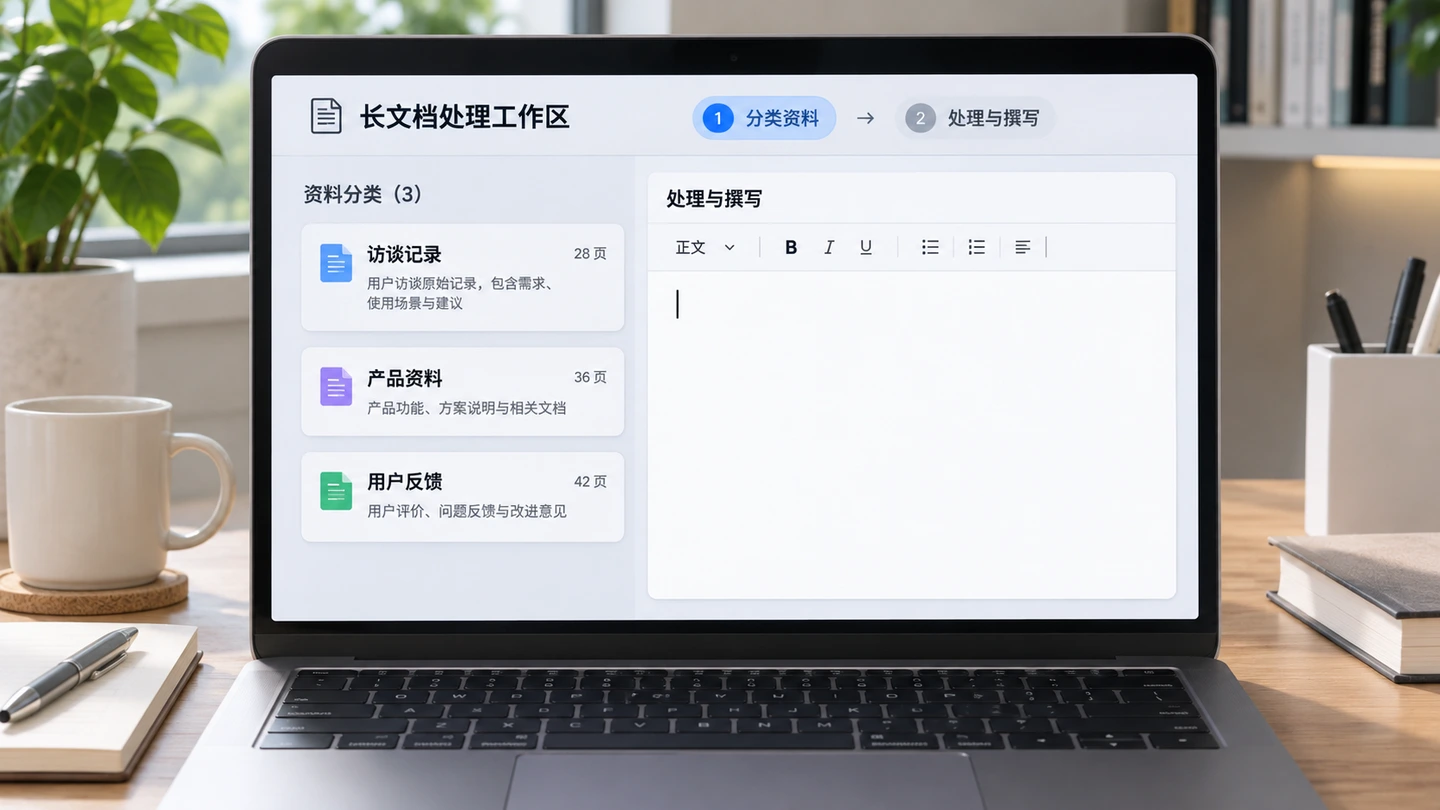
先按来源和用途分组,降低材料混淆。
分轮提取信息,让结论带着出处
资料导入对话后,切勿直接下达“撰写全文”的指令。首轮交互仅做信息盘点:要求 AI 按主题梳理核心观点、关键事实、出处来源以及需人工确认的疑点。第二轮则聚焦于挖掘不同材料间的共性与矛盾,并严格区分推断与原文事实。此举的价值在于,能在文章成型前发现证据缺失,避免成稿后因缺乏支撑而返工。
提示词应力求具体,例如:“请仅依据已提供材料,分别整理用户需求、产品既定能力及用户反馈中的高频问题。每项内容需标注来源材料;若材料未提及,请注明‘未提及’,严禁自行猜测。”若需对比两组资料,可要求逐条并列呈现,避免 AI 提前判定优劣。
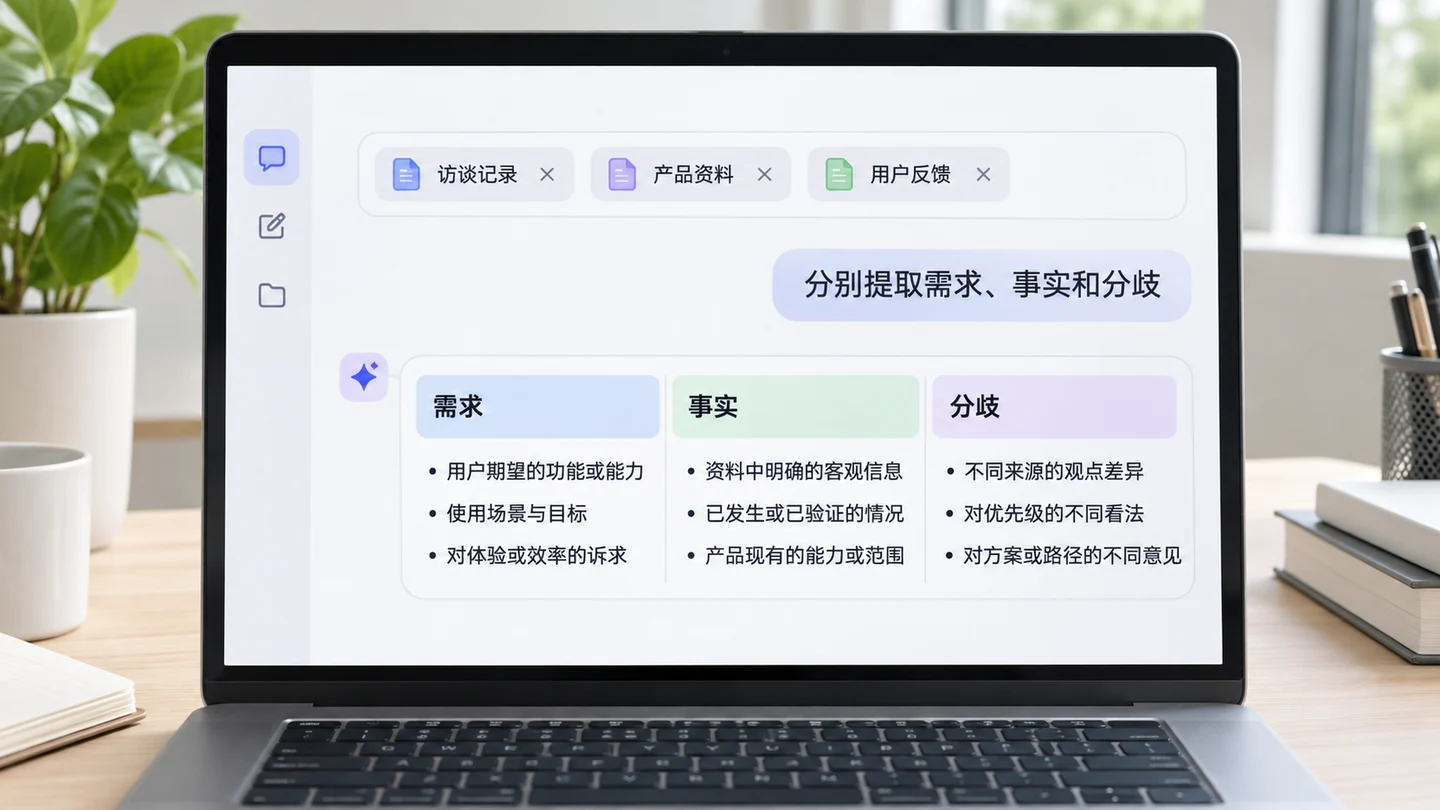
分轮提取,并把事实和分歧分别列出。
需警惕的是,模型生成的摘要属于二次加工成果。对于数字、专有名词、因果逻辑及带有评价色彩的表述,务必回归原文核对。特别是当多份资料说法不一时,应保留差异并分析其成因(如时间、对象或统计口径不同),而非让模型强行抹平冲突。
先搭文章骨架,再把材料放到该在的位置
完成信息摘录后,将任务转向结构设计:让 Kimi 基于已确认信息提出章节框架,明确每章需解决的问题、可用证据及待核实空白。你可先审视主线是否清晰,再逐章要求扩写。例如,文章可按“问题起源—现象呈现—原因与限制分析—实际判断”的逻辑展开。具体顺序应依题目而定,无需拘泥于固定模板。
大纲经确认后,再指令 AI 围绕特定章节撰写初稿,并附带所用摘录来源。相较于一次性生成长文,分章写作更利于控制重复率、语气一致性及论证跨度;在素材繁多时,也便于替换局部证据而无需重构全文。尽管 Kimi 文档功能可基于提示和参考材料生成较完整文档,但输出仍应视为草稿,不可因结构完整而默认其内容绝对准确。
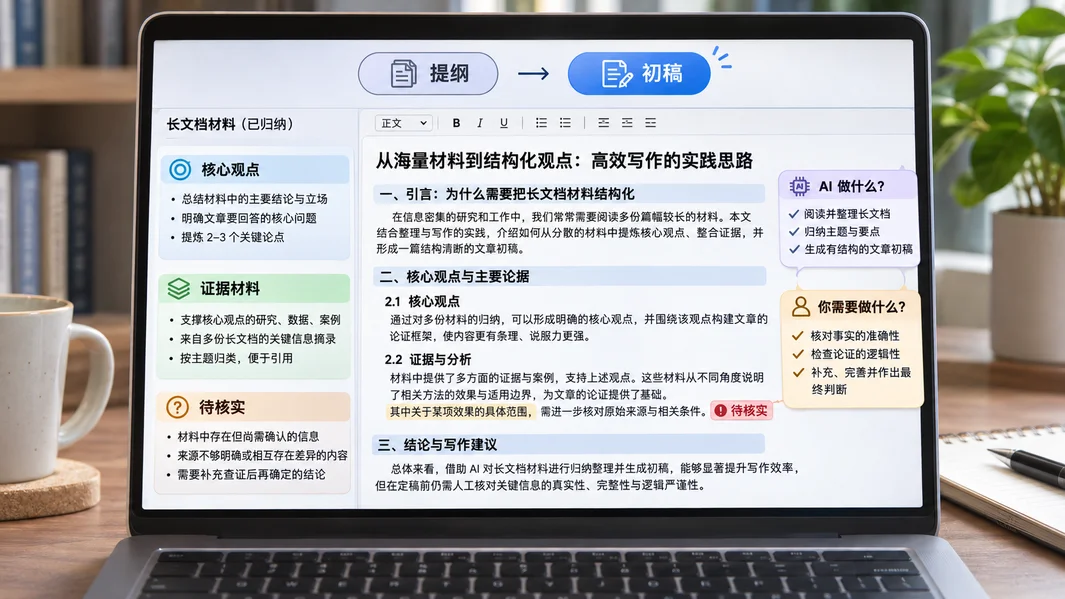
由提纲扩展初稿,保留待核对项。
整合成文的最后一步,靠人工把关
各章节初稿完成后,需统一术语、删除冗余解释,并检查章节间的逻辑连贯性。可请 Kimi 标记重复观点、未解释缩写及缺乏来源支撑的断言,但仅将其作为查漏线索,而非最终审稿结论。务必回归原始材料核实事实;对于材料未覆盖的问题,应明确界定边界,或补充可靠信息后再行判断。
在长文档写作中,AI 的优势在于加速检索、归纳与组织,但无法替代作者承担证据责任。将任务拆解为可核对的微步骤,既能发挥 Kimi 处理文档与起草内容的效能,又能避免产出流畅但来源混乱的稿件。若资料庞大且观点交织,此流程极具价值;若仅涉及少量简单材料,直接标注重点并自拟提纲反而更为高效。
Stable Diffusion模型训练入门:硬件门槛与数据准备指南
2026-11-07 08:39:38
Three.js 添加光照后模型全黑或阴影不显示的原因
2026-11-05 23:45:06
利用Web Speech API的speechSynthesis实现前端文字转语音
2026-10-31 14:02:39
JavaScript TwoQueues 缓存模型实现与使用
2026-10-28 18:52:23
Three.js光照系统源码解析:Light、AmbientLight与DirectionalLight等核心类详解
2026-10-26 22:43:13