

基于JavaScript的大文件分片上传后端实现详解
本文介绍基于JavaScript前端分片的大文件上传后端处理方案。核心逻辑包括接收分片数据、利用RandomAccessFile进行随机写入、通过FileChannel和MappedByteBuffer优化内存使用,以及校验文件完整性。代码涵盖实体类设计、分片处理流程及存储路径生成,支持MySQL、Oracle等数据库,旨在解决大文件传输的性能与稳定性问题。
大文件分片上传后端实现概述
本文仅展示后端实现代码,核心思路为前端对文件进行分片处理,每次调用上传接口时向后端传递当前分片序号及总分片数量等参数。
以下直接提供代码实现,对关键逻辑部分已添加详细注释以便理解:
文件上传实体类定义
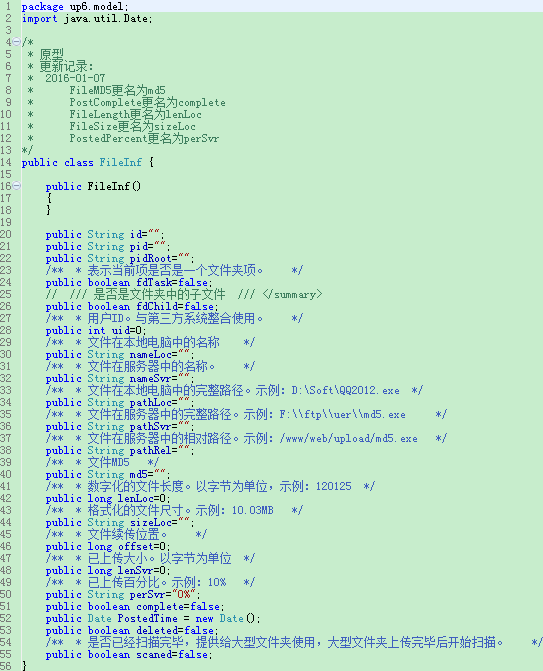
文件上传实体类定义如下:
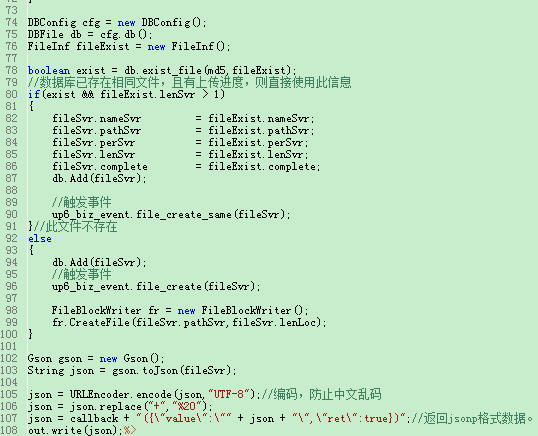
从实体类可以看出,其中已包含多项实用属性和功能,例如用于实现MD5秒传机制的相关字段。
文件数据接收与处理逻辑
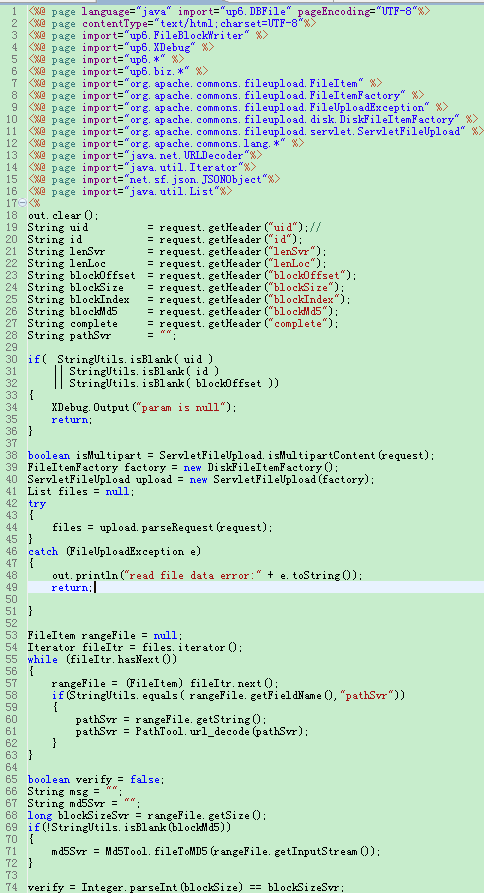
首先是文件数据接收逻辑,该模块负责接收前端上传的文件分片数据,并将其写入服务器文件。前端控件已提供分片索引、大小、MD5值及长度等信息,后端可根据实际需求灵活处理,或将分片数据直接保存至分布式存储系统。
文件初始化与写入流程
文件初始化部分处理流程如下:
第一步:实例化RandomAccessFile对象,用于随机访问文件。
第二步:调用RandomAccessFile的getChannel()方法获取文件通道FileChannel。此逻辑具备优化空间,若未来有分布式存储需求,可替换为分布式存储方案以减轻单台服务器压力。
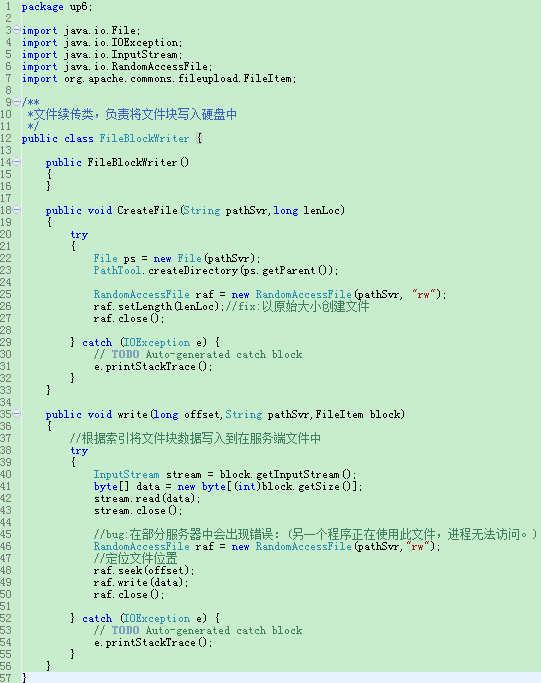
第三步:获取当前处理的分片序号,并据此计算文件写入的最终偏移量。
第四步:获取当前文件分片对应的字节数组,以便获取该分片的字节长度。
第五步:利用FileChannel类的map()方法创建直接字节缓冲器MappedByteBuffer。
第六步:将分片字节数组写入当前缓冲区的指定位置,调用mappedByteBuffer.put(byte[] b)完成数据写入。
第七步:操作完成后释放缓冲区资源。
第八步:校验文件是否已完成全部分片的上传。
辅助类:文件夹扫描与路径生成
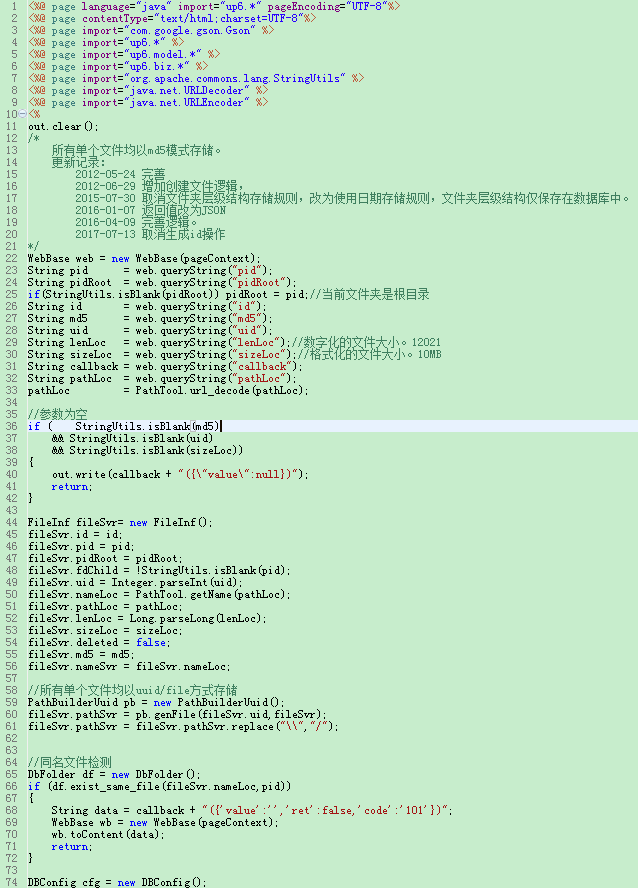
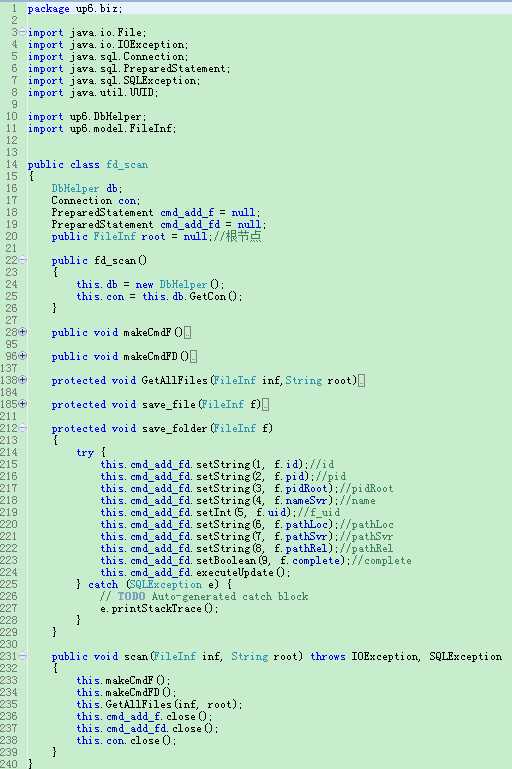
文件夹扫描类实现如下:
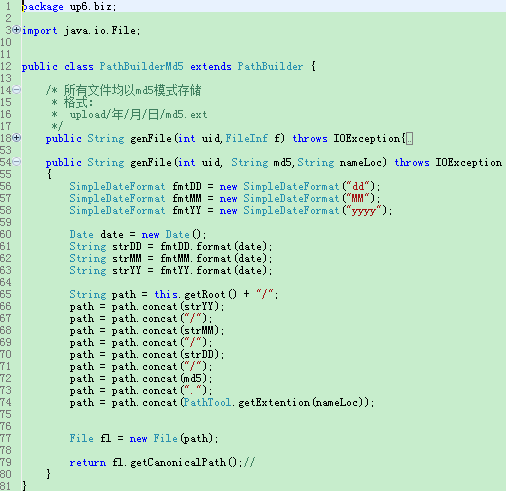
存储路径生成类逻辑如下:
至此,后端核心逻辑介绍完毕。如有疑问或建议,欢迎评论或私信交流,共同进步。
最后附上系统运行效果的截图展示:
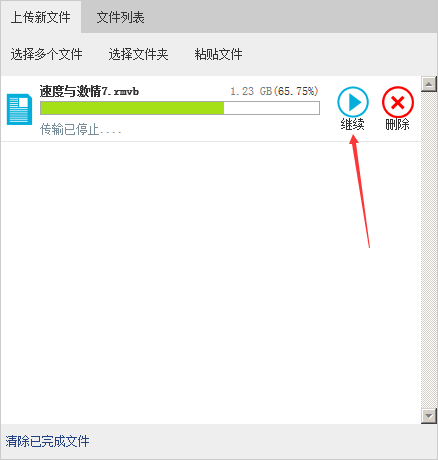
后端代码逻辑整体保持一致,目前系统已支持MySQL、Oracle及SQL Server等数据库环境。
以上就是本文的全部内容,希望能为读者的学习提供帮助,也欢迎大家继续支持本站。
NestJS 是什么?与 Express、Koa 的核心区别及选型建议
2026-11-05 13:46:41
生产环境升级 Node.js 的注意事项与兼容性测试策略
2026-11-05 09:19:24
nvm 常用命令详解:怎么平滑切换和升级 Node.js 版本
2026-11-04 09:02:34
JavaScript和JSP的根本区别:运行环境与执行机制解析
2026-11-03 23:30:18
使用nvm卸载指定版本Node.js并切换默认环境
2026-11-03 23:09:26