YOLOv3和YOLOv4白话讲解
作者:技术拾光时间:2026-05-31 08:03:17浏览:563
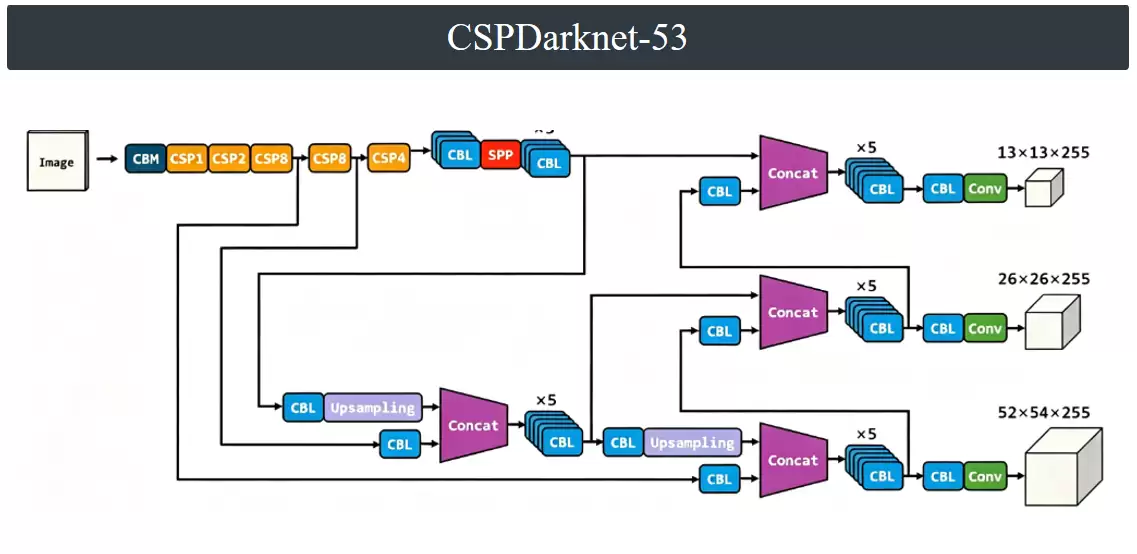
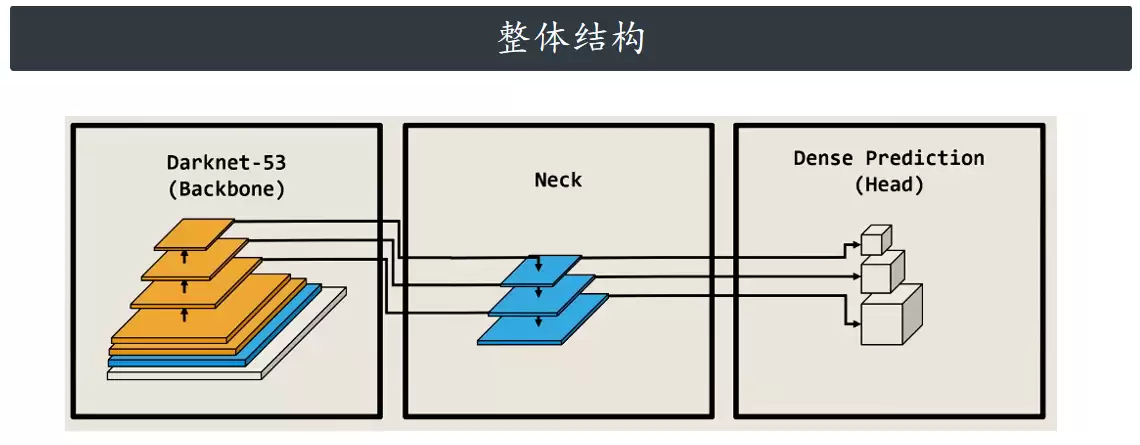
YOLOv3采用全卷积、残差连接与多尺度融合,通过Darknet-53提取特征,经FPN上采样拼接得到三个尺度输出,分别检测大、中、小目标。YOLOv4改进为CSPDarknet-53与Mish激活,引入SPP模块增大感受野,并利用PANet实现双向特征融合,提升多尺度检测精度。
骨干网络
YOLOv3 的骨干网络称为 Darknet-53。输入图像先经过一个基础的 CBL 模块(卷积 + 批归一化 + LeakyReLU 激活)进行初步特征提取。之后特征图依次送入五组残差模块,各组内残差单元堆叠数量分别为 1、2、8、8、4。该设计与 ResNet 思路一致,通过短路连接应对深层网络中的梯度消失问题。从结构上看,Darknet-53 是纯粹的卷积堆叠:全卷积 + 5 次下采样 + 16 个残差块 + 共 53 个卷积层,不含池化和全连接层。输入尺寸为 416×416×3,输出三个特征图,尺寸分别为 13×13、26×26、52×52,直接送入检测头。每个 CBL 块(Conv + BN + LeakyReLU)和残差块(Residual)均经过精心设计:残差块内部采用 1×1 降维 → 3×3 升维的路径,通过短接相加(add,非 concat)保持通道数不变。add 为数值相加,通道数不变,用于构建残差;concat 为通道拼接,通道数增加,用于特征融合。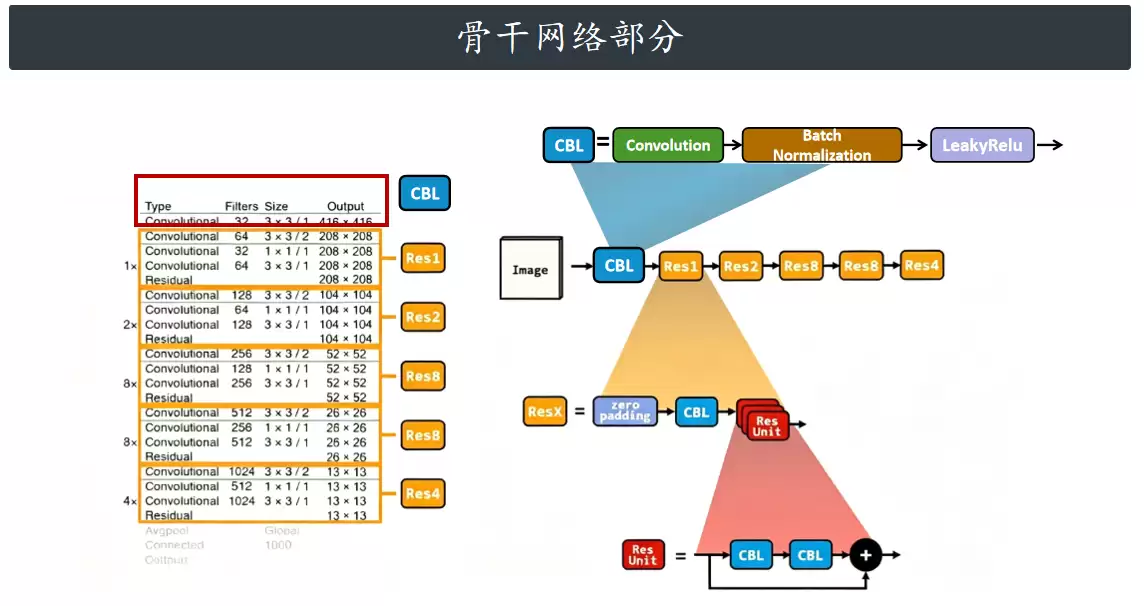 整个下采样流程为:
输入 416×416×3 → CBL(32) → 下采样(64) → Res×1 → 下采样(128) → Res×2 → 下采样(256) → Res×8 → 输出 52×52×256 → 下采样(512) → Res×8 → 输出 26×26×512 → 下采样(1024) → Res×4 → 输出 13×13×1024。
颈部网络
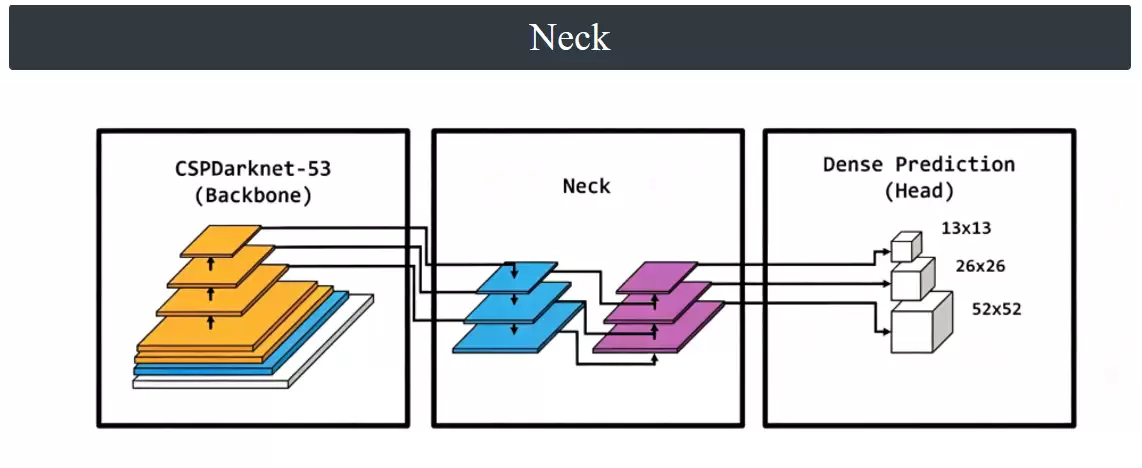
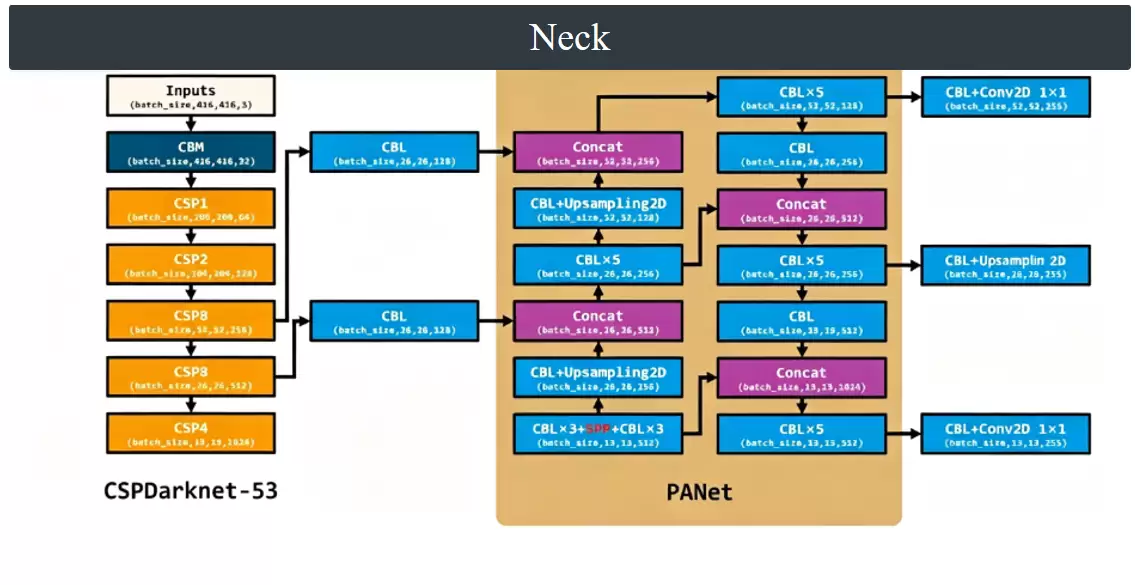
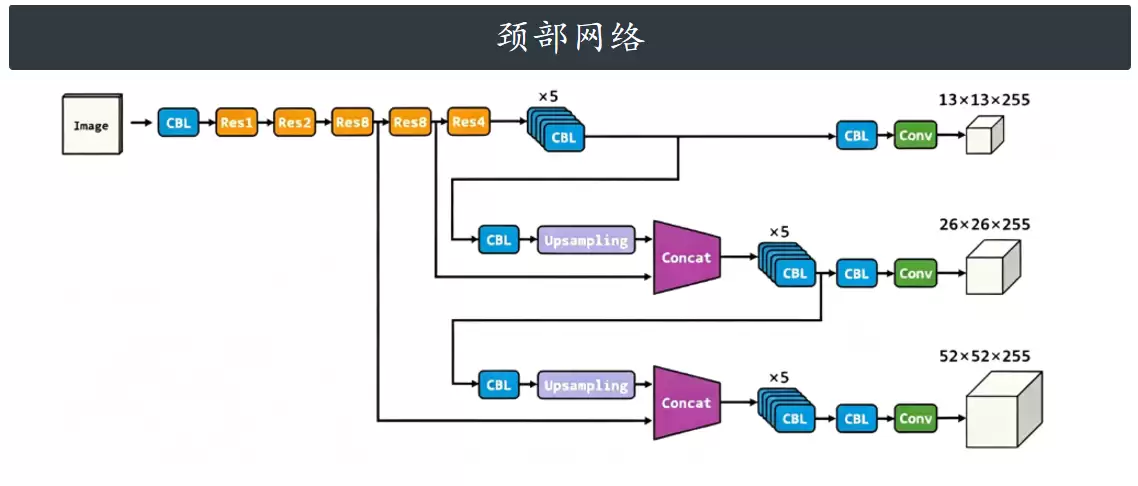
骨干网络提取的多尺度特征需要通过融合来提升检测效果。YOLOv3 采用经典的 FPN(特征金字塔)结构,走自上而下的融合路径。从骨干网络最底层输出的 13×13 深层特征开始,先堆叠 5 层 CBL 模块,再接一层 CBL 和卷积,得到第一组检测所需的 13×13×255 张量,专门负责大目标。之后,在五层 CBL 后引出一个分支,经过一层 CBL 调整后立即进行上采样(常用最近邻插值或双线性插值),将 13×13 放大为 26×26。放大后的特征图与骨干网络倒数第二层(26×26)的浅层特征进行通道拼接融合,再重复五层 CBL、一层 CBL、一层卷积的结构,输出 26×26×255 张量,负责检测中等目标。对融合后的 26×26 特征再执行一次上采样和拼接,最终得到 52×52×255 的高分辨率特征图,专门捕捉小目标。通过多尺度上采样与跨层拼接,YOLOv3 将深层语义信息与浅层细节信息结合,使大、中、小不同尺寸的物体都能被有效检测。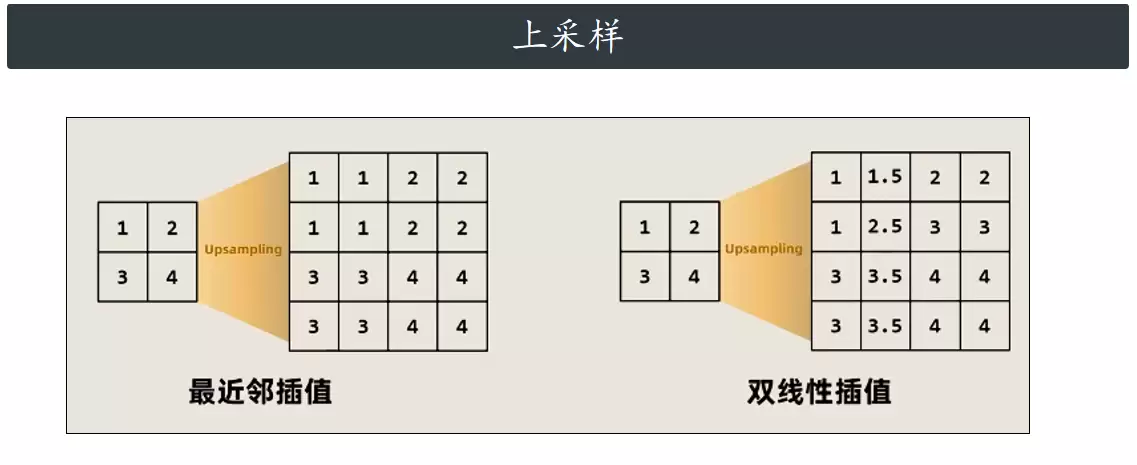
检测头部
YOLOv3 最终输出三个不同尺度的预测张量。每个尺度的特征图将图像划分为密集网格(如 13×13=169 个网格)。每个网格单元对应一个 255 维的特征张量,255 来自 3×85。即每个网格预设 3 个不同形状的锚框(Anchor Box),每个锚框对应 85 个预测参数,包含坐标偏移、尺寸、置信度及类别概率。以 13×13 层为例:第一段 85 维负责修正偏宽的 1 号锚框,第二段 85 维负责修正中等的 2 号锚框,第三段 85 维负责修正偏高的 3 号锚框。这种设计的原因在于一个网格可能同时存在多个形状各异的物体,单一锚框模板不够用,因此预先准备三种不同长宽比的模板,让网络学习并修正,从而提高检测精度。13×13 深层特征图感受野大、语义信息强,专门检测大目标;26×26 负责中等目标;52×52 高分辨率特征图擅长捕捉小目标。三种尺度的锚框规格分别匹配,共同保障多尺度检测效果。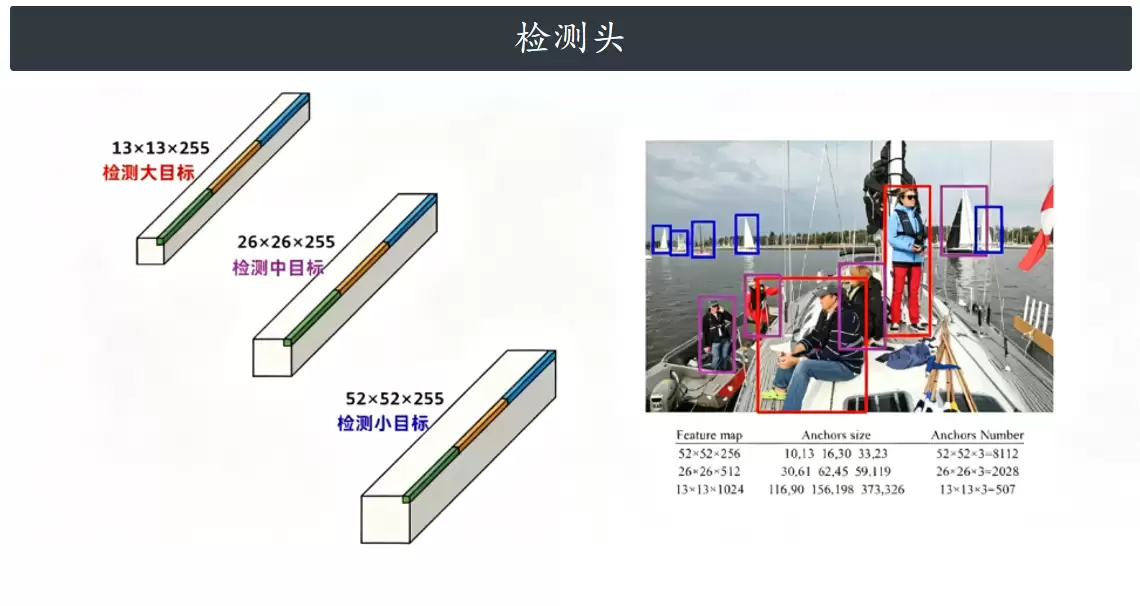
YOLOv4 的结构演进
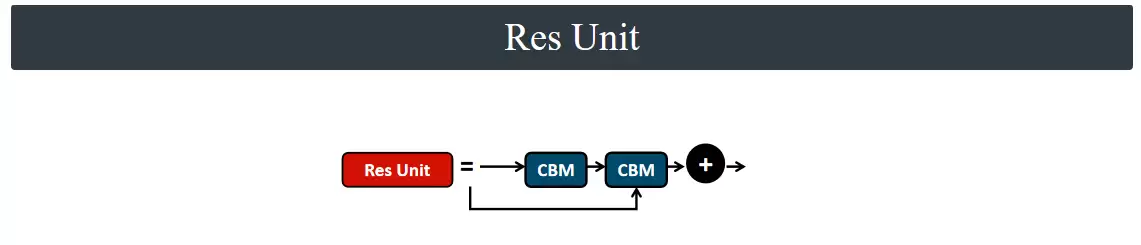
YOLOv4 是 YOLOv3 的进化版,将工程优化发挥到极致。主干特征提取网络变为 CSPDarknet-53,它在 Darknet-53 基础上引入 CSP(跨阶段部分连接)模块,计算量削减约 20%,训练更为稳定。激活函数方面,CBL 中的 LeakyReLU 替换为 Mish 激活函数,Mish 函数更平滑,梯度收敛更快,仅用于网络第一层,效果显著。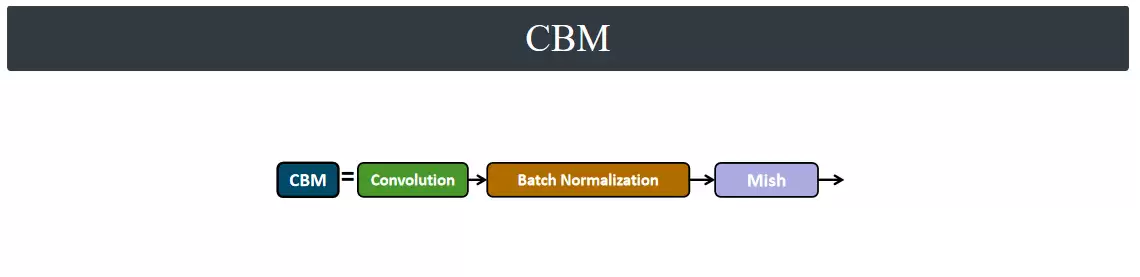 残差单元内部,CBL 变为 CBM。残差模块改动较大,增加了多个 CBM 层,内部进行拼接操作,这是 CSP 模块的核心。
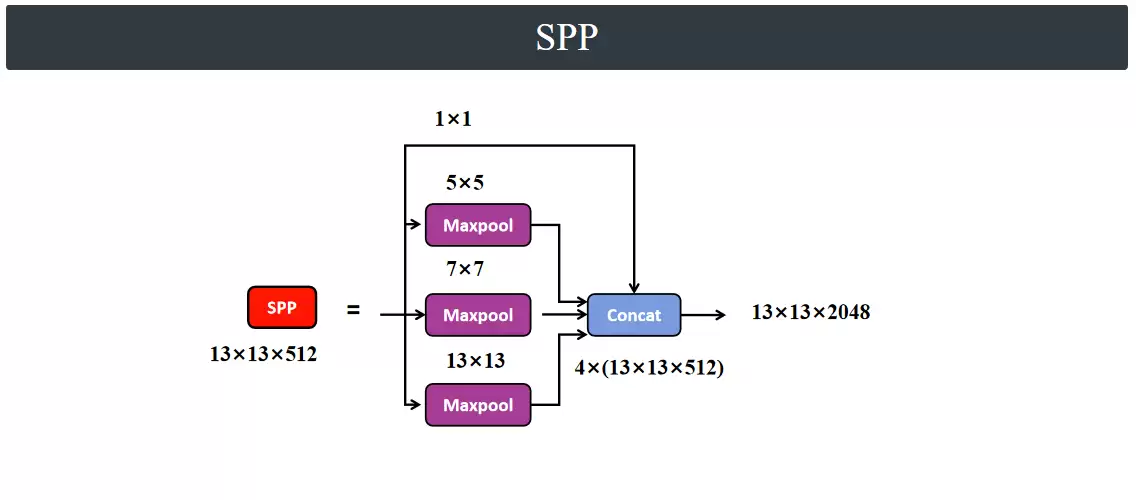
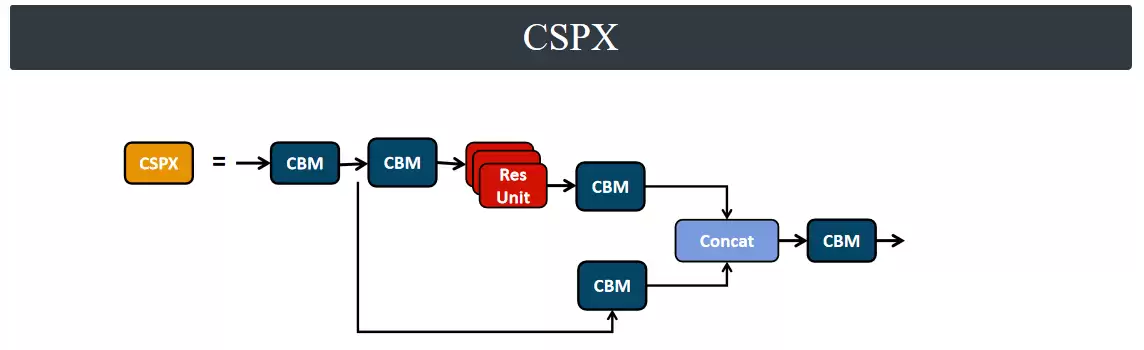 此外,YOLOv4 在 Neck 部分引入空间金字塔池化(SPP),使用 3 个不同尺寸的池化核(如 13×13、9×9、5×5)对特征图处理并拼接结果。大尺寸池化核(13×13)极大增加感受野,多尺寸池化使模型提取更丰富特征,小目标检测能力增强,计算量几乎不变。
Neck 部分
YOLOv4 的 Neck 比 v3 复杂。骨干网络输出后,先经过三层 CBL,接着是 SPP 模块,再堆叠三层 CBL 整合,得到 13×13×512 深层特征。然后经过一层 CBL 和上采样,与骨干网络 26×26 层特征拼接,再经五层 CBL 提纯。之后重复上采样和拼接,得到 52×52 浅层特征。YOLOv4 进一步增加一条反向下采样分支:从浅层特征开始,用卷积逐步缩小特征图尺寸,将浅层定位细节反向传递给上层特征,强化深层语义。这种自上而下 + 自下而上的双向融合结构即为 PANet。对比 YOLOv3 的 FPN 单向融合,YOLOv4 的 PANet 双向融合弥补了 FPN 不足,使深层特征获得细节、浅层特征获得语义,大小目标特征融合更充分,检测精度提升。