人工智能大白话GPT解读
GPT的核心基于精简解码器,采用自回归机制逐词生成文本,预训练通过最大化条件概率优化参数。微调支持分类、蕴含等四种任务。GPT-2实现零样本泛化,依赖提示词机制。生成时使用Top-K和Top-P采样及温度参数控制多样性与连贯性。GPT-3在零样本、单样本和小样本设置下评估。
GPT1的训练
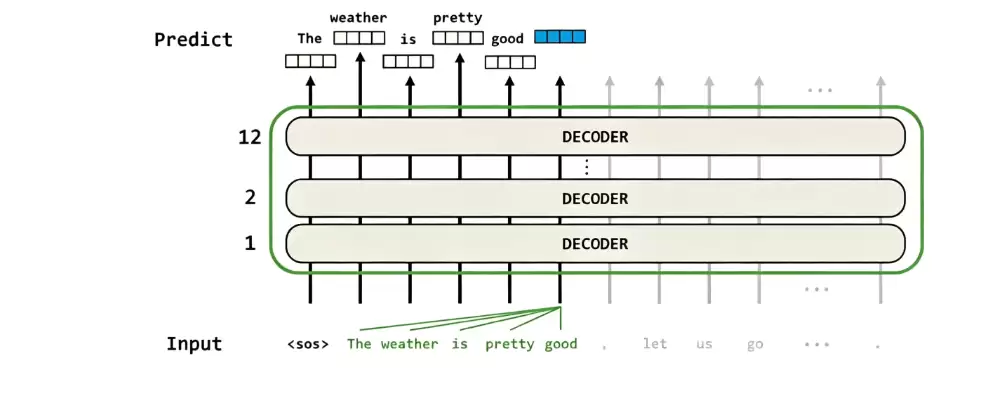
要理解GPT的文本生成方式,首先需要了解其基本结构。GPT的核心基于解码器构建,但在传统解码器的基础上做了一项简化——移除一个多头注意力层,仅保留一个完整的解码器层。这一调整使模型将全部注意力集中于文本生成任务,同时兼顾了效率与效果。
那么,GPT具体如何生成文本?它采用自回归机制,逐步进行。首先,向模型输入一个特殊标记
但这只是第一步。模型不会丢弃先前信息——它将最初的
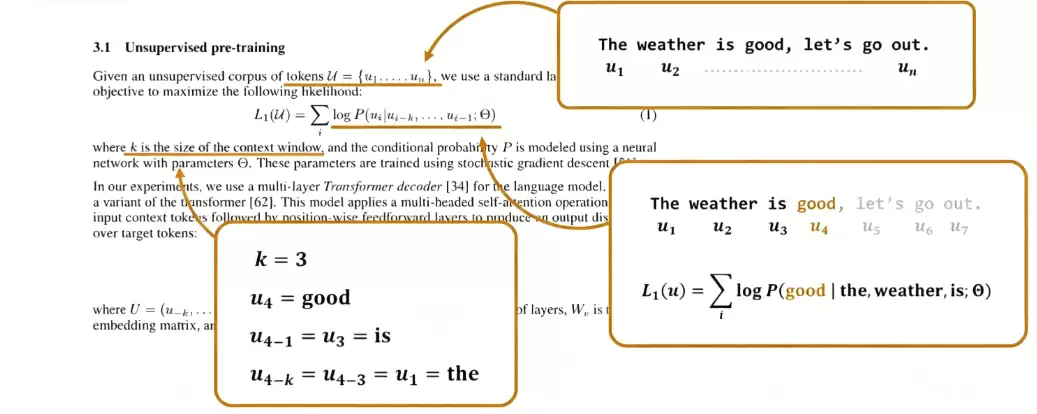
在预训练阶段,假设一个完整句子由若干单词U1、U2…Un组成。论文中的核心条件概率公式,实际上描述了自回归预测的数学逻辑。举例来说:当模型需要预测第四个单词“good”时,本质上是计算一个概率——在已知前面三个词的条件下,下一个词恰好是“good”的可能性有多大。
公式中的参数代表模型所有可学习的权重。预训练的目标很明确:最大化整句话的联合条件概率,通过反向传播不断迭代、更新参数,缩小模型预测与真实文本之间的差距。此外,模型还会设置一个上下文窗口大小k,用于限制单次预测能参考的前文长度。例如,当k=3时,模型预测下一个词最多只能看到前面的3个单词,这样既能减轻计算负担,也能约束语义依赖范围。
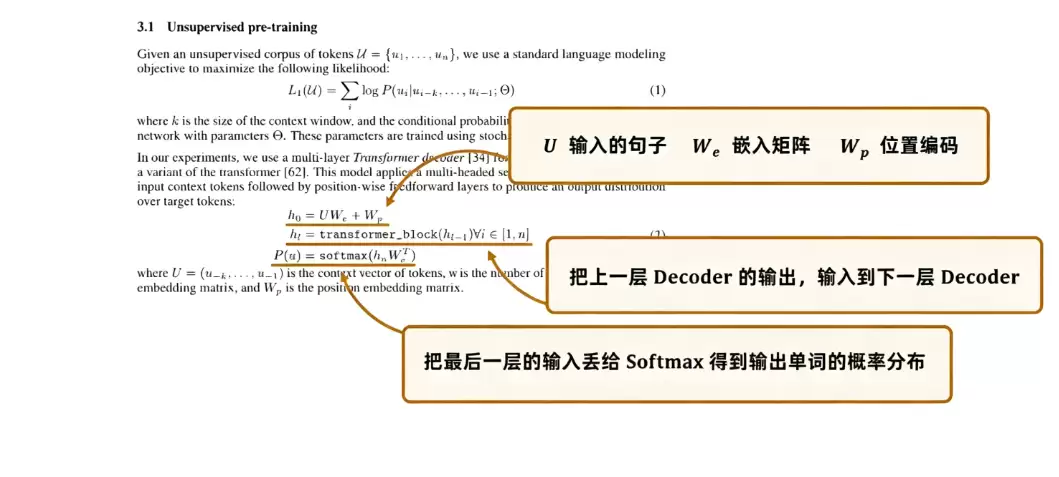
GPT的预训练流程整体与Transformer解码器的运算逻辑保持一致。输入文本序列U先与词嵌入矩阵相乘,得到词嵌入向量,再叠加上位置嵌入信息,这样单词的语义和位置特征就融合在一起。接下来,每一层解码器的输出都作为下一层的输入,逐层完成特征提取和上下文建模。最后一步是预测:解码器输出的隐藏特征hn与词嵌入矩阵的转置进行矩阵运算,映射到词表维度,得到每个单词的原始得分,再经过Softmax归一化,变成每个词的预测概率。模型选取概率最大的那个词,作为当前时刻的输出,从而完成逐词的自回归预测。
GPT1的微调
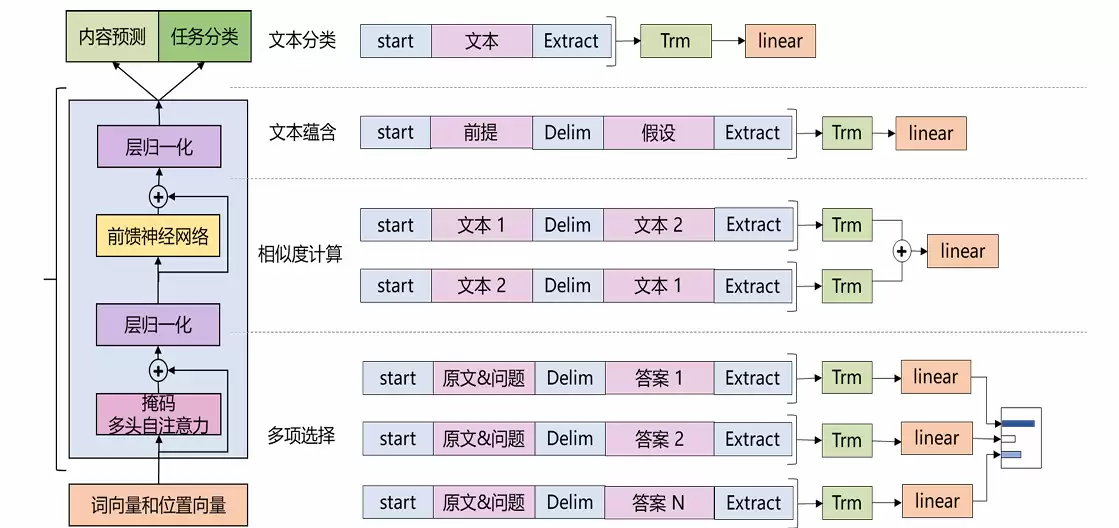
GPT-1的微调任务分为四种类型:分类、蕴含、相似度计算和多选。分类是指给一段文字打标签;蕴含是给出两句话,判断它们的逻辑关系(是蕴含、矛盾还是中性);相似度计算同样是两句话,比较意思是否相近;多选则是给出一个题干和几个选项,选出正确答案。
GPT2
Zero-shot
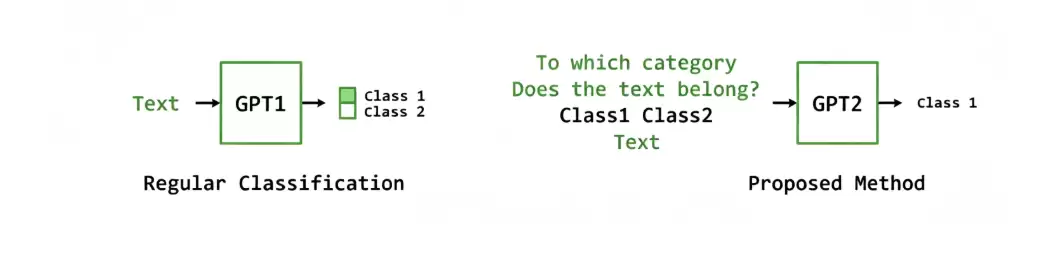
GPT-2在GPT-1的基础上做了两处核心升级:一是堆叠更多解码器层,加深网络深度;二是使用规模更大、质量更高的WebText海量语料数据集进行预训练。更重要的是,GPT-2验证了一种更通用的迁移学习范式:大规模预训练语言模型可以实现零样本(Zero-shot)泛化——不修改参数、不调整结构、不做下游微调,仅凭预训练学到的语言能力就能直接完成各类任务。
零样本能力的核心原理,实际上就是现在广泛使用的提示词(Prompt)机制。只需向模型输入一段引导性文本,它就能理解指令意图,依据前文语境自主生成符合任务需求的内容,完全不需要额外训练就能适配多种场景。
TOP-K,TOP-P
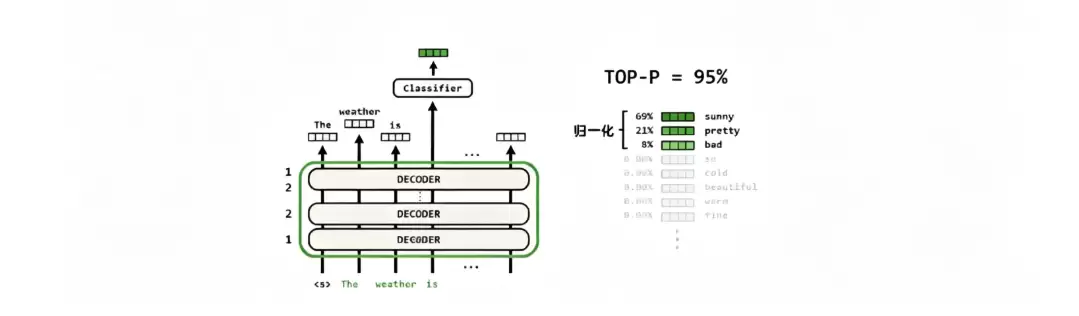
在文本续写任务中,例如补全“散步、骑车、看夕阳”这类场景,如果每次都选概率最高的词,生成的内容很容易变得单调、重复、缺乏多样性。为了解决这个问题,模型引入了Top-K和Top-P两种采样参数。
原本的GPT生成单词时直接选择全局概率最高的,比较死板。Top-K采样则是人为设定一个固定数值,比如K=5,模型只保留当前概率排名前五的单词,其他全部归零,然后对这五个候选词重新归一化后采样选词。这样就能避免选出特别冷门、不通顺的词。
Top-P采样,也称为核采样,它会设定一个累计概率阈值,比如95%。模型将所有词按概率从高到低排序,从前到后依次累加,直到总和超过95%时停止。落在累加区间内的词就是合法候选词集合,同样归一化后采样。两者的区别在于:Top-K固定选前K个,Top-P按累计概率动态筛选。配合使用,既能保证语句通顺,又能增加文本多样性。
温度
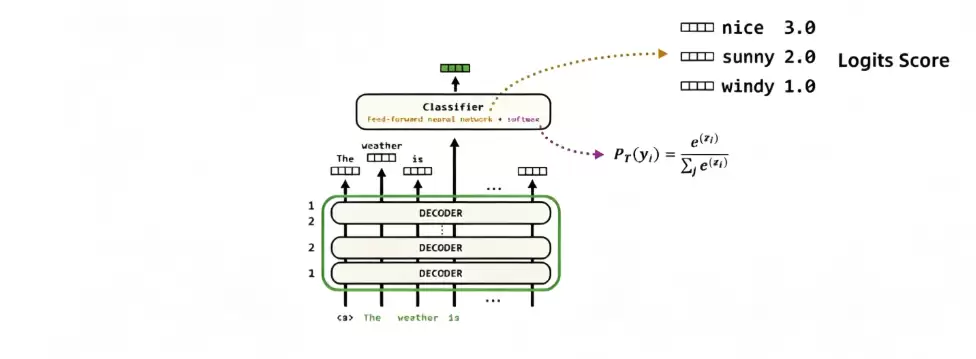
在文本生成过程中,模型先输出每个候选词的原始逻辑得分,再经过Softmax转化为预测概率。温度(Temperature)是一个调节生成随机性的超参数,原理是在Softmax计算中加一个温度系数作为分母,对原始得分进行缩放。
当温度小于1时,得分差距被放大,概率分布更集中,模型更倾向于选择高概率的词,生成的内容更连贯、保守、确定性强;当温度大于1时,得分差距被缩小,概率分布更平滑,低概率词也有机会被选中,生成的内容更多样、更有创意,但逻辑出问题的风险也更大。
GPT在使用温度、Top-K、Top-P这三个生成控制参数时,存在先后执行顺序,三者不会同时随意调整。通常不建议同步调整Top-K和Top-P这两项,因为它们的筛选逻辑不同,同时大幅调整会导致概率分布紊乱,生成效果难以控制,出现语句不通顺、逻辑混乱或风格失控的问题。实践中,一般只单独调节其中一项参数,以保证生成结果稳定可控。
GPT3
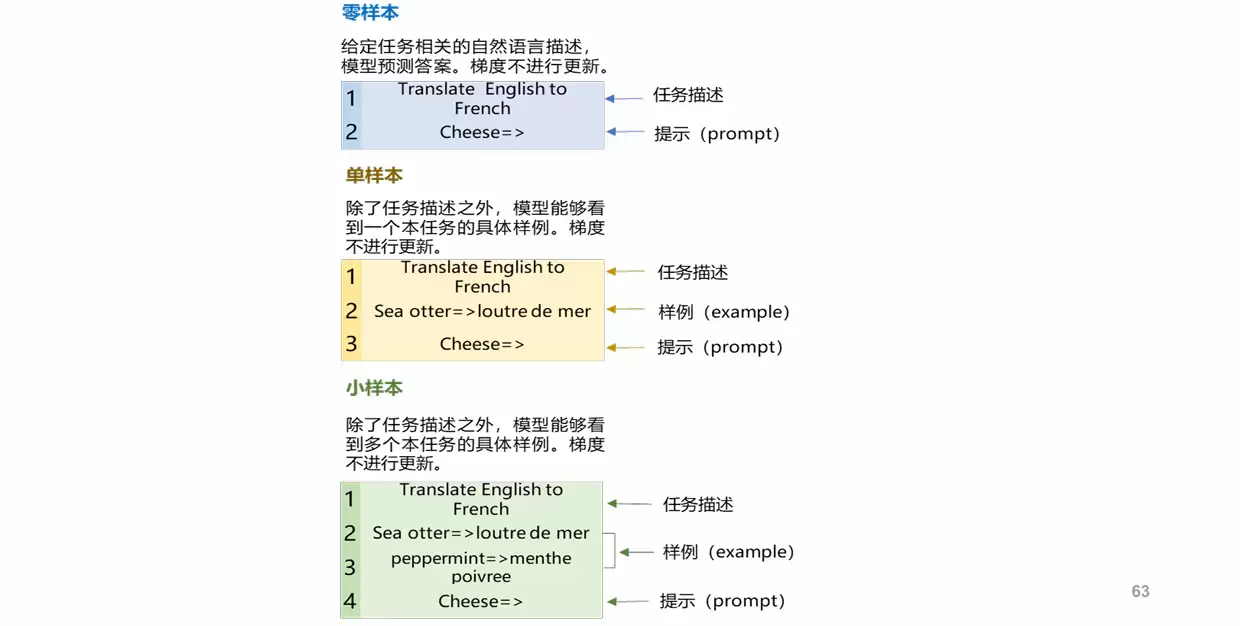
GPT-3在几十个自然语言处理数据集上进行了评估,主要考察三种设置:零样本学习(Zero-shot Learning)——不允许展示具体任务样本,只告知模型自然语言表示的指令;单样本学习(One-shot Learning)——只允许展示一个样本;小样本学习(Few-shot Learning)——允许展示尽可能多的样本,大约在10到100个之间。