

人工智能YOLOv2算法大白话讲解
YOLOv2采用Darknet-19主干网络,以1×1和3×3卷积替代大卷积核并减少参数量。训练分预训练和检测两阶段,输入尺寸需为32的倍数。检测网络保留骨干并加入直通层,通过空间到深度重排融合浅层与深层特征,提升小目标检测精度。锚框机制基于聚类自动选取5组先验框,简化目标回归任务。
YOLOV2网络架构
YOLOv2选用Darknet-19作为主干网络,这一设计思路具有显著优势。与YOLOv1不同,Darknet-19取消了7×7的大卷积核,仅保留1×1和3×3两种卷积核。从参数数量来看,一个7×7卷积核需要49个参数,而替换为三个3×3卷积核仅需27个参数,但感受野保持一致。即使面对5×5卷积核,使用两个3×3堆叠也能实现替代,参数从25个降至17个。此外,每次卷积后均跟随批量归一化操作,有效提升了训练过程的稳定性和收敛速度。
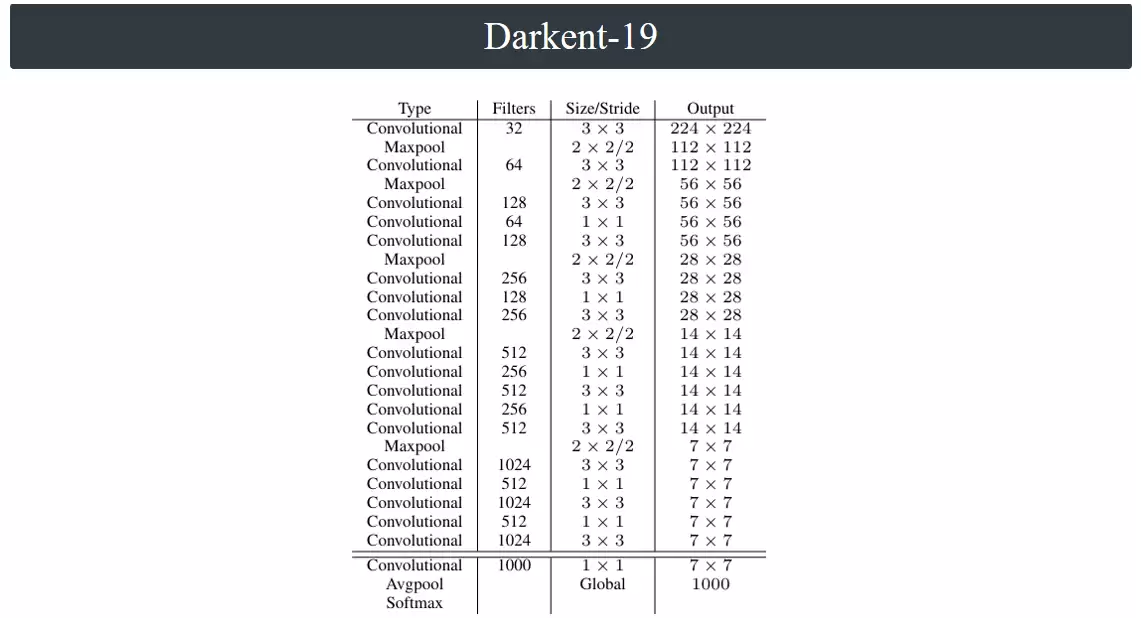
YOLOv1的训练流程为先使用224×224的ImageNet数据预训练分类模型,随后将输入放大至448×448并在检测数据集上微调。YOLOv2延续了这一“先预训练,再检测微调”的基本思路,但在细节上进行了更精细的优化,具体分为两个阶段:
| 阶段 | 输入尺寸 | 数据集 | 目标 |
|---|---|---|---|
| 分类训练阶段(左) | 224×224 | ImageNet | 学习通用图像特征 |
| 检测训练阶段(右) | 448×448 | Pascal VOC 等检测数据集 | 学习目标定位与检测 |
YOLOv2同样遵循此模式,但增加了一个中间步骤:预训练阶段先使用224×224尺寸训练160个epoch,再使用448×448尺寸微调10个epoch。最终检测阶段采用416×416(或352/608)尺寸作为输入,且输入尺寸必须为32的倍数,并每10个批次更换一次尺寸。
| 阶段 | 子步骤 | 输入尺寸 | 数据集 | 关键信息 |
|---|---|---|---|---|
| 预训练阶段 | Train | 224×224 | ImageNet | 160 个 epoch |
| Fine-tune | 448×448 | ImageNet | 10 个 epoch | |
| 检测阶段 | Detection | 416×416(或 352/608) | Pascal VOC & COCO | 尺寸是 32 的倍数,每 10 个批次更换尺寸 |
上述网络架构图仅对应预训练阶段的分类网络。进入检测阶段后,模型后部将被替换,仅保留主干部分。
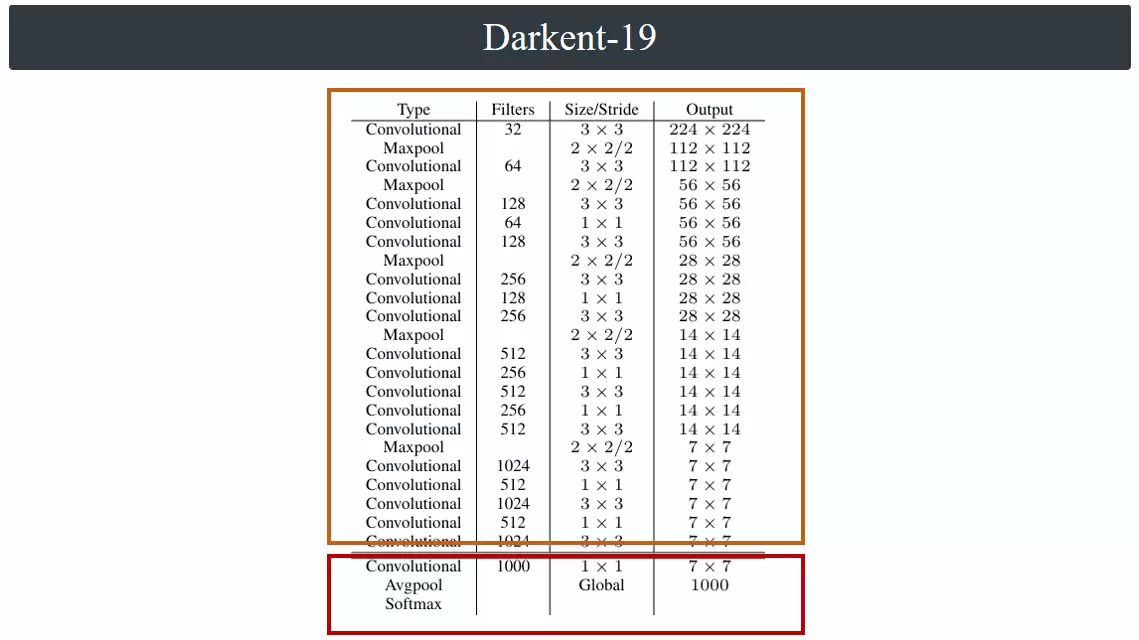
实际的YOLOv2检测网络保留了Darknet-19作为骨干,并在其后堆叠两个卷积层。为融合不同层级的特征,引入直通层(Passthrough Layer):将骨干网络第5组卷积层输出的高分辨率浅层特征,通过空间到深度(Space-to-Depth)重排后,与网络尾部卷积层输出的低分辨率深层特征进行拼接。最后经过两个卷积层直接输出检测结果。该设计使模型能够同时利用浅层的细节信息和深层的语义信息,显著提升了小目标的检测能力。
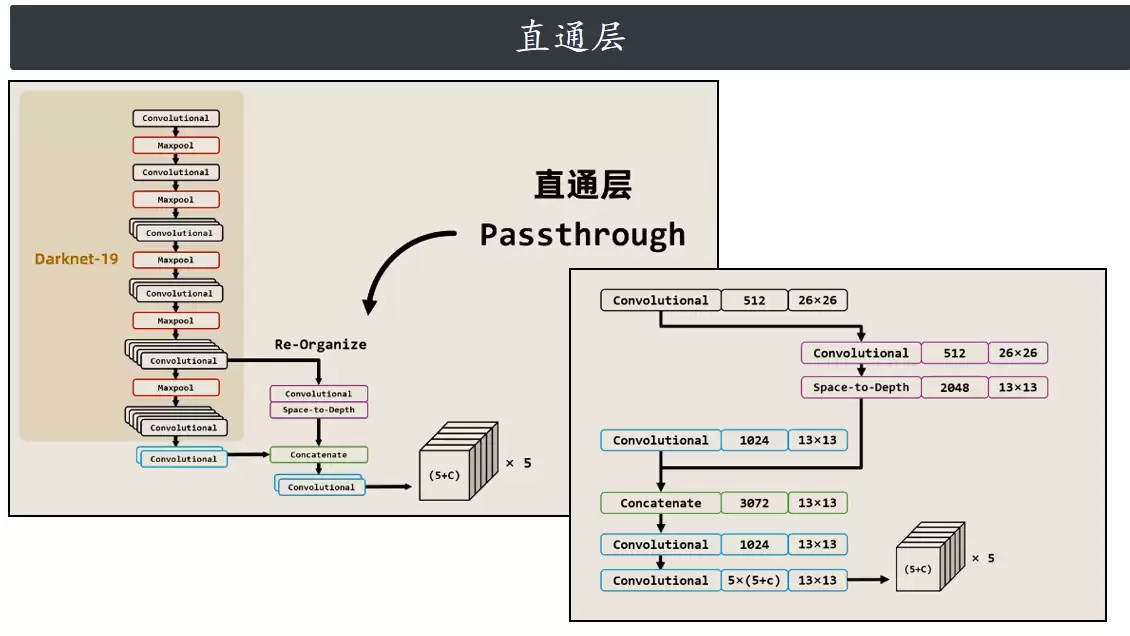
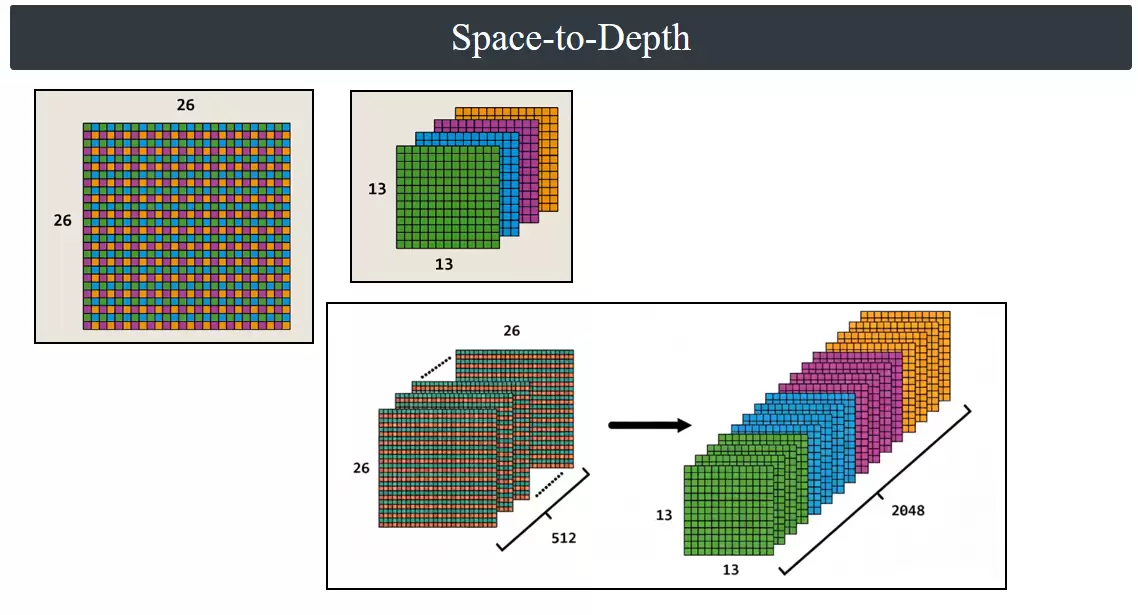
具体实施方式如下:以26×26特征图为例,将其左上角2×2区域划分为四个不同颜色的格子,然后以步长为2遍历整个特征图。遍历完成后,将相同颜色的格子按通道维度堆叠,原始26×26特征图即转换为13×13×4的张量,此即Space-to-Depth重排。在YOLOv2的直通层中,该操作作用于骨干网络输出的512通道26×26特征图,最终得到13×13×2048的张量,再与网络深层输出的13×13×1024特征进行通道拼接,形成13×13×3072的融合特征图。
直通层的本质在于将浅层细粒度的位置信息与深层抽象的语义信息相结合,从而解决了YOLOv1在检测小目标时精度偏低的问题,使模型能够捕捉到更多细节信息。
锚框和位置偏移运算
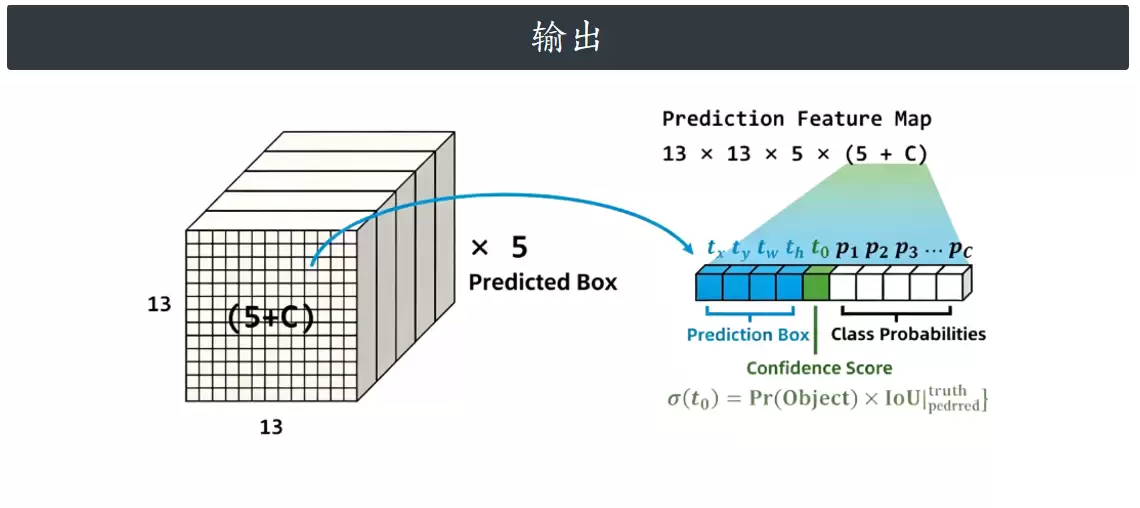
模型最终输出为一个13×13×5×(5+C)的三维特征矩阵。其中5代表每个网格预设了5组先验锚框,整张特征图被划分为13×13个网格单元,每个网格独立预测5个边界框。每个预测框的输出向量长度为5+C,具体含义如下:前4个数值表示边界框的中心偏移量和宽高,第5个数值为目标置信度,最后C个数值对应各个类别的预测概率。
在后处理阶段,置信度分支的输出需经过Sigmoid激活函数,映射至0到1之间,以获得真正有效的置信得分。此步骤虽简单,但直接决定了最终检测结果的解码与输出质量。
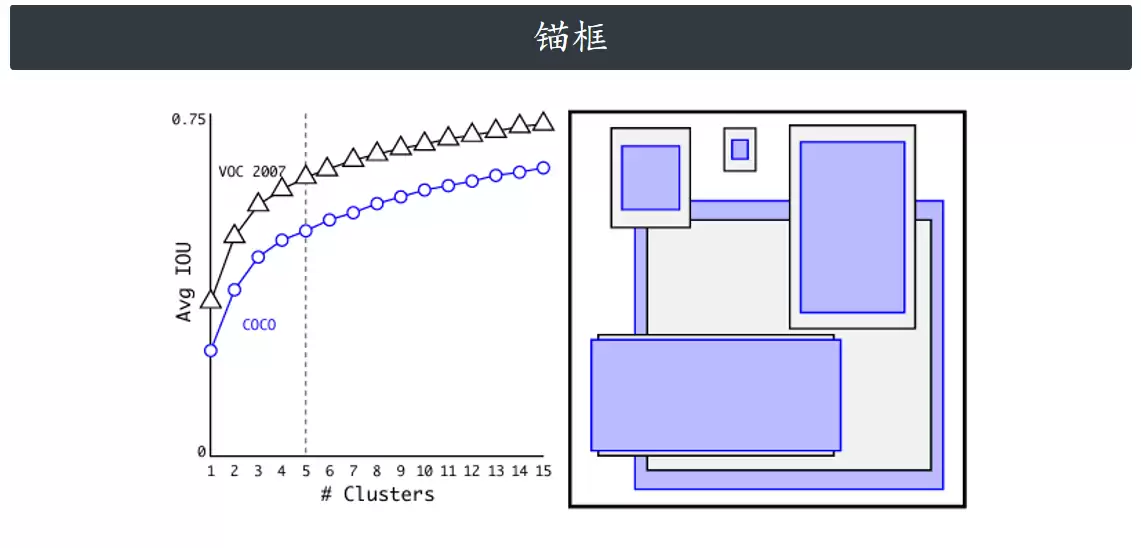
现实中的目标物体在外形和尺寸上往往存在固定规律。例如行人通常呈竖向长条状,俯视视角下的车辆则为宽矩形。不同类别物体的边界框长宽比和大小均具有明显共性。若能根据数据集归纳出具有代表性和普适性的基准框,并以此为参考,则可大幅降低模型的学习难度。这些基准框即为锚框(Anchor)。
为使锚框更适配数据集,YOLOv2和YOLOv5不再依赖人工经验手动设定尺寸,而是采用聚类算法对所有真实标注框进行维度聚类分析,自动统计并归纳特征,最终选取5组最具代表性的锚框作为先验基准。这一改进有效提升了边界框回归的精度。
训练过程中,模型将特征图划分为13×13个网格,每个网格从预设的5组锚框中匹配最优锚框。具体做法为:针对每个真实目标框,计算其与所有候选锚框的IoU,选出IoU最大的锚框作为匹配基准。该匹配锚框的中心落在对应网格内,随后模型以此锚框为参照,结合预测的边界框参数,计算坐标和宽高的偏移误差,完成回归训练。通过不断修正预测框位置,定位精度逐渐提高。
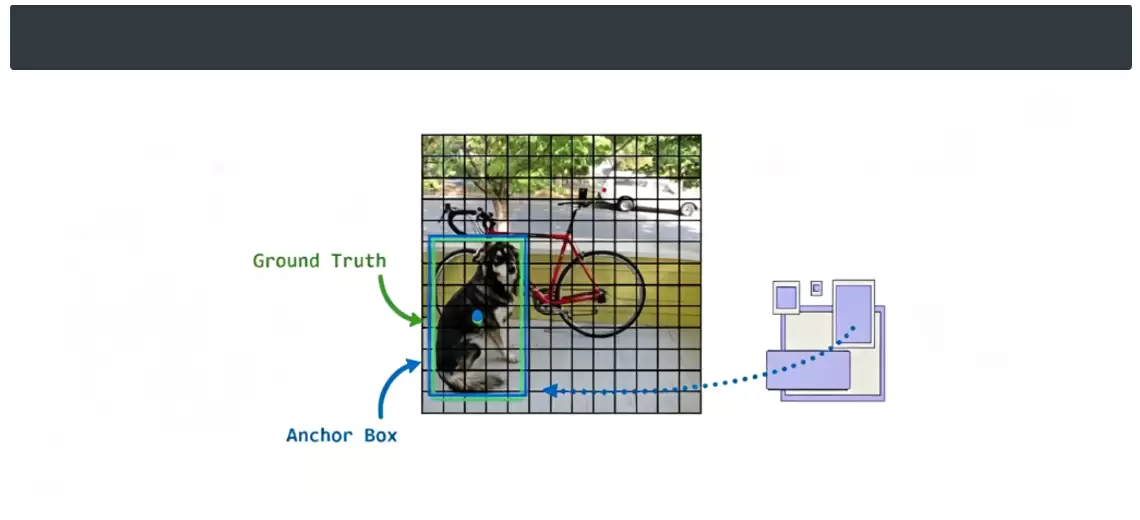
锚框的尺寸是相对于数据集图像的比例尺,具有极强的数据依赖性。因此,在训练自己的数据集时,必须根据目标分布定制专属锚框,否则检测效果将受到影响。
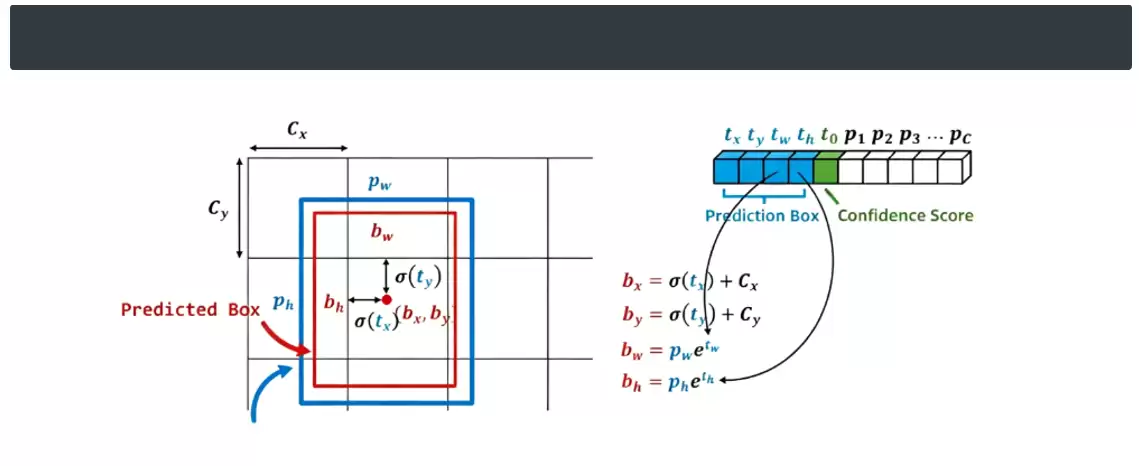
以单个网格为例:假设第二行第二个网格中,红色框为模型输出的预测边界框,蓝色框为匹配的先验锚框。目标中心的偏移由模型直接回归预测得到。训练时,模型以蓝色锚框为基准,结合预测框的坐标、宽高、置信度和类别信息,与真实标注框进行比对,计算坐标偏差损失、置信度损失和分类损失,并不断迭代优化。
总结锚框的核心价值如下:
- 锚框是基于数据集目标特征预先设定的先验基准框,提前归纳了常见物体的尺寸和长宽比例。
- 为模型提供固定参考模板,避免网络凭空预测目标尺寸,降低学习难度。
- 模型无需直接预测完整边界框,只需以匹配的锚框为基础,微调中心坐标和宽高即可,回归任务显著简化。
- 适配不同形态的检测目标,有效提升定位精度,加快收敛速度,对改善小目标、异形目标的检测效果尤为明显。