

Node.js实现网页爬虫的几种简易方式
本文介绍Node.js环境下实现网页爬虫的两种主要方式。第一种基于Superagent发起请求,结合Cheerio解析HTML并提取数据,利用fs和path模块实现文本与图片的本地存储。第二种使用Nightmare自动化测试工具,基于Electron模拟浏览器行为,适用于处理动态加载页面。
Node.js爬虫基础与Superagent+Cheerio方案
提到网络爬虫,许多人第一反应是它能抓取图片等资源,这确实是其常见用途之一。作为Node.js爬虫领域的初学者,本文将分享几种在Node.js中实现爬虫的基本方法。
首先介绍第一种方案,该方案组合使用了node.js中的superagent、request以及cheerio库。其中,cheerio是核心组件,它提供了类似Node.js环境下的jQuery功能,对于熟悉jQuery的用户来说,上手非常迅速。
Cheerio的主要作用是解析抓取到的页面DOM结构,并从中提取所需的数据信息。而superagent则是Node.js中一个轻量级、渐进式的第三方HTTP客户端请求代理模块,常用于向目标网站发起请求。
在Node.js中,内置的http模块也可以作为客户端发送请求,而第三方模块request则对其进行了封装,使得操作更加便捷。以下是引入这三个模块的代码示例:

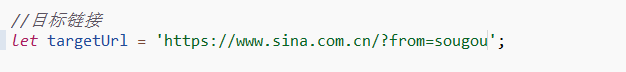
接下来,我们开始对目标页面发起请求。假设目标页面为新浪网首页:
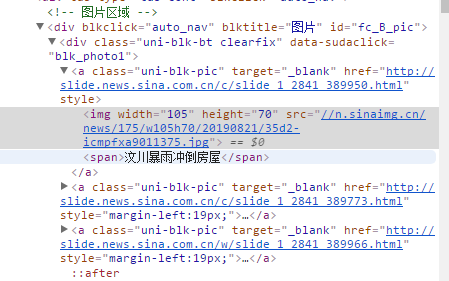
新浪首页的部分HTML代码结构如下:
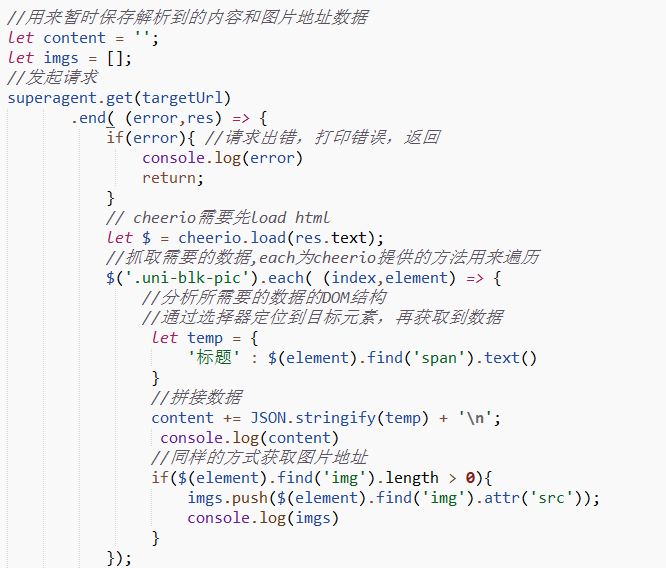
通过superagent向目标网站发送请求并获取网页内容后,利用cheerio.load方法加载需要解析的HTML字符串。
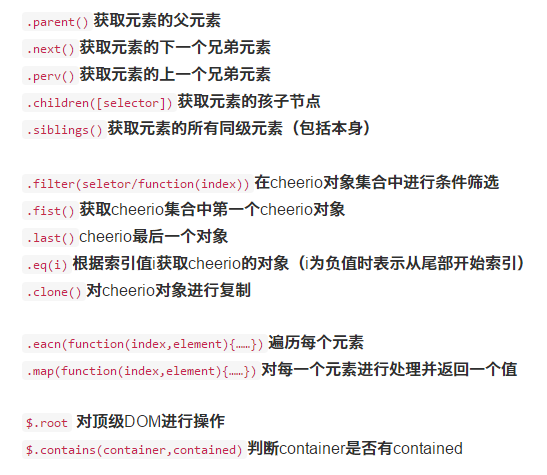
在Cheerio中,可以使用 .each(function(index,element){...})方法遍历并处理所需的DOM元素。
执行上述代码后,返回的结果如下所示:
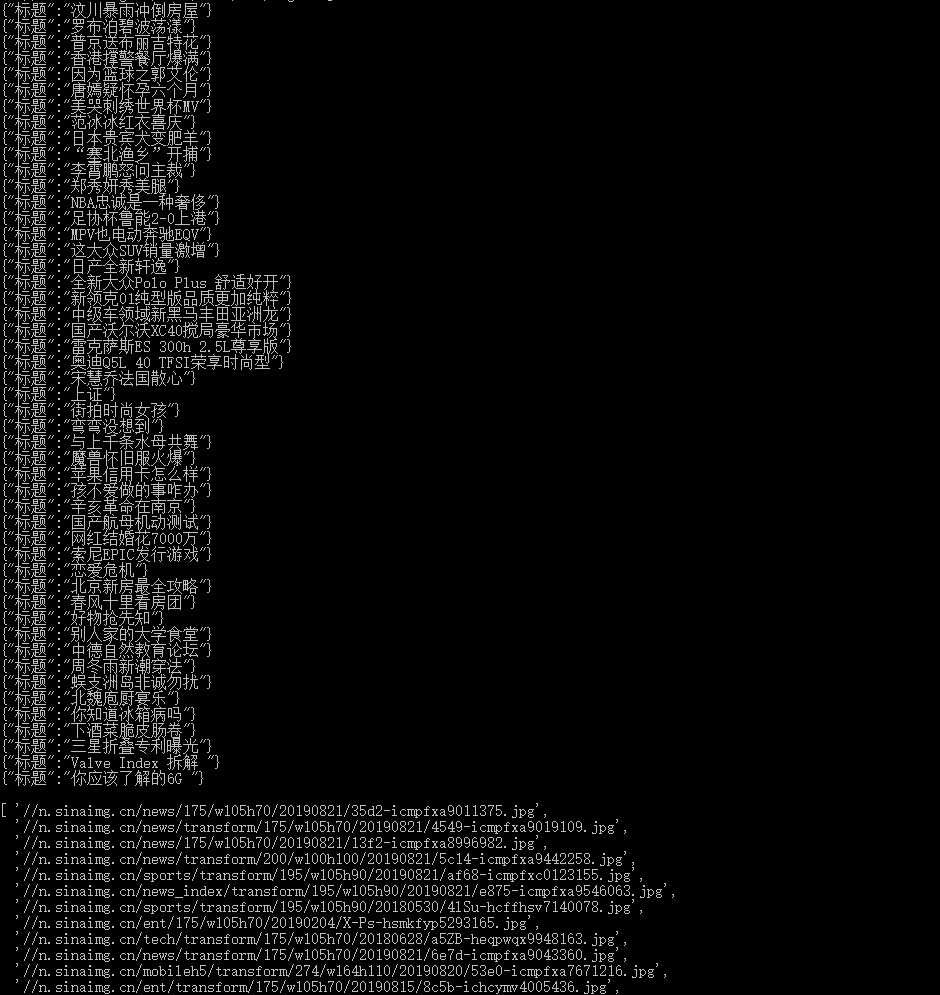
如果需要将提取的文字内容保存到本地,可以采用以下方法:
首先需要引入文件系统模块const fs= require("fs")。
同时引入路径处理模块 const path=require("path")。
Node.js内置的fs模块负责文件系统的读写操作。与其他JS模块不同,fs模块同时提供了异步和同步两种操作方式。
在上述流程中,调用存储文字内容的mkdirs方法。
//存放数据
mkdirs('./content2',saveContent); (注: content2是新建文件名;saveContent是回调函数)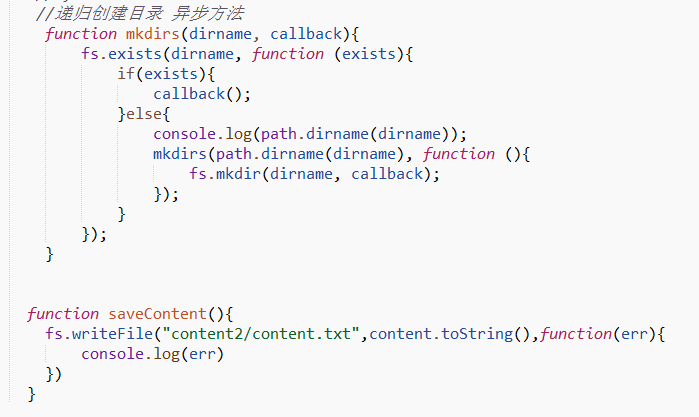
最终,文字内容将被保存至content2目录下的content.txt文件中。
如果希望存储图片,可以参考以下实现方式:

基于Nightmare的动态页面处理方案
第二种方案是使用Nightmare自动化测试工具。
这里简要介绍Nightmare工具的主要用途:
Electron允许开发者使用纯JavaScript调用Chrome的原生接口来创建桌面应用程序。它可以被视为专注于桌面应用的Node.js变体,而非传统的Web服务器。
这种基于浏览器的应用方式使得各种响应式交互变得极为方便。
Nightmare是一个基于Electron的框架,专为Web自动化测试和爬虫设计。它具备类似PhantomJS的自动化测试功能,能够模拟用户行为以触发异步数据加载。
与Request库类似,它可以直接访问URL抓取数据,并支持设置页面延迟时间。因此,无论是手动触发脚本还是行为触发脚本,都能轻松实现。
const Nightmare=require("nightmare") //自动化测试包 ,处理动态页面
const nightmare=Nightmare({show: true}) show:true时,运行node可以显示内置模拟浏览器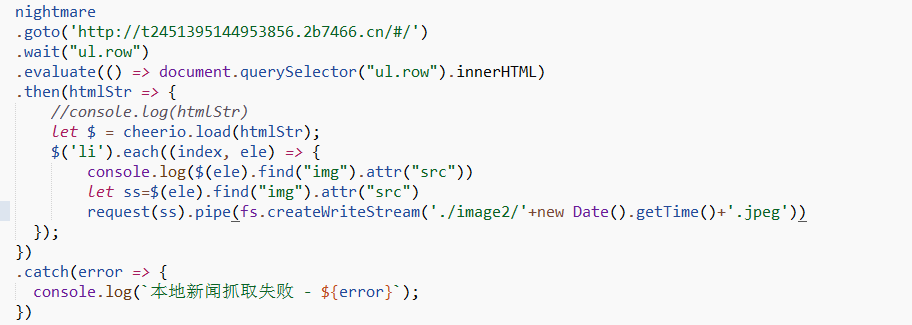
运行结束后,图片将存储在image2目录中。
文章到此结束,欢迎伙伴们提出指正意见。
总结
以上就是本文的全部内容,希望这些内容对大家的学习或工作具有参考价值,感谢支持。
Node.js中使用path模块获取文件名
2026-11-05 15:15:15
Node.js中url模块与querystring模块处理查询字符串的区别
2026-11-05 15:04:45
JavaScript(JS)主要用来做什么
2026-11-05 10:10:47
怎么修改Node.js和npm的全局安装路径与缓存目录
2026-11-04 19:48:28
NW.js 常见问题排查:Node 模块加载失败与版本兼容解决
2026-11-04 11:22:45