

JavaScript 实现敏感词过滤:DFA算法原理与性能对比
本文详细介绍在 JavaScript 中实现敏感词过滤的两种方案:传统全文匹配与 DFA 确定有限状态自动机。重点解析 DFA 算法通过构建词树结构实现高效查找的逻辑,并提供完整的代码实现。通过对比测试,DFA 算法在平均耗时和最大耗时上均显著优于原生 indexOf 方法,适合高并发场景。
敏感词过滤方案概述
近期开发了一个用户评论功能,允许用户提交评论并在文章下方查看。作为遵循社会主义核心价值观的内容平台,必须对评论内容进行敏感词过滤。经过调研,目前主要有两种常见的解决方案。
第一种方案是全文搜索并逐个匹配。这种方式虽然直观,但在数据量较大时存在明显的效率瓶颈,具体性能对比见文末。
第二种方案是采用 DFA 算法,即确定有限状态自动机(DFA)。关于该算法的详细定义可参考相关百科链接。
DFA 算法原理
DFA 算法简介
DFA 是一种计算模型,其数据源为有限集合。算法通过当前状态和输入事件来确定下一个状态,即遵循“状态 + 事件 = 下一状态”的规则。通过这一过程逐步构建出一个有向图,其中节点代表状态。由于 DFA 仅涉及查找和判断操作,无需复杂计算,因此能显著提升算法效率。
参考文章:Java 实现敏感词过滤
DFA 实现逻辑与代码
实现逻辑概述
数据结构构造
将敏感词列表转换为树状结构。例如,敏感词库包含 ['日本鬼子', '日本人', '日本男人'],其数据结构如下图所示(图片引用自参考文章)。
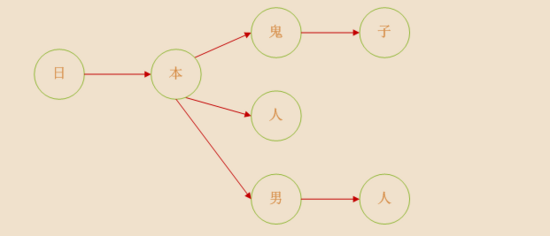
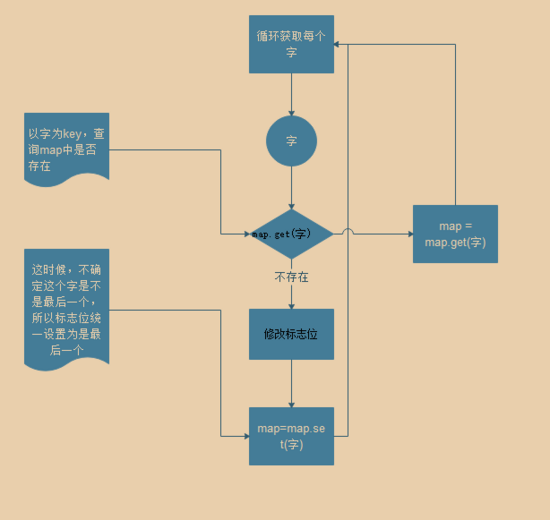
每个汉字作为一个节点,连续节点组成一个完整词汇。以“日本人”为例,对应树中的特定路径。可以使用对象或 Map 来构建树结构,本例采用 Map 构建节点。每个节点包含一个状态标识,用于标记当前节点是否为词的结尾。每条路径必须有一个终点节点。以下是构建节点的流程图。
判断逻辑说明
从文本的第一个字符开始检查。例如文本“你我是日本鬼子”,第一个字“你”在第一层节点中未找到,则继续检查第二个字。当遇到“日”时,在第一层找到对应节点,接着在下一层节点中查找“本”,同时判断该节点是否为结尾节点。如果是,则匹配成功;否则继续向后匹配。
代码实现部分
#### 构造数据结构
/**
* @description
* 构造敏感词map
* @private
* @returns
*/
private makeSensitiveMap(sensitiveWordList) {
 // 构造根节点
 const result = new Map();
 for (const word of sensitiveWordList) {
  let map = result;
  for (let i = 0; i < word.length; i++) {
   // 依次获取字
   const char = word.charAt(i);
   // 判断是否存在
   if (map.get(char)) {
    // 获取下一层节点
    map = map.get(char);
   } else {
    // 将当前节点设置为非结尾节点
    if (map.get('laster') === true) {
     map.set('laster', false);
    }
    const item = new Map();
    // 新增节点默认为结尾节点
    item.set('laster', true);
    map.set(char, item);
    map = map.get(char);
   }
  }

 }
 return result;
}
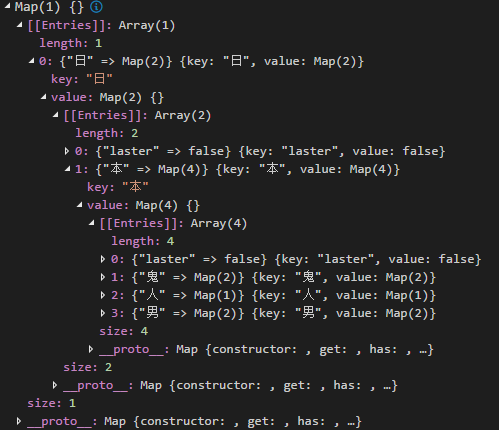
最终生成的 Map 结构如下所示。
查找敏感词逻辑
/**
* @description
* 检查敏感词是否存在
* @private
* @param {any} txt
* @param {any} index
* @returns
*/
private checkSensitiveWord(sensitiveMap, txt, index) {
 let currentMap = sensitiveMap;
 let flag = false;
 let wordNum = 0;//记录过滤
 let sensitiveWord = ''; //记录过滤出来的敏感词
 for (let i = index; i < txt.length; i++) {
  const word = txt.charAt(i);
  currentMap = currentMap.get(word);
  if (currentMap) {
   wordNum++;
   sensitiveWord += word;
   if (currentMap.get('laster') === true) {
    // 表示已到词的结尾
    flag = true;
    break;
   }
  } else {
   break;
  }
 }
 // 两字成词
 if (wordNum < 2) {
  flag = false;
 }
 return { flag, sensitiveWord };
}
/**
* @description
* 判断文本中是否存在敏感词
* @param {any} txt
* @returns
*/
public filterSensitiveWord(txt, sensitiveMap) {
 let matchResult = { flag: false, sensitiveWord: '' };
 // 过滤掉除了中文、英文、数字之外的
 const txtTrim = txt.replace(/[^\u4e00-\u9fa5\u0030-\u0039\u0061-\u007a\u0041-\u005a]+/g, '');
 for (let i = 0; i < txtTrim.length; i++) {
  matchResult = checkSensitiveWord(sensitiveMap, txtTrim, i);
  if (matchResult.flag) {
   console.log(`sensitiveWord:${matchResult.sensitiveWord}`);
   break;
  }
 }
 return matchResult;
}
性能测试与对比
效率分析
为了验证 DFA 算法的效率,进行了简单测试。测试文本长度为 5095 个汉字,敏感词库包含 2000 个敏感词。对比算法包括 DFA 算法和 String 原生对象提供的 indexOf API。
// 简单的字符串匹配-indexOf
ensitiveWords.forEach((word) => {
 if (ss.indexOf(word) !== -1) {
  console.log(word)
 }
})
两种算法分别执行 100 次,结果如下。
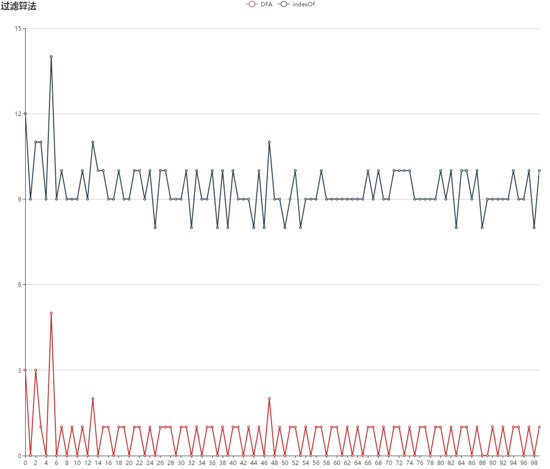
从结果可直观看出,DFA 的平均耗时约为 1ms,最大耗时为 5ms;而 indexOf 方式的平均耗时约为 9ms,最大耗时为 14ms。因此,DFA 在效率上具有明显优势。
总结
以上介绍了 JavaScript 实现敏感词过滤的算法及逻辑,希望对大家有所帮助。如有疑问请留言,小编会及时回复。感谢大家对本站的支持!
JS 鼠标滚轮事件频繁触发导致卡顿怎么优化?
2026-11-05 17:08:07
优化JS回到顶部性能:防抖节流与requestAnimationFrame应用
2026-11-05 16:33:51
JS中Array、Set与Map的区别及应用场景选择
2026-11-05 16:03:02
PixiJS 常见报错排查:纹理跨域、黑屏与内存泄漏解决
2026-11-05 10:05:21
JS数组find与filter取值区别及性能对比
2026-11-05 08:39:21