JS 深浅拷贝的本质区别:图解栈内存与堆引用
深入剖析 JavaScript 深浅拷贝的本质差异。结合 V8 引擎栈内存与堆内存双轨分配模型,图解指针地址传递机制与副作用产生根源,对比主流拷贝方案的原理、边界与实战选型策略。
一、JavaScript 内存模型:栈内存与堆内存的存储分工
在深入探讨拷贝操作前,必须首先建立对 V8 引擎底层内存排布的具象认知。JavaScript 引擎将运行时内存主要划分为栈内存(Stack Memory)与堆内存(Heap Memory),两者的分配机制、寻址方式和生命周期存在根本差异。
1. 栈内存:高效、连续与直接存值
栈内存由系统自动分配和释放,具有后进先出(LIFO)的结构特性。在 JavaScript 中,执行上下文中的基础数据类型(Primitive Types:Number、String、Boolean、Null、Undefined、Symbol、BigInt)占用固定大小的内存空间,其值直接存放在当前栈帧的局部变量区中。当函数执行完毕退出上下文时,栈指针简单回退,所占用的栈槽立即随之回收,存取性能极高。
2. 堆内存:动态、树状与指针寻址
与栈内存不同,对象、数组和函数等引用类型(Reference Types)的大小在编译期无法预知,其内部属性可以随时动态增加或删减。因此,V8 引擎会在堆内存中开辟动态空间来存放这些复杂数据实体。与此同时,在栈内存的变量槽位中,仅写入一个固定长度的十六进制堆内存物理地址指针(例如 0x100A)。
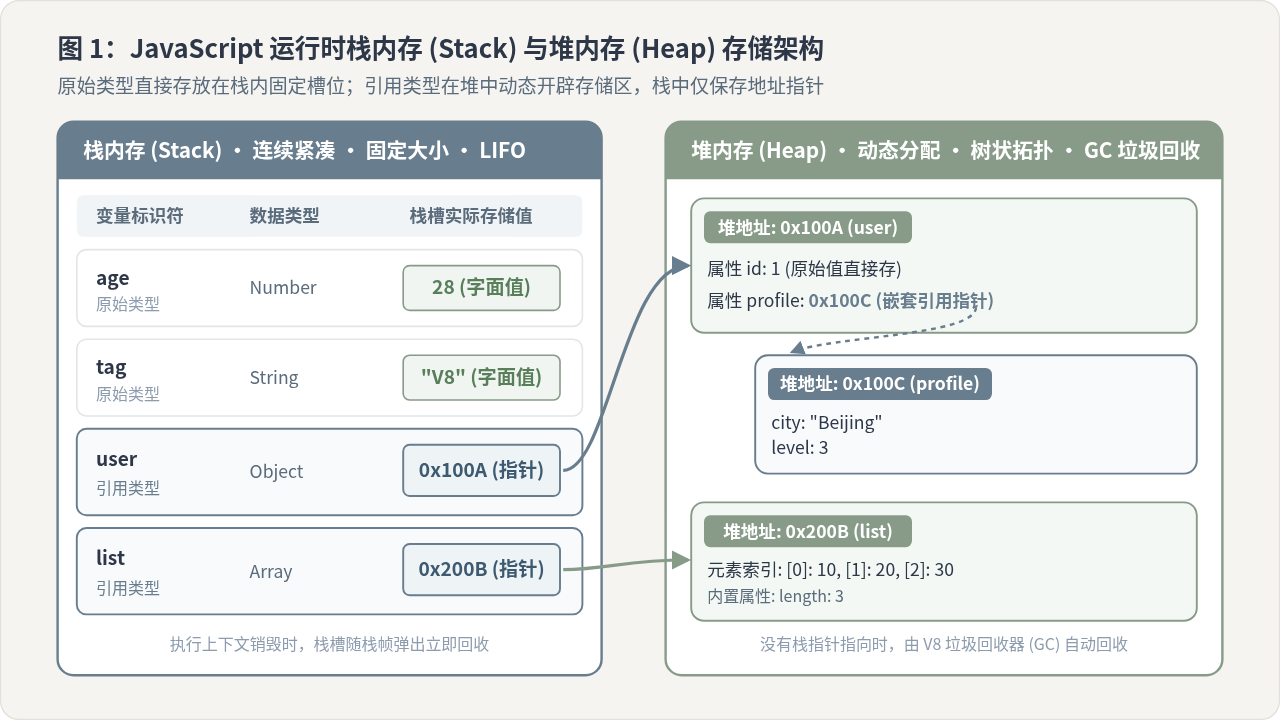
理解这一分工有助于厘清变量赋值操作:当执行 let y = x(原始类型)时,JavaScript 引擎在栈中为 y 分配全新槽位并完整拷贝 x 的数值,两者互不相干;而执行 let objB = objA(直接引用赋值)时,拷贝的仅仅是栈中存储的堆内存指针。
// 1. 原始类型赋值:栈内存直接复制字面值
let a = 28;
let b = a;
b = 30;
console.log(a); // 28 —— 彼此完全独立

// 2. 引用类型赋值:仅复制栈中持有的堆内存指针
let obj1 = { name: "Tom", meta: { age: 18 } };
let obj2 = obj1;
obj2.name = "Jerry";
console.log(obj1.name); // "Jerry" —— 两者指向同一个堆块 0x100A
二、浅拷贝的机制与本质局限:图解指针共享的连锁反应
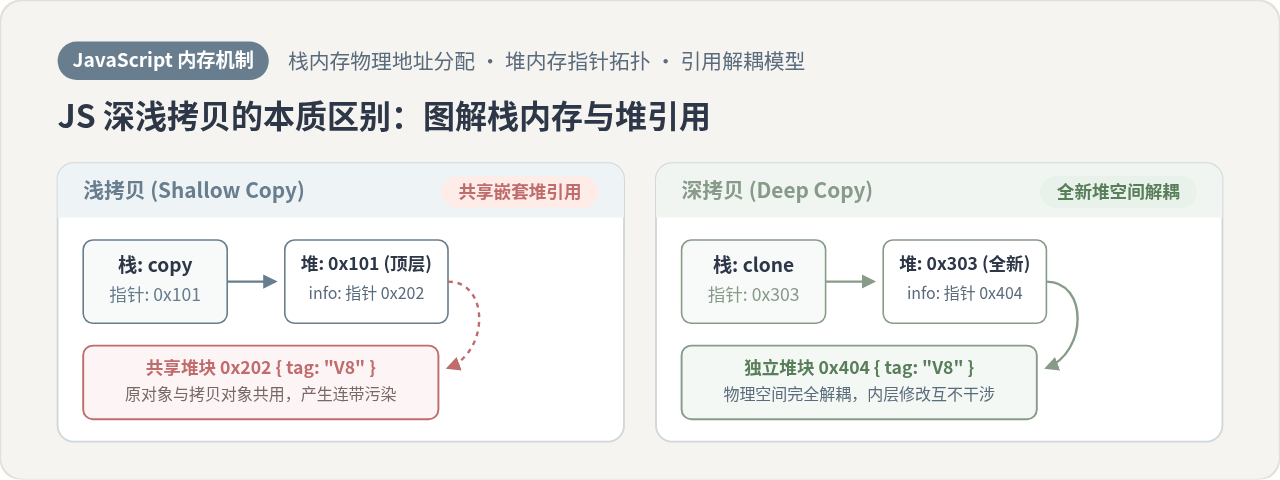
很多开发者初学时常将“引用赋值(obj2 = obj1)”与“浅拷贝(Shallow Copy)”混淆。浅拷贝并不是简单的指针传递,它确实创建了一个全新的顶层对象,但在处理内部属性时存在关键局限。
1. 浅拷贝的具体行为定义
浅拷贝会遍历源对象自身所有的可枚举属性,并依次写入新创建的对象实例中:
- 若属性为原始类型:直接拷贝属性的字面值(在新的堆对象中开辟对应属性槽位并存值);
- 若属性为引用类型:仅拷贝该属性所持有的堆内存地址指针,而不进入该引用类型内部继续复制。
常见的浅拷贝实现包括 ES6 展开运算符 const copy = { ...origin }、Object.assign({}, origin) 以及数组的 Array.prototype.slice() 与 Array.from()。
2. 指针共享引发的数据污染过程推导
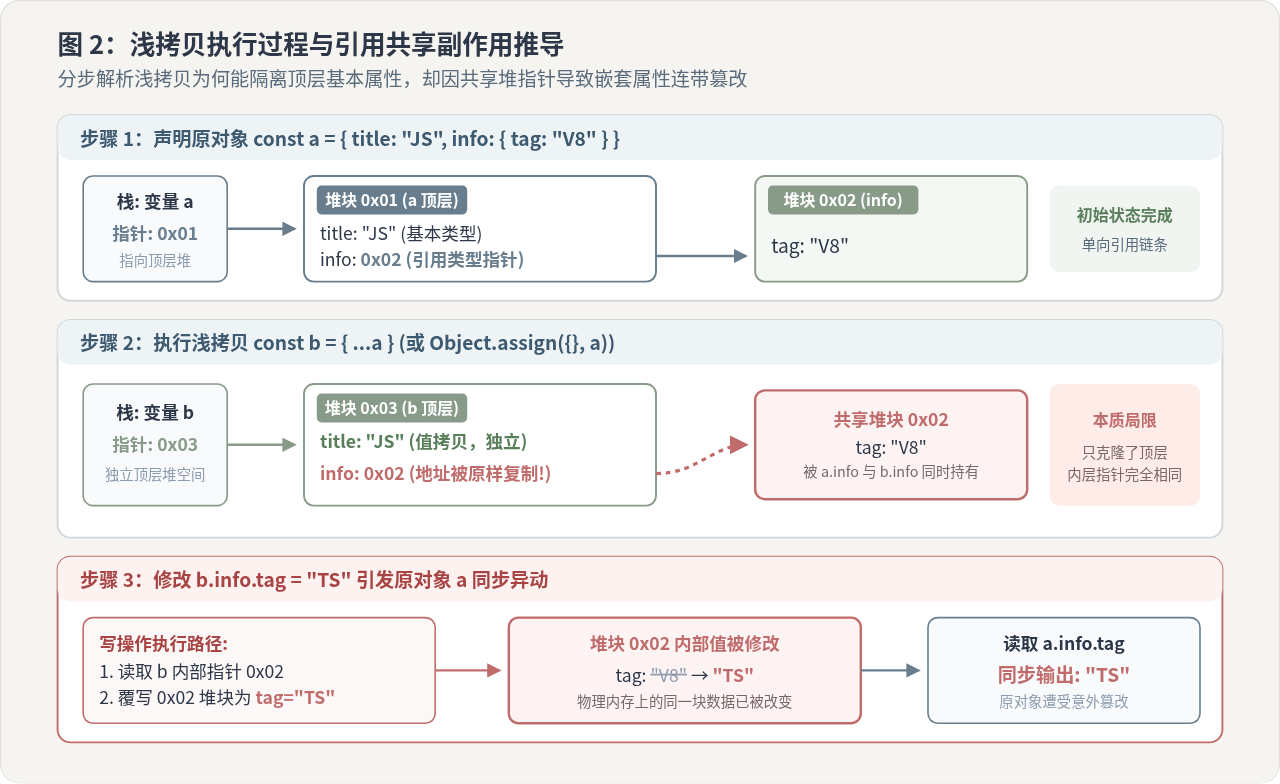
结合图 2 的推导步骤,我们可以清晰观察到浅拷贝的断层现象:
- 第一层属性完全解耦:执行
const b = { ...a }后,b在堆中获得了独立的地址0x03。如果此时修改b.title = "New",被改写的仅仅是0x03堆块内部的title槽,a.title仍然是"JS"。 - 嵌套属性指针共用:由于
a.info是一个对象,在堆中的地址为0x02。浅拷贝在复制info键时,仅仅将0x02这个十六进制地址写入了b的属性表中。此时,a.info和b.info的内部指针完全等价。 - 连锁修改的发生:当业务代码执行
b.info.tag = "TS"时,V8 引擎通过b.info保存的地址寻找到堆块0x02,将其内部的tag改写为"TS"。由于原对象a.info同样指向0x02,随后访问a.info.tag会发现其值也已被动改变。
setState({ ...state }) 进行不可变更新,如果状态树包含嵌套数组或多层配置,仅依靠顶层扩展运算符可能导致深层组件共享同源数据引用,从而引发非预期的重渲染失效或跨模块状态篡改。
三、深拷贝的实现原理与常见方案对比
深拷贝(Deep Copy)的目标是在堆内存中实现全拓扑层级的完全镜像复制。不仅目标对象自身需要分配新的堆地址,其依赖树上的所有嵌套子对象、数组及引用结构,都必须在堆中递归开辟全新的物理空间,建立一套平行的独立引用网络。
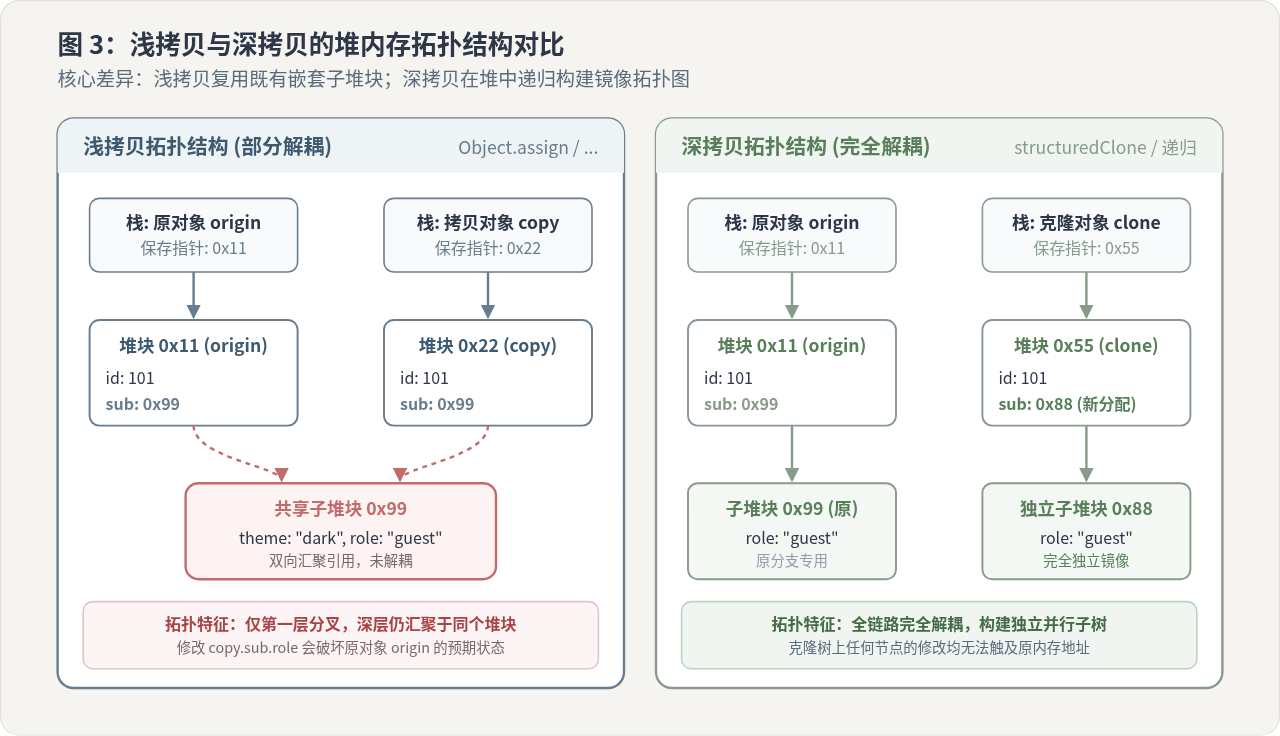
在实际工程中,实现深拷贝主要有以下三种路径,各自具备不同的运行特征与适用边界:
方案 1:现代 Web 原生标准 —— structuredClone()
structuredClone() 是 HTML 规范中定义的基于结构化克隆算法(Structured Clone Algorithm)的原生 API,目前已在主流浏览器(Chrome 98+、Firefox 94+、Safari 15.4+)以及 Node.js 17+ 中获得全量支持。
- 核心优势:由底层 C++ 引擎直接驱动,执行速度远超纯 JS 实现的递归函数;天然支持循环引用解析;完整支持
Map、Set、Date、RegExp、ArrayBuffer及各类类型化数组(Uint8Array等)。 - 严格限制:无法克隆函数方法(遇到函数会抛出
DataCloneErrorDOMException);无法克隆 DOM 节点与 Symbol 键;不保留自定义类的原型链(克隆后退化为纯 Object)。
// 原生 structuredClone 实战示例
const original = {
  title: "架构方案",
  date: new Date(),
  tags: new Set(["JS", "V8"]),
  nested: { count: 100 }
};
// 构建循环引用
original.self = original;

// 深度克隆(完美解耦且不抛栈溢出)
const cloned = structuredClone(original);

cloned.nested.count = 200;
console.log(original.nested.count); // 100 —— 互不影响
console.log(cloned.date instanceof Date); // true —— 保留原生类型
console.log(cloned.self === cloned); // true —— 正确还原循环引用结构
方案 2:轻量级临时方案 —— JSON.parse(JSON.stringify(obj))
通过 JSON 序列化为字符串再反序列化,是一种广为流传的简易深拷贝手段。该方法在处理纯粹的配置数据(纯 JSON 规范类型)时表现良好,但在复杂数据结构中存在大量隐蔽陷阱:
- 属性静默丢失:
undefined、Symbol以及函数在序列化时会被忽略过滤,或者在数组中被强制替换为null; - 内置对象降级变形:
Date对象会被转换为 ISO 格式的字符串,反序列化后无法自动还原为 Date 实例;RegExp和Error会被转换为空对象{};NaN和Infinity会被转为null; - 循环引用直接崩溃:若对象存在自引用或双向循环依赖,执行时会抛出未捕获异常:
TypeError: Converting circular structure to JSON。
方案 3:工业级手写递归深拷贝(解决循环引用与原型链)
当业务数据中混合了成员方法、类实例或自定义 Symbol 键时,原生的 structuredClone 与 JSON 序列化均无法直接满足需求,此时需要手写具备 WeakMap 破环能力的深度克隆算法。
/**
 * 工业级递归深拷贝函数
 * @param {*} target 待拷贝目标
 * @param {WeakMap} hash 缓存已访问对象,避免循环引用导致调用栈溢出
 * @returns {*} 完全解耦的深拷贝副本
 */
function deepClone(target, hash = new WeakMap()) {
  // 1. 处理原始类型及 null
  if (target === null || typeof target !== "object") {
    return target;
  }

  // 2. 处理特殊内置引用对象
  if (target instanceof Date) return new Date(target.getTime());
  if (target instanceof RegExp) return new RegExp(target.source, target.flags);
  if (target instanceof Set) {
    const copySet = new Set();
    hash.set(target, copySet);
    target.forEach(val => copySet.add(deepClone(val, hash)));
    return copySet;
  }
  if (target instanceof Map) {
    const copyMap = new Map();
    hash.set(target, copyMap);
    target.forEach((val, key) => copyMap.set(key, deepClone(val, hash)));
    return copyMap;
  }

  // 3. 检查循环引用:若命中缓存则直接返回对应的新对象引用
  if (hash.has(target)) {
    return hash.get(target);
  }

  // 4. 保留原型链并初始化对应容器(数组或普通对象)
  const cloneTarget = Array.isArray(target)
    ? []
    : Object.create(Object.getPrototypeOf(target));

  // 写入哈希表以防内层递归重复进入
  hash.set(target, cloneTarget);

  // 5. 使用 Reflect.ownKeys 兼顾常规字符串属性与 Symbol 属性
  const keys = Reflect.ownKeys(target);
  for (const key of keys) {
    cloneTarget[key] = deepClone(target[key], hash);
  }

  return cloneTarget;
}
四、拷贝方案选型原则与实战决策指南
在实际项目研发中,“深拷贝更安全”并不意味着应当处处使用深拷贝。深拷贝需要遍历整个对象图并在堆内存中持续申请新空间,当面对万级节点的大型树状数据时,会带来显著的 CPU 计算延迟与 V8 GC 垃圾回收压力。
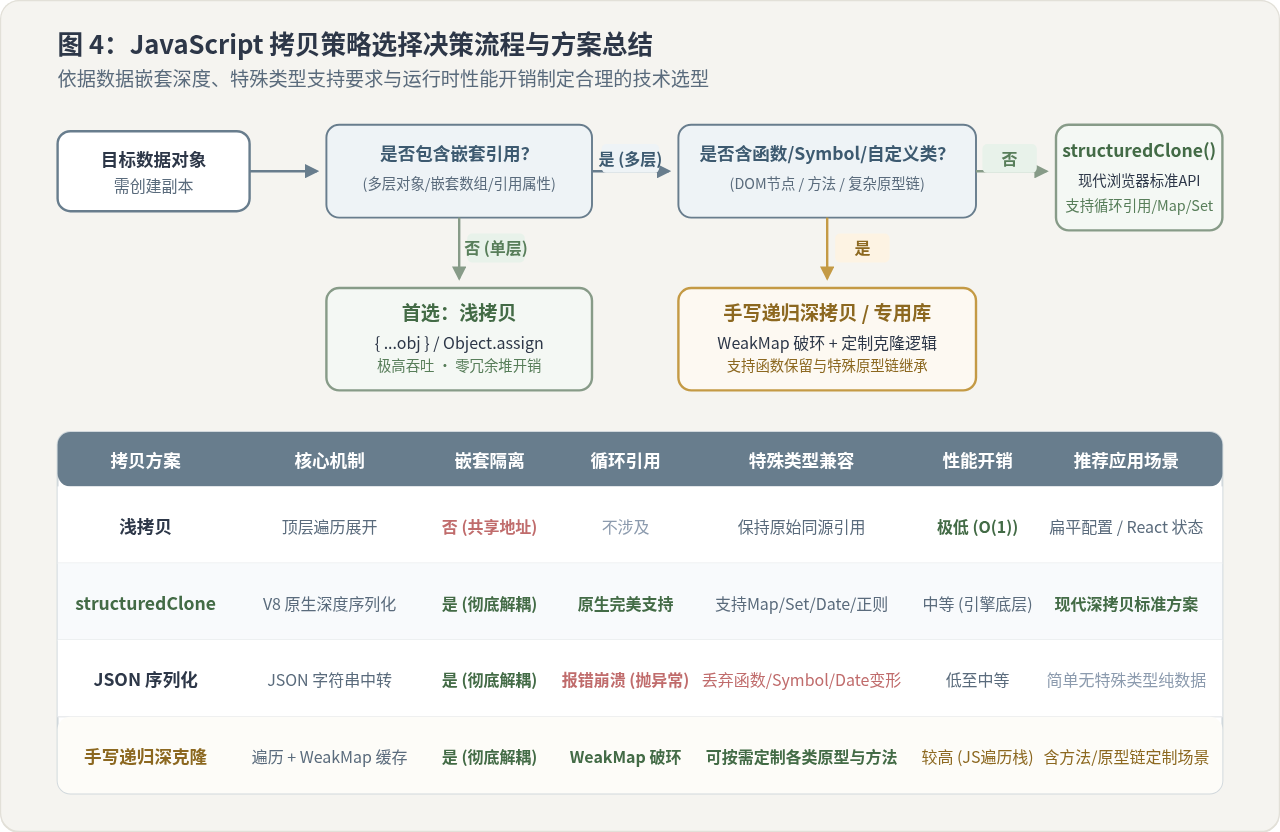
1. 选型匹配矩阵
| 业务场景类型 | 推荐方案 | 核心考量理由 |
|---|---|---|
| 单层扁平配置合并、React 状态不可变更新 | 浅拷贝 ({ ...obj }) |
属性无嵌套引用,耗时仅需数纳秒,零冗余堆内存占用。 |
| 复杂业务表单回滚、图表配置抽离、独立草稿编辑 | 原生 structuredClone() |
深层结构完全解耦;V8 原生 C++ 实现,支持 Date/Map/Set 与循环引用。 |
| 跨端持久化传输存储、简单接口响应缓存 | JSON.parse/stringify |
数据天然符合 JSON 规范,无需依赖高级内置类。 |
| 富富文本编辑器模型、含类实例方法与 Symbol 的核心引擎 | 定制递归深拷贝 (WeakMap) | 保留函数句柄、自定义类原型链以及不可克隆对象的降级处理。 |
五、总结
理解深浅拷贝的差异,本质上是理解 JavaScript 引擎如何在物理内存中排布数据。浅拷贝与深拷贝不是技术优劣的对立,而是对应着不同层级的内存抽象:
- 浅拷贝复制的是“表层结构与引用入口”:适合层级扁平、读多写少、或强调极致吞吐的高频渲染链路;
- 深拷贝复制的是“数据拓扑的物理实体”:适合状态隔离、防御性重写、及需要规避隐式数据污染的复杂业务逻辑。
在现代 JavaScript 技术栈中,应当优先拥抱官方标准 structuredClone() 作为复杂深拷贝的基石,在必要时配合弱引用哈希表(WeakMap)构建边界兼容体系,从而在保障代码健壮性的同时最大化发挥运行时的内存利用效率。
JS运算符优先级与结合性的区别是什么?
2026-11-05 13:22:02
JS Map怎么只遍历Key或Value
2026-11-05 13:00:36
D3.js 与 ECharts 选型对比:灵活性 vs 开发效率
2026-11-05 09:45:01
为什么JS中typeof []返回object:数组类型检测误区解析
2026-11-04 19:50:47
D3.js 新手入门:环境搭建与第一个条形图实现
2026-11-04 10:49:48
相关标签: