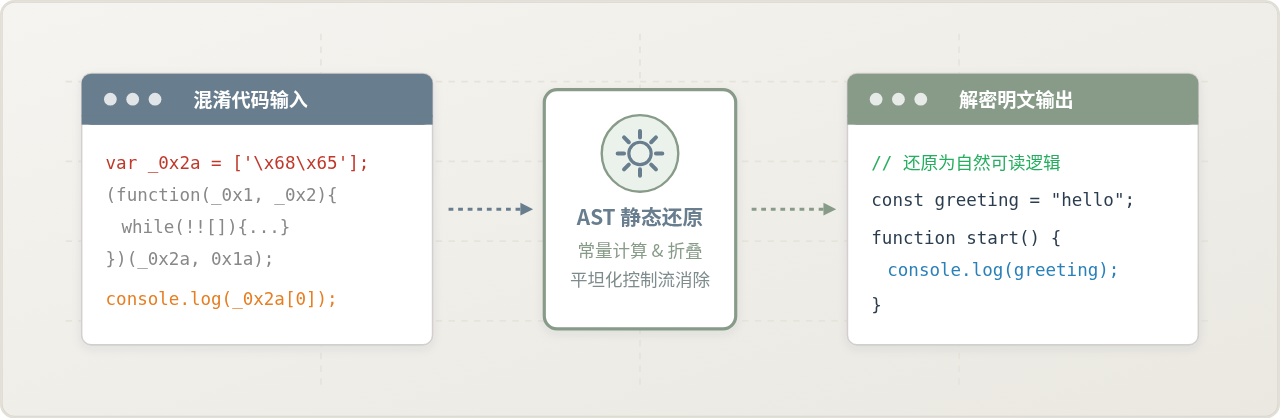
JS反混淆后代码报错或无法运行怎么办?
系统分析JavaScript代码反混淆后出现语法错误、变量未定义、运行时异常及内存卡死的深层根因,提供标准排查流程、自保护陷阱绕过策略与AST安全还原方案。
常见报错表现与故障定性
反混淆后的 JavaScript 往往已经失去了原本的代码形态,在进入调试修复之前,必须根据运行时的具体异常信息进行第一道精准分类。常见的故障表现可以划分为四种典型类型:
- 语法解析失败(SyntaxError: Unexpected token / Invalid left-hand side assignment):通常发生在反混淆脚本处理逗号表达式、自增减操作或复杂三元运算时,将计算表达式错误地放置在赋值语句的左侧,或者在拼接 AST 字符串字面量时遗漏了转义字符。
- 标识符未定义(ReferenceError: xxx is not defined):主要原因是使用全局字符串正则替换变量名,导致不同作用域内的同名变量被误伤,或者混淆器原本依靠
var变量提升建立的闭包引用在重构为块级作用域后断裂。 - 运行时空指针与类型异常(TypeError: Cannot read properties of undefined / not a function):常见于字符串数组解密环节,由于大数组移位(Array Rotation)函数的执行时机错位,导致传入解密函数的索引获取到了
undefined。 - 执行假死、进程崩溃或堆栈溢出(RangeError: Maximum call stack size exceeded):这是最具迷惑性的故障,并非代码语法出错,而是触发了商业混淆器(如 JavaScript-Obfuscator)的自防篡改拦截,激活了无限递归或
while(true)死循环。
系统排查与定位的标准化五步法
面对动辄数千行、即便还原后依然结构晦涩的代码,盲目通读代码极难发现隐蔽错误。建议遵循一套自底向上的标准化排查链路:
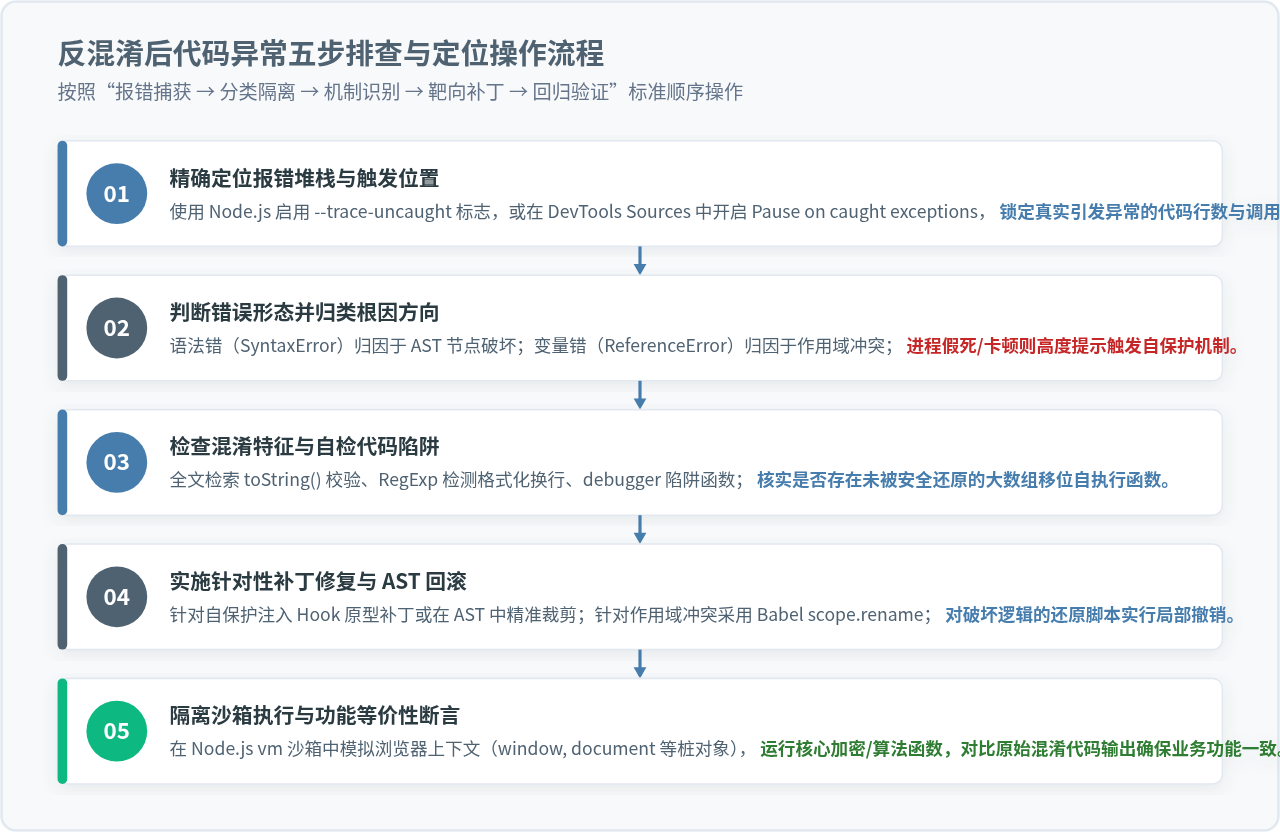
第 1 步:在可控运行时中复现并锁定报错位置
不要直接把反混淆代码放回复杂的大型前端项目中运行。应当将核心逻辑抽离为独立的单文件,在命令行中使用 Node.js 运行:
node --trace-uncaught ./deobfuscated.js
若代码中包含浏览器特有对象(如 window、document、navigator),可以在脚本顶部临时注入基础 Mock 桩对象,或者在 Chrome DevTools 的 Sources 面板中建立 Snippets,开启 Pause on caught exceptions,让断点在异常抛出的第一瞬间暂停。
第 2 步:核对原始混淆代码与还原产物的对应节点
拿到抛错行号后,将其与还原前的原始混淆文件逐行对比。重点观察发生异常的那一行代码在原始文件中对应何种结构:如果原始代码是一个解密函数调用,说明还原脚本在计算静态常量时给出了错误结果;如果原始代码是一段自执行 IIFE,说明其内部包含环境探测逻辑。
第 3 步:搜索并切断自卫代码陷阱
在还原后的代码中全局搜索关键词:toString、search、test、debugger、action。检查是否存在类似 function(){return 'dev'} 并对其进行正则匹配的代码段。这类代码通常用于防御开发者格式化代码,一旦识别到即需优先处理。
第 4 步:针对 AST 转换实施分模块局部撤回
现代反混淆脚本大多由多个 AST Visitor 串联组成(例如:1. 字符串解密 → 2. 算术折叠 → 3. 控制流平坦化展开 → 4. 标识符重命名)。如果最终产物崩溃,应采取“二分法”注销部分 Visitor,逐一验证究竟是哪一个阶段破坏了语义一致性。
第 5 步:在沙箱环境中进行输入输出等价性比对
为确保修复不仅消除了报错,且功能未受损,应编写测试用例给关键函数传入相同的测试参数,验证还原后函数的返回值是否与原始混淆代码完全一致。
诱发报错的深层技术机理剖析
要从根源上修复问题,必须理解反混淆破坏原有代码稳定性的技术机理。混淆器在生成代码时设计了极强的动态依赖,而常规的静态反混淆往往低估了这些约束。
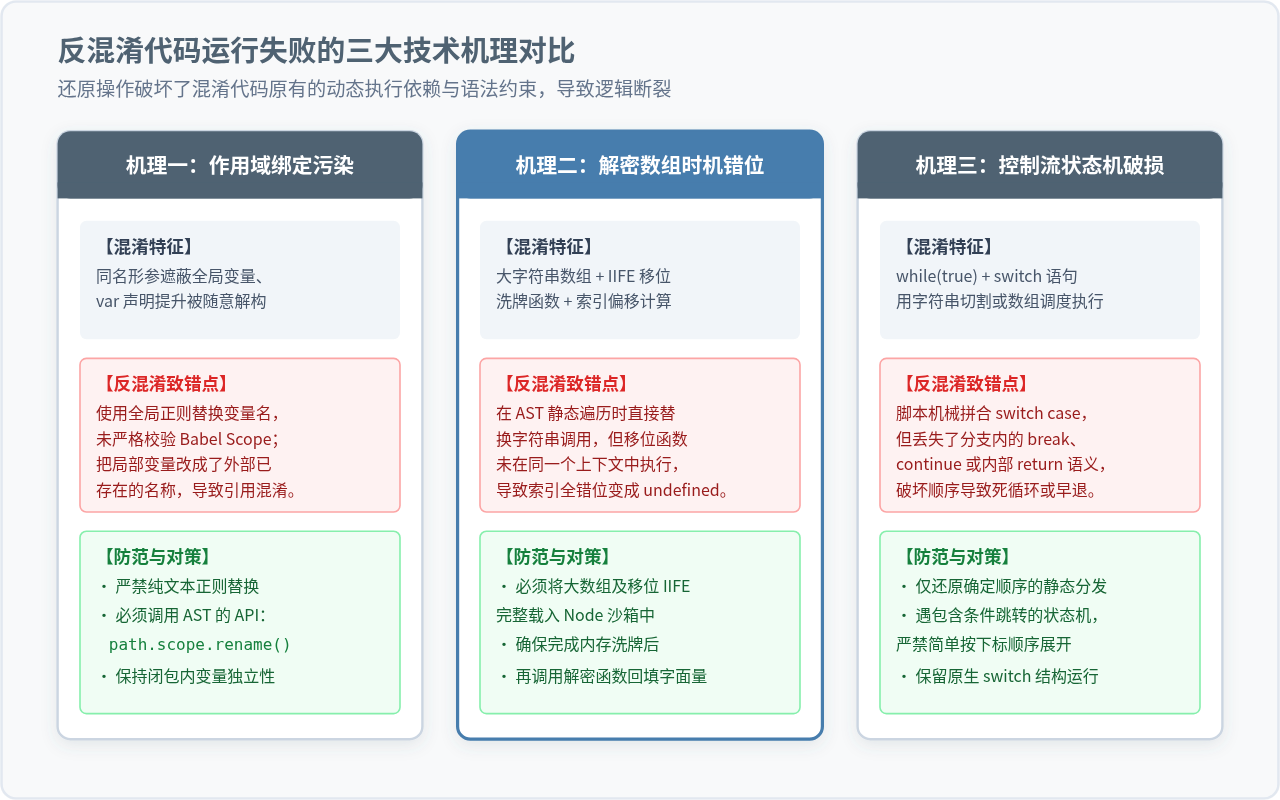
机理一:作用域绑定污染与变量遮蔽
很多开发者为了让反混淆代码更具可读性,会使用简单的字符串匹配或正则表达式批量将诸如 _0x1a2b 替换为可读名称。然而在复杂代码中,相同的短变量名可能在内层闭包与外层函数中重复出现。一旦进行全局替换,局部形参的名字便可能与上层作用域的变量产生冲突,造成变量遮蔽(Variable Shadowing),从而在内层访问外部变量时读取到错误值,抛出 ReferenceError 或逻辑异常。
path.scope.rename() API 执行重命名,它会自动维护词法作用域并避免标识符冲突。
机理二:字符串解密函数与数组移位时机错位
主流混淆器(如 Obfuscator.io)都会构建一个巨大的字符串数组,并在紧随其后的自执行函数(IIFE)中执行数组元素的轮转(Array Rotation/Shift),直到通过某种算法校验。许多反混淆脚本直接把该数组作为静态列表读取,却没有执行移位函数,导致解密函数的偏移量(Offset)完全错位,返回空值或乱码。
机理三:控制流平坦化状态机的死循环与分支遗漏
控制流平坦化将线性的执行流程打散为一个带有分发器(Dispatcher)的 switch-case 结构。有些反混淆脚本尝试根据预设的字符串切片(例如 '3|1|0|2|4'.split('|'))将其还原为扁平语句。如果原代码中某个分支包含动态判断并修改了分发索引,或者包含 continue 语义,简单的机械拼合就会导致状态机脱轨,陷入无限循环。
攻克混淆器“自保护”(Self-Defending)陷阱
当反混淆后的代码一运行就卡死、CPU 占用率飙升到 100%,或者抛出 Maximum call stack size exceeded 时,几乎可以 100% 确定是触发了“自保护机制”。
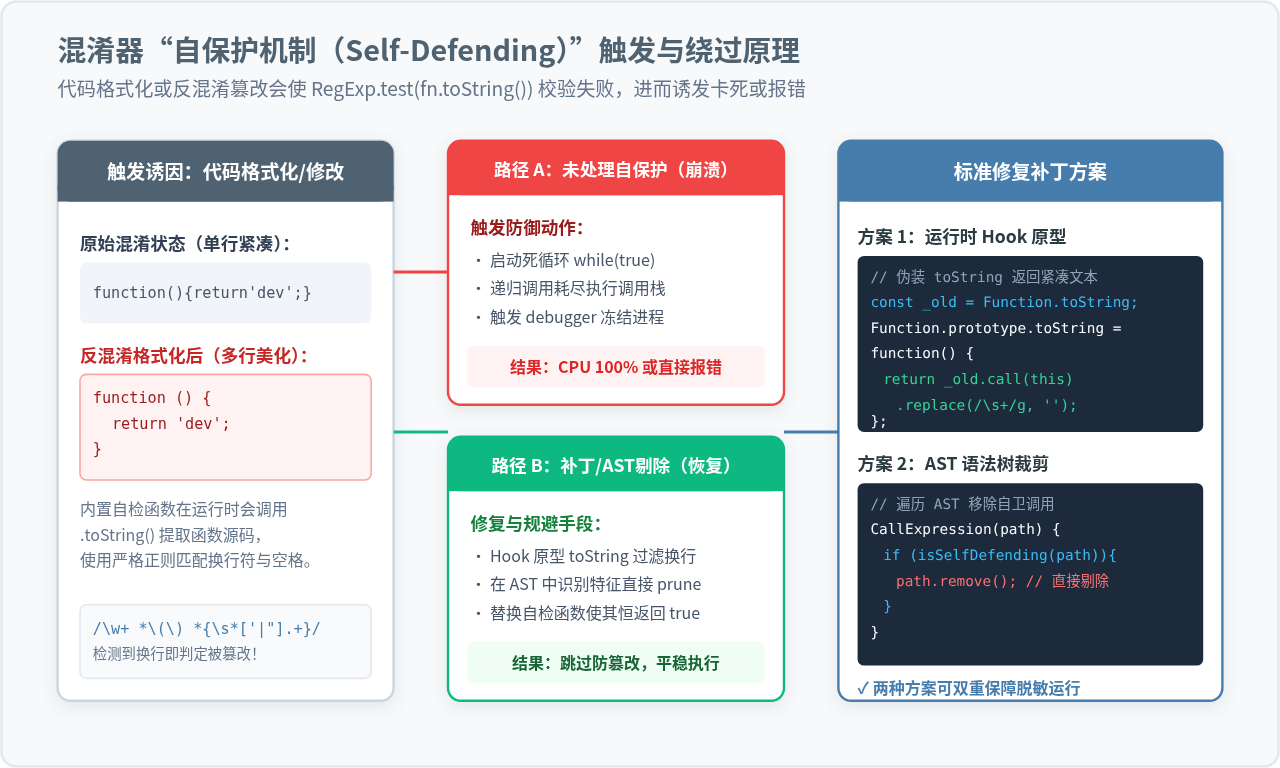
自保护的核心检测逻辑
自保护机制的代码通常会被编译成一个匿名函数。它会获取自身或者某个关键函数的字符串源码,并使用正则表达式进行验证:
// 混淆器内置典型的防格式化检测代码示例
function _0x2c4e() {
  var _0x19a = function() {
    return 'dev';
  };
  // 正则检测该函数是否在一行内,若存在换行或多余缩进则校验失败
  var _0x51b = new RegExp('\\w+ *\\(\\) *{\\s*['|"].+['|"].*}');
  return !_0x51b.test(_0x19a.toString());
}
if (_0x2c4e()) {
  // 触发自毁:无限递归调用或分配巨量数组导致内存溢出
  (function() {
    while (true) {}
  })();
}
在反混淆过程中,我们通常会对代码进行格式化(Beautify/Prettify)以便阅读,这直接破坏了单行特征,导致 test() 校验失败,触发死循环。
实战修复方案
针对自保护机制,有两种行之有效的应对方案:
-
方案一:运行时 Hook
Function.prototype.toString(轻量快捷)在加载反混淆代码的最开头注入一段 Hook 代码,抹平换行和缩进,让所有函数在被转为字符串时伪装成单行代码:
// 在反混淆代码顶部注入的原型修补代码 const originalToString = Function.prototype.toString; Function.prototype.toString = function() { const code = originalToString.call(this); // 过滤换行符与多余空格,满足自检正则的要求 return code.replace(/\s+/g, ' '); }; -
方案二:在 AST 层面精准剔除自卫节点(彻底根治)
编写 Babel 脚本,识别出包含
toString()校验或空循环的 IIFE 函数调用表达式,直接调用path.remove()将其从抽象语法树中删除。自卫函数本身不包含任何业务计算,删除后代码不仅能正常运行,还能显著提升执行性能。
安全还原与代码重构实操指南
为了从根本上避免反混淆导致代码损坏,在编写或修改自动化 AST 还原脚本时,应当遵循以下工程规范:
1. 安全提取动态解密字典
提取混淆代码中的大数组与解密函数时,推荐使用 Node.js 的原生 vm 模块在隔离上下文中执行解密逻辑,而非试图通过静态 AST 计算解密过程:
const vm = require('vm');
const fs = require('fs');

// 提取原文件中仅包含大数组和移位 IIFE 的头部代码
const setupCode = extractSetupSnippet(rawCode);

// 构建包含基础运行环境的沙箱
const sandbox = {
  window: {},
  document: {},
  Function: Function,
  String: String
};
const context = vm.createContext(sandbox);

// 在安全沙箱中执行初始化代码,完成内存中的数组轮转
vm.runInContext(setupCode, context);

// 后续在 AST 遍历解密调用点时,直接在 context 中求值替换为 StringLiteral
function safeDecrypt(callNodeStr) {
  return vm.runInContext(callNodeStr, context);
}
2. 谨防逗号表达式的不当展开
混淆代码中充斥着形如 (a = 1, b = 2, c = a + b) 的序列表达式(SequenceExpression)。在将其拆解为独立语句时,务必注意返回值的接收者。若该表达式位于 return 或赋值操作中,直接拆分会导致运算优先级倒挂。建议仅对处于顶层表达式语句(ExpressionStatement)中的逗号序列进行展开。
故障排查决策矩阵与验证清单
排查反混淆异常时,可对照下表提供的决策矩阵,按步骤快速锁定核心线索:
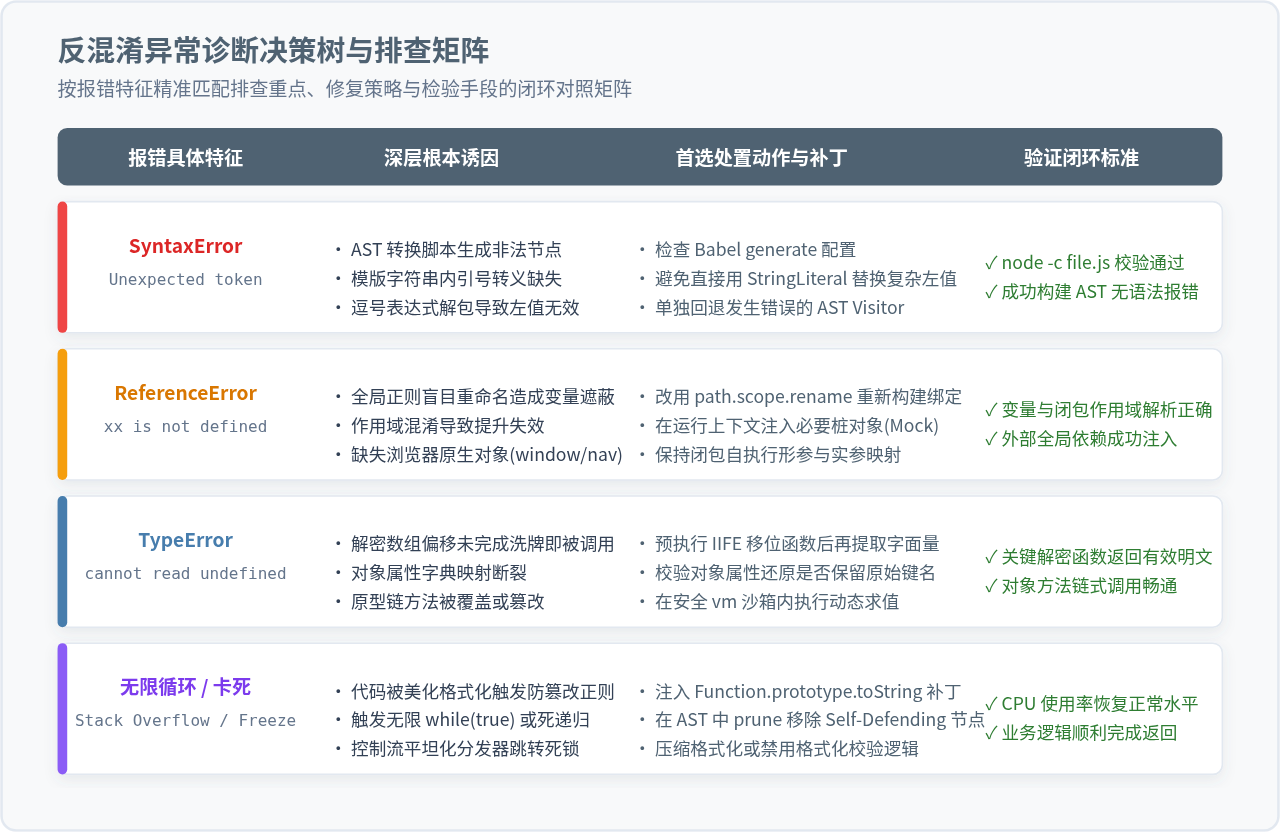
| 错误形态 | 主要诱因 | 推荐排查与修复方案 | 验收标准 |
|---|---|---|---|
SyntaxError: Unexpected token |
AST 生成非法节点、三元/赋值运算符左值破坏、转义字符丢失 | 检查 Babel generator 配置;定位到具体 AST 节点;回滚该类节点的转换 Visitor | node -c file.js 语法解析零错误,代码能被正常 AST 解析 |
ReferenceError: xx is not defined |
盲目全局正则替换变量名;提升变量作用域被破坏;缺失全局对象 | 放弃纯文本替换,改用 path.scope.rename();向运行环境注入 Mock 桩对象 |
作用域内标识符全部具备有效绑定(Binding),无游离变量引用 |
TypeError: cannot read property |
解密数组移位未执行;静态提取索引错位;对象属性映射断裂 | 在 Node 沙箱中先完整执行移位 IIFE 再求值;保留未识别的原生调用 | 解密函数稳定返回正确的字符串字面量,对象属性调用畅通 |
| 卡死 / CPU 100% / 栈溢出 | 美化代码触发 Self-Defending 正则校验;控制流状态机死循环 |
注入 Function.prototype.toString 伪装补丁;在 AST 中移除自防篡改节点 |
代码执行平稳,无阻塞卡顿,函数执行完毕后正常返回结果 |
怎么用 Promise 封装 JavaScript sleep 函数实现异步延时
2026-11-05 17:49:14
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
相关标签: