JavaScript下载进度条怎么做?监听XMLHttpRequest与fetch进度事件
深入讲解在前端使用JavaScript实现下载进度条的两种主要方案:通过XMLHttpRequest原生监听progress事件,以及使用现代Fetch API配合ReadableStream进行流式分块累加。分析核心原理、HTTP报头要求、无定进度条降级与跨域处理。
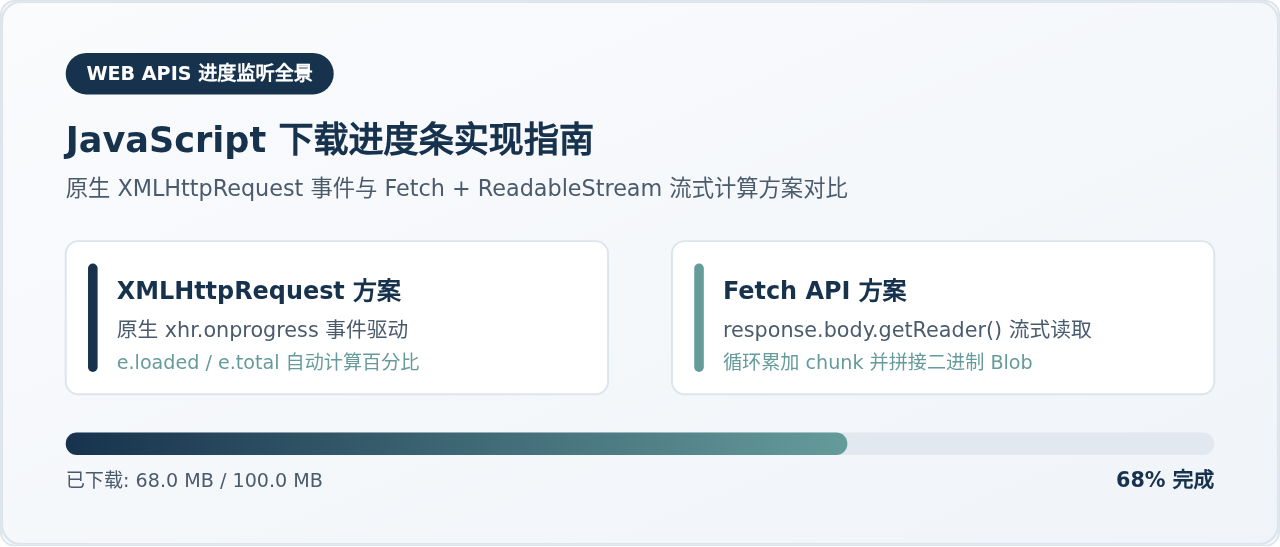
图 0:JavaScript 监听下载进度条的两种主流实现路径
XMLHttpRequest;另一种则是使用现代化的 Fetch API 结合 ReadableStream 数据流进行手动分块计算。
一、下载进度计算的核心原理与前置条件
无论使用哪种技术,浏览器计算下载进度的数学公式都是一致的:
进度百分比 = (已接收字节数 / 文件总字节数) * 100%。
这就要求浏览器在下载过程中,必须能够获知这两个关键数据。
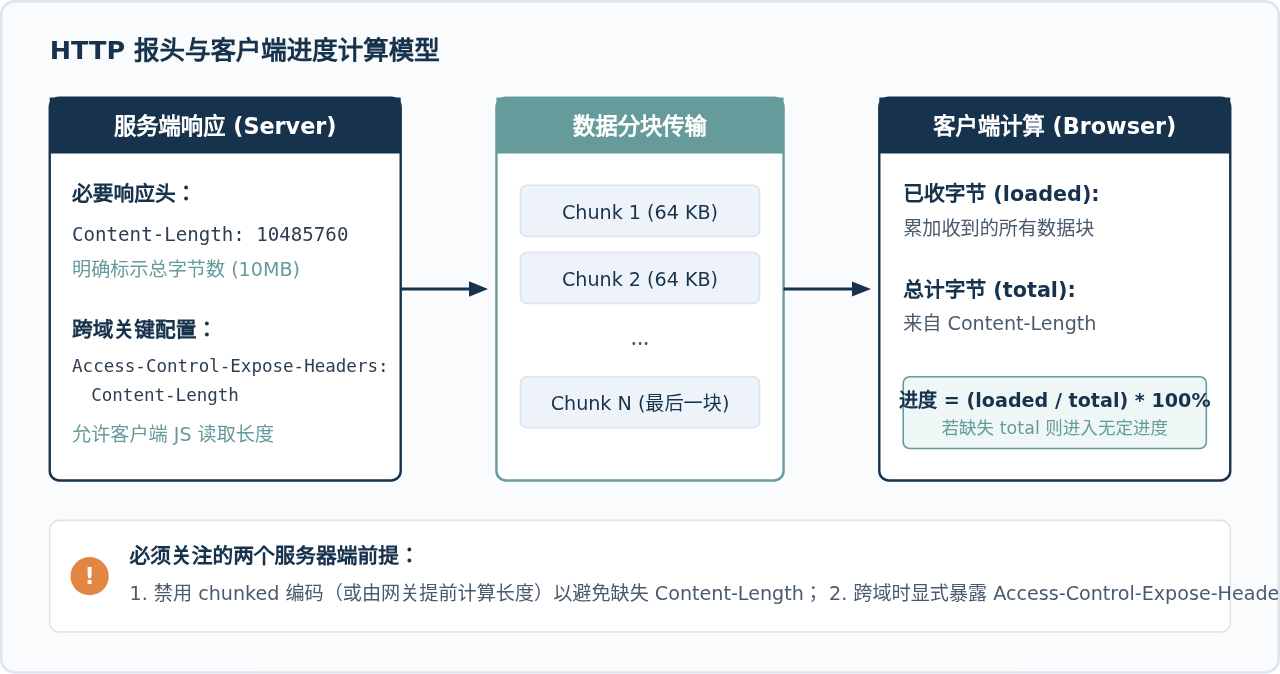
图 1:下载进度计算的核心报头依赖与数据流转
实现进度计算的前提条件包括:
-
服务端必须提供
Content-Length响应头: 如果服务端采用动态流式传输(如开启了Transfer-Encoding: chunked且未指定具体文件长度),或者使用了 Gzip/Brotli 压缩而未提供解压缩前大小,浏览器就无法得知总长度,导致e.lengthComputable为false。此时只能显示“已下载 XX MB”,而无法计算百分比。 -
跨域请求时必须暴露报头:
当资源存在跨域(CORS)时,浏览器出于安全策略默认只会暴露几个简单的响应头。如果要读取
Content-Length,服务端必须在响应中配置:Access-Control-Expose-Headers: Content-Length。
二、方案一:使用 XMLHttpRequest 监听 progress 事件
在很多人的印象中 XMLHttpRequest(简称 XHR)是较旧的 API,但在监听下载进度方面,XHR 是最直接、最稳定且原生封装最完善的方案。XHR 对象原生提供了 progress 事件,当网络接收到新数据包时就会持续触发该事件。
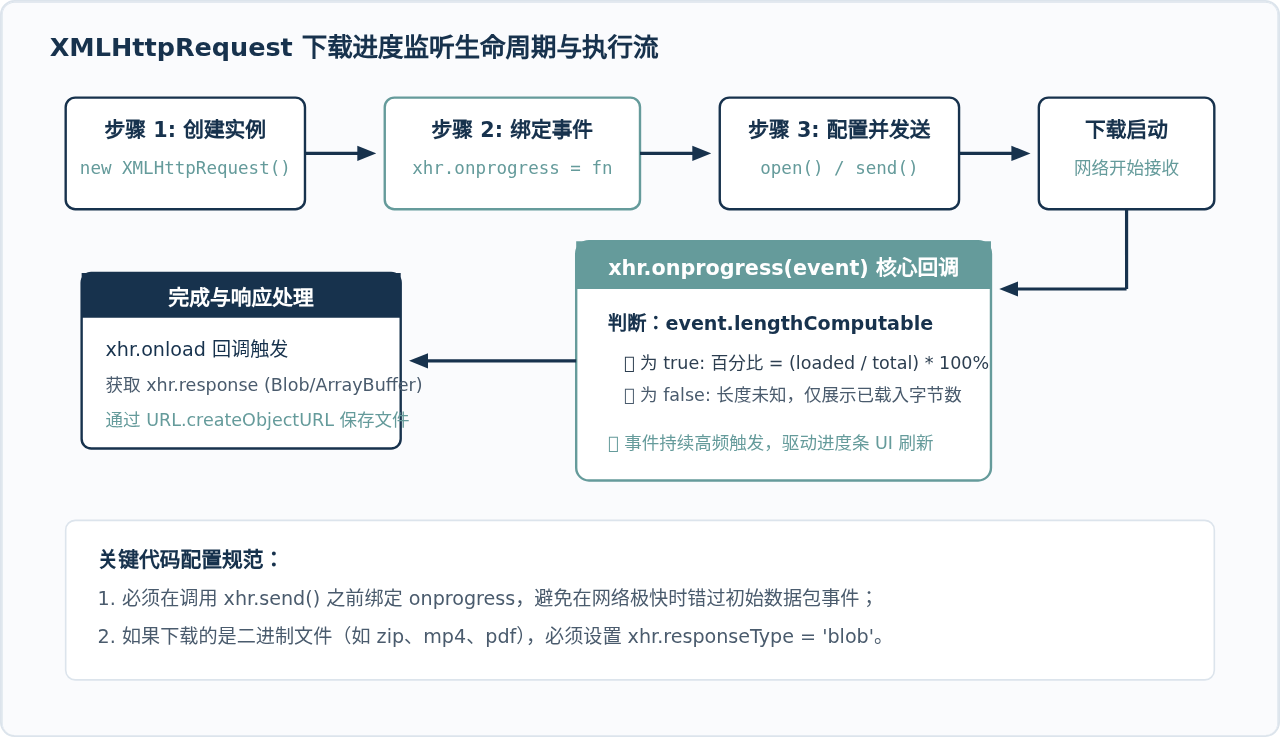
图 2:XMLHttpRequest 进度事件监听步骤与内部状态流转
完整代码示例:XMLHttpRequest 实现下载与进度条更新
以下是使用 XMLHttpRequest 下载大文件并驱动界面进度条的完整、可运行代码。
// 使用 XMLHttpRequest 监听下载进度
function downloadWithXHR(url, filename) {
  const progressBar = document.getElementById('progress-bar');
  const progressText = document.getElementById('progress-text');

  const xhr = new XMLHttpRequest();
  xhr.open('GET', url, true);

  // 设置响应类型为 blob,用于二进制文件下载
  xhr.responseType = 'blob';

  // 1. 监听下载进度
  xhr.onprogress = function (event) {
    if (event.lengthComputable) {
      // 获得总大小与当前接收大小
      const percentComplete = (event.loaded / event.total) * 100;
      const loadedMB = (event.loaded / (1024 * 1024)).toFixed(2);
      const totalMB = (event.total / (1024 * 1024)).toFixed(2);

      // 更新界面
      progressBar.style.width = percentComplete + '%';
      progressText.textContent = `${percentComplete.toFixed(1)}% (${loadedMB}MB / ${totalMB}MB)`;
    } else {
      // 当无法获取 Content-Length 时
      const loadedMB = (event.loaded / (1024 * 1024)).toFixed(2);
      progressText.textContent = `已下载: ${loadedMB}MB (总大小未知)`;
    }
  };

  // 2. 监听下载完成
  xhr.onload = function () {
    if (xhr.status === 200) {
      const blob = xhr.response;
      // 创建虚拟下载链接并自动点击触发保存
      const downloadUrl = window.URL.createObjectURL(blob);
      const a = document.createElement('a');
      a.href = downloadUrl;
      a.download = filename || 'downloaded_file';
      document.body.appendChild(a);
      a.click();
      a.remove();
      // 释放内存中的临时 Object URL
      window.URL.revokeObjectURL(downloadUrl);
      progressText.textContent = '下载完成!';
    } else {
      progressText.textContent = `下载失败,HTTP状态码: ${xhr.status}`;
    }
  };

  // 3. 错误处理
  xhr.onerror = function () {
    progressText.textContent = '网络连接异常,下载失败';
  };

  // 4. 发送请求
  xhr.send();
}
三、方案二:使用 Fetch API 与 ReadableStream 实现进度监听
现代前端项目中广泛使用基于 Promise 的 fetch() API。但是,原生的 fetch() 并没有像 XHR 那样提供 onprogress 回调参数。
为了在 Fetch 中实现进度条,我们必须借助于浏览器的 Streams API,即访问 response.body 的流式读取器 ReadableStreamDefaultReader。我们按块(chunk)循环读取网络流,并在读取每块时自行累加字节数,进而手动驱动进度条。
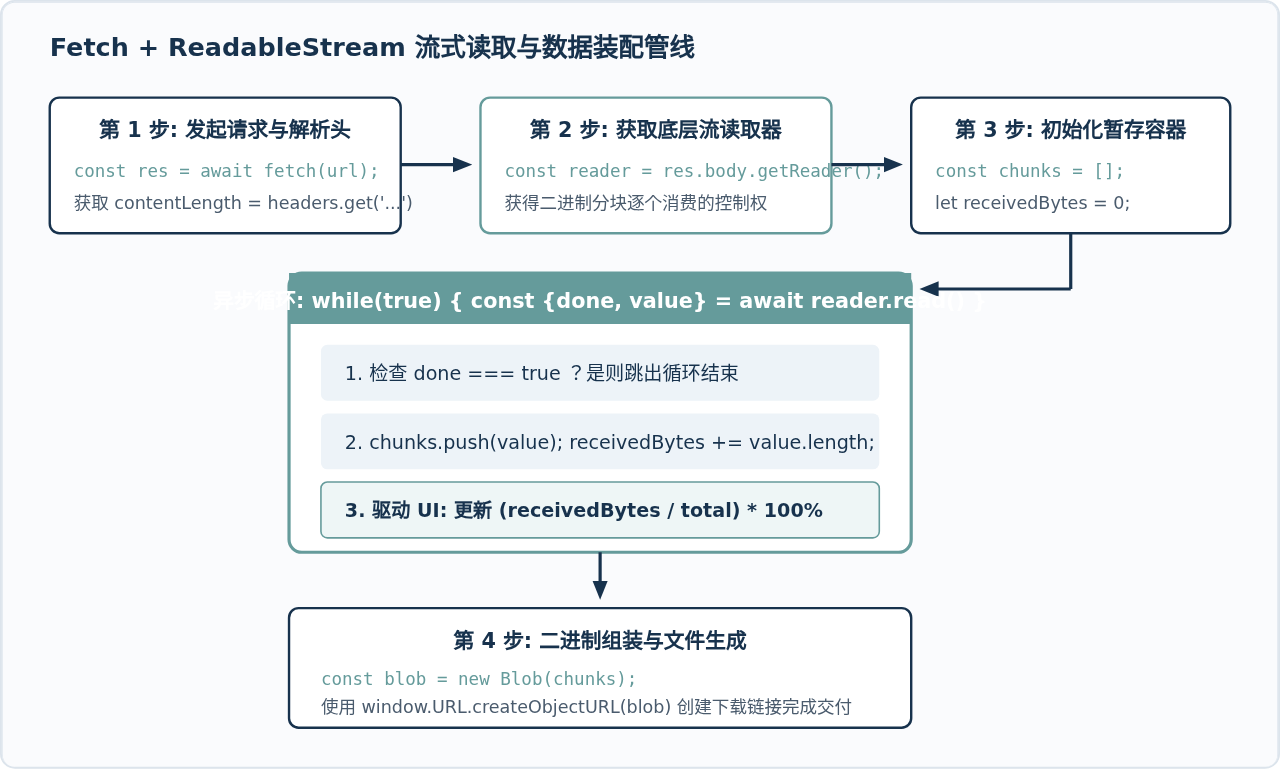
图 3:Fetch 结合 ReadableStream 的流式消费与分块组装管道
完整代码示例:Fetch + ReadableStream 实现带进度的下载
Fetch 方案虽然代码量略大于 XHR,但它完全基于现代异步语法 async/await,非常契合工程化规范:
// 使用 Fetch API + ReadableStream 监听下载进度
async function downloadWithFetch(url, filename) {
  const progressBar = document.getElementById('progress-bar');
  const progressText = document.getElementById('progress-text');

  try {
    const response = await fetch(url);

    if (!response.ok) {
      throw new Error(`HTTP error! status: ${response.status}`);
    }

    // 1. 获取响应体总长度
    const contentLength = response.headers.get('content-length');
    const totalBytes = contentLength ? parseInt(contentLength, 10) : 0;

    // 2. 获取 ReadableStream 的读取器
    const reader = response.body.getReader();
    let receivedBytes = 0;
    const chunks = []; // 用于收集每个 Uint8Array 分块

    // 3. 循环读取流数据
    while (true) {
      const { done, value } = await reader.read();

      if (done) {
        break; // 流已读取完毕
      }

      chunks.push(value);
      receivedBytes += value.length;

      // 4. 计算并更新进度
      if (totalBytes > 0) {
        const percent = (receivedBytes / totalBytes) * 100;
        const loadedMB = (receivedBytes / (1024 * 1024)).toFixed(2);
        const totalMB = (totalBytes / (1024 * 1024)).toFixed(2);

        progressBar.style.width = percent + '%';
        progressText.textContent = `${percent.toFixed(1)}% (${loadedMB}MB / ${totalMB}MB)`;
      } else {
        const loadedMB = (receivedBytes / (1024 * 1024)).toFixed(2);
        progressText.textContent = `已下载: ${loadedMB}MB (总大小未知)`;
      }
    }

    // 5. 将分块数组合并为最终的 Blob
    const blob = new Blob(chunks);
    const downloadUrl = window.URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = downloadUrl;
    a.download = filename || 'downloaded_file';
    document.body.appendChild(a);
    a.click();
    a.remove();
    window.URL.revokeObjectURL(downloadUrl);

    progressText.textContent = '下载完成!';
  } catch (error) {
    progressText.textContent = `下载异常: ${error.message}`;
  }
}
四、异常场景与工程化边界处理
在实际生产环境中,网络情况和后端配置十分复杂,实现下载进度条时常会遇到以下边界问题:
1. 缺失 Content-Length 时的“无定进度条”(Indeterminate Progress)
当后端使用动态流压缩或分块传输时,totalBytes 为 0 或 NaN。此时严禁直接显示 NaN% 或进度条归零卡死。
正确的交互策略是切换为无定进度条:在界面上保留左右来回滑动的条纹动画(或旋转指示器),文本区域实时更新“已下载: 15.4 MB”,向用户明确表明传输仍在正常进行。
2. 超大文件导致的内存占用问题
不管是 XHR 的 xhr.responseType = 'blob' 还是 Fetch 的 chunks.push(value),数据最终都是缓存在浏览器的 JavaScript 堆内存或临时交换区中。
chunks 可能引发浏览器内存溢出(OOM)崩溃。针对此类场景,应借助 showSaveFilePicker(File System Access API)或第三方流式写入方案(如 StreamSaver.js),将收到的 chunk 直接流式写入本地硬盘,而非保存在内存数组中。
五、XHR 与 Fetch 方案全面对比与选型决策
在不同业务需求下,应该如何在这两种方案中做出取舍?我们可以从开发复杂度、运行时能力以及项目技术栈等维度进行考量。
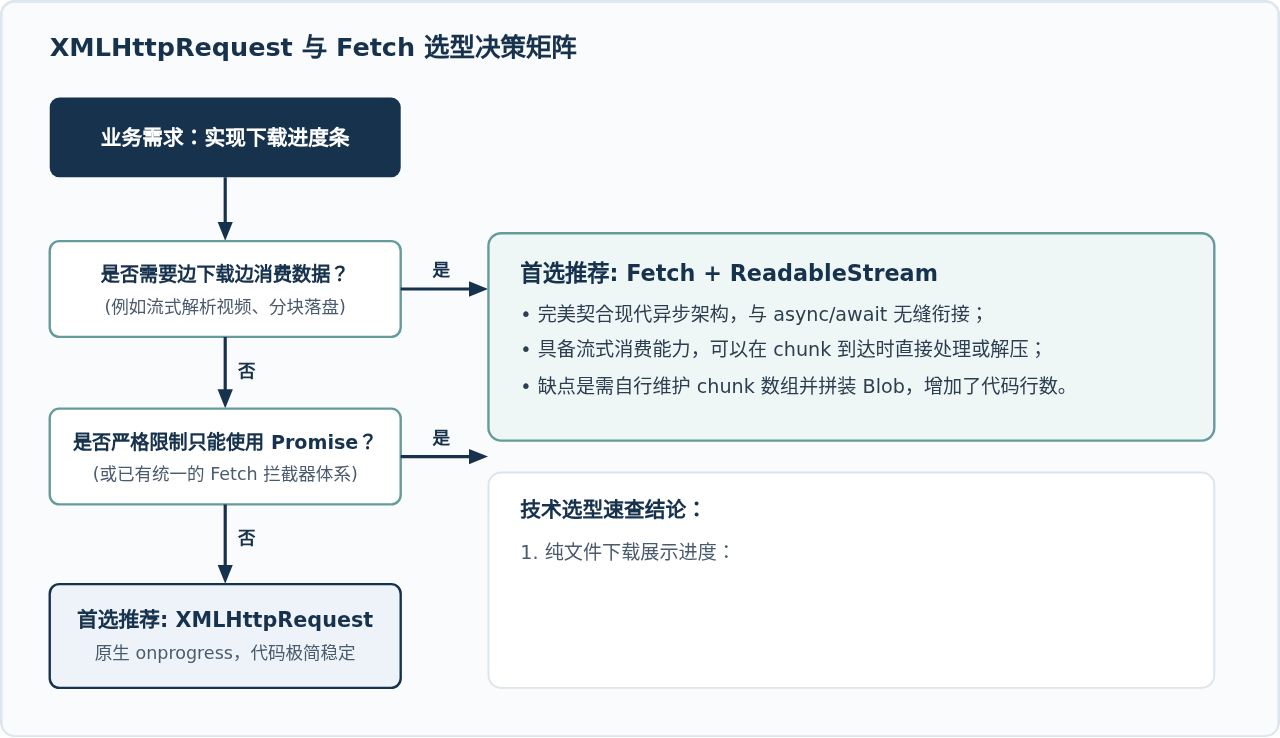
图 4:XMLHttpRequest 与 Fetch 场景选型决策流
| 特性维度 | XMLHttpRequest | Fetch + ReadableStream |
|---|---|---|
| 原生进度支持 | 原生具备 xhr.onprogress 事件,开箱即用 |
无原生回调,需通过 reader.read() 手动循环累加 |
| 代码实现复杂度 | 低(仅需几行事件回调即可更新 UI) | 中(需处理异步循环、状态标志与二进制重组) |
| API 风格 | 基于事件监听与回调模型(可封装为 Promise) | 基于现代 Promise 与 async/await 语法 |
| 流式边下边读 | 不支持边下载边向外部分流处理 | 天然支持数据流管道管道传输(Piping) |
| 上传进度支持 | 支持 xhr.upload.onprogress 监听上传 |
浏览器端目前无法监听请求体上传进度 |
| 请求中断取消 | 使用 xhr.abort() |
使用 AbortController 信号机制 |
六、总结与落地建议
在 JavaScript 中制作下载进度条,核心并不在于界面的 CSS 绘制,而在于对网络层数据传输的准确捕获:
-
确认服务端配置:在编写代码前,先在浏览器 DevTools 网络面板确认响应头中是否存在
Content-Length。如果是跨域接口,确认服务端是否设置了Access-Control-Expose-Headers: Content-Length。 -
单纯下载优先使用 XHR:如果只是需要“点击按钮 - 下载文件 - 看到进度条”,
XMLHttpRequest能够用最少的代码达成目标,且稳定性历经验证。 -
现代化技术栈选用 Fetch Stream:如果团队有统一的 Fetch 封装,或者需要边下载边进行业务解密/流式处理,则推荐采用
ReadableStream方案,将流式读取逻辑封装为通用自定义 Hook 或工具模块。 -
做好降级保护:始终在代码中保留对
lengthComputable === false或contentLength === null的处理逻辑,降级为无定进度条或已下载大小提示,保证界面的健壮性。
JS怎么使用classList添加、删除和切换class
2026-11-05 17:26:02
网页开发三者分工:HTML结构、CSS样式与JavaScript交互怎么协作
2026-11-05 12:51:22
JS解析URL参数时怎么处理中文乱码和特殊字符
2026-11-05 12:47:23
js-cookie 存储 JSON 对象:自动序列化与反序列化技巧
2026-11-05 12:36:26
marked.js 快速上手:安装与基础 Markdown 转 HTML 示例
2026-11-05 09:32:53