

marked.js 快速上手:安装与基础 Markdown 转 HTML 示例
本教程详细讲解 marked.js 的快速上手方法,包括 Node.js 与浏览器环境的安装引入、marked.parse() 基础转换示例、常用配置选项以及 XSS 安全防御方案。
在开发文档中心、博客后台或即时文本编辑器时,把用户输入的 Markdown 标记转换成浏览器能够识别的 HTML 结构是一项常见需求。marked.js(通常简称为 marked)是一个用纯 JavaScript 编写的低依赖、高速度编译器,专门负责将 Markdown 格式的原始字符串解析为标准的 HTML 标签字符串。本文直接介绍 marked.js 在 Node.js 服务端与原生浏览器环境中的接入方法,并通过完整的代码示例展示基础转换调用与安全注意事项。
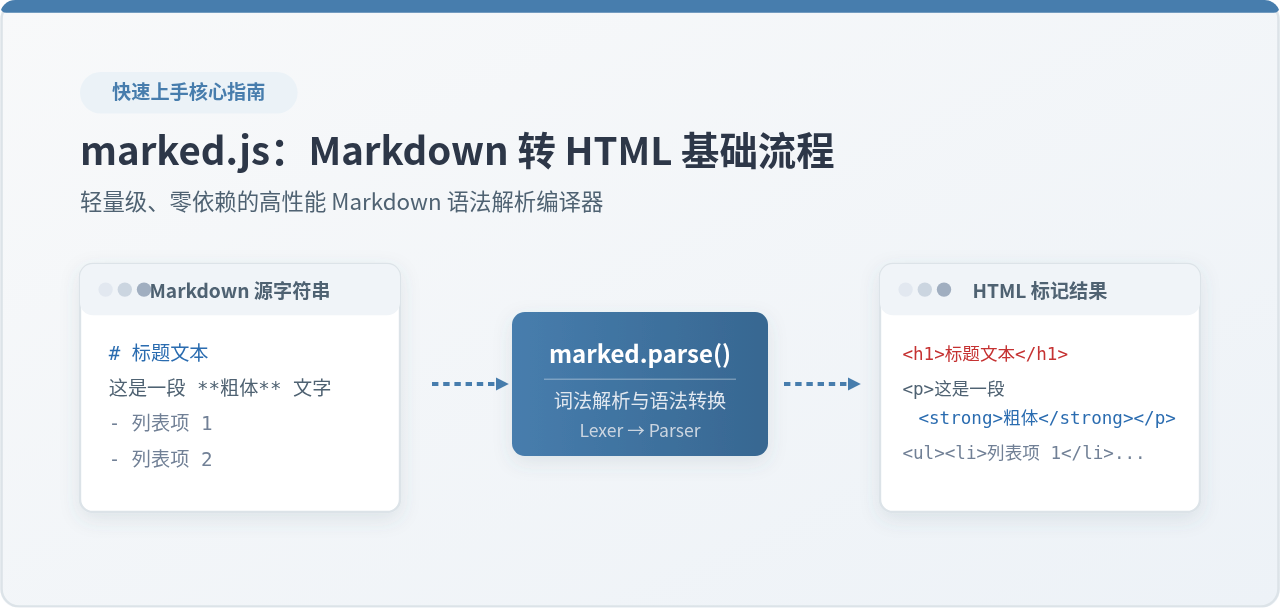
一、环境准备与安装方式
marked.js 既可以作为 npm 依赖项集成到工程化项目中(例如 Node.js 服务端脚本、Webpack/Vite 打包流水线),也可以直接通过 CDN 链接在原生 HTML 网页中以 <script> 标签引入。开发者可根据当前项目的架构模式选择适合的引入方式。
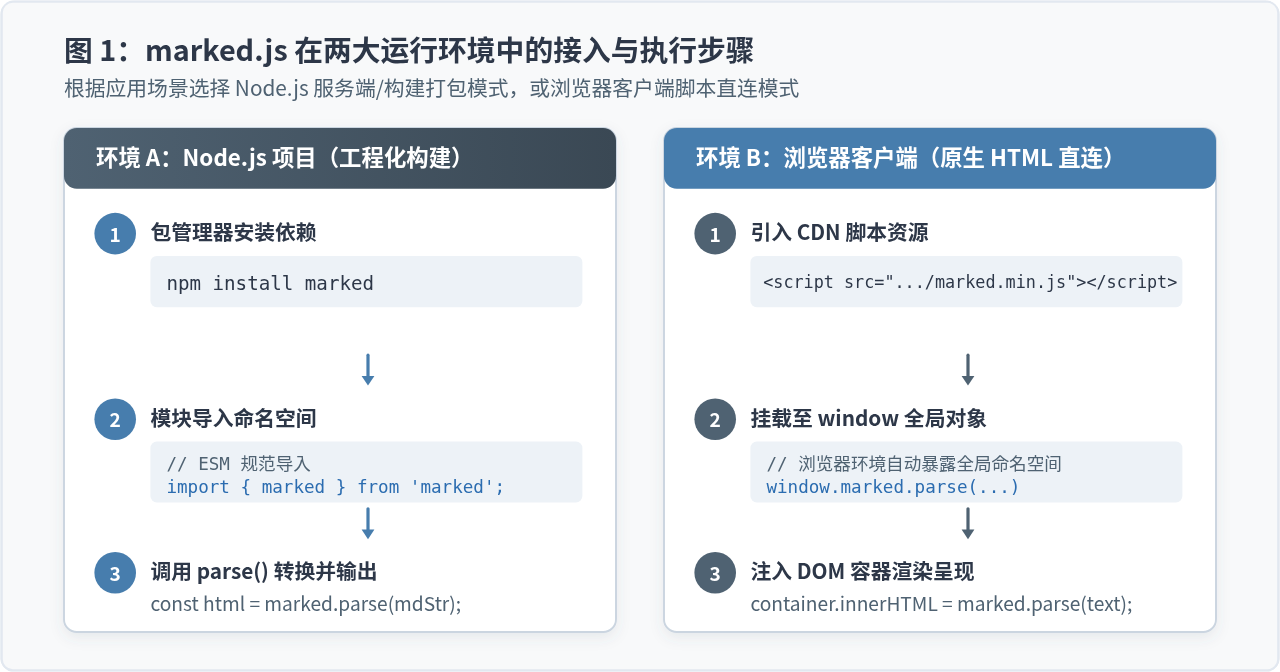
1. 在 Node.js 项目中安装
打开终端并定位到项目根目录,运行如下 npm 命令安装 marked:
终端安装命令npm install marked安装完成后,根据项目采用的模块化规范在代码中引入:
- ESM(ECMAScript 模块,推荐):
import { marked } from 'marked'; - CommonJS(传统 Node.js 模块):
const { marked } = require('marked');
{ marked } 提取核心对象,或者直接使用 marked.parse() 方法,切勿像早期版本那样将默认导入项直接当作函数调用。
2. 在浏览器原生 HTML 中引入
如果不使用构建工具,只需在 HTML 页面的 <head> 或 <body> 底部加入官方 CDN 脚本即可:
<!-- 引入 marked 生产压缩包 -->
<script src="https://cdn.jsdelivr.net/npm/marked/marked.min.js"></script>
脚本加载完成后,全局对象 window.marked 便会自动挂载就绪,可直接调用 marked.parse()。
二、marked.js 内部转换原理
理解 marked 的执行过程有助于在面对复杂排版或编写自定义插件时快速定位问题。marked 内部采用经典的编译器三阶段流水线设计:输入字符串首先经过词法分析器(Lexer),按块级(Block)与行内(Inline)语法拆解为 Tokens 数据结构;随后语法解析器(Parser)遍历 Tokens;最终通过渲染器(Renderer)将各类语义节点映射并拼装为对应的标准 HTML 标签。
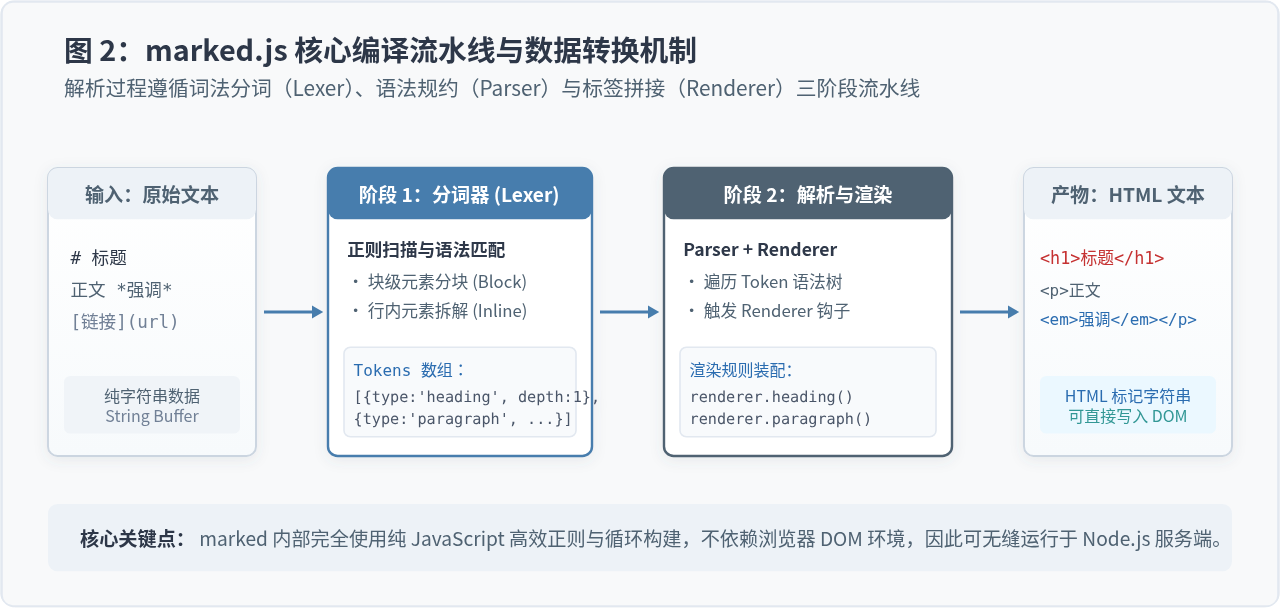
由于这套流程全程仅使用 JavaScript 正则表达式与纯字符串拼接,不依赖任何特定平台的底层库,也不直接操作 DOM,因此它的执行开销极小,跨平台一致性非常高。
三、基础转换代码示例
marked.js 最核心的 API 就是 marked.parse()。该方法接收一个 Markdown 字符串作为必填参数,返回对应的 HTML 字符串。
1. Node.js 独立运行示例
以下为一个在 Node.js 环境下读取 Markdown 文本并转换为 HTML 的完整脚本。创建文件 example.mjs 并写入以下内容:
import { marked } from 'marked';

// 准备一段包含标题、强调、列表与链接的 Markdown 文本
const markdownText = `
# 快速上手指南

这是一个使用 **marked.js** 进行语法解析的段落。

### 常用特性
- 零依赖架构
- 执行速度飞快
- 支持 GitHub 风格的 Markdown (GFM)

访问 [marked 官网](https://marked.js.org) 获取完整文档。
`;

// 调用 marked.parse() 进行同步转换
const htmlOutput = marked.parse(markdownText);

// 打印转换产物
console.log('--- 转换生成的 HTML 内容 ---');
console.log(htmlOutput);
在终端执行该文件(示例命令与实际打印输出如下):
终端运行与示例输出$ node example.mjs
--- 转换生成的 HTML 内容 ---
<h1>快速上手指南</h1>
<p>这是一个使用 <strong>marked.js</strong> 进行语法解析的段落。</p>
<h3>常用特性</h3>
<ul>
<li>零依赖架构</li>
<li>执行速度飞快</li>
<li>支持 GitHub 风格的 Markdown (GFM)</li>
</ul>
<p>访问 <a href="https://marked.js.org">marked 官网</a> 获取完整文档。</p>2. 浏览器端实时渲染示例
在网页端,可以将多行文本输入框(<textarea>)与展示容器(<div>)关联起来。以下是一个开箱即用的单文件 HTML 示例:
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>marked.js 浏览器演示</title>
  <!-- 引入 marked 浏览器脚本 -->
  <script src="https://cdn.jsdelivr.net/npm/marked/marked.min.js"></script>
  <style>
    .container { display: flex; gap: 20px; max-width: 900px; margin: 30px auto; }
    textarea, #preview { flex: 1; min-height: 260px; padding: 12px; border: 1px solid #ccc; border-radius: 6px; }
    #preview { background: #fafafa; overflow-y: auto; }
  </style>
</head>
<body>
  <div class="container">
    <!-- Markdown 输入区域 -->
    <textarea id="markdown-input" placeholder="请输入 Markdown 文本...">## 即时渲染测试

输入任意内容,**右侧实时变化**!</textarea>

    <!-- HTML 结果渲染区域 -->
    <div id="preview"></div>
  </div>

  <script>
    const inputArea = document.getElementById('markdown-input');
    const previewArea = document.getElementById('preview');

    function renderMarkdown() {
      const rawText = inputArea.value;
      // 调用全局 marked.parse 方法转换并注入页面
      previewArea.innerHTML = marked.parse(rawText);
    }

    // 监听输入事件实现动态响应
    inputArea.addEventListener('input', renderMarkdown);
    // 初次加载主动触发一次渲染
    renderMarkdown();
  </script>
</body>
</html>
四、常用解析选项与配置方式
在默认情况下,marked 遵循标准的 GitHub Flavored Markdown (GFM) 规范。但在某些场景下,我们需要调整特定解析行为(例如控制换行符是否直接转为 <br>)。现代 marked 推荐使用 marked.use() 方法进行全局参数注册。
| 配置项 | 默认值 | 功能说明 |
|---|---|---|
gfm |
true |
是否启用 GitHub 风格的 Markdown 语法扩展(如表格、删除线、任务列表等)。 |
breaks |
false |
是否将单次回车换行转换为 <br> 标签。默认 false 时遵循 CommonMark 规范(需在行尾补两个空格才触发换行)。 |
pedantic |
false |
是否尽可能严格兼容原始 markdown.pl 的古老规则,通常保持 false。 |
silent |
false |
解析遇到意外异常时是否静默吞掉错误并返回提示字符串。 |
使用 marked.use() 调整换行行为的写法如下:
import { marked } from 'marked';

// 配置:将单次回车换行直接转换为 <br>
marked.use({
  gfm: true,
  breaks: true
});

const text = "第一行内容\n第二行内容";
console.log(marked.parse(text));
// 输出包含 <br>:<p>第一行内容<br>第二行内容</p>
五、安全防护:XSS 跨站脚本防范
这是每一个使用 Markdown 解析器的开发者都必须面对的重点安全问题。根据 Markdown 规范,原始输入中内嵌的 HTML 标签(例如 <div>、<span>)属于合法输入,marked 会保留这些标签以便用户进行更精细的版面排版。
然而,如果你的应用场景涉及接收外部不受信用户提交的 Markdown 内容(例如论坛帖子、评论区、公开问答),恶意用户很可能输入形如 <img src="x" onerror="alert('xss')"> 或 <script> 的恶意代码。此时若直接将 marked.parse() 的产物赋值给浏览器的 innerHTML,将直接导致 XSS 攻击漏洞。
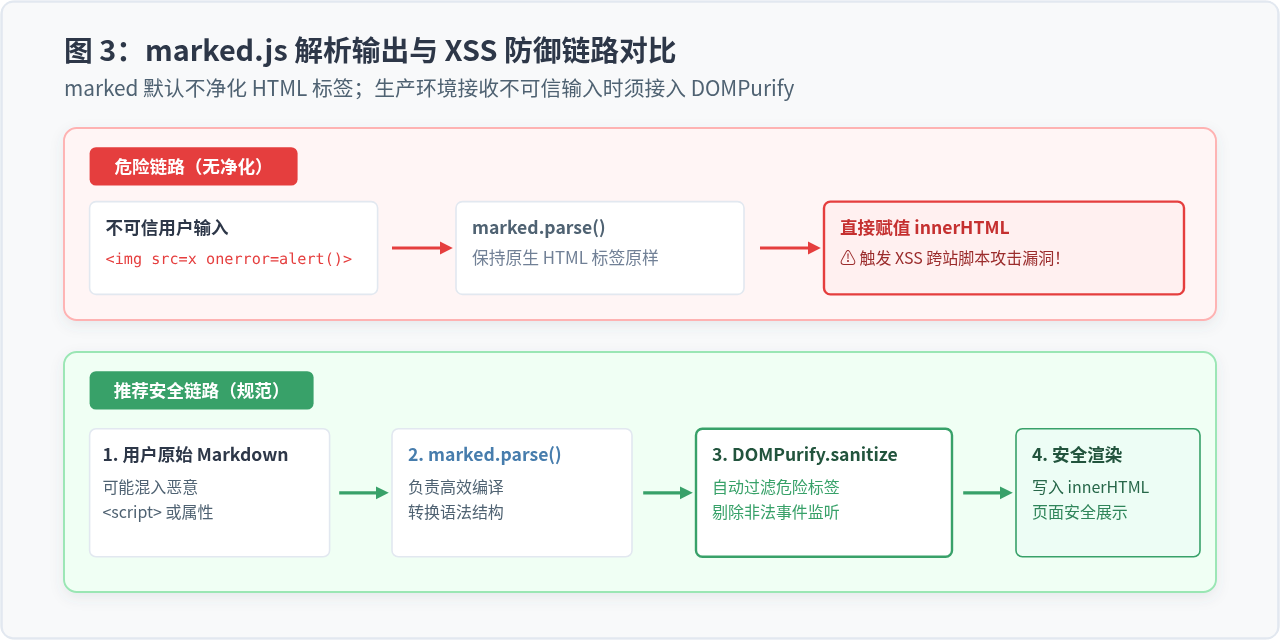
sanitize: true 配置,但官方早在 v4.0.0 就彻底废除了该配置。原因是单纯依靠正则表达式无法真正穷举并防范复杂的 HTML 注入漏洞。官方唯一强烈推荐的安全解决方案是在调用 marked.parse() 之后,使用专业的 HTML 净化库 DOMPurify。
接入 DOMPurify 净化后的标准安全代码如下:
JavaScript (安全防御链路)// 浏览器环境同时引入 DOMPurify:
// <script src="https://cdn.jsdelivr.net/npm/dompurify/dist/purify.min.js"></script>
function getSafeHtml(userMarkdown) {
// 步骤 1:先使用 marked 将 Markdown 语法转换为原始 HTML 字符串
const rawHtml = marked.parse(userMarkdown);
// 步骤 2:使用 DOMPurify 过滤危险标签和非法事件监听属性
const safeHtml = DOMPurify.sanitize(rawHtml);
// 步骤 3:将净化后的安全 HTML 注入页面
return safeHtml;
}
// 测试恶意攻击载荷
const maliciousInput = '# 欢迎\n<img src=x onerror=alert("XSS漏洞被触发")>';
const cleanResult = getSafeHtml(maliciousInput);
console.log(cleanResult);
// 输出:<h1>欢迎</h1>\n<img src="x">(危险的 onerror 属性被安全剥离)六、快速上手总结与核验清单
marked.js 以其纯粹的解析定位、微弱的体积和优异的执行性能,成为前端与 Node.js 领域最为流行的 Markdown 编译引擎之一。在完成基础接入并准备投入实际业务前,请对照以下全景清单进行快速检查:
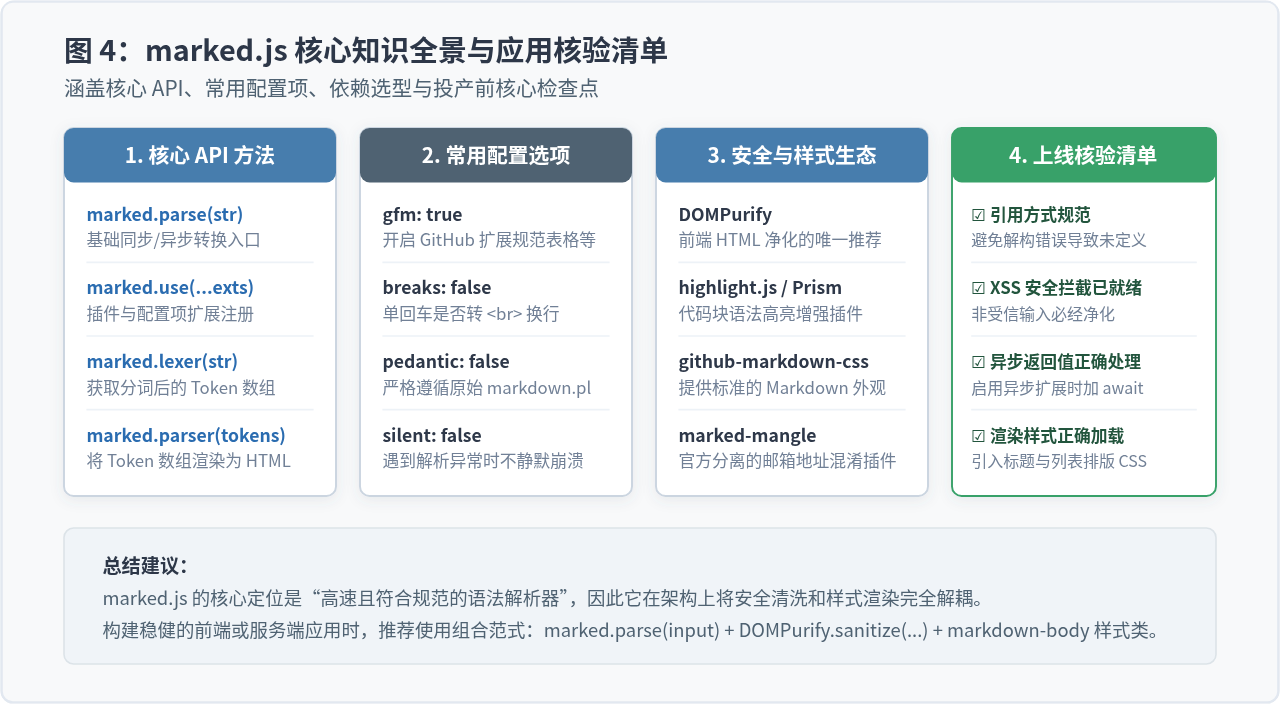
- 解构命名匹配:确认 Node.js 环境下已使用
const { marked } = require('marked')或import { marked },避免因缺少解构出现TypeError: marked is not a function报错。 - 排版样式配套:marked 只生成语义化的 HTML 标签,不自带视觉 CSS 样式。建议在展示页面引入
github-markdown-css等开源排版样式,为h1~h6、table、pre提供美观的默认间距与字体。 - 安全净化闭环:任何面对公开用户的业务系统,必须统一接入
DOMPurify.sanitize(marked.parse(input))管道,从根本上杜绝跨站脚本攻击隐患。 - 异步扩展辨析:如果配置了异步高亮器(如某些包含异步语法的插件或开启了
async: true),记得将调用改为await marked.parse(input),以确保得到正确的解析字符串而非 Promise 对象。
JS怎么使用classList添加、删除和切换class
2026-11-05 17:26:02
网页开发三者分工:HTML结构、CSS样式与JavaScript交互怎么协作
2026-11-05 12:51:22
JS解析URL参数时怎么处理中文乱码和特殊字符
2026-11-05 12:47:23
js-cookie 存储 JSON 对象:自动序列化与反序列化技巧
2026-11-05 12:36:26
Phaser.js 与 PixiJS、Cocos Creator 的技术选型对比
2026-11-05 08:36:30







