

JavaScript按字节截取字符串防止中文乱码的方法
深入解析在 JavaScript 中按字节长度安全截取字符串的原理与实现方案。针对 UTF-8 和 GBK 编码环境,详细讲解多字节字符被截断导致乱码的底层机制,并提供字符遍历累加与 TypedArray 字节回退两种高效防乱码实现代码。
在前端与后端接口交互、对接短信网关或写入限制字段长度的数据库时,限制文本的“字节长度”是极为常见的需求。由于 JavaScript 字符串默认以 UTF-16 码元计算长度,直接使用 str.slice() 截取可能满足字符数,却无法控制底层字节数;而若直接将字符串转成字节流并强行截断,又极易把一个占 3 个字节的 UTF-8 中文字符切碎,留下残缺的半字节,从而在页面或接收端产生诸如“”的替换乱码。解决该问题的关键结论是:在截断过程中必须严格识别字符的多字节边界,当剩余字节配额不足以完整容纳下一个中文字符时,主动停止拼接或向前回退,宁可少截一个字符,也绝不截留残缺字节。
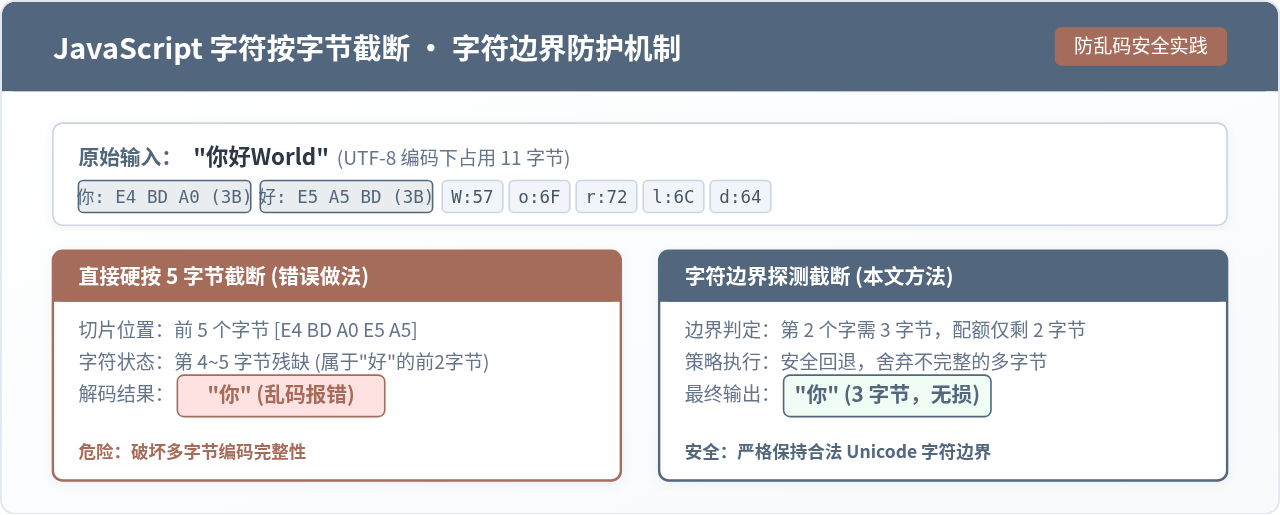
一、乱码根源:字符单元与字节长度的割裂
在 JavaScript 中,string.length 属性返回的是字符串中 UTF-16 编码单元(Code Units)的数量。对于标准 ASCII 字符和大多数常用中文字符,一个字符都对应一个 16 位码元,因此 "hello".length 是 5,而 "你好".length 仅仅是 2。
然而在网络传输协议或存储介质中,字符串通常以 UTF-8 或 GBK 字节流形式存在:
- UTF-8 编码:标准 ASCII 字符(如英文、数字、基本符号)占 1 个字节;常用中文字符占 3 个字节;生僻字及各类 Emoji 表情符号占 4 个字节。
- GBK / GB2312 编码:ASCII 字符占 1 个字节;中文字符占 2 个字节(双字节)。
如果业务要求输入框最多允许提交 10 个字节,输入内容为“前端开发指南”。若直接按 10 个字节硬切:“前”(3B)+“端”(3B)共占用 6 字节,下一个字“开”(3B,UTF-8 编码为 0xE5 0xBC 0x80)需要 3 个字节。此时配额仅剩 4 字节,能容纳“开”;再处理“发”(3B,编码为 0xE5 0x8F 0x91)时,配额只剩下 1 个字节。如果强行切断,第 10 个字节就只留下了 0xE5 这个引导字节。解码器在解析时,发现 0xE5 后面缺少了必要的两个后续字节(0x80~0xBF 范围),就会将其判定为非法字节序列,并用 Unicode 替换字符 (U+FFFD)代替,这就是中文乱码的本质。
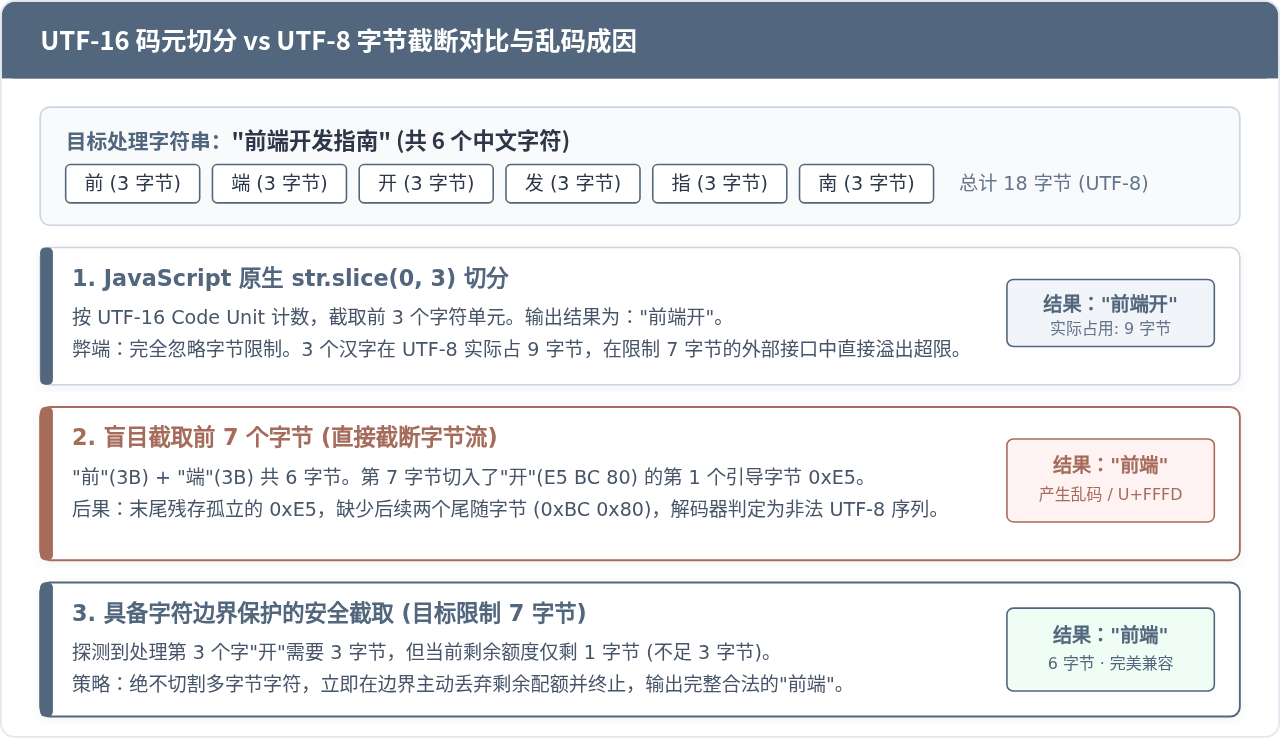
二、实现方案一:基于字符遍历的安全累加法(推荐)
对于绝大多数日常业务(如表单校验、输入框字数限制、列表卡片摘要截取),最稳妥且直观的方式是从字符串开头逐字符迭代,动态计算每个字符在目标编码下的字节数并累加。一旦当前字符加入后总字节数会超出配额,则立刻终止循环,返回当前已收集的子串。
这种方法的天然优势在于:它是以“完整字符”为基本单位向前行进的,根本不会深入到底层字节数组去切开单个字符,因此天生具备字符边界防护能力。
1. UTF-8 编码下的累加实现
借助 ES6 的 codePointAt() 方法,我们可以准确获取字符的 Unicode 码点,并根据 UTF-8 规范判断其占用字节数:
- 码点在
0x0000 ~ 0x007F之间:占用 1 字节(ASCII)。 - 码点在
0x0080 ~ 0x07FF之间:占用 2 字节(拉丁文、希腊文等扩展)。 - 码点在
0x0800 ~ 0xFFFF之间:占用 3 字节(中文汉字绝大部分集中于此)。 - 码点在
0x10000 ~ 0x10FFFF之间:占用 4 字节(数学符号、辅助平面汉字、Emoji)。
/**
 * 按 UTF-8 字节数安全截取字符串
 * @param {string} str 原始字符串
 * @param {number} maxBytes 最大允许字节数
 * @returns {string} 截取后的安全字符串
 */
function truncateByBytesLoop(str, maxBytes) {
  if (!str || maxBytes <= 0) return '';

  let currentBytes = 0;
  let result = '';

  // 使用 for...of 遍历能够天然识别代理对(Surrogate Pairs),不会把 Emoji 拆散
  for (const char of str) {
    const codePoint = char.codePointAt(0);
    let charBytes = 1;

    if (codePoint <= 0x007F) {
      charBytes = 1;
    } else if (codePoint <= 0x07FF) {
      charBytes = 2;
    } else if (codePoint <= 0xFFFF) {
      charBytes = 3;
    } else {
      charBytes = 4;
    }

    // 若加入当前字符后超过最大字节限制,立即退出
    if (currentBytes + charBytes > maxBytes) {
      break;
    }

    currentBytes += charBytes;
    result += char;
  }

  return result;
}

// 执行测试
const sampleText = "前端开发指南2026";
const truncatedText = truncateByBytesLoop(sampleText, 10);
console.log("截取结果:", truncatedText);
在上面的示例中,配额为 10 字节:“前”(3B)+“端”(3B)+“开”(3B)累计 9 字节。下一个字符“发”需要 3 字节,累计需 12 字节,超过了限制 10 字节。算法在此处精准终止,返回 9 字节的“前端开”,没有保留任何不完整的字节。
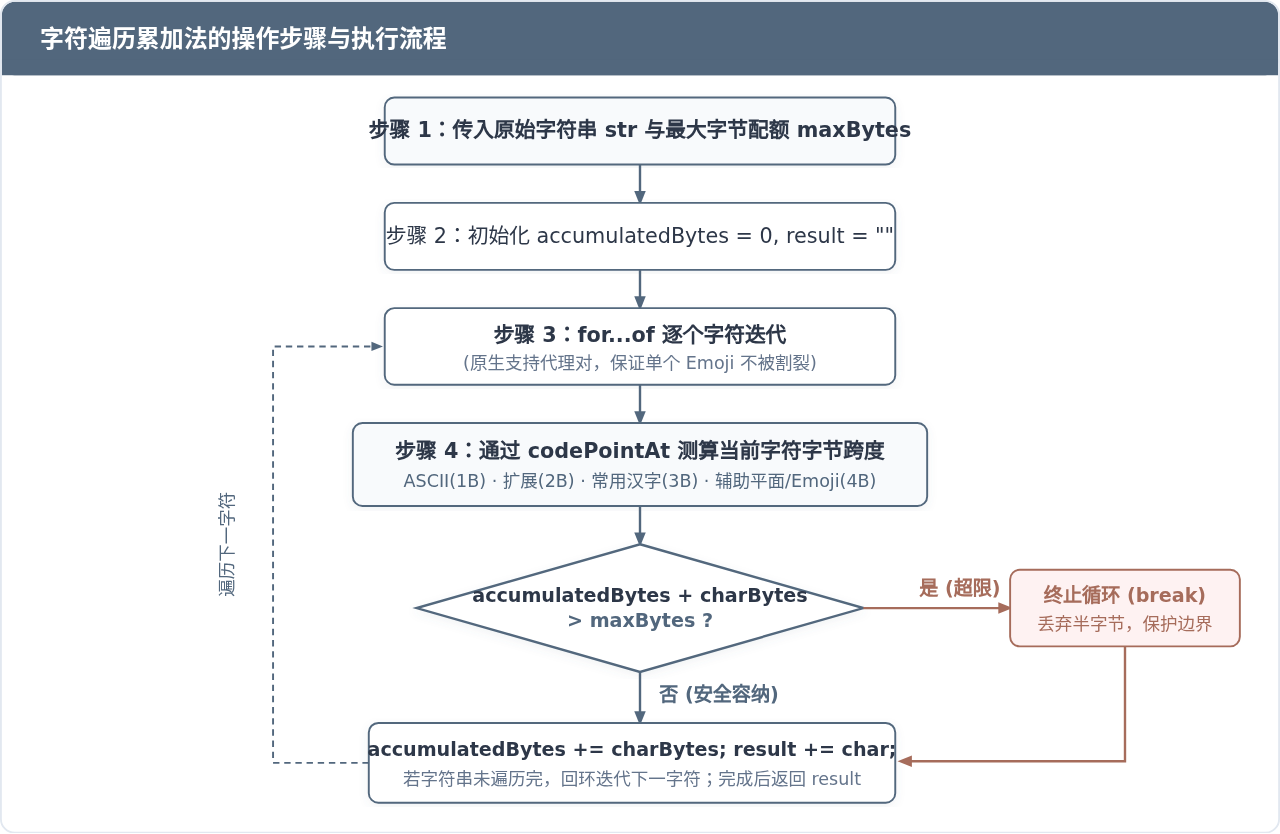
传统的 for (let i = 0; i < str.length; i++) 遍历的是 16 位码元。当遇到某些生僻汉字或 Emoji(码点大于 0xFFFF)时,它们由一对高低代理项(Surrogate Pair)组成,str[i] 只会拿到半个代理项,导致 codePointAt 计算错误。而 for...of 能够按完整 Unicode 字符进行迭代,从根本上防止了代理对损坏。
三、实现方案二:基于 TypedArray 与 TextEncoder 的字节回退截断法
如果处于需要高吞吐处理长文本的场景(例如在 Node.js 服务端、Web Worker 中解析网络二进制包),利用浏览器内置的 TextEncoder 和 TextDecoder 原生 API,结合底层字节回退判断,能够获得极高的执行性能。
1. UTF-8 引导字节与尾随字节特征
根据 RFC 3629 规范,UTF-8 编码具有严格的位掩码规律:
- 引导字节(Leading Byte):标志多字节字符的起始,最高位为
110xxxxx(2B)、1110xxxx(3B)或11110xxx(4B)。 - 尾随字节(Trailing Byte):紧随引导字节之后,最高两位恒为
10xxxxxx(数值在0x80 ~ 0xBF之间)。
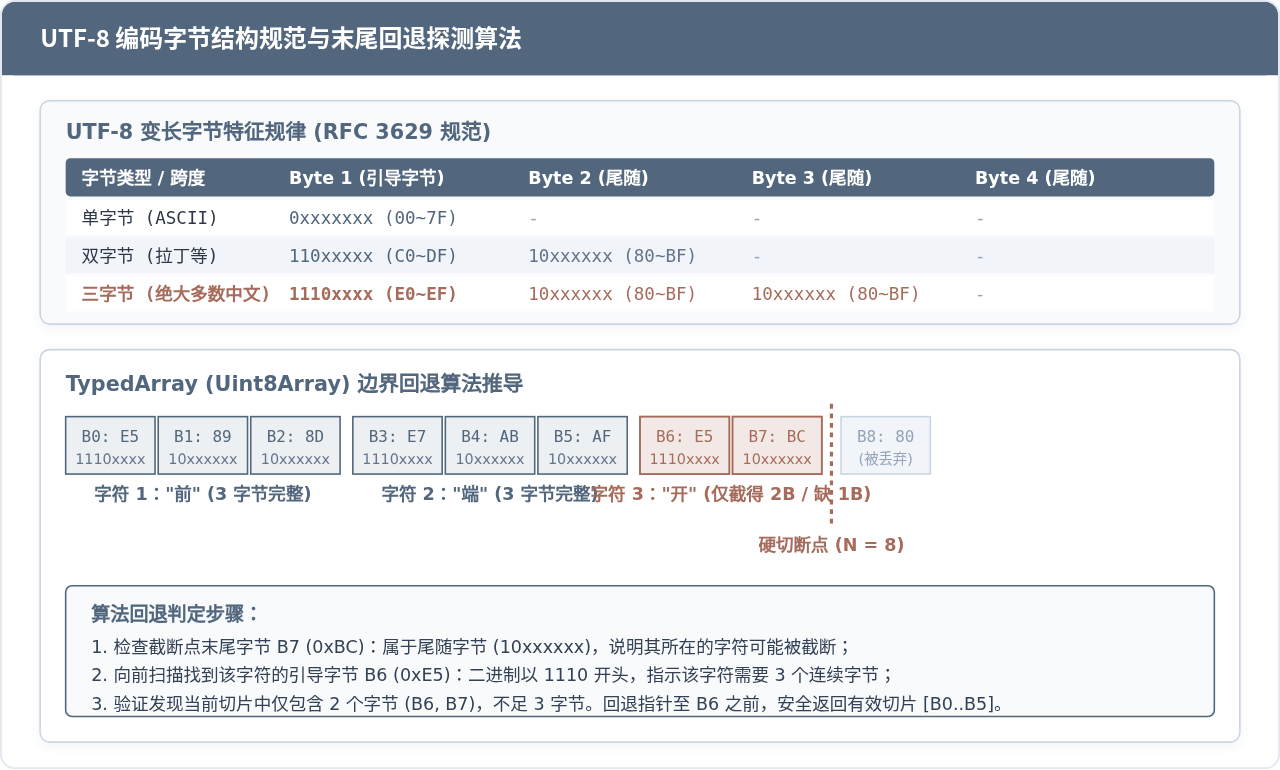
2. 字节回退算法代码实现
核心逻辑是:先使用 TextEncoder 将字符串编码为 Uint8Array;随后在 maxBytes 处进行切片;若切片末尾刚好落在某个多字节字符的中间,则逆向扫描找到引导字节,确认该字符是否被切断。如果被切断,则将切片指针回退至引导字节之前,最后通过 TextDecoder 安全还原为字符串。
/**
 * 基于 TextEncoder 与字节回退的高性能截取
 * @param {string} str 待截取字符串
 * @param {number} maxBytes 限制字节数
 * @returns {string} 安全截取的字符串
 */
function truncateByBytesTypedArray(str, maxBytes) {
  if (!str || maxBytes <= 0) return '';

  const encoder = new TextEncoder();
  const bytes = encoder.encode(str);

  // 如果原本字节数就没有超出限制,直接原样返回
  if (bytes.length <= maxBytes) {
    return str;
  }

  let end = maxBytes;

  // 从截断边界向前检查 UTF-8 连续字节
  // 尾随字节满足 (b & 0xC0) === 0x80 (即二进制 10xxxxxx)
  let i = end;
  while (i > 0 && (bytes[i - 1] & 0xC0) === 0x80) {
    i--;
  }

  // 此时 i - 1 位置可能是引导字节,也可能整个截断点全部在 ASCII 内
  if (i > 0) {
    const leadByte = bytes[i - 1];
    let expectedLength = 1;

    if ((leadByte & 0x80) === 0) {
      expectedLength = 1; // 0xxxxxxx (单字节 ASCII)
    } else if ((leadByte & 0xE0) === 0xC0) {
      expectedLength = 2; // 110xxxxx (双字节)
    } else if ((leadByte & 0xF0) === 0xE0) {
      expectedLength = 3; // 1110xxxx (三字节,常用中文)
    } else if ((leadByte & 0xF8) === 0xF0) {
      expectedLength = 4; // 11110xxx (四字节)
    }

    // 检查截断区间内包含的该字符字节数是否满足其完整长度
    const actualBytesAvailable = end - (i - 1);
    if (actualBytesAvailable < expectedLength) {
      // 字节不完整,丢弃该残缺字符的所有字节
      end = i - 1;
    }
  }

  const validSlice = bytes.subarray(0, end);
  return new TextDecoder('utf-8').decode(validSlice);
}

// 执行测试
const rawContent = "性能优化:JavaScript深水区";
const safeSliced = truncateByBytesTypedArray(rawContent, 16);
console.log("安全截取:", safeSliced);
在此示例中,“性能优化:”占 5 个汉字/全角符号共 15 字节,加上字母“J”占 1 字节,正好凑满 16 字节,截取结果极其平整,绝不会把后续汉字拆开。
四、适配 GBK / 双字节编码场景的截取方法
虽然现代 Web 标准全面拥抱 UTF-8,但在政务系统、金融交换报文、物流接口或传统 SQL 数据库(设定为 GBK 字符集,且字段按字节计数)中,中文被严格规定为占用 2 个字节。如果在前端向此类系统提交数据,必须按照 GBK 的规则来计算和截取。
GBK 汉字由 2 个字节组成(首字节在 0x81 ~ 0xFE,尾字节在 0x40 ~ 0xFE)。如果在奇数位置把一个双字节汉字劈断,后半截字节会与后面的下一个汉字首字节错误组合,引发整段后续文本连环错位乱码。
在不引入庞大转码字典库的前提下,前端可以通过字符的 Unicode 编码范围进行双字节加权判断:凡是 ASCII 范围(code <= 127)均计为 1 字节;其余字符(包括中文常用字、全角符号)均计为 2 字节。
/**
 * 按 GBK 规则(中文 2 字节,英文 1 字节)安全截取字符串
 * @param {string} str 待截取文本
 * @param {number} maxBytes 最大允许字节数
 * @returns {string} 截断结果
 */
function truncateByGbkBytes(str, maxBytes) {
  if (!str || maxBytes <= 0) return '';

  let currentBytes = 0;
  let result = '';

  for (const char of str) {
    const code = char.charCodeAt(0);
    // ASCII 字符计 1 字节,其余绝大多数中文字符计 2 字节
    const charBytes = (code > 127) ? 2 : 1;

    if (currentBytes + charBytes > maxBytes) {
      break;
    }

    currentBytes += charBytes;
    result += char;
  }

  return result;
}

// 执行测试
const gbkInput = "银行转账备注信息";
console.log("GBK 限制 7 字节截取:", truncateByGbkBytes(gbkInput, 7));
“银行转”3 个字在 GBK 下各占 2 字节,累计 6 字节;第 4 个字“账”需要 2 字节,超出 7 字节上限,因此安全停留在 6 字节处,避免了留下孤立字节。
五、方案选型与工程实践注意事项
为了在实际项目中作出合理的架构选型,我们将几种核心截取方案的技术特性总结如下:
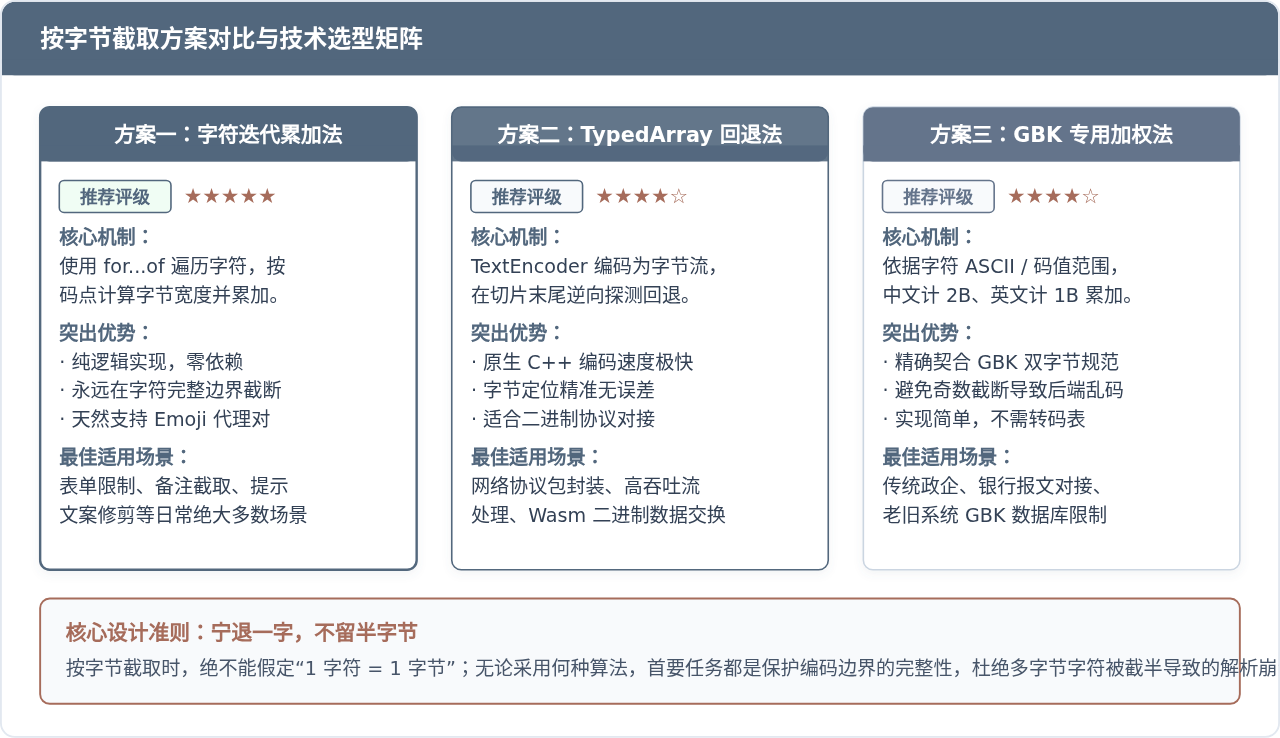
在实际编码与上线过程中,还有以下三项容易忽视的关键细节:
- 截断后追加省略号(...)的配额预留:如果在 UI 展示中需要追加
...或…,必须提前扣除省略符号本身的字节数。例如标准三点省略号...在 UTF-8 下占 3 字节,若总限制为 30 字节,截取逻辑的实际最大配额应设为27,之后再进行字符拼接。 - 输入框实时监听(input 事件)的性能平衡:在处理用户实时打字截断时,优先推荐“字符遍历累加法”。因为用户的输入通常在几十至数百字符以内,字符遍历的耗时在微秒级别,远比反复进行
TextEncoder.encode内存分配和垃圾回收更加轻巧平稳。 - 前后端校验双重保险:前端截取的目的主要是优化用户体验和阻止非法参数发出,而后端接收到请求时必须以服务端的编码解析器(如 Node.js 的
Buffer.byteLength、Java 的getBytes(StandardCharsets.UTF_8))作为最终防御线,两者保持一致的截断或拒绝逻辑。
JS大数值转字符串出现科学计数法怎么办
2026-11-05 17:09:21
JS split切割后出现空字符串怎么过滤
2026-11-05 16:00:30
在 React 或 Vue 项目中封装使用 JS 节流防抖
2026-11-05 15:27:29
JavaScript中怎么将带小数的字符串转为整数?
2026-11-05 14:32:38
怎么用JavaScript策略模式重构电商促销计算逻辑?
2026-11-05 14:01:09







