

JS怎么截取字符串的前几位
深入解析在JavaScript中截取字符串前几位的核心方案。详细讲解slice(0, n)的标准用法、与substring和substr的差异对比、包含Emoji等Unicode字符的安全截取技巧及工程最佳实践。
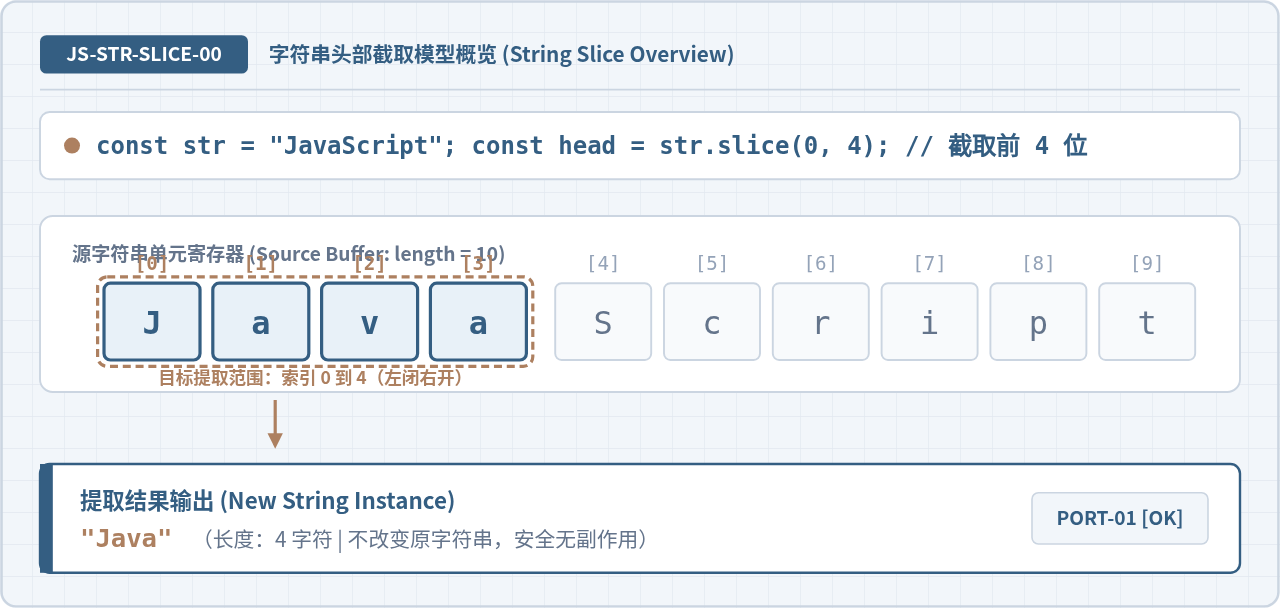
str.slice(0, n),其中 n 代表需要截取的字符数量。该方法以索引 0 为起点,截取到索引 n(不包含索引 n 处的字符),并返回一个新的子字符串。如果字符串自身长度小于 n,它会自动截取至末尾而不会产生越界报错。本文将系统拆解 slice 的执行细节、与其他历史方法的差异,以及面对 Emoji 等复杂字符时的安全截取技巧。
一、首选方案:使用 String.prototype.slice(0, n)
在现代前端与 Node.js 开发中,slice() 是处理字符串切片的首选方法。JavaScript 中的字符串属于不可变原始值(Immutable),因此任何截取操作都不会修改原来的字符串,而是由底层创建并返回一个全新的字符串副本。
1. 基础用法与代码示例
提取字符串前 n 位时,固定传入 0 作为起始索引,并将 n 作为结束索引:
在这个例子中,slice(0, 4) 提取了索引为 0、1、2、3 的四个字符。区间为数学上的左闭右开区间 [0, 4),因此长度正好为 4 - 0 = 4。
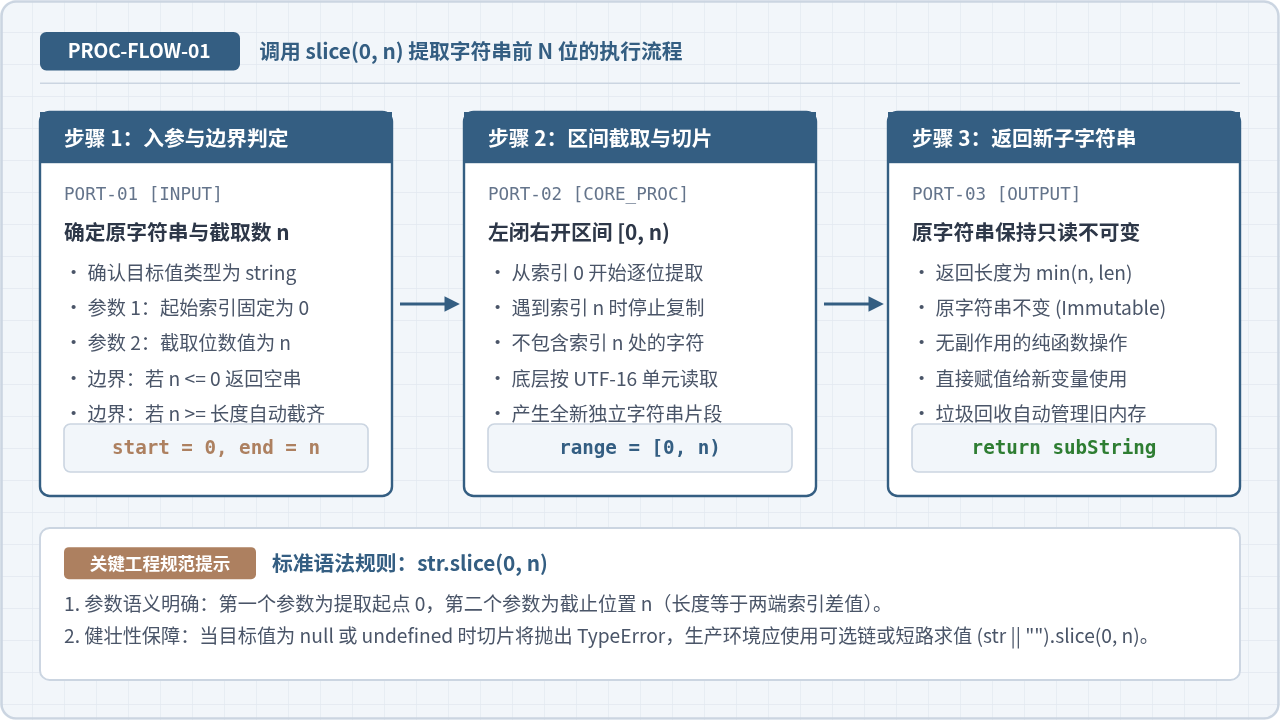
2. 边界条件与健壮性表现
在实际业务中,传入的长度 n 可能大于字符串本身的长度,或者小于等于 0。slice 对这些极端情况有明确且宽容的规范定义:
- 当 n 大于字符串长度时:
"Hi".slice(0, 10)会返回完整字符串"Hi",不会填充空字符,也不会抛出异常。 - 当 n 小于或等于 0 时:
"Hi".slice(0, 0)或"Hi".slice(0, -1)返回空字符串""(当第二参数为负数时,它代表从倒数第几个字符结束截取)。 - 空字符串处理:
"".slice(0, 5)安全返回""。
虽然 slice 对参数越界非常安全,但如果变量本身是 null 或 undefined,直接调用 str.slice() 会抛出 TypeError。在生产环境中,建议结合短路求值或空值合并运算符:
const safeHead = (str || "").slice(0, n);
二、方法对比:slice、substring 与 substr 的异同
除了 slice 之外,JavaScript 原型链上还存在 substring 和 substr 两个历史方法。初学者常常混淆它们的用法,下表与对比图展示了它们的核心差异。
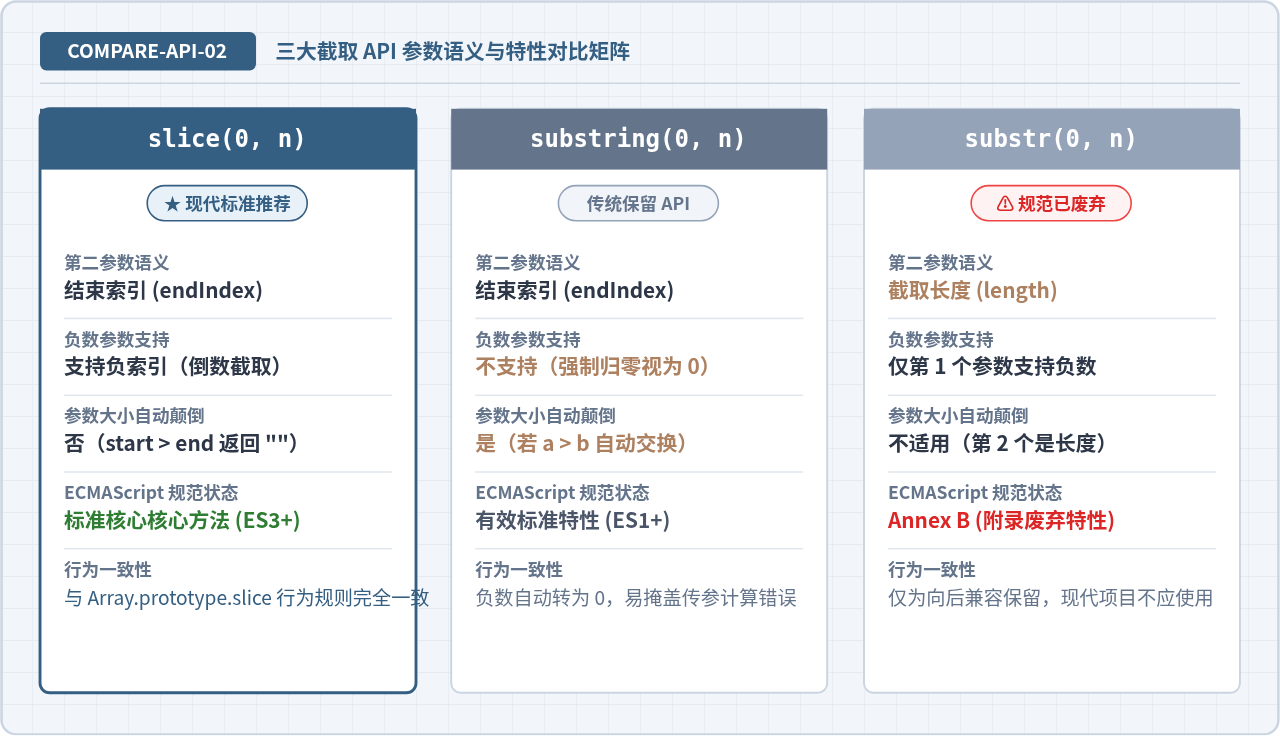
| 方法名称 | 语法形式 | 第二个参数含义 | 负数参数处理 | 规范建议 |
|---|---|---|---|---|
| slice | str.slice(0, n) |
结束索引 (endIndex) | 支持负数(从末尾向前倒数) | 首选推荐(与数组切片语法高度一致) |
| substring | str.substring(0, n) |
结束索引 (endIndex) | 自动转换为 0;若起始大于结束会自动对调 | 传统保留(容易因自动交换参数隐藏逻辑错误) |
| substr | str.substr(0, n) |
截取长度 (length) | 起始支持负数,长度为负数则返回空 | 已废弃(ECMAScript Annex B 附录特性) |
为什么不建议使用 substr?
String.prototype.substr() 的第二个参数表示“截取的字符个数”,虽然 str.substr(0, 4) 同样能截取前 4 位,但该方法早在 ECMAScript 规范中被列入 Annex B(遗留兼容特性),官方明确建议在新项目中避免使用。
substring 与 slice 的关键区别
当参数均为非负数且 0 <= n 时,substring(0, n) 与 slice(0, n) 的表现完全相同。但一旦涉及异常传参,substring 会自动将负数转为 0,甚至在 start > end 时自动颠倒顺序,这种“隐式纠错”往往会掩盖上游业务代码中的计算 Bug。因此,规范中行为一致、语义清晰的 slice 是更稳健的选择。
三、特殊进阶:包含 Emoji 与特殊 Unicode 字符的处理
在处理国际化文本、用户昵称或评论留言时,常常会遇到包含 Emoji 表情(如 😀、🎉)或生僻汉字的字符串。如果直接使用 str.slice(0, 1),很可能会产生乱码或问号字符()。
1. 乱码产生的原因:UTF-16 代理对裂开
JavaScript 内部字符串采用 UTF-16 编码。常见英文字母和标准汉字位于基本多语言平面(BMP),占用 1 个 16 位的代码单元(Code Unit)。而 Emoji 表情等字符码点大于 0xFFFF,由一对 16 位的代理对(Surrogate Pair)共同组成,即占用 2 个代码单元。
str.slice() 是基于 UTF-16 代码单元进行切片的。如果对 "😀abc" 截取前 1 位,就会把 Emoji 的高位代理和低位代理强行切开,从而导致孤立的代理字符无法被渲染。
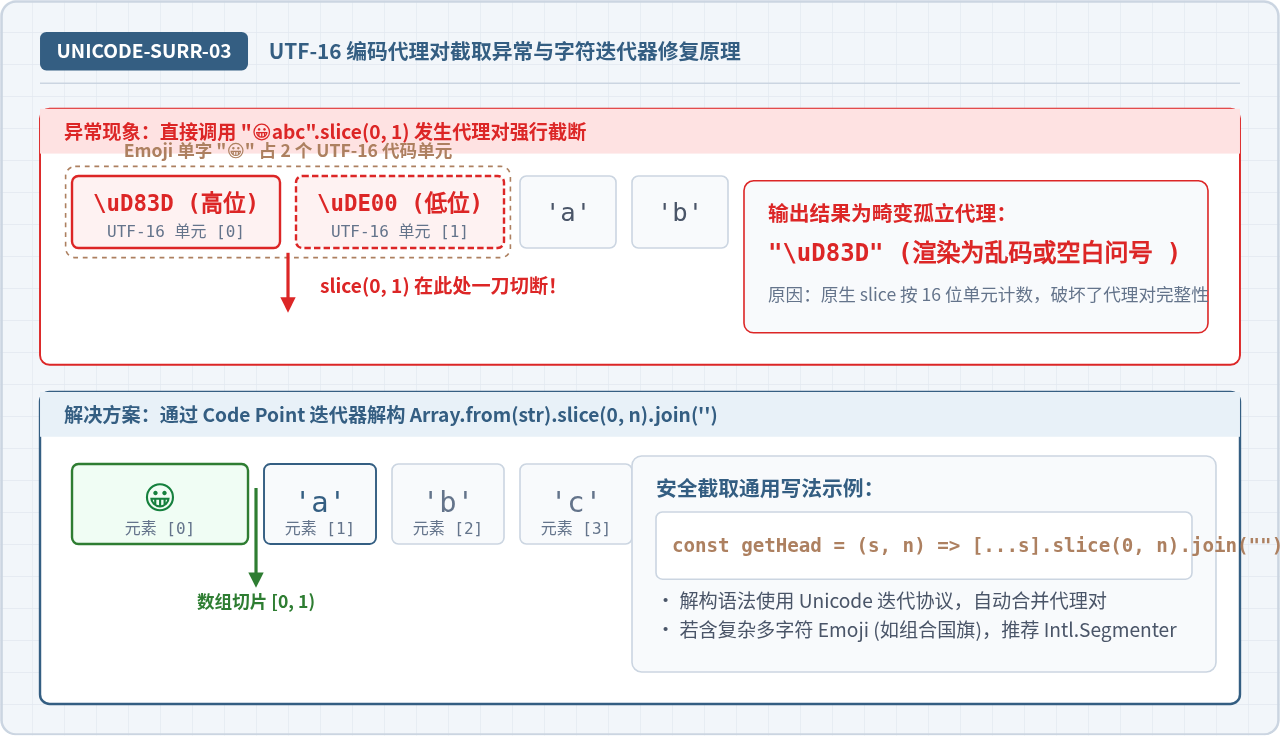
2. 正确解决方案:使用扩展运算符或 Array.from()
ES6 引入的展开运算符(...)和 Array.from() 实现了 Unicode 迭代协议,能够识别完整的码点(Code Point),将代理对作为一个整体进行拆分:
传统截取: (长度=1,但字符损坏)
码点截取:"😀" (完整保留真实视觉字符)
3. 超复杂字素簇:Intl.Segmenter API
对于更复杂的合成表情(例如带有肤色修饰符的表情、家庭组合表情 👨👩👧👦、国旗旗帜等),它们是由零宽连接符(ZWJ)组合而成的“字素簇”(Grapheme Cluster)。此时若需要真正符合人类视觉直觉的“前 N 个字”,可以使用现代浏览器原生支持的 Intl.Segmenter:
四、工程封装与选型决策
在实际企业级项目开发中,建议根据输入文本的复杂度与性能要求,选择匹配的截取策略。
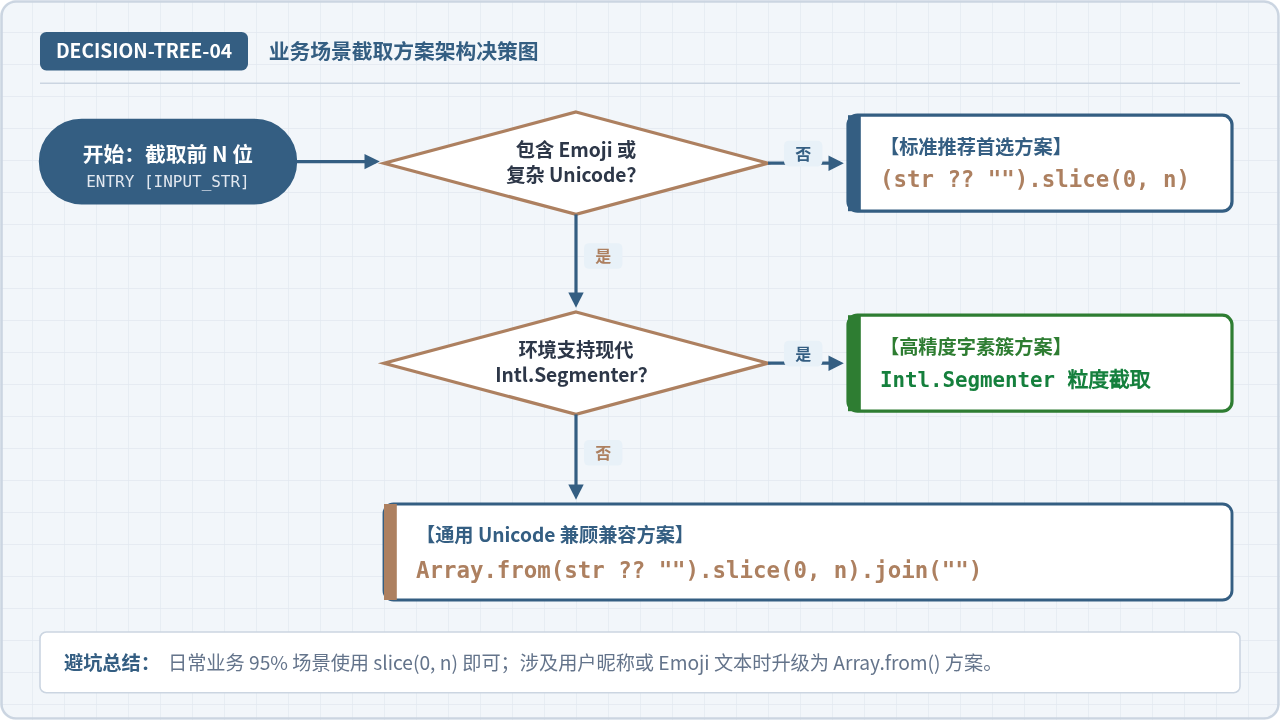
封装通用的截取工具函数
结合空值安全保护与长度限制,可以封装如下轻量级工具函数:
五、核心结论速查
- 标准答复:截取 JavaScript 字符串前
n位,直接使用str.slice(0, n),简单高效、无副作用。 - 负数与越界:
slice自动兼容超出长度的情况,不会越界报错;n <= 0时返回空串。 - 历史包袱:远离废弃的
substr;不必使用容易掩盖参数倒置问题的substring。 - Emoji 场景:涉及用户输入或表情符号时,采用
Array.from(str).slice(0, n).join('')防止高低位代理被截断产生乱码。
JS处理含Emoji或中文的字符串转数组乱码问题
2026-11-05 16:12:28
JS怎么使用展开运算符合并对象
2026-11-05 14:42:18
ES6+环境下判断JS对象为空的简洁写法
2026-11-05 12:12:23
怎么通过replacer函数自定义JS中JSON的格式化输出
2026-11-05 11:19:44
JS正则表达式基础:字面量与RegExp构造函数的区别及常用元字符
2026-11-05 11:16:58







