JS处理含Emoji或中文的字符串转数组乱码问题
全面解析 JavaScript 中使用 split('') 将包含 Emoji 或生僻汉字字符串转数组时产生乱码的底层原因,对比 UTF-16 码元、Unicode 码点与字形簇切分差异,并提供基于 Intl.Segmenter 的现代标准解决方案与工程防御实践。
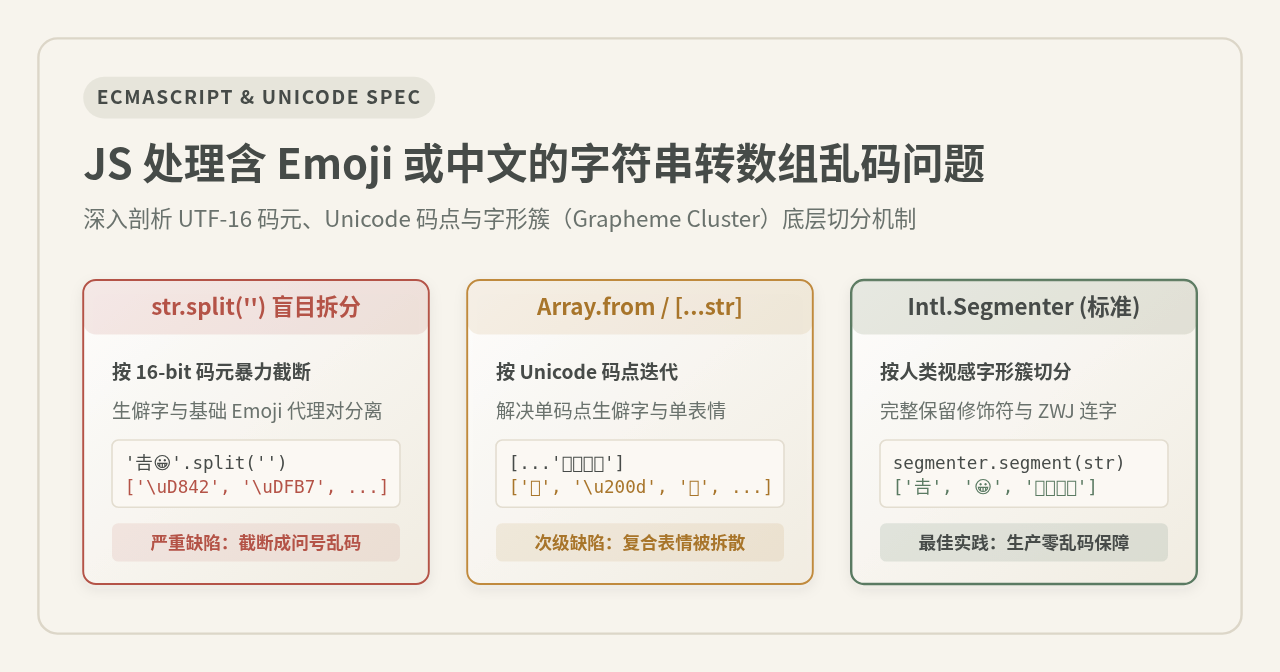
在 JavaScript 中,直接使用 str.split('') 将字符串切分为单字符数组时,常常导致 Emoji 表情变为问号方块()或者生僻汉字(如“𠮷”、“𬱖”)被腰斩乱码。这一问题的根源在于 JavaScript 字符串内部使用 UTF-16 码元(Code Unit)存储,而生僻汉字及绝大多数 Emoji 属于需要两个 16 位单元组合表示的“辅助平面”字符,直接按 16 位切割必然破坏编码结构。要彻底杜绝此类乱码,单码点场景可选用展开语法 [...str],包含肤色修饰符与复合序列的真实业务场景则必须使用标准原生的 Intl.Segmenter 按人类视觉字形簇(Grapheme Cluster)安全切分。
一、典型乱码现象与业务痛点复现
字符串转字符数组是日常前端与服务端开发中的基础操作。常见场景包括:用户昵称逐字渲染打字机动效、文本倒序排列、带有字符上限的输入框实时字数统计,以及敏感词逐字脱敏。许多开发者习惯直接调用 str.split('')。然而,在处理不同字符集时,这种做法的表现截然不同:
// 场景 1:常用中文 —— 运行正常
const str1 = "你好";
console.log(str1.split(''));
// 结果: ['你', '好'],长度为 2

// 场景 2:扩展区生僻汉字(如人名“𠮷”)—— 发生乱码
const str2 = "张𠮷";
console.log(str2.split(''));
// 结果: ['张', '\uD842', '\uDFB7'],长度变为 3!页面显示为 "张"

// 场景 3:基础 Emoji 表情 —— 发生乱码
const str3 = "点赞👍";
console.log(str3.split(''));
// 结果: ['点', '赞', '\uD83D', '\uDC4D'],长度变为 4!页面显示为 "点赞"

// 场景 4:文本倒序输出 —— 灾难性损坏
const reversed = "𠮷😀".split('').reverse().join('');
console.log(reversed);
// 结果: 代理对次序颠倒,全部沦为不可恢复的乱码字符
当包含乱码数组的字符串被存入数据库(例如仅支持 3 字节 UTF-8 的历史数据表)或提交给下游系统校验时,往往会触发不可逆的编码损坏或接口字段长度报错。
二、底层根源:UTF-16 码元、Unicode 码点与代理对机制
要理解为什么 split('') 会失效,首先需要理清字符编码在 JavaScript 内部的内存实现。
许多开发者存在一种常见误解:“中文在 UTF-8 中占用 3 个字节,为什么 JS 切分常用汉字没有碎成 3 个元素,反而生僻字和 Emoji 碎了?”
原因在于:JavaScript 引擎在内存中并不是以 UTF-8 组织字符串的,而是严格遵循 UTF-16 规范。
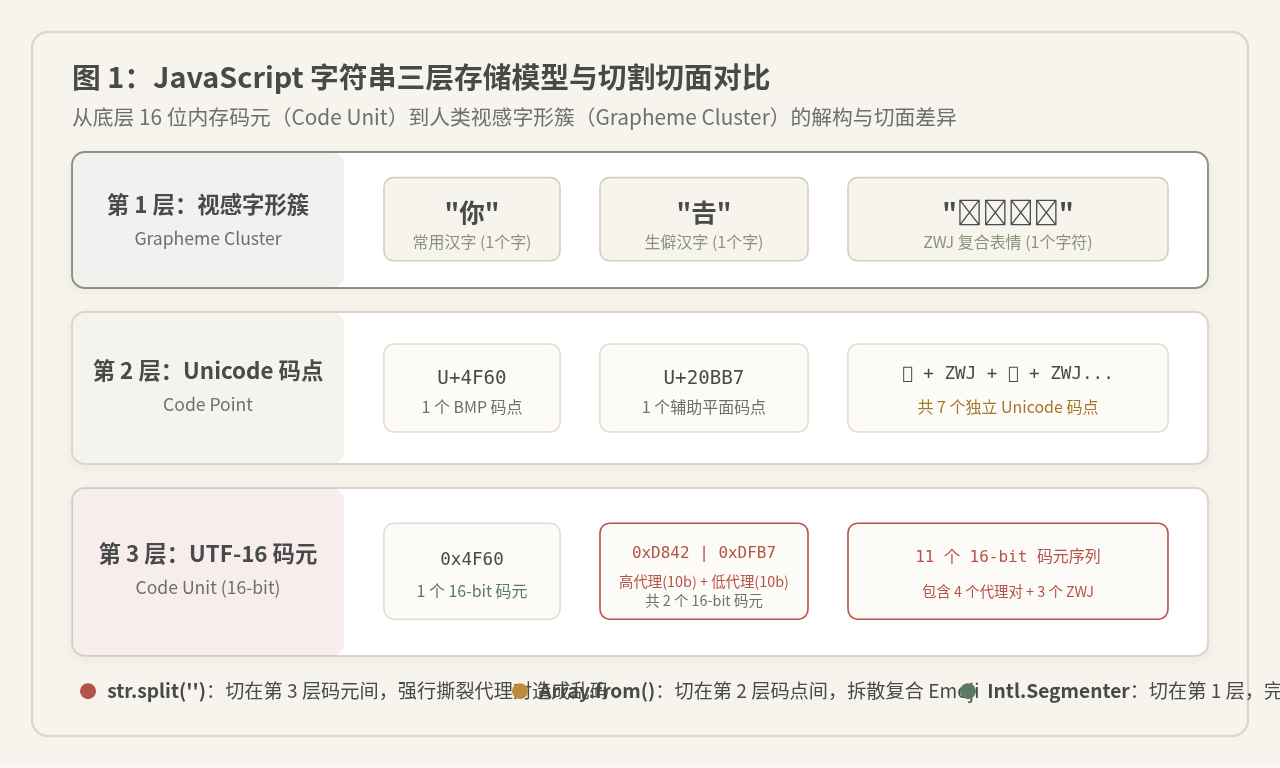
在 UTF-16 规范中,最小的存储单元被称为“代码单元”(Code Unit,即码元),固定为 16 位(2 个字节)。Unicode 将字符划分为 17 个“平面”(Plane),每个平面包含 65536 个码点(Code Point,从 U+0000 到 U+10FFFF):
-
基本多语言平面(BMP,U+0000 到 U+FFFF): 绝大部分常用拉丁字符、数字,以及现代汉语中的数千个常用汉字(如“中”
U+4E2D、“你”U+4F60)都落在这一平面内。它们刚好用 1 个 16 位码元就能表达完毕。 -
辅助平面(SMP / SIP 等,U+010000 到 U+10FFFF): 超过 16 位上限的字符,包括绝大多数 Emoji、古代象形文字,以及现代户籍、地名中常见的 CJK 扩展汉字(如“𠮷”
U+20BB7、“𪚥”U+2A6A5)。
由于 16 位无法直接容纳超过 0xFFFF 的数值,UTF-16 采用代理对(Surrogate Pair)机制:从 BMP 中划出两段保留区间,分别作为高位代理(0xD800–0xDBFF)和低位代理(0xDC00–0xDFFF)。一个辅助平面字符在内存中由一个高位代理码元加一个低位代理码元组成。
而 ECMAScript 规范定义中的 String.prototype.split(''),其切割行为是完全机械地以 16 位码元为步长进行划分的。它根本不理解代理对的语义关联,直接在两个代理码元之间下了切刀。高位码元和低位码元一旦孤立,就成了非法的 Unicode 片段,浏览器渲染引擎在找不到对应字形时,只能回退显示为替换字符(U+FFFD )。
三、常见替代方案剖析:为什么 Array.from() 仍然不够?
在 ES6 标准普及后,很多教程推荐使用展开语法 [...str] 或 Array.from(str) 替代 split('')。这种说法在哪些条件下成立?又在何时会失效?
1. 展开语法与 Array.from 的优势
[...str] 与 Array.from(str) 底层调用的是字符串的默认迭代器 String.prototype[Symbol.iterator]。该迭代器具备对 UTF-16 代理对的感知能力:当它扫描到高位代理时,会自动提取紧随其后的低位代理,合成为一个完整的 Unicode 码点(Code Point)进行输出。
// 成功处理扩展区生僻汉字与单码点 Emoji
const str = "张𠮷😀";
console.log([...str]);
// 结果: ['张', '𠮷', '😀'] -> 成功!生僻字与单码点表情完好无损
因此,如果你的业务场景仅涉及常用汉字、生僻人名汉字和标准独立表情,[...str] 确实是有效且开销适中的方案。
2. 复合 Emoji 场景下的失效原因
现代 Unicode 标准中的表情符号不仅是“单码点字符”。随着表达需求的丰富,Unicode 引入了大量复合机制:
-
肤色修饰符(Fitzpatrick Modifiers):例如“👍🏽”(中等深肤色点赞手势),实际上是由基础表情
👍(U+1F44D)与肤色码点🏽(U+1F3FD)相继排列组成的两个码点序列。 -
零宽连字符序列(ZWJ Sequences):例如家庭表情“👨👩👧👦”,底层由父亲(
U+1F468)、零宽连字符(U+200D)、母亲(U+1F469)、零宽连字符、女儿(U+1F467)、零宽连字符、儿子(U+1F466)共 7 个码点紧密串联而成。操作系统渲染引擎感知到 ZWJ 连字后,将其合并为一个紧凑家庭图标呈现。 -
变体选择符与键帽序列:例如带有方框数字效果的“1️⃣”,由数字字符
1、变体选择符VS-16(U+FE0F)及键帽组合符(U+20E3)构成。
Array.from() 仅仅是在码点(Code Point)层级做切分,并不识别这些连字与修饰规则。执行 [...'👨👩👧👦'] 会直接把该表情拆解为 7 个散落的元素,使得原本紧凑的复合图形瞬间瓦解:
const family = "👨👩👧👦";
console.log([...family]);
// 结果输出 7 个独立元素: ['👨', '\u200d', '👩', '\u200d', '👧', '\u200d', '👦']
// 视感上原本的 1 个表情被错认为 7 个字符!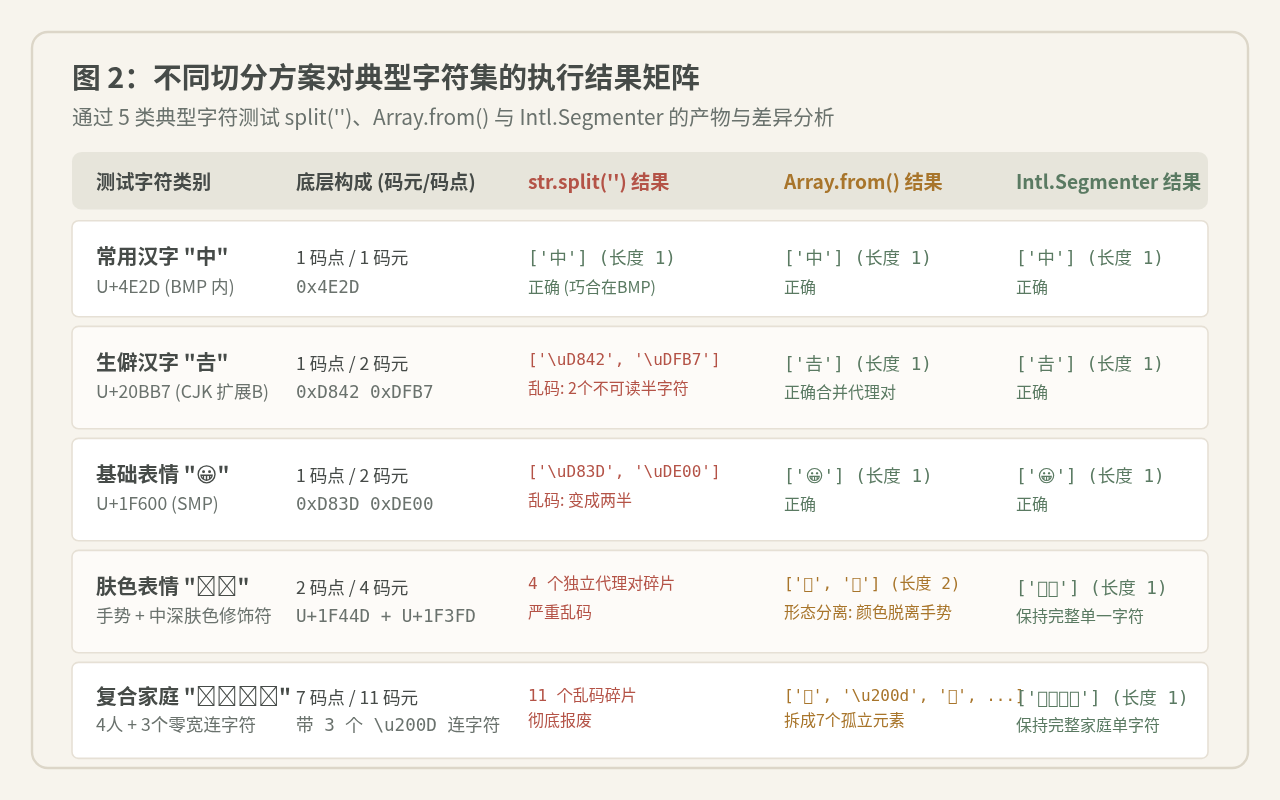
四、现代标准解决方案:利用 Intl.Segmenter 精准切分字形簇
为了从 ECMAScript 规范层面彻底终结多语言文本切分难题,TC39 制定了 Intl.Segmenter 国际化标准 API(ECMA-402)。
Intl.Segmenter 的核心能力在于支持字形簇(Grapheme Cluster)粒度的切分。字形簇正是从用户真实视觉感官出发的定义——无论底层由几个 UTF-16 码元、几个 Unicode 码点或几个修饰符连缀而成,只要在屏幕上表现为一个不可分割的字符单位,它就会被完整归入一个分段。
1. Intl.Segmenter 的标准调用范式
/**
 * 将任意文本安全切分为视觉单字符数组
 * @param {string} text 输入字符串
 * @param {string} [locale='zh-Hans'] 语言标签
 * @returns {string[]}
 */
function splitToGraphemes(text, locale = 'zh-Hans') {
  // 边界防护:非字符串直接处理
  if (typeof text !== 'string') return [];
  if (text.length === 0) return [];

  // 优先使用原生标准 Intl.Segmenter
  if (typeof Intl !== 'undefined' && Intl.Segmenter) {
    const segmenter = new Intl.Segmenter(locale, { granularity: 'grapheme' });
    const iterator = segmenter.segment(text);
    return Array.from(iterator, item => item.segment);
  }

  // 降级方案:Code Point 迭代器(兼顾生僻字与单码点Emoji)
  return [...text];
}
2. 执行效果实测
使用 splitToGraphemes 函数处理混合有常用汉字、生僻汉字、修饰符 Emoji 及复合家庭 Emoji 的复杂文本:
const complexText = "你好𠮷👍🏽👨👩👧👦";
// 传统 split 切割(乱码严重)
console.log(complexText.split('').length); // 输出: 19 (大量代理对碎片)
// 展开语法切割(复合表情破裂)
console.log([...complexText].length); // 输出: 11 (👍🏽裂为2,👨👩👧👦裂为7)
// Intl.Segmenter 切割(完全符合肉眼认知)
const result = splitToGraphemes(complexText);
console.log(result);
// 输出: ['你', '好', '𠮷', '👍🏽', '👨👩👧👦']
console.log(result.length);
// 输出: 5 (完全精确!)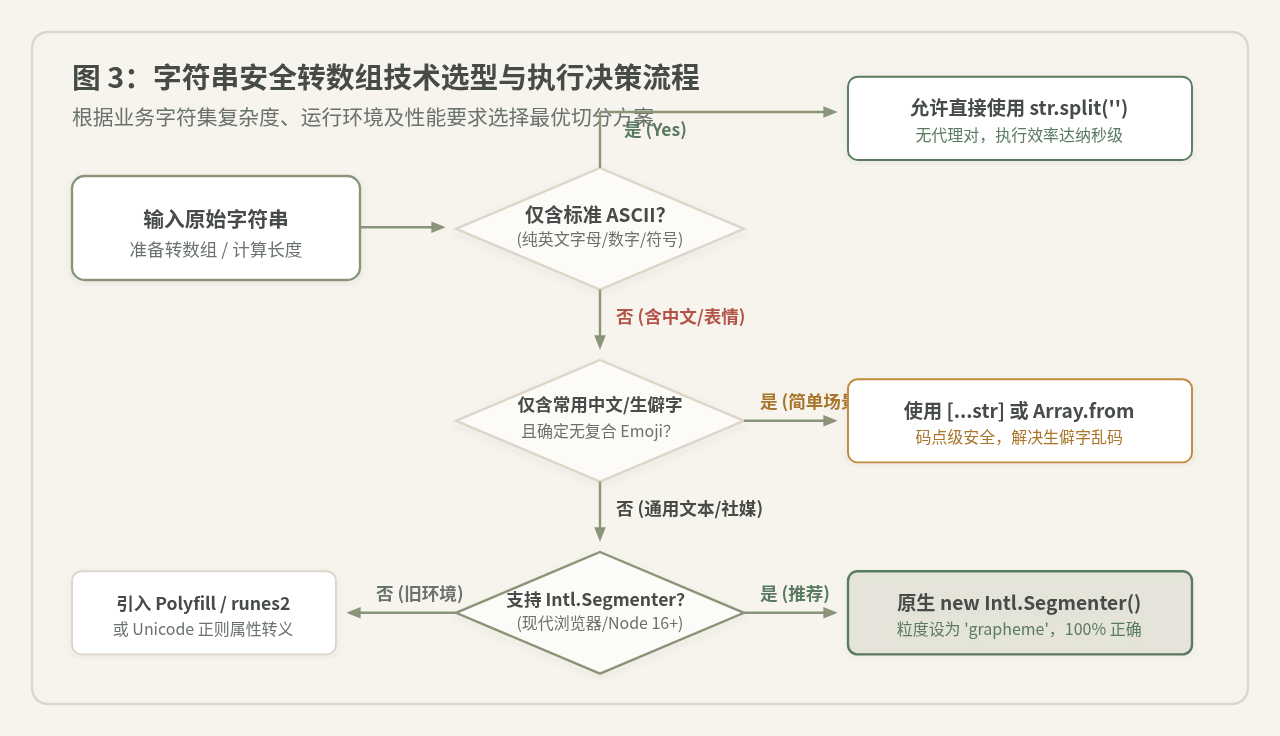
五、生产环境落地规范与防御性架构
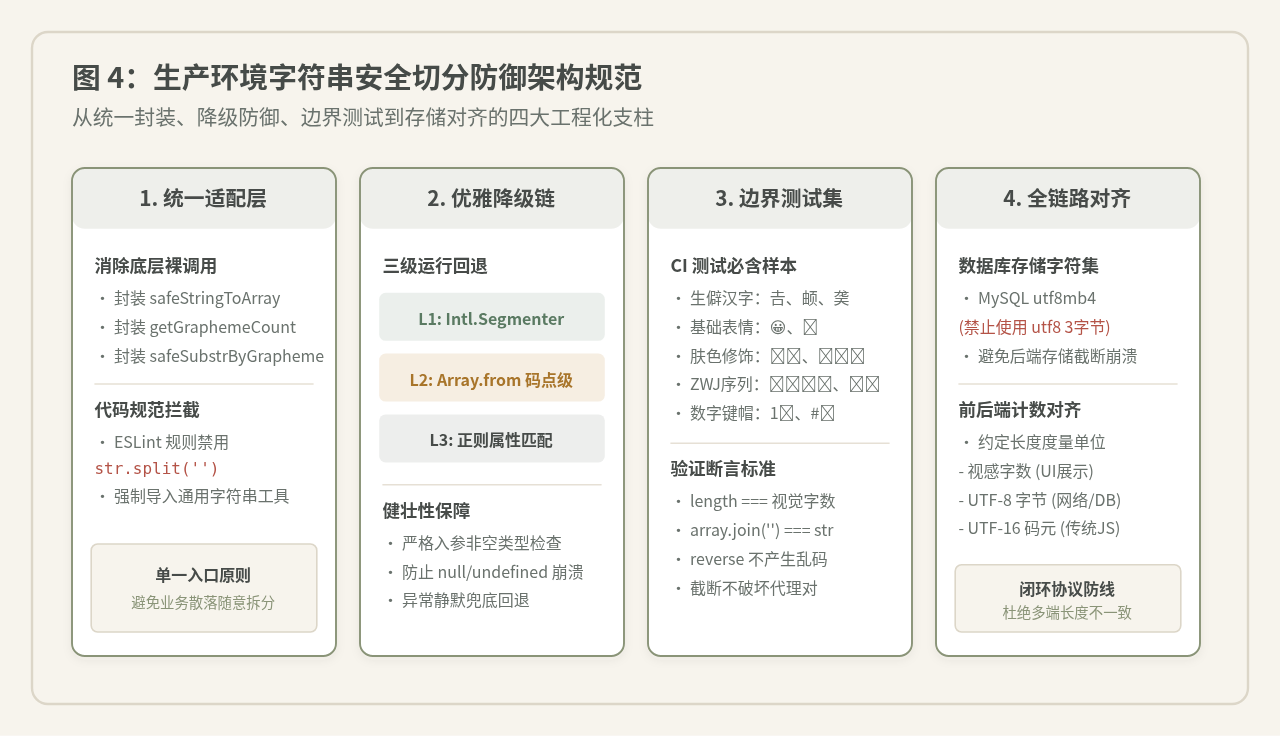
在实际商业项目中,字符串安全切分不能仅停留在单个函数编写层面,还必须落实到架构约束与全链路对齐规范中。
1. 运行环境与兼容性保障
Intl.Segmenter 目前已被纳入主流浏览器与服务端运行时的标准支持列表:
- Chrome / Chromium: 87+(2020 年末开始全面原生支持)
- Safari(iOS / macOS): 14.1+(2021 年春全面支持)
- Node.js: 16.0.0+(自带完整 ICU 国际化数据包)
- Firefox: 125+(现代版本已正式默认开启)
对于需要兼容存量旧版 Android 微信内置浏览器或低版本 Webview 的项目,推荐在构建时配置轻量 Polyfill,或安装经过业界实测的字符解析包(如 runes2 或基于 Unicode 属性转义 /\p{Extended_Pictographic}/u 的正则表达式解析器)。
2. 静态代码分析与 Lint 拦截
直接书写 str.split('') 往往是开发者的潜意识习惯。在大型团队协同中,建议在 ESLint 规则中增加自定义限制:
// .eslintrc.js 规则配置片段
module.exports = {
  rules: {
    "no-restricted-syntax": [
      "error",
      {
        selector: "CallExpression[callee.property.name='split'][arguments.0.value='']",
        message: "禁止直接使用 split('') 进行单字符拆分,可能导致生僻字或Emoji乱码。请改用 utils/string 中的 safeSplitToArray。"
      }
    ]
  }
};
3. 前后端度量单位与数据库对齐
前端展示通常关注“用户肉眼可见字符数”,而后端数据库关注“存储字节数”或“码元上限”。必须防范前端按照字形簇算出了 10 个字符并通过了字数限制,但后端采用截断逻辑导致最后一个字符的代理对被裁掉一半的情况:
- 数据库字符集: MySQL 数据库表字段必须声明为
utf8mb4,杜绝历史旧版utf8(实际仅支持 3 字节,写入任何 Emoji 或辅助平面生僻字将直接报错)。 - 接口传输对齐: 在提交字数限制敏感的文本时,接口文档应明确规定字段长度约束是按字形簇(Grapheme)、码点(Code Point)还是 UTF-8 字节(Bytes)度量。
六、核心方法与适用边界速查
| 转换方法 | 工作层级 | 生僻字表现 | 复合 Emoji 表现 | 性能开销 | 推荐使用场景 |
|---|---|---|---|---|---|
str.split('') |
16-bit 码元 | 乱码 (两半) | 乱码 (碎片化) | 极低 (纳秒级) | 明确仅含 ASCII / 纯数字英文字符串 |
[...str] / Array.from() |
Unicode 码点 | 正常 | 连字破裂 / 肤色脱落 | 低 (微秒级) | 仅有人名生僻字或基础表情的轻量场景 |
Intl.Segmenter |
字形簇 (Grapheme) | 正常 | 完整单一字符 | 中 (微秒级,支持实例复用) | 通用生产级推荐:用户输入、富文本、社媒与国际化应用 |
Intl.Segmenter 作为核心实现,配合 [...str] 进行环境嗅探降级。在高性能批量循环场景下,建议在函数外部提前实例化 new Intl.Segmenter() 并复用实例,以避免重复初始化带来的开销。
JS怎么使用展开运算符合并对象
2026-11-05 14:42:18
ES6+环境下判断JS对象为空的简洁写法
2026-11-05 12:12:23
怎么通过replacer函数自定义JS中JSON的格式化输出
2026-11-05 11:19:44
JS正则表达式基础:字面量与RegExp构造函数的区别及常用元字符
2026-11-05 11:16:58
JS使用Array.from和Array.of创建数组的方法
2026-11-05 10:43:07