JS数组查找元素:find、findIndex与includes的高效用法
深入解析JavaScript中find、findIndex与includes三个数组检索方法的核心原理、短路机制、类型判定算法、场景选型决策以及高频查找下的性能优化实践。
假设你正在开发一个用户权限管理模块,接口返回了包含数百名成员的对象数组。当需要判断某个 ID 是否具有编辑权限、从列表中取出当前登录用户的详细配置,或者根据用户工号原地删除离职员工时,选择正确的数组查找方法直接决定了代码的语义清晰度与执行效率。
核心答案与方法全景
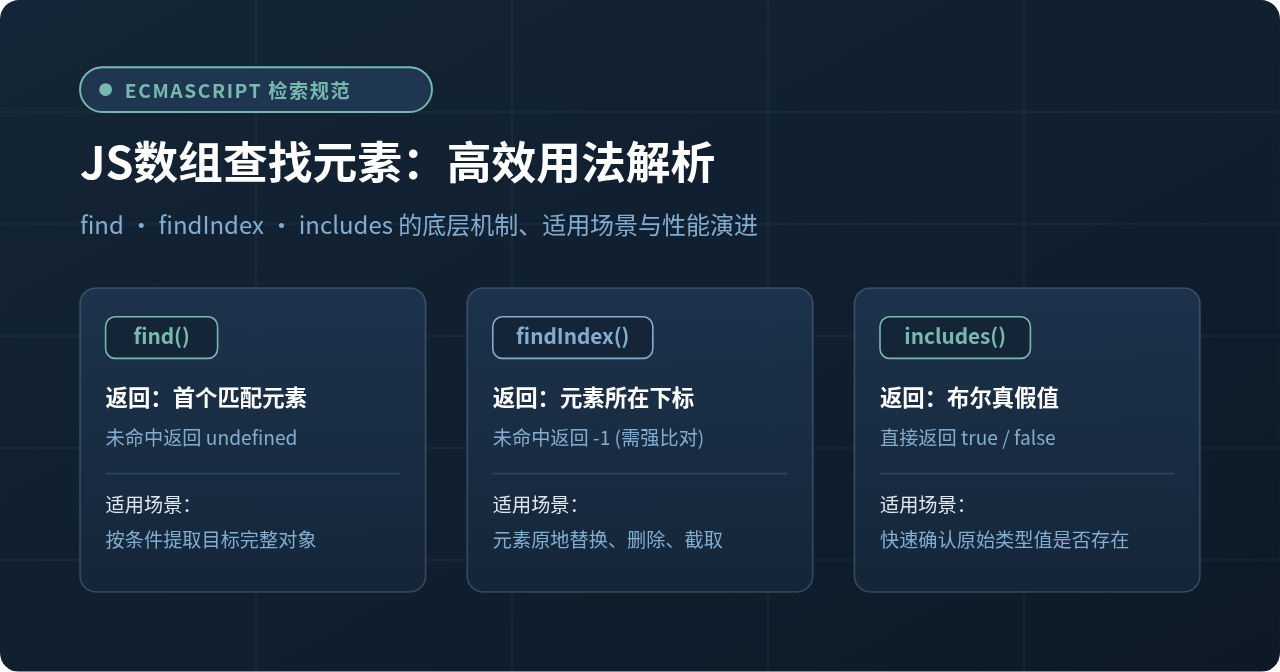
在现代 JavaScript 中,面对数组查找需求,核心解决方案由三个职责各异的 API 构成:
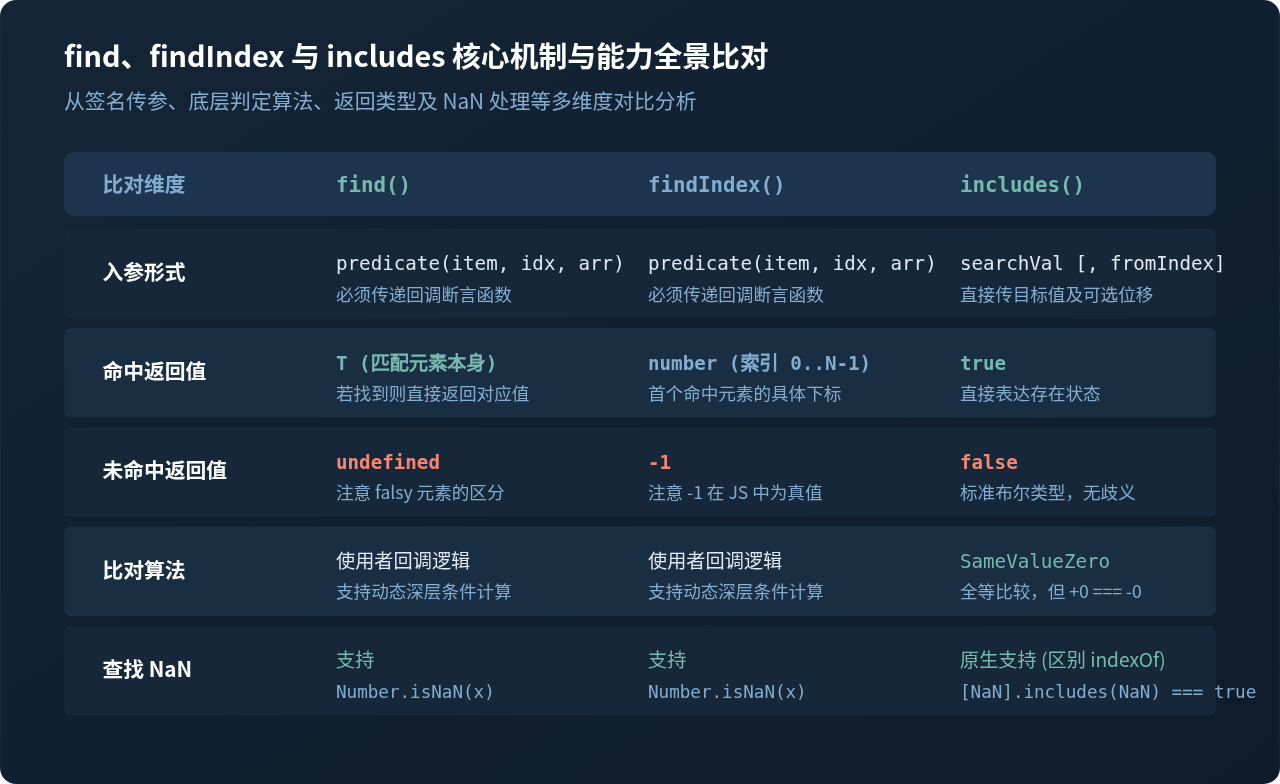
Array.prototype.includes:专用于判断值是否存在。接收一个待比对的目标值(支持可选偏移量),直接返回布尔值(true或false)。它采用SameValueZero比较算法,比传统indexOf !== -1语义更纯粹,且能精准识别NaN。Array.prototype.find:专用于按条件提取目标元素。接收一个谓词函数(Predicate),返回数组中第一个使该函数返回真值的元素本身;若没有匹配项,则返回undefined。Array.prototype.findIndex:专用于定位目标元素的下标位置。同样接收谓词函数,返回首个匹配项的索引数字(0到length - 1);若未找到,则返回-1。该下标直接用于数组的更新、截取或原地删除(如splice)。
它们都具备短路求值(Early Return)特性:遍历过程中只要满足判定条件,就会立即终止对后续元素的遍历,从而避免无谓的算力开销。
执行流程与短路求值原理
许多开发者习惯于使用 filter()[0] 来获取满足条件的第一个元素,这种写法在小数组中看似无伤大雅,但在大数据集合中存在严重的性能隐患。filter() 必须无条件完整遍历整个数组并分配一个全新的临时数组,而 find 与 findIndex 在底层执行引擎中遵循严格的短路机制。
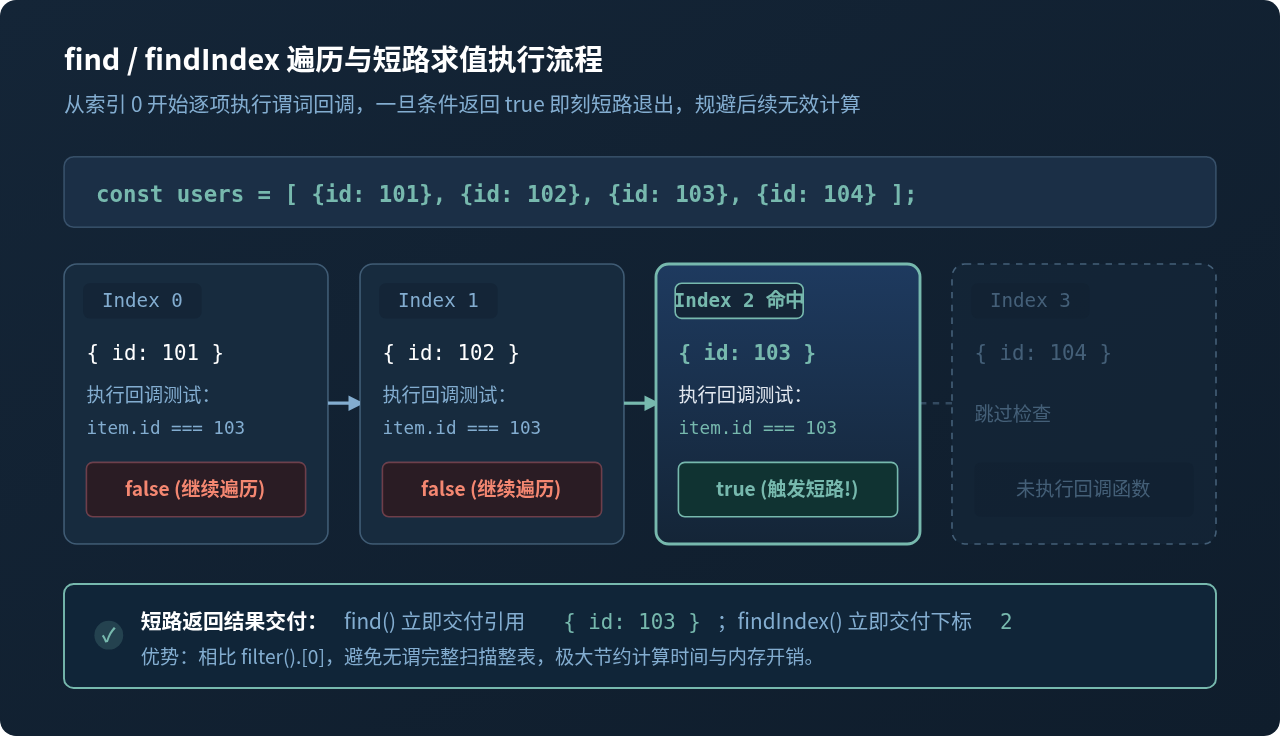
如上图所示,当数组包含若干元素时,执行过程按以下严密步骤展开:
- 从索引
0开始,依次将当前项element、下标index及原数组array传递给回调函数。 - 执行回调内部逻辑,如果返回假值(Falsy),迭代指针自增步进至下一项。
- 一旦某一项使回调返回真值(Truthy),引擎立即捕获该项(或下标),直接跳出整个迭代循环,后续未遍历的所有元素(如示例中的 Index 3)完全不会触发回调函数,实现计算资源的即时释放。
下面的代码直观展示了短路机制对函数调用次数的优化效果:
// 示例:验证短路特性与执行开销
const items = [{ id: 1 }, { id: 2 }, { id: 3 }, { id: 4 }, { id: 5 }];
let callCount = 0;

const result = items.find(item => {
  callCount++;
  return item.id === 2;
});

console.log(result);    // 输出: { id: 2 }
console.log(callCount); // 输出: 2(仅执行了两次回调,后序 3 个元素直接跳过)
三大方法的核心机制与特性比对
虽然三个方法都服务于“查找”,但其底层算法、参数结构和返回值机制存在根本性差异。
1. includes:轻量级值检索与 SameValueZero 算法
includes(searchElement[, fromIndex]) 是 ES2016 引入的特性。它的核心价值在于简化存在性检查并解决 JavaScript 长期存在的 NaN 对比黑洞。
// 传统 indexOf 的 NaN 缺陷
const numbers = [10, 20, NaN, 40];
console.log(numbers.indexOf(NaN)); // 输出: -1(因为 NaN !== NaN)

// includes 采用 SameValueZero 规范算法
console.log(numbers.includes(NaN)); // 输出: true(精准识别 NaN)
console.log(numbers.includes(20, 2)); // 输出: false(从索引 2 开始检索,避开索引 1)注意引用类型比对陷阱:includes 只能对对象引用做浅层全等比对。如果数组内部存放的是普通对象字面量,由于每次创建字面量都会生成新的内存地址,直接比对字面量永远返回 false:
// 常见错误:对象字面量引用不同
const list = [{ id: 1 }];
console.log(list.includes({ id: 1 })); // 输出: false

// 正确方式:必须匹配相同的对象引用
const sharedRef = { id: 1 };
const list2 = [sharedRef];
console.log(list2.includes(sharedRef)); // 输出: true
2. find:解构并提取深层对象实体
当目标数据是对象集合,或者需要根据动态表达式(如大于某个数值、符合正则规则等)进行匹配时,find 是最标准的选择。
const products = [
  { sku: "A100", title: "无线键盘", stock: 0 },
  { sku: "B200", title: "人体工学椅", stock: 12 },
  { sku: "C300", title: "4K显示器", stock: 5 }
];

// 查找第一款有库存的商品
const availableProduct = products.find(item => item.stock > 0);
console.log(availableProduct); // 输出: { sku: 'B200', title: '人体工学椅', stock: 12 }
3. findIndex:定位位置用于结构变更
如果在找到元素后需要原地修改属性、更新数组特定位置,或者利用 splice 将其剔除,获取索引下标是不可或缺的中间步骤。
const users = [
  { id: 101, name: "张三", active: true },
  { id: 102, name: "李四", active: false },
  { id: 103, name: "王五", active: true }
];

// 定位李四的下标并安全剔除
const targetIndex = users.findIndex(u => u.id === 102);

if (targetIndex !== -1) {
  users.splice(targetIndex, 1); // 从索引处删除 1 个元素
}
console.log(users.length); // 输出: 2
场景选型指南与决策路径
在编写业务逻辑时,切勿盲目混用上述方法。合理的选型应当综合考虑入参数据形态、判断复杂度以及最终的操作诉求。
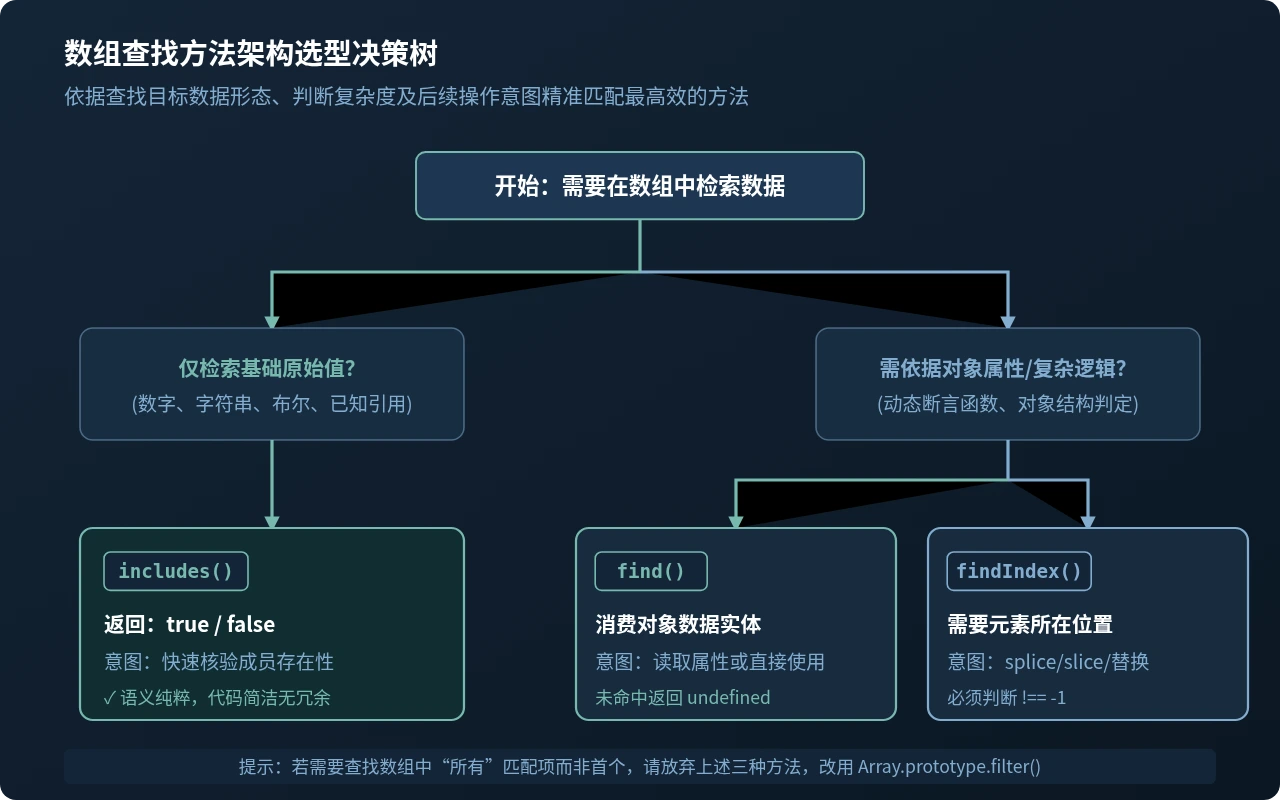
选型总结如下:
- 仅需回答“在不在”:优先选用
includes()。代码意图一目了然,无需声明冗长的箭头函数。 - 需要取出元素做计算或展示:选用
find()。直接拿到数据实体,无需先查下标再通过arr[index]访问。 - 需要对原数组进行切片、替换或删除:选用
findIndex()。定位到确切偏移量后对接slice()、splice()或用于不可变更新状态。
高频查找下的性能优化实战
find、findIndex 和 includes 的底层时间复杂度皆为 O(N)。在绝大多数常规前端交互或千级以下数组中,单次查找耗时仅数微秒,完全满足要求。
然而,当面临高频密集查询场景——例如在表格渲染时,每一行都要在另一个大型配置列表中查找对应的部门名称或字典标签(即 $M$ 次查询嵌套在 $N$ 长度数组上),整体时间复杂度会退化为 $O(M imes N)$。
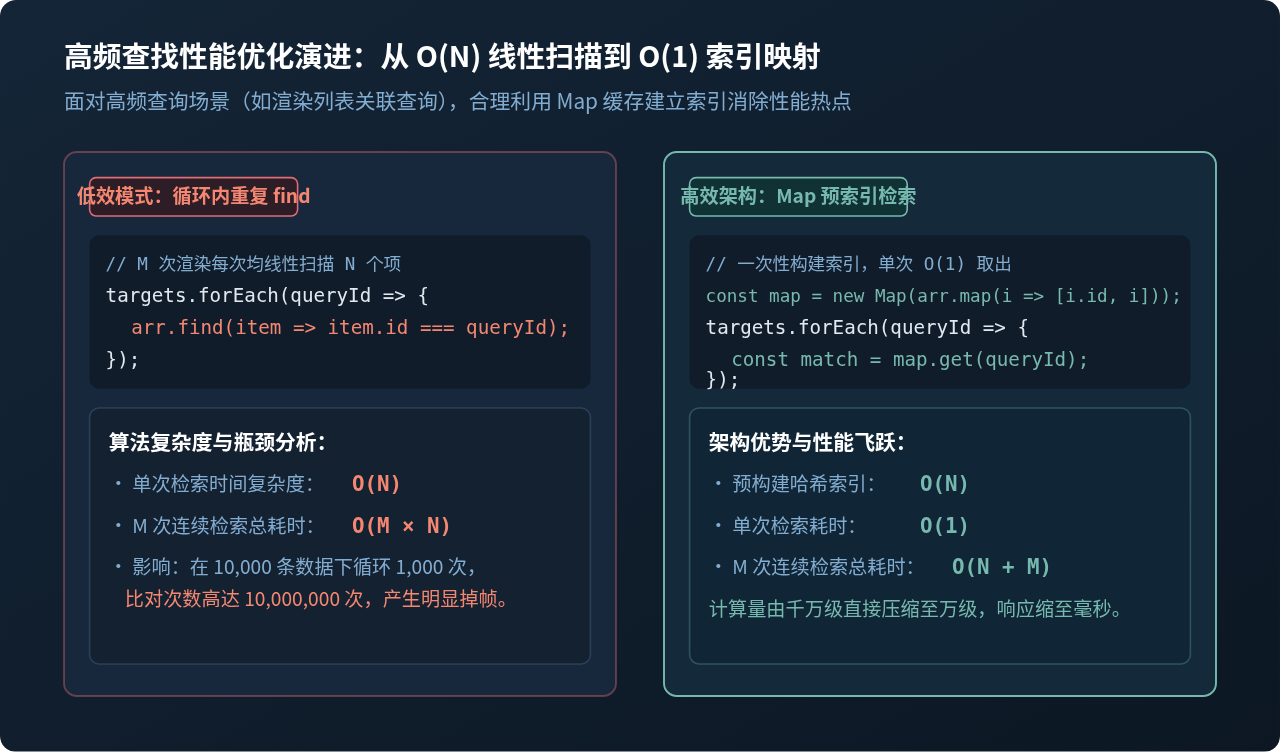
优化的核心路径是将多次重复扫描转化为一次性哈希构建:
// 优化前:O(M * N) 嵌套遍历,引起前端掉帧
function matchUsersNaive(orderList, userList) {
  return orderList.map(order => {
    const user = userList.find(u => u.id === order.userId); // 每次循环均全表查找
    return { ...order, userName: user?.name };
  });
}

// 优化后:O(N + M) Map 预构建索引,性能提升几十倍
function matchUsersOptimized(orderList, userList) {
  // 1. 先用 O(N) 一次性构建哈希索引
  const userMap = new Map(userList.map(u => [u.id, u]));

  // 2. 后续查询均为 O(1)
  return orderList.map(order => {
    const user = userMap.get(order.userId);
    return { ...order, userName: user?.name };
  });
}
常见陷阱与避坑清单
在日常代码评审与调试中,以下四个典型错误高发且隐蔽,需重点规避:
1. findIndex 的真值判定陷阱
在 JavaScript 中,任何非零数值都是真值(Truthy),而 -1 也是真值!如果错误地直接写出 if (arr.findIndex(...)),当未找到元素返回 -1 时,代码依然会误入分支内部:
const index = [1, 2, 3].findIndex(x => x === 999); // 返回 -1

// ❌ 错误写法:-1 被强制转换为 true
if (index) {
  console.log("触发误判!"); // 会被执行!导致逻辑严重错误
}

// ✅ 正确写法:严格与 -1 比对
if (index !== -1) {
  // 安全操作
}
2. find 返回 Falsy 基础值的歧义
当数组中存储的是原始基础值时,匹配到的结果可能恰好是 0、"" 或 false。此时若直接使用 if (arr.find(...)),会导致真正匹配到的合法值被误当作“未找到”:
const scores = [0, 85, 92];
const zeroScore = scores.find(s => s === 0);

// ❌ 错误判断:0 在布尔上下文中为 false
if (zeroScore) {
  // 此分支不会进入
}

// ✅ 正确判断:与 undefined 比对,或改用 includes
if (zeroScore !== undefined) {
  console.log("成功找到 0 分项");
}
3. 异步回调函数(Async Callback)的误用
find 和 findIndex 的回调函数必须是同步函数。如果在谓词中传入 async 函数,async 函数始终返回一个 Promise 对象,而所有对象在布尔判定中都是真值。这会导致回调在检查第一个元素时就立即满足条件退出:
// ❌ 严重错误:async 函数永远返回真值 Promise 对象
const target = users.find(async user => {
  return await checkRemoteStatus(user.id);
});
// 结果将无条件返回 users[0],完全起不到异步过滤效果!
4. 稀疏数组(Sparse Arrays)空槽的处理机制
根据 ECMAScript 规范,find、findIndex 和 includes 会对稀疏数组中的空槽(Empty Slot / Hole)进行访问,将空槽视为具有值 undefined 的元素。而旧规范中的 forEach、map、indexOf 则会直接跳过空槽。这一行为差异需特别注意。
JS 鼠标滚轮事件频繁触发导致卡顿怎么优化?
2026-11-05 17:08:07
优化JS回到顶部性能:防抖节流与requestAnimationFrame应用
2026-11-05 16:33:51
JS中Array、Set与Map的区别及应用场景选择
2026-11-05 16:03:02
PixiJS 常见报错排查:纹理跨域、黑屏与内存泄漏解决
2026-11-05 10:05:21
JS数组find与filter取值区别及性能对比
2026-11-05 08:39:21