

JavaScript怎么截取字符串的前N位和后N位
详细解析在JavaScript中截取字符串前N位与后N位的标准方法、底层索引机制、slice与substring的差异对比,以及处理边界情况与Unicode表情字符的实战指南。
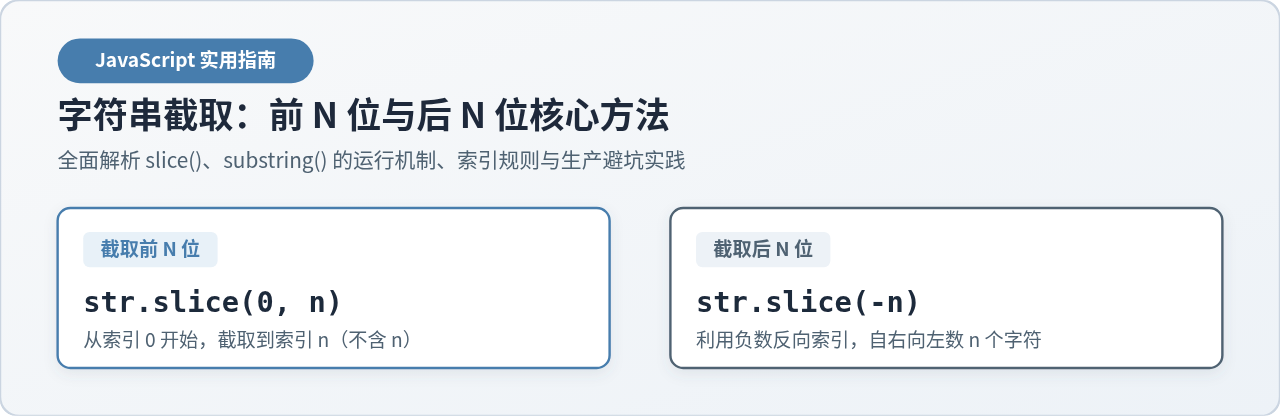
String.prototype.slice()。截取前 N 位写作 str.slice(0, n);截取后 N 位写作 str.slice(-n)。当截取后 N 位且传入的 N 可能为 0 时,建议写成 n <= 0 ? '' : str.slice(-n) 以防止误返回完整原串。
在日常前端与 Node.js 业务开发中,提取字符串开头或结尾的若干字符是高频操作,例如手机号脱敏截取、文件拓展名前缀判定、流水号后四位提取或卡号展示等。虽然 JavaScript 提供了多种截取字符串的原生 API,但不同方法在负数索引处理、边界溢出控制以及参数语义上存在明显差异。本文将系统梳理标准解决方案、底层索引模型与生产边界防护。
一、核心标准方法:使用 slice() 高效截取
slice(startIndex, endIndex) 是 ECMAScript 标准中最推荐使用的字符串切片方法。它提取原字符串的一个子片段,并返回一个新字符串,而绝不修改原字符串(JavaScript 字符串本身是不可变的)。
1. 切片的核心规则:左闭右开
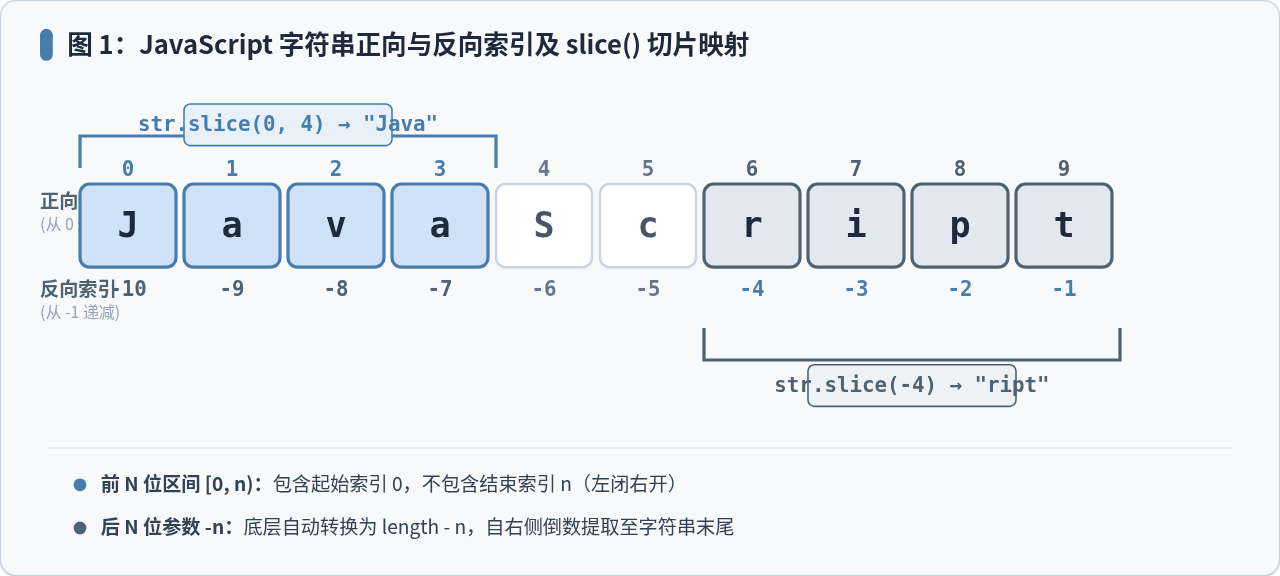
slice() 接收两个参数:第一个参数为提取的起始位置 startIndex(包含该位置字符),第二个参数为结束位置 endIndex(不包含该位置字符),即数学上的半开半闭区间 [startIndex, endIndex)。如果省略第二个参数,则默认截取到字符串的末尾。
2. 截取前 N 位的具体代码
由于 JavaScript 字符串索引从 0 开始计数,截取前 N 位即代表从索引 0 提取到索引 n 之前:
// 示例:截取前 N 位
const text = "JavaScript";
const n = 4;

const firstN = text.slice(0, n);
console.log(firstN);"Java"
当 n 大于或等于字符串总长度时,slice(0, n) 并不会抛出异常,而是优雅地返回完整原字符串副本;如果 n 为 0,则返回空字符串 ""。
3. 截取后 N 位的具体代码
slice() 原生支持负数参数。当传入负数时,JavaScript 会将其自动换算为 length + index,其中 -1 表示最后一个字符,-n 表示倒数第 n 个字符。因此,仅需传入 -n 即可直接截取末尾 N 个字符:
// 示例:截取后 N 位
const text = "JavaScript";
const n = 4;

const lastN = text.slice(-n);
console.log(lastN);"ript"
二、传统方案辨析:为什么不用 substring() 与 substr()
初学者常常困惑于 slice()、substring() 与 substr() 三者之间的区别。在实现“前N位”与“后N位”这一具体需求时,它们表现出完全不同的参数解析逻辑。
1. substring() 为什么不适合截取后 N 位
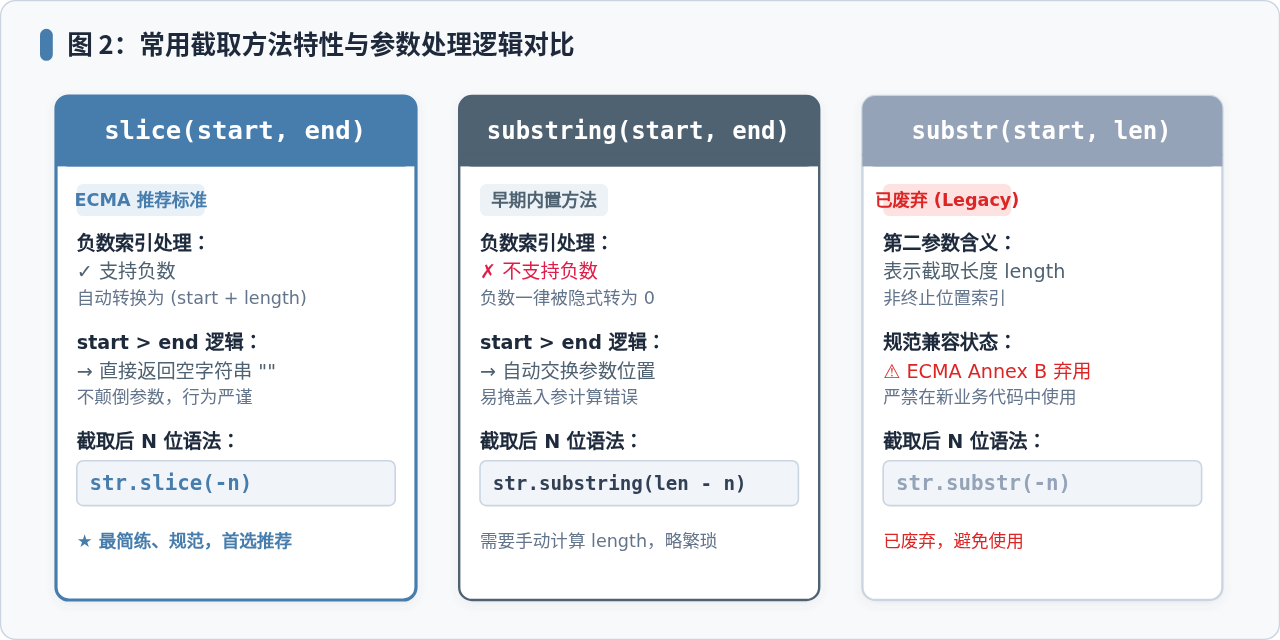
substring(start, end) 同样接收起始和结束索引,但它有两个违背直觉的特性:
- 负数一律转为 0:若传入任何小于 0 的数值,
substring()会强制将其当成0处理。因此str.substring(-4)实际上等价于str.substring(0),返回的是全部字符串,完全无法实现反向切片。 - 参数自动颠倒:若
start > end,substring()会自动交换这两个实参。例如str.substring(4, 0)会变成str.substring(0, 4)。这种“宽容”的设计在大型项目中经常会掩盖逻辑计算错误。
如果坚持使用 substring() 截取后 N 位,必须手动引入字符串长度做减法运算:str.substring(str.length - n),代码冗长且不易维护。
2. substr() 已被标准弃用
substr(start, length) 的第二个参数代表截取长度。尽管早期它支持负数起始索引(如 str.substr(-4) 能够截取后4位),但该方法已被 ECMAScript 官方规范正式标记为已弃用(Annex B Legacy)。现代 Web 规范强烈建议不要在任何新项目中继续使用 substr(),未来代码应全面迁移至 slice()。
三、严谨落地的实操步骤与边界防御
在编写高质量生产代码或公共工具函数时,除了知道最简语法,还需要考虑到入参类型异常、数值越界及负零陷阱等情况。
1. 警惕 N = 0 时的负零陷阱(-0 === 0)
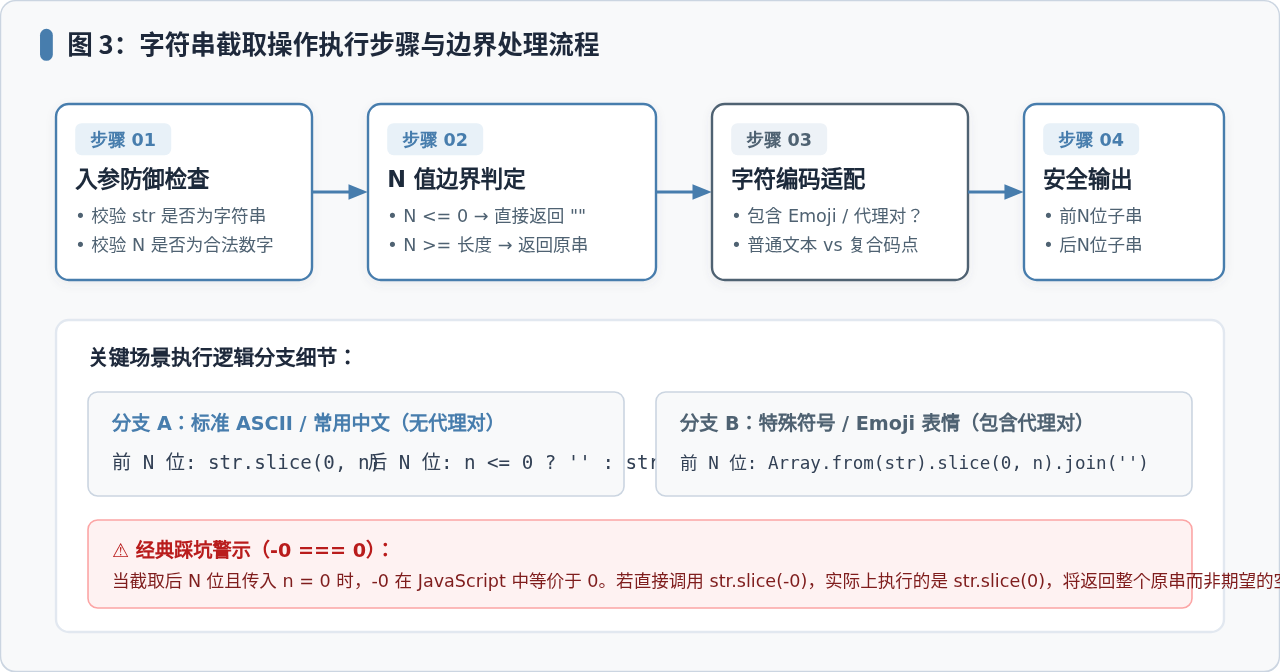
这是 JavaScript 字符串操作中最容易被忽略的隐蔽 Bug。当截取后 N 位且传入的变量 n = 0 时:
// 隐患示例:
const str = "Hello";
const n = 0;

// 在 JS 中,-0 完全严格等于 0
console.log(-n === 0); // true

// 因此 str.slice(-0) 实际上等同于 str.slice(0)!
const result = str.slice(-n);
console.log(result); // 输出 "Hello",而不是期望的 ""!"Hello"
由于数学上 -0 等同于 0,导致 str.slice(-0) 并不会从末尾倒数,而是被判定为正向索引 0,从而把整个字符串完整返回。为了解决这个问题,提取后 N 位时必须对 n <= 0 进行防御截断。
2. 工业级通用截取函数封装
下面给出严谨防错的前 N 位与后 N 位工具函数实现:
/**
 * 安全截取字符串的前 N 个字符
 * @param {string} str 待处理的字符串
 * @param {number} n 截取的字符位数
 * @returns {string}
 */
function takeFirstN(str, n) {
  if (typeof str !== 'string' || !n || n <= 0) {
    return '';
  }
  return str.slice(0, n);
}

/**
 * 安全截取字符串的后 N 个字符(防御 N=0 陷阱)
 * @param {string} str 待处理的字符串
 * @param {number} n 截取的字符位数
 * @returns {string}
 */
function takeLastN(str, n) {
  if (typeof str !== 'string' || !n || n <= 0) {
    return '';
  }
  return str.slice(-n);
}

// 执行验证
const sample = "Order-20261101-9876";

console.log("前5位:", takeFirstN(sample, 5));
console.log("后4位:", takeLastN(sample, 4));
console.log("后0位测试:", takeLastN(sample, 0));
console.log("超长位数测试:", takeFirstN(sample, 100));前5位: "Order"
后4位: "9876"
后0位测试: ""
超长位数测试: "Order-20261101-9876"
四、进阶场景:正确处理 Emoji 表情与特殊 Unicode 字符
在国际化场景或包含 Emoji 表情(如社交评论、昵称展示)时,直接使用 str.slice() 可能会造成字符截断乱码。这是因为 JavaScript 的字符串原生索引基于 UTF-16 代码单元(Code Units),而不是视觉上的“字符”。
1. 代理对(Surrogate Pairs)截断隐患
常用字符(如 ASCII 和常规汉字)属于基本多语言平面(BMP),占用 1 个 UTF-16 码元;而许多 Emoji 表情(例如 🎉、🚀)以及生僻汉字占用 2 个码元(代理对)。
// 代理对截断问题剖析
const emojiStr = "🎉新年快乐";
console.log(emojiStr.length); // 输出 5,因为 "🎉" 自身占用 2 个码元

// 错误示范:如果试图截取前 1 位
const broken = emojiStr.slice(0, 1);
console.log(broken); // 输出乱码字符 "\uD83C"(孤立高位代理项)"" (无效的高位代理项乱码)
2. 解决方案:使用码点迭代器(Array.from 或扩展运算符)
ES6 引入了 Unicode 码点识别机制。通过 Array.from(str) 或 [...str] 可以按完整的 Unicode 码点解构字符串,再执行切片即可保证 Emoji 结构完整无损:
// 优雅截取支持 Emoji 的前 N 位与后 N 位
function safeUnicodeTakeFirstN(str, n) {
  if (typeof str !== 'string' || !n || n <= 0) return '';
  return Array.from(str).slice(0, n).join('');
}

function safeUnicodeTakeLastN(str, n) {
  if (typeof str !== 'string' || !n || n <= 0) return '';
  return Array.from(str).slice(-n).join('');
}

const msg = "🎉恭贺新禧🎊";
console.log("安全前2位:", safeUnicodeTakeFirstN(msg, 2));
console.log("安全后2位:", safeUnicodeTakeLastN(msg, 2));安全前2位: "🎉恭"
安全后2位: "禧🎊"
五、总结与选型速查
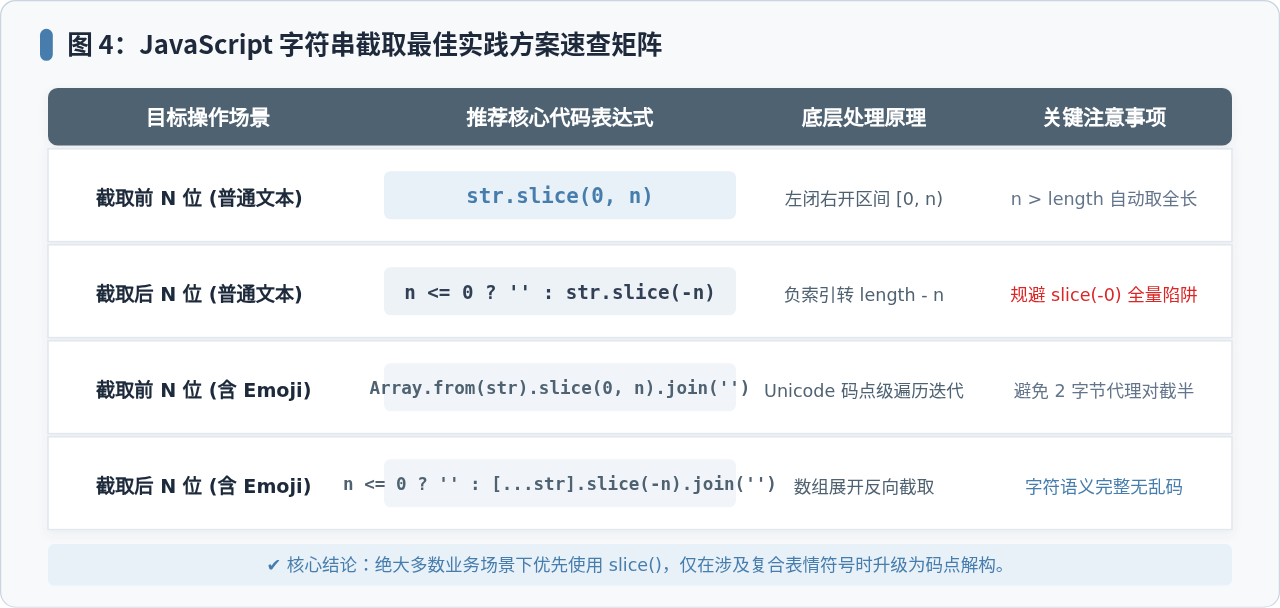
为了便于在不同业务场景中快速选型,下表对各类方案的技术特性进行综合归纳:
| 需求场景 | 推荐方案 | 时间复杂度 | 核心优势与注意事项 |
|---|---|---|---|
| 常规前 N 位 | str.slice(0, n) |
O(n) | 执行速度最快,标准内置,内存友好。 |
| 常规后 N 位 | n <= 0 ? '' : str.slice(-n) |
O(n) | 原生支持负数倒数,注意防范 n=0 的全量反弹。 |
| 包含 Emoji 表情前 N 位 | Array.from(str).slice(0, n).join('') |
O(L) | 按 Unicode 码点拆分,彻底消除高低位代理对半截乱码。 |
| 历史代码重构 | 替换废弃的 substr() 为 slice() |
- | 消除 Annex B 废弃警告,统一 API 调用范式。 |
掌握 slice() 的左闭右开区间与负数索引换算机制,是写出健壮、高效且可读性强的 JavaScript 字符串处理逻辑的坚实基础。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13







