JS数组扁平化指南:flat方法使用与递归实现原理
深入解析JavaScript数组扁平化的核心方法与底层实现。全面讲解原生Array.prototype.flat的使用细节、depth参数机制、稀疏数组处理,并从零剖析递归实现原理、调用栈执行过程与工业级防爆栈迭代方案。
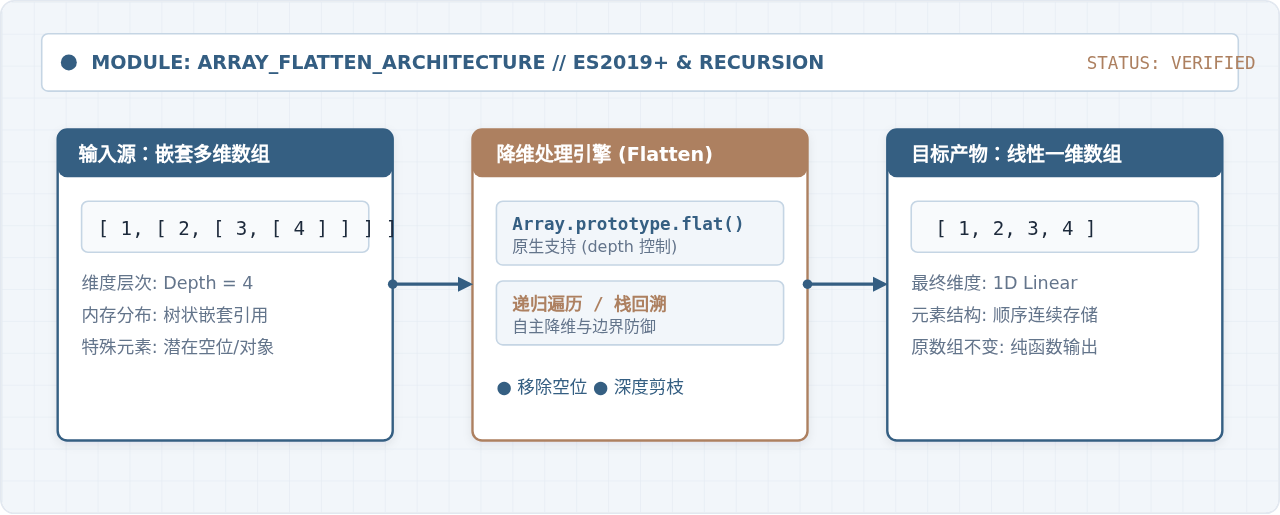
数组扁平化(Array Flattening)是将嵌套的多层数组转换为单一维度或指定维度线性数组的过程。在现代 JavaScript 中,最直接的手段是调用 ES2019 引入的原生 Array.prototype.flat() 方法;而在面试深挖、环境兼容或复杂业务定制场景中,基于递归的自实现机制则是考察对调用栈、数据结构解构与边界异常防御理解的核心范例。
一、什么是数组扁平化与典型业务场景
在前端与 Node.js 业务开发中,数据往往以树状或多级嵌套形式存在。例如,从级联选择器(Cascader)、多层评论楼层、多部门组织架构树中提取全部人员 ID,或是处理表格中跨行合并单元格导出的多维数组。
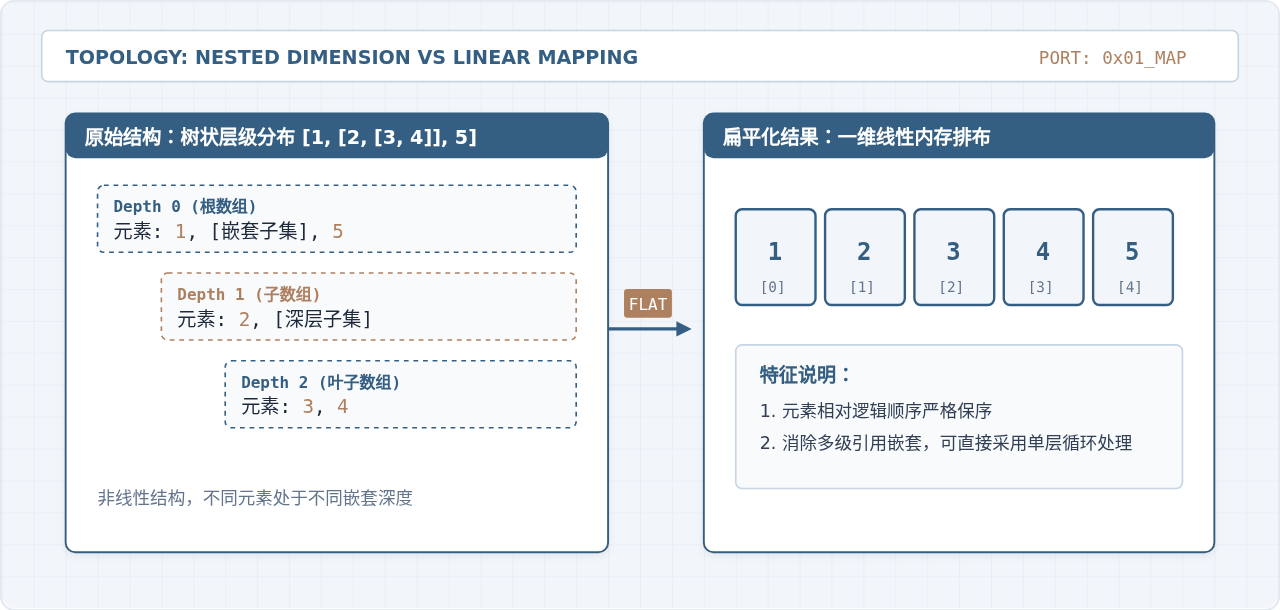
扁平化前后的数据在内存结构和访问方式上存在本质区别:
- 嵌套多维数组:包含一层或多层引用,遍历时需要多层下标
arr[i][j][k]或递归遍历,无法直接应用针对一维数组的filter、sort或find逻辑。 - 扁平化数组:所有叶子节点被提取为同一层级的线性序列,极大降低了后续数据统计、批量映射和索引过滤的复杂度。
二、原生 flat 方法的使用细节与边界行为
ECMAScript 2019 (ES10) 正式引入了 Array.prototype.flat() 方法。作为标准内置实现,它是开发中的首选方案。
1. 基础语法与 depth 参数
const newArray = arr.flat([depth]);depth(可选):指定要提取嵌套数组的结构深度。如果不传,默认值为1。- 返回值:包含扁平化后元素的新数组,原数组不会被修改。
const numbers = [1, [2, [3, [4]]]];

// 默认深度为 1,仅展开最外层的子数组
console.log(numbers.flat());
// 输出: [1, 2, [3, [4]]]

// 显式指定深度为 2
console.log(numbers.flat(2));
// 输出: [1, 2, 3, [4]]
2. 完全扁平化:使用 Infinity
当面对结构未知、嵌套层数随机的数组时,可以传入全局常量 Infinity,这表示无论嵌套多少层,都全部递归展开为一维数组:
const deepArray = [1, [2, [3, [4, [5]]]]];
console.log(deepArray.flat(Infinity));
// 输出: [1, 2, 3, 4, 5]depth <= 0,例如 flat(0) 或 flat(-1),flat() 不会执行任何拉平操作,而是返回原数组的浅拷贝。
3. 特殊机制:自动跳过稀疏数组中的空位
JavaScript 中的数组可能是稀疏的(Sparse Array),即存在未赋值的“空槽”(empty slot)。flat() 在执行时有一个特殊的规范行为:它会直接剔除数组中的空位,但保留显式声明的 undefined 或 null。
const sparseArr = [1, 2, , 4, undefined, null, [5, , 6]];

console.log(sparseArr.flat());
// 索引 2 和子数组中的空位被完全移除
// 输出: [1, 2, 4, undefined, null, 5, 6]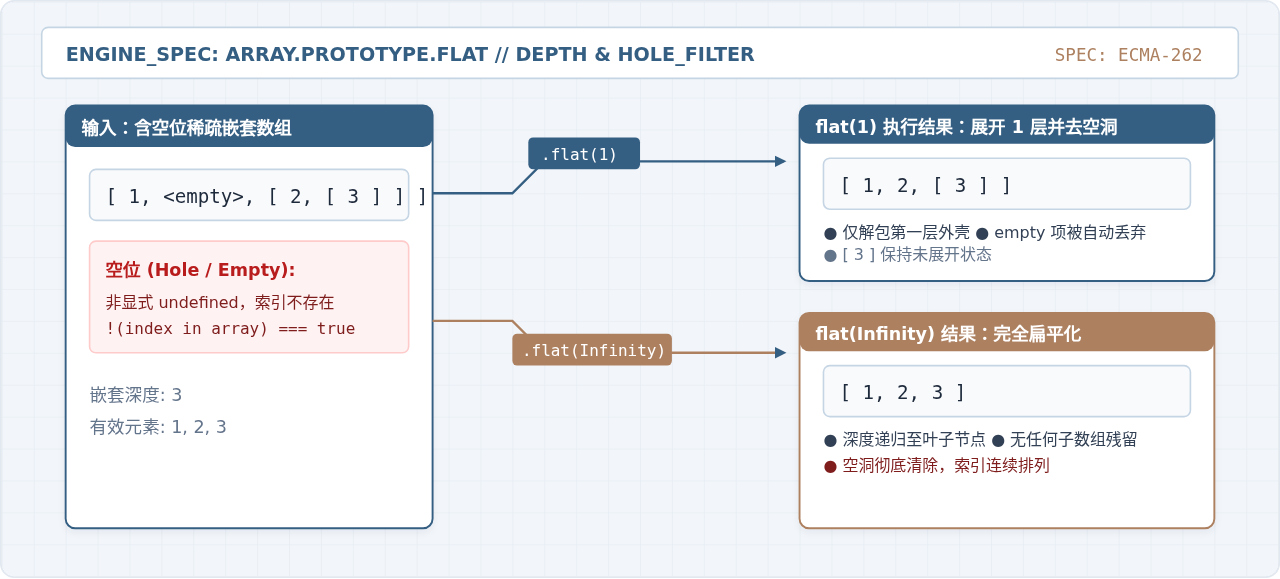
三、递归实现原理与分步代码演进
为了在不支持 ES2019 的旧版引擎(如 IE 或低版本客户端 WebView)中运行,或者实现带有自定义过滤规则的扁平化,我们需要掌握递归实现的底层原理。
递归的核心逻辑:
- 创建一个结果容器。
- 顺序遍历数组中的每个元素。
- 基线条件(Base Case):如果当前项不是数组,直接追加进结果容器。
- 递归条件(Recursive Case):如果当前项是数组,则递归调用扁平化函数,将返回值与当前结果合并。
1. 基础全量递归:forEach 与 push 组合
这是最直观且高效的递归形式。利用 Array.isArray() 判断类型,配合闭包存储展开结果:
function flattenDeep(arr) {
  const result = [];

  function step(current) {
    for (const item of current) {
      if (Array.isArray(item)) {
        step(item); // 遇到数组进入下一层递归
      } else {
        result.push(item); // 叶子节点入队
      }
    }
  }

  step(arr);
  return result;
}

// 测试验证
console.log(flattenDeep([1, [2, [3, 4]], 5]));
// 输出: [1, 2, 3, 4, 5]
2. 函数式风格:reduce 与 concat 递归
许多代码库喜欢使用 Array.prototype.reduce 编写更加声明式的扁平化逻辑:
const flattenByReduce = (arr) =>
  arr.reduce((prev, cur) =>
    prev.concat(Array.isArray(cur) ? flattenByReduce(cur) : cur),
    []
);reduce + concat 语法虽然精简优雅,但每次 concat 都会重新分配内存并浅拷贝已有元素。在数据量庞大(如几万条)时,内存分配与垃圾回收压力明显高于直接使用 push 的闭包实现。
3. 工业级自实现:支持 depth 参数的递归 flat
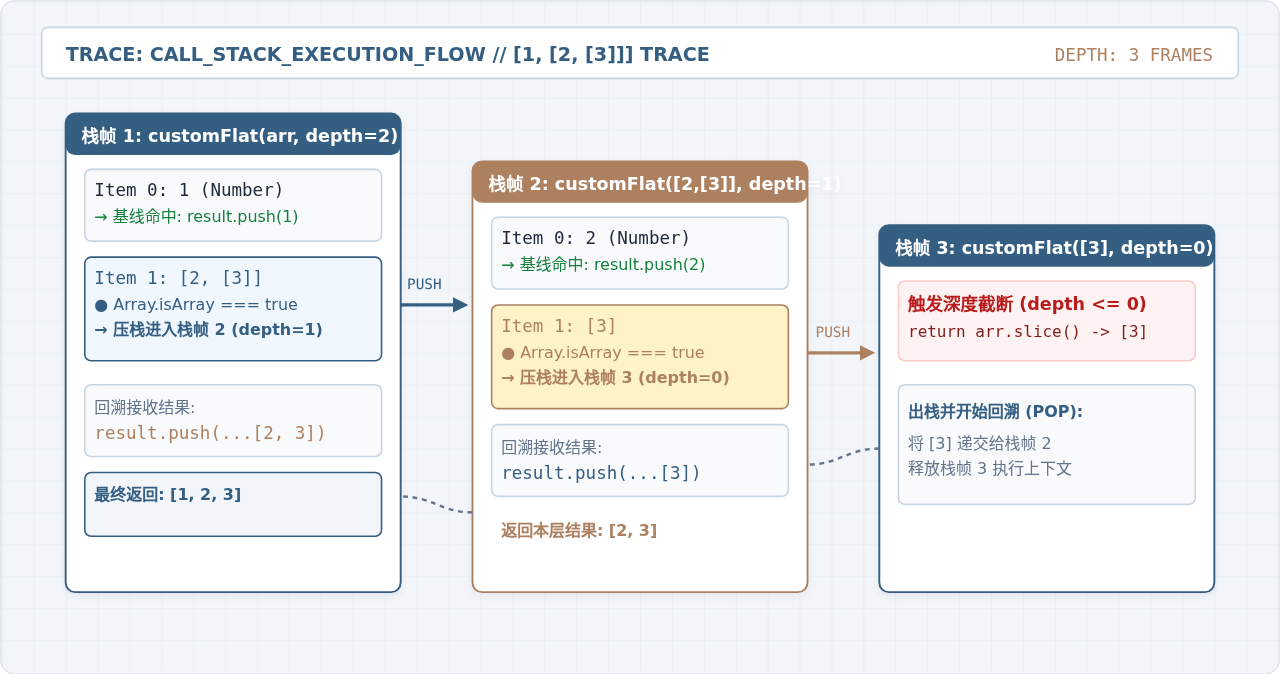
为了精准模拟原生 arr.flat(depth) 的行为,我们需要在递归函数中引入 depth 递减计数器:
function customFlat(arr, depth = 1) {
  // 如果深度小于等于0,或输入不是数组,直接返回浅拷贝
  if (depth <= 0 || !Array.isArray(arr)) {
    return arr.slice();
  }

  const result = [];

  for (let i = 0; i < arr.length; i++) {
    // 模拟原生行为:利用 in 操作符过滤稀疏数组空位
    if (i in arr) {
      const item = arr[i];
      if (Array.isArray(item) && depth > 0) {
        // 递归调用,深度递减 1,并将结果合并
        result.push(...customFlat(item, depth - 1));
      } else {
        result.push(item);
      }
    }
  }

  return result;
}
四、边界防御:栈溢出、循环引用与性能调优
递归方案虽然逻辑清晰,但在生产级复杂场景下,存在不可忽视的系统级隐患。
1. 递归调用栈溢出(Maximum Call Stack Size Exceeded)
V8 引擎对 JavaScript 执行栈的深度有严格限制(通常在 10,000 帧左右)。如果数组嵌套层级过深(例如由爬虫爬取的恶劣树形结构、过深 AST),纯递归方案会直接导致整个主线程崩溃抛出 RangeError。
工业级解法:基于显式栈(Stack)的迭代展开法
使用 JavaScript 堆内存中的普通数组模拟调用栈,把递归调用转化为单层 while 循环,彻底规避执行调用栈溢出风险:
function flattenIterative(arr) {
  const stack = [...arr];
  const result = [];

  while (stack.length > 0) {
    const next = stack.pop();
    if (Array.isArray(next)) {
      // 将子数组解开重新放回栈中继续处理
      stack.push(...next);
    } else {
      result.push(next);
    }
  }

  // 由于使用的是 pop(),结果是倒序的,最后反转一次保序
  return result.reverse();
}
2. 循环引用检测(Circular Reference)
当数组内部不小心引用了自身或祖先节点时,递归会陷入无休止的死循环,最终耗尽资源崩溃。
// 构造循环引用示例
const cyclicArr = [1, 2];
cyclicArr.push(cyclicArr); // 自身包含自身
防御手段:引入 WeakSet 缓存追踪
在递归执行过程中记录所有已经遍历过的数组引用。一旦发现当前数组已经在 seen 集合中,立即中断当前分支或抛出异常:
function safeFlattenDeep(arr, seen = new WeakSet()) {
  if (seen.has(arr)) {
    throw new TypeError("检测到数组存在循环引用,已终止扁平化");
  }
  seen.add(arr);

  const res = [];
  for (const item of arr) {
    if (Array.isArray(item)) {
      res.push(...safeFlattenDeep(item, seen));
    } else {
      res.push(item);
    }
  }
  return res;
}
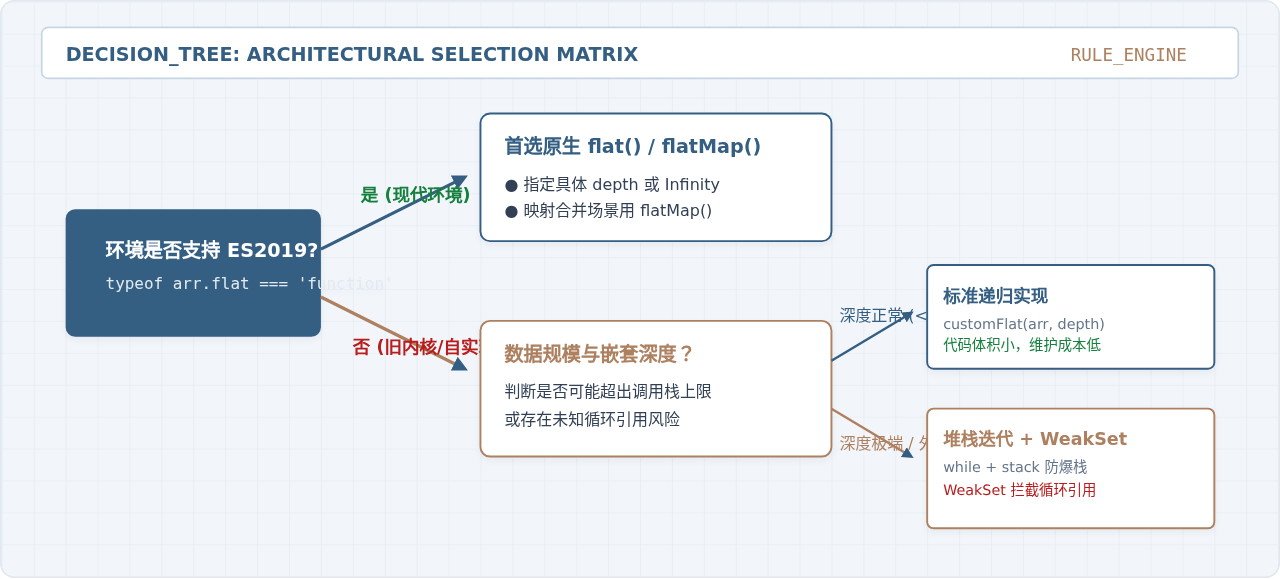
五、各扁平化实现方案对比与选型决策
| 实现方案 | 深度可控性 | 稀疏数组空位处理 | 栈安全 (超深嵌套) | 性能与适用场景 |
|---|---|---|---|---|
| 原生 flat() | 完整支持 (默认1,支持指定与 Infinity) | 规范行为:自动剔除空位 | C++ 底层优化,抗深度能力强 | 首选。现代浏览器与 Node.js 11+ 标准方案。 |
| 递归 + push/闭包 | 易扩展支持深度计数器 | 需显式 i in arr 过滤 |
受 JS 调用栈深度限制(约 1万层) | 轻量高效,逻辑直观,代码体积小。 |
| reduce + concat | 可扩展 | 自动跳过空位(reduce自身特性) | 受调用栈限制,内存开销大 | 适合单行函数式写法,数据量大时不推荐。 |
| 显式堆栈迭代 (while) | 可通过包装元组记录深度 | 需手动适配空位检测 | 绝对栈安全,受堆内存支配 | 适合未知来源、深度极端或抗崩溃级别的大数据处理。 |
六、总结
JavaScript 数组扁平化是处理层级与树形数据的基本功:
- 日常生产代码中,优先使用标准
Array.prototype.flat()。它在底层 C++ 引擎中被高度优化,原生支持深度截断(depth)与稀疏空洞自动清理。 - 当需要 Polyfill 或在面试与自研库中手写实现时,递归的核心在于明确基线条件(非数组直接入队)与递归条件(子数组递归回溯),并通过
in运算符过滤空槽。 - 面对不可控的极端深层数据或存在对象相互引用的复杂结构时,应主动升级为“堆栈循环迭代法”与“WeakSet 环检测机制”,从根本上保证程序的健壮性与健壮的内存控制。
JavaScript怎么遍历对象的Symbol键和不可枚举属性
2026-11-05 13:13:39
封装一个健壮的JS字符串判空工具函数
2026-11-05 12:16:14
JavaScript合并数组的三种常用方法:concat、扩展运算符与push
2026-11-05 11:22:29
JavaScript立即执行函数(IIFE)是什么及基本语法
2026-11-05 10:51:19
JS对象数组转字符串为什么推荐用JSON.stringify()
2026-11-05 09:40:31