

JS怎么从URL链接中解析并获取文件名
深入讲解在 JavaScript 中如何从 URL 链接中解析并提取完整文件名、文件主干名称与扩展名。详细剖析常规 split 方法的边界陷阱,给出基于 URL API、路径清洗、中文编码还原及服务端 Content-Disposition 的工业级解决方案。
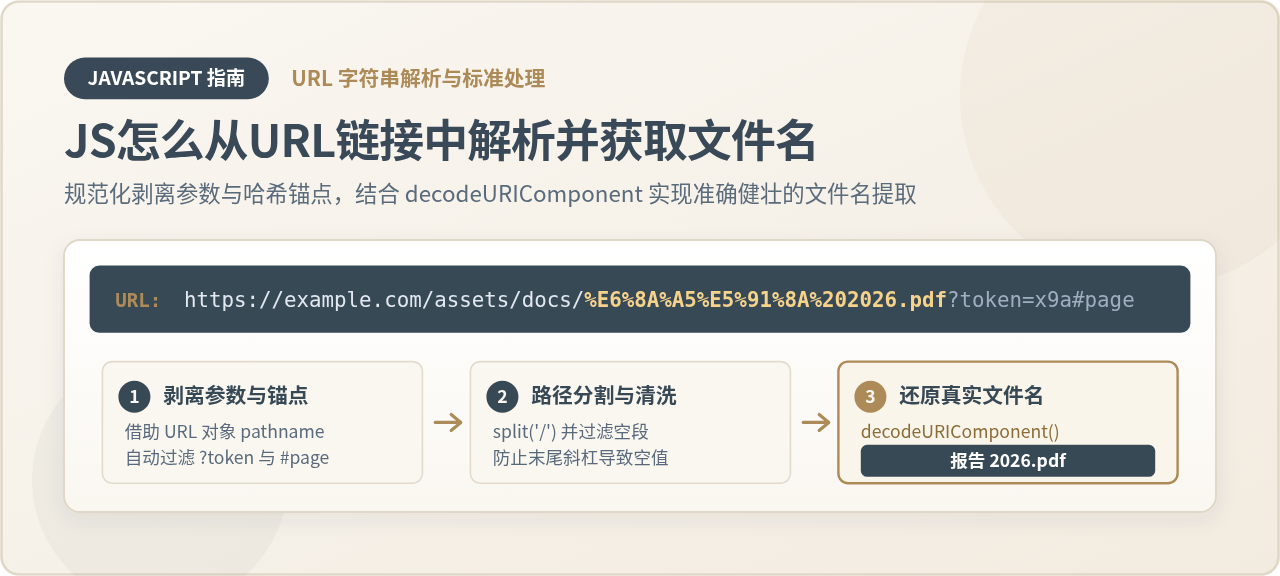
在 JavaScript 中,从 URL 链接中解析并获取文件名的最稳妥方式是使用内置的 URL 对象结合 decodeURIComponent。通过 new URL(url).pathname 自动剥离查询参数(Query String)与哈希锚点(Hash Fragment),再提取路径的末尾片段并完成中文及特殊字符的逆向解码,可以彻底规避由于参数干扰、末尾斜杠或 URI 编码导致的提取错误。本文将从常见误区出发,完整演示标准四步解析法、主文件名与扩展名拆分技巧、常见边界场景及工程级封装实现。
一、为什么不能简单用 split('/'):URL 的解构真相
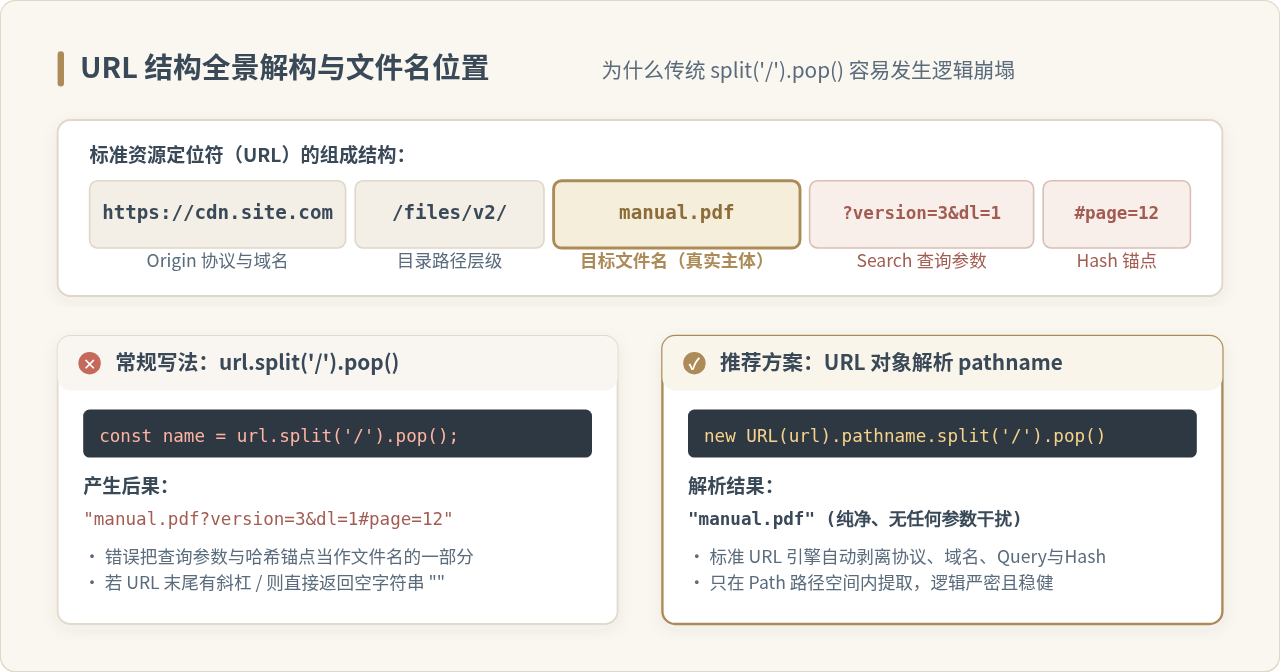
很多开发者在初次遇到该需求时,习惯性写出 url.split('/').pop()。这种方式仅在最理想、最简单的静态绝对路径下看起来有效,一旦进入实际业务环境,极易出现隐蔽的解析 Bug。
一个标准的 URL 并非单纯由斜杠分隔的文件系统路径,而是由 Origin(协议与主机)、Pathname(目录路径)、Search(查询参数) 和 Hash(哈希锚点) 组成的复合结构:
- 查询参数干扰:形如
https://cdn.com/doc/report.pdf?v=2&dl=1,直接使用pop()得到的是report.pdf?v=2&dl=1,后续若将其作为文件名保存或展示,后缀名判断将彻底失效。 - 锚点片段污染:带有哈希的链接
https://site.com/file.png#preview会返回file.png#preview。 - 末尾斜杠导致空值:若链接以斜杠结尾(如
https://site.com/download/v1.0/),直接pop()得到的是一个空字符串""。 - 中文与空格编码失真:浏览器网络传输中,非 ASCII 字符会被编码。例如
财务月报.xlsx呈现为%E8%B4%A2%E5%8A%A1%E6%9C%88%E6%8A%A5.xlsx,直接截取会导致界面显示为乱码。
二、现代 JavaScript 的标准解法:URL 对象四步处理法
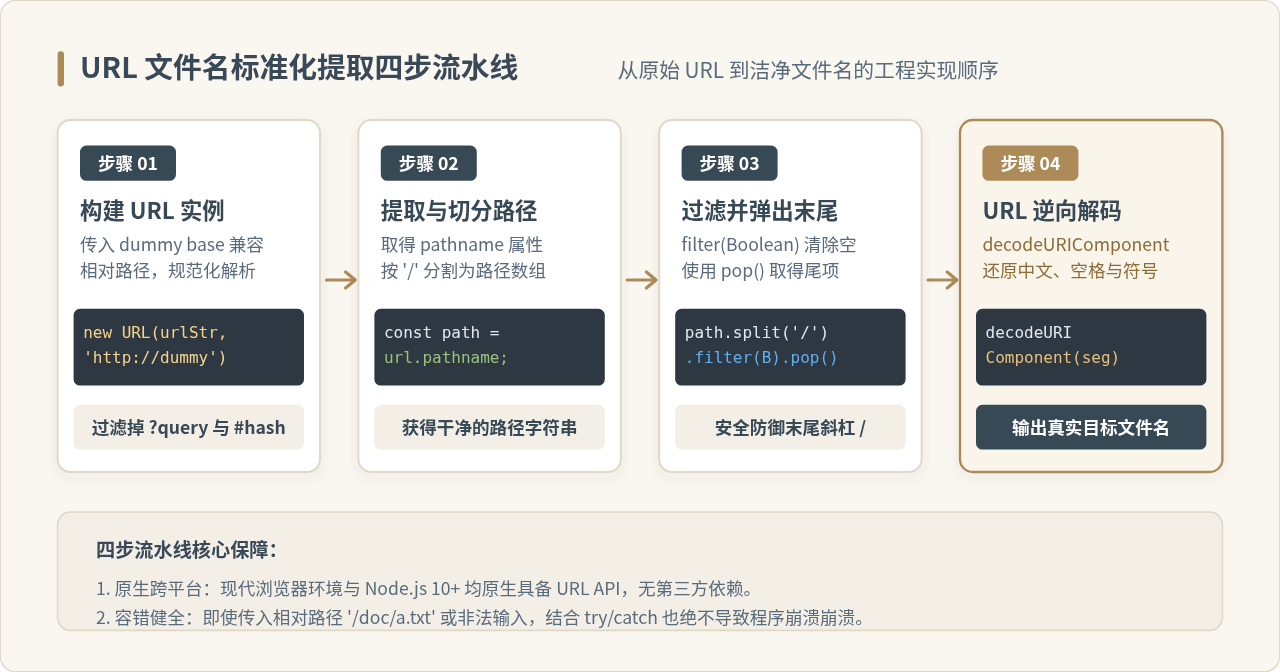
现代浏览器以及 Node.js 10+ 环境均已原生支持标准 URL Web API。借助该接口,我们只需四个步骤就能安全提取文件名:
- 构建 URL 规范实例:利用
new URL(urlString, dummyBase)自动标准化地址。添加基准域名可以无缝兼容/assets/demo.png这类相对路径。 - 提取纯净 Pathname:
urlObj.pathname会自动剔除所有的?query与#hash,只保留纯路径部分。 - 清洗与弹出末尾段:按斜杠
/切割后,使用.filter(Boolean)清除多余的空段(防御连续斜杠与末尾斜杠),随后调用.pop()获取末尾段。 - 解码还原字符串:调用
decodeURIComponent(),将%20还原为空格,将 UTF-8 编码还原为真实中文字符。
下面是实现这一标准逻辑的核心代码:
/**
 * 从 URL 链接中提取纯净文件名
 * @param {string} urlString - 待解析的 URL(支持绝对与相对路径)
 * @param {string} [fallbackName=''] - 当无法解析时返回的默认文件名
 * @returns {string} 洁净的文件名
 */
function getFilenameFromUrl(urlString, fallbackName = '') {
  if (!urlString || typeof urlString !== 'string') {
    return fallbackName;
  }

  try {
    // 传入基准域 'http://dummy.local',确保相对路径(如 '/docs/a.pdf')也能合法解析
    const parsedUrl = new URL(urlString, 'http://dummy.local');

    // 1. 获取纯净的 pathname(自动剥离 ?query 和 #hash)
    const pathname = parsedUrl.pathname;

    // 2. 按 '/' 切割,并过滤掉空段(防御末尾斜杠与双斜杠)
    const segments = pathname.split('/').filter(Boolean);
    if (segments.length === 0) {
      return fallbackName;
    }

    // 3. 取出最后一段
    const rawFilename = segments.pop() || '';

    // 4. 对 URI 编码字符进行逆向还原
    return decodeURIComponent(rawFilename);
  } catch (error) {
    // 当输入内容无法构成合法路径时返回兜底
    return fallbackName;
  }
}

// --- 运行示例 ---
console.log(getFilenameFromUrl('https://example.com/files/%E6%9C%88%E5%BA%A6%E6%8A%A5%E8%A1%A8.xlsx?token=abc#view'));
// 输出:月度报表.xlsx

console.log(getFilenameFromUrl('/static/images/hero%20banner.png?v=1.2'));
// 输出:hero banner.png

console.log(getFilenameFromUrl('https://example.com/packages/release-2.0.0/'));
// 输出:release-2.0.0(自动规避末尾斜杠导致的空值)
三、进阶:分离文件主名称与扩展名
在实际业务(如重命名上传、格式校验、图标匹配)中,我们通常不仅需要完整文件名,还需要将文件主干名(Base Name)与文件扩展名(Extension)分离开来。
需要注意拆分扩展名时的两个关键边界:
- 无扩展名文件:如 Dockerfile、LICENSE、README,不应误判为后缀。
- 隐藏文件 / 点开头文件:如
.gitignore、.env,点位于索引 0 处,其属于没有主名称的配置名,或者统一视作主名,不应误判扩展名为.gitignore。 - 包含多个点的复合文件:如
archive.tar.gz或jquery.min.js。通常业界标准以最后一个点作为扩展名分界符。
/**
 * 拆解文件名的主名称与扩展名
 * @param {string} fullName - 完整文件名,例如 "summary.v2.pdf"
 * @returns {{ fullName: string, baseName: string, extName: string }}
 */
function splitFilename(fullName) {
  if (!fullName) {
    return { fullName: '', baseName: '', extName: '' };
  }

  const lastDotIndex = fullName.lastIndexOf('.');

  // 如果没有点,或者点位于第 0 位(如 .gitignore),则没有扩展名
  if (lastDotIndex <= 0) {
    return {
      fullName,
      baseName: fullName,
      extName: ''
    };
  }

  return {
    fullName,
    baseName: fullName.substring(0, lastDotIndex),
    extName: fullName.substring(lastDotIndex) // 包含点,例如 ".pdf"
  };
}

// --- 拆解测试示例 ---
console.log(splitFilename('annual-report.2026.pdf'));
// 输出:{ fullName: 'annual-report.2026.pdf', baseName: 'annual-report.2026', extName: '.pdf' }

console.log(splitFilename('.env'));
// 输出:{ fullName: '.env', baseName: '.env', extName: '' }
四、复杂边界场景的应对策略
在工程项目中,URL 来源五花八门。针对不同的输入源,需要做好充分的防御性编程。
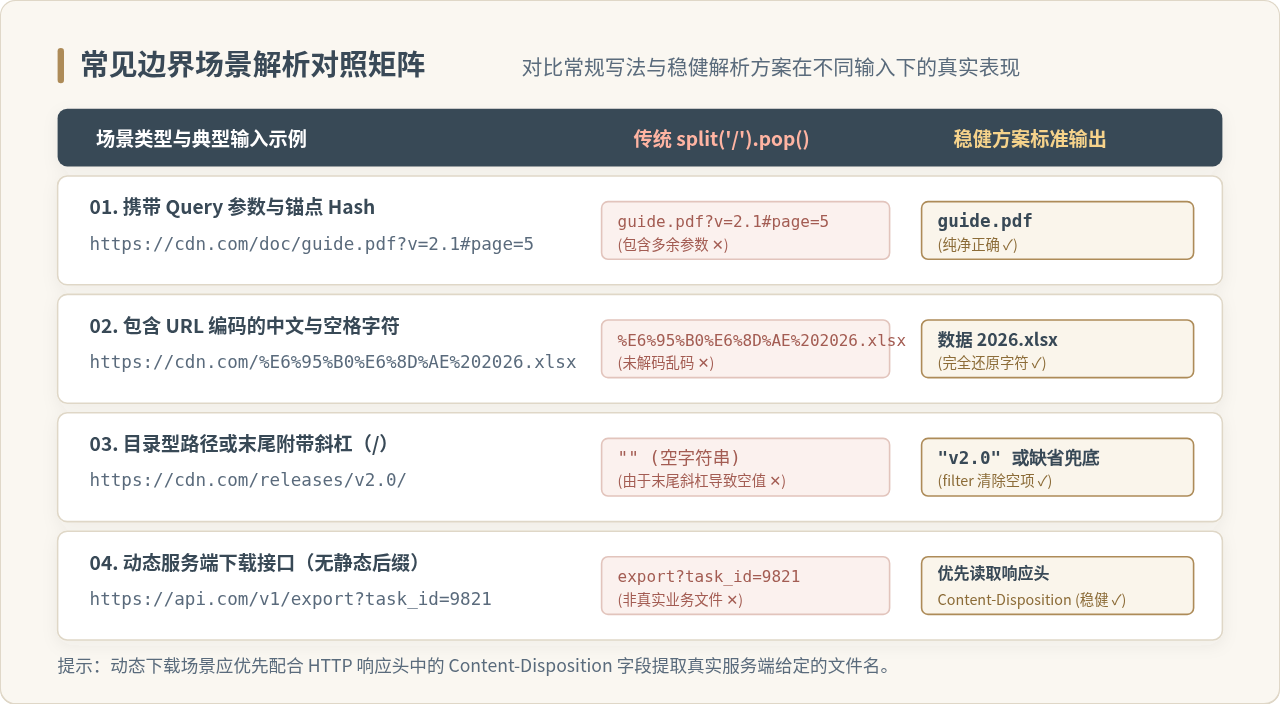
1. 动态接口下载与 Content-Disposition 响应头
许多文件下载并不是指向云存储(如 OSS / S3)的静态物理路径,而是指向后端的一个控制层接口,例如:
https://api.system.com/v1/export-report?taskId=9527&format=csv这种情况下,URL 的 pathname 是 /v1/export-report,末尾段是 export-report。若直接从 URL 截取,不仅丢失了真实的文件扩展名 .csv,甚至连有意义的文件名都无法获取。
对于后端动态生成的流式下载,真实文件名由 HTTP 响应头 Content-Disposition 提供,例如 Content-Disposition: attachment; filename="Report_2026.csv"; filename*=UTF-8''Report_2026.csv。在前端发送 Ajax / Fetch 请求时,应优先尝试从响应头提取文件名;若无响应头,再降级使用 URL 解析兜底。
前端通过 Fetch 响应头提取文件名的参考范式:
/**
 * 从 HTTP 响应头 Content-Disposition 中提取文件名
 * @param {Headers} headers - Fetch 响应头对象
 * @returns {string|null} 提取出的文件名
 */
function getFilenameFromHeaders(headers) {
  const disposition = headers.get('content-disposition');
  if (!disposition) return null;

  // 1. 优先匹配 RFC 5987 编码标准: filename*=UTF-8''%e6%b5%8b%e8%af%95.xlsx
  const utf8Match = disposition.match(/filename\*=UTF-8''([^;\s]+)/i);
  if (utf8Match && utf8Match[1]) {
    return decodeURIComponent(utf8Match[1]);
  }

  // 2. 匹配标准引号包裹格式: filename="report.xlsx"
  const quotedMatch = disposition.match(/filename="([^"]+)"/i);
  if (quotedMatch && quotedMatch[1]) {
    return quotedMatch[1];
  }

  // 3. 匹配无引号裸格式: filename=report.xlsx
  const plainMatch = disposition.match(/filename=([^;\s]+)/i);
  if (plainMatch && plainMatch[1]) {
    return plainMatch[1];
  }

  return null;
}
2. Blob URL 与 Data URL
在前端处理本地预览或导出时,常产生类似 blob:https://example.com/7b3b3a32-1594-4b53-9d7a-112233445566 的临时对象链接。这类 URL 的 pathname 是一串 UUID,无法从中获取有语义的文件名。对于这类对象,应在生成 Blob 对象时主动绑定并传递预定义文件名,避免依赖从 URL 反查。
五、正则提取方案(轻量级替代场景)
在某些资源受限或极轻量的脚本场景中,如果不希望实例化 URL 对象,也可以使用单条正则表达式完成路径末尾提取:
/**
 * 使用正则从 URL 提取文件名
 * @param {string} url
 * @returns {string}
 */
function getFilenameByRegex(url) {
  if (!url || typeof url !== 'string') return '';

  // 匹配规则:排除 ? 和 #,找到最后一个 / 与 (?|#|$) 之间的字符串
  const match = url.match(/\/([^/?#]+)(?:[?#]|$)/);
  if (!match) return '';

  try {
    return decodeURIComponent(match[1]);
  } catch (e) {
    return match[1];
  }
}
正则方案对比评估:正则表达式性能极高,但在应对末尾连续斜杠、相对复杂协议(如 blob:、data:)时规则容易膨胀变脆。对于常规 Web 应用与 Node.js 生产环境,仍首选标准 URL 对象。
六、工程化实践:封装健壮的文件名提取工具
综合以上所有要点,我们在工程项目中可以封装一个兼具容错降级、结构化输出与中文转义恢复的通用解析器:
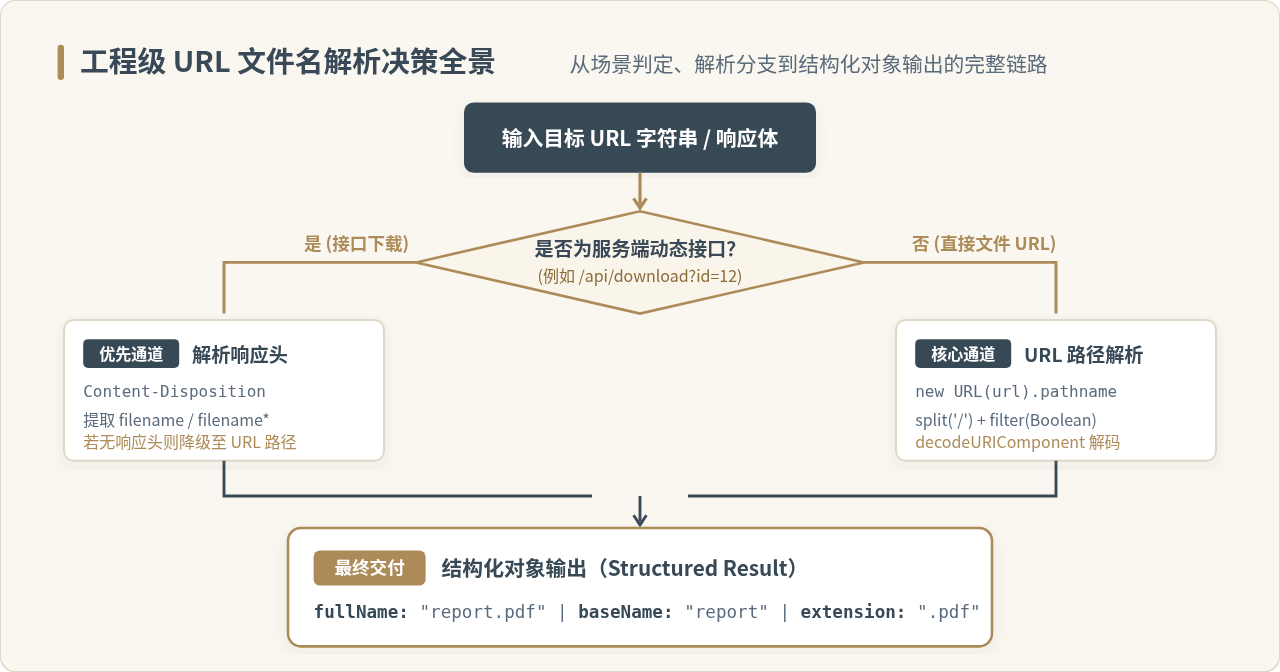
/**
 * 工业级 URL 文件名解析工具函数
 * @param {string} url - 资源 URL
 * @param {object} [options] - 配置项
 * @param {string} [options.defaultName='download'] - 无法提取时的默认主名
 * @param {string} [options.defaultExt=''] - 无法提取时的默认后缀(如 '.dat')
 * @returns {{ fullName: string, baseName: string, extName: string, isValid: boolean }}
 */
function parseUrlFilename(url, options = {}) {
  const { defaultName = 'download', defaultExt = '' } = options;

  const fallback = {
    fullName: defaultName + defaultExt,
    baseName: defaultName,
    extName: defaultExt,
    isValid: false
  };

  if (!url || typeof url !== 'string') {
    return fallback;
  }

  try {
    // 兼容相对路径,传入虚拟 host
    const parsed = new URL(url, 'http://localhost');
    const segments = parsed.pathname.split('/').filter(Boolean);

    if (segments.length === 0) {
      return fallback;
    }

    // 弹出末尾片段并解码
    const rawSegment = segments.pop() || '';
    const cleanName = decodeURIComponent(rawSegment).trim();

    if (!cleanName) {
      return fallback;
    }

    // 分离扩展名
    const dotIndex = cleanName.lastIndexOf('.');
    if (dotIndex <= 0) {
      // 无后缀或隐藏文件
      return {
        fullName: cleanName,
        baseName: cleanName,
        extName: defaultExt,
        isValid: true
      };
    }

    return {
      fullName: cleanName,
      baseName: cleanName.substring(0, dotIndex),
      extName: cleanName.substring(dotIndex),
      isValid: true
    };
  } catch (err) {
    return fallback;
  }
}

// ========================
// 综合测试用例验证
// ========================
const testCases = [
  'https://oss.mycorp.cn/reports/2026%E5%B9%B4%E8%B4%A2%E6%8A%A5.pdf?auth=key123#page=1',
  '/download/dist/package.tar.gz',
  'https://site.org/downloads/setup.exe?t=19283921',
  'https://site.org/docs/manual/',
  'https://site.org/.bashrc',
  'invalid-url-string'
];

testCases.forEach(testUrl => {
  console.log('测试链接:', testUrl);
  console.log('解析结果:', parseUrlFilename(testUrl));
  console.log('---');
});
七、要点总结与技术选型清单
| 解析考量点 | 高风险做法 | 工程化推荐做法 |
|---|---|---|
| 参数与哈希过滤 | 直接基于原字符串按 / 切割 |
使用 new URL(url).pathname 自动剥离 |
| 中文字符与空格 | 忽略编码,直接呈现原始字符串 | 调用 decodeURIComponent() 还原可读字符 |
| 末尾斜杠容错 | 直接取 pop() 得到空字符串 |
在 split('/') 后使用 .filter(Boolean) 清除空项 |
| 动态后端接口 | 强行从接口 URL 路径中猜测文件名 | 优先读取 HTTP 响应头的 Content-Disposition |
| 后缀名拆分 | 简单 split('.')[1],导致多点文件名截断 |
基于 lastIndexOf('.') 并排查隐藏文件边界 |
掌握以上规范,不仅能确保从静态资源链接中精准提取文件名,更能在面对接口流式下载、复杂中文字符及多参数 URL 时,提供高可靠性的文件处理能力。
JS处理含Emoji或中文的字符串转数组乱码问题
2026-11-05 16:12:28
JS怎么使用展开运算符合并对象
2026-11-05 14:42:18
ES6+环境下判断JS对象为空的简洁写法
2026-11-05 12:12:23
怎么通过replacer函数自定义JS中JSON的格式化输出
2026-11-05 11:19:44
JS正则表达式基础:字面量与RegExp构造函数的区别及常用元字符
2026-11-05 11:16:58







