JS前端怎么将数据生成文件并触发浏览器下载
详细讲解在纯前端环境下如何利用JavaScript将内存数据封装为Blob对象、创建临时URL并借助a标签下载属性触发浏览器文件下载,涵盖JSON、CSV乱码处理、大文件与内存释放等核心实践。
在纯前端场景中,当页面需要将表格统计数据导出为 CSV、将编辑器的配置生成 JSON、或将页面绘制的内容另存为图像时,无需向服务端发送请求再由后端返回文件流。现代 JavaScript 可以直接在浏览器内存中把数据打包为二进制对象,并配合虚拟超链接的下载属性,直接唤起操作系统的保存对话框。
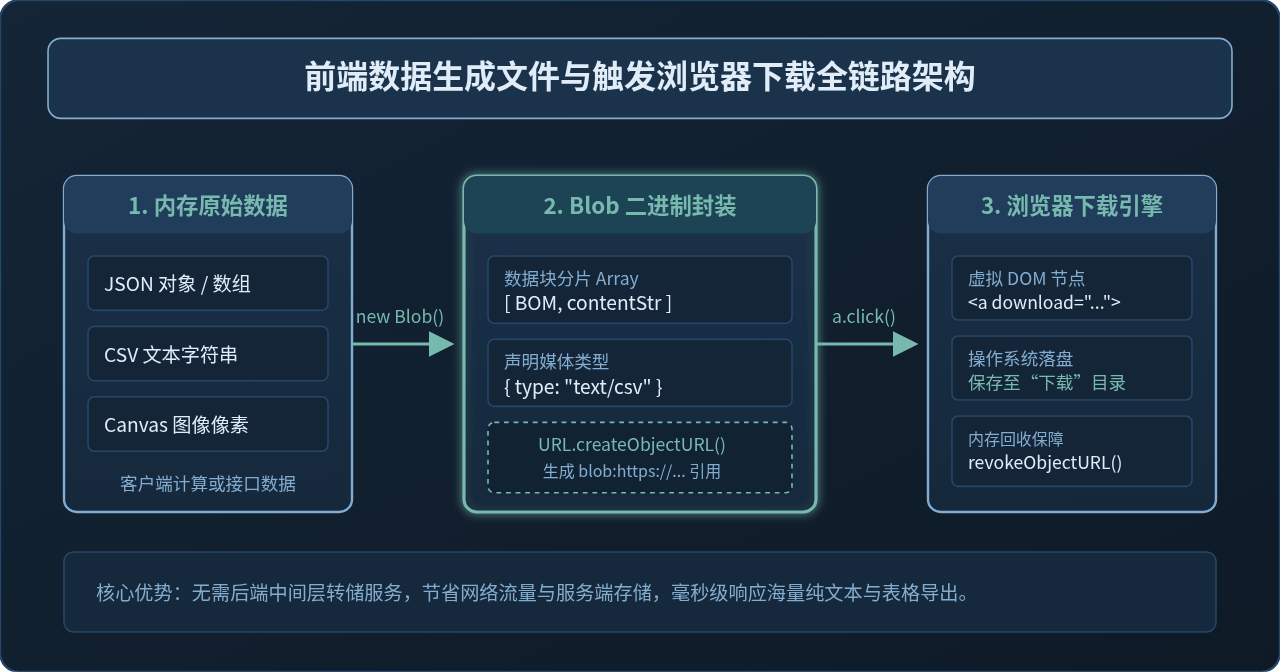
一、前端生成并下载文件的核心机制
浏览器出于安全沙箱机制,不允许网页脚本直接向操作系统的任意磁盘路径写入文件。然而,HTML5 为 <a> 标签引入的 download 属性以及 W3C 规范中的 Blob 与 URL.createObjectURL API,为前端提供了一条标准、安全的文件保存通道。
整套机制由以下三个核心构件协作完成:
- Blob(Binary Large Object)容器:充当文件内容的内存承载体。无论原始数据是 JavaScript 对象、普通文本还是图像像素数组,都可以包装进 Blob,并为其打上 MIME 类型(如
application/json、text/csv)。 - URL.createObjectURL 临时映射:由浏览器在内存中分配一个形如
blob:https://example.com/uuid的唯一内部指针。这个 URL 表现得像一个合法的资源下载链接,但数据实际上驻留在当前页面会话的内存中。 - 带有 download 属性的虚拟超链接:当
<a>标签具备download="filename.ext"属性时,浏览器会跳过跳转页面的默认动作,转而向操作系统发出“另存为”指令,将链接指向的数据保存为指定文件名。
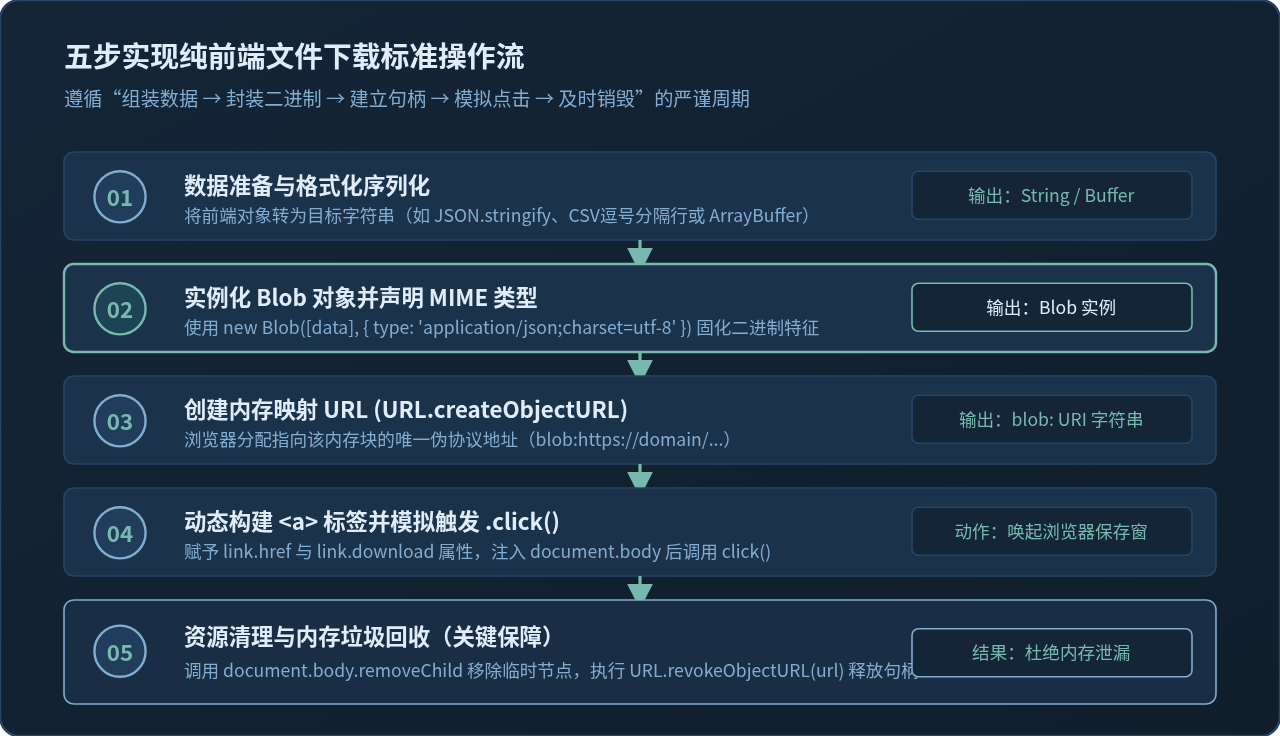
二、通用下载函数实现步骤
为了在实际项目中复用这套逻辑,我们可以封装一个通用下载函数 downloadBlobFile。它接收生成好的数据内容、预设的文件名和 MIME 类型,执行完整的组装、触发与销毁流程。
/**
 * 通用纯前端数据下载函数
 * @param {string|ArrayBuffer|Blob} content 需要导出的数据或已封装的Blob
 * @param {string} filename 下载后的默认文件名(如 report.csv)
 * @param {string} mimeType 文件的MIME类型(默认为通用二进制流)
 */
function downloadBlobFile(content, filename, mimeType = 'application/octet-stream') {
  // 1. 如果输入不是 Blob 实例,则包装为 Blob
  const blob = content instanceof Blob ? content : new Blob([content], { type: mimeType });

  // 2. 创建内存引用 URL
  const objectUrl = URL.createObjectURL(blob);

  // 3. 创建隐藏的 a 标签并配置参数
  const link = document.createElement('a');
  link.href = objectUrl;
  link.download = filename;
  link.style.display = 'none';

  // 4. 将节点挂载到 DOM 并模拟用户点击
  document.body.appendChild(link);
  link.click();

  // 5. 移除 DOM 节点并释放内存映射
  document.body.removeChild(link);
  // 使用微任务或小延迟释放引用,防止部分浏览器在异步读取未完成前链接被提前销毁
  setTimeout(() => {
    URL.revokeObjectURL(objectUrl);
  }, 100);
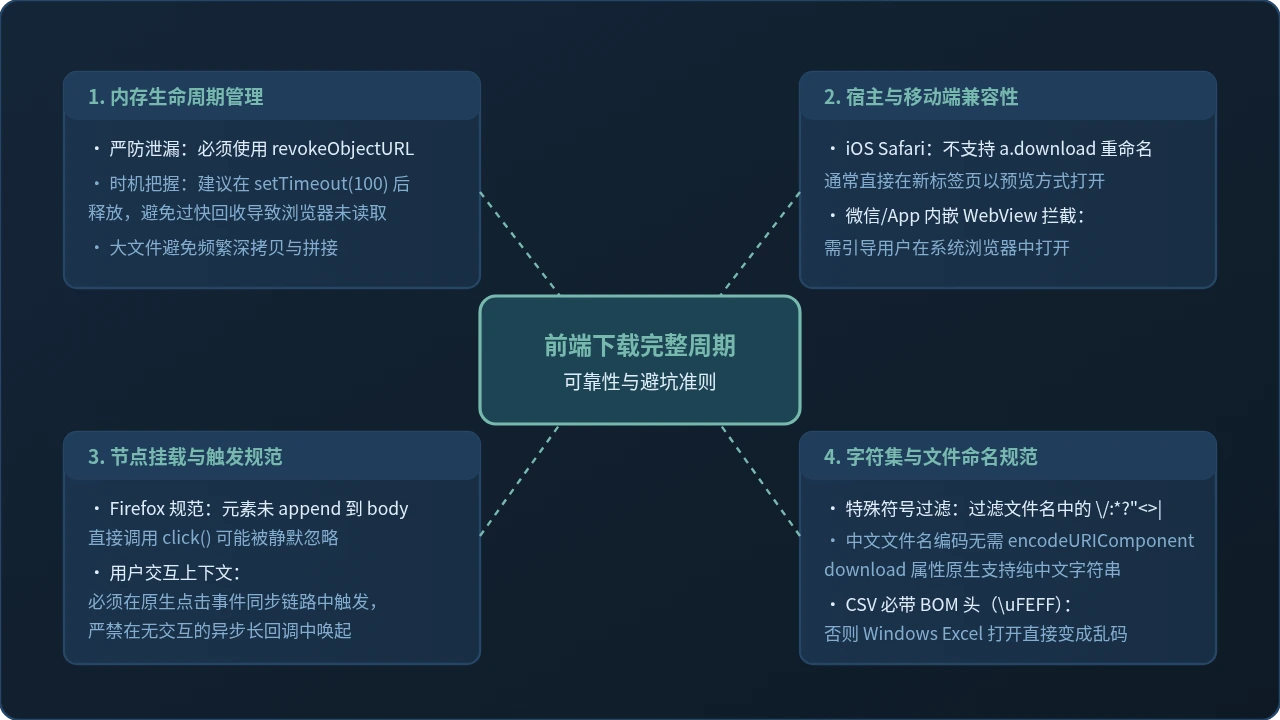
}在早期的 Chrome 中,直接调用未挂载到 DOM 树的 link.click() 能够正常工作。但是在 Firefox 以及部分遵循严格 HTML 规范的浏览器环境下,未附加到活动文档(Active Document)中的链接节点会被事件系统忽略,导致点击无响应。因此,将临时链接添加到 body、执行点击后再行移除是最健壮的跨浏览器做法。
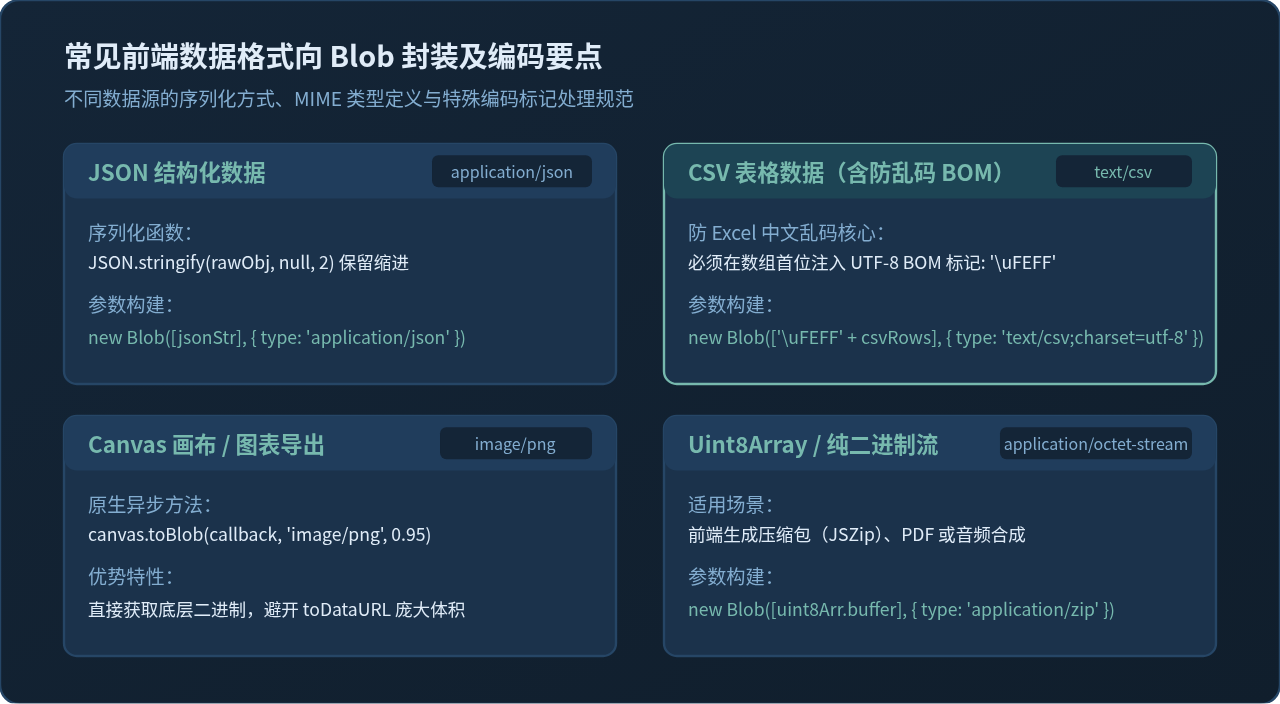
三、常见业务数据导出实战
实际开发中,需要导出的数据格式主要集中在 JSON 配置、CSV 表格数据以及 Canvas 生成的图像。不同格式在数据序列化和字符编码上有各自的注意事项。
1. 导出 JSON 数据文件
导出 JSON 数据时,直接使用 JSON.stringify 进行序列化。如果希望用户在记事本或编辑器打开时具备良好的可读性,可传入缩进参数 null, 2 进行格式化。
function exportJson(data, filename = 'data.json') {
  const jsonString = JSON.stringify(data, null, 2);
  downloadBlobFile(jsonString, filename, 'application/json;charset=utf-8');
}

// 使用示例
const userConfig = { theme: 'dark', fontSize: 14, autoSave: true };
exportJson(userConfig, 'settings.json');
2. 导出 CSV 表格与 UTF-8 BOM 乱码处理
导出表格时,CSV(逗号分隔值)是最轻量且被 Excel 和各类办公软件普遍支持的纯文本格式。将多行数据转换为以逗号分隔、换行符(
)结尾的字符串即可。
Windows 版本的 Microsoft Excel 默认使用系统本地编码(如简体中文环境下的 GBK)打开 CSV 文件,而不是标准的 UTF-8。如果在生成文件时未添加字节顺序标记(BOM,即 Unicode 字符 ),Excel 就会将中文内容解析为乱码。在文本开头拼接 即可强制 Excel 识别为 UTF-8 编码。
function exportCsv(headers, rows, filename = 'export.csv') {
  // 构建 CSV 字符串内容
  const formatCell = (val) => {
    const str = String(val == null ? '' : val);
    // 如果单元格包含逗号、双引号或换行符,需用双引号包裹,且原双引号进行转义(两个双引号)
    if (str.includes(',') || str.includes('"') || str.includes('\n')) {
      return `"${str.replace(/"/g, '""')}"`;
    }
    return str;
  };

  const headerLine = headers.map(formatCell).join(',');
  const rowLines = rows.map(row => row.map(formatCell).join(','));
  const csvContent = [headerLine, ...rowLines].join('\r\n');

  // 核心:在内容前拼接 \uFEFF (UTF-8 BOM 头)
  const bom = '\uFEFF';
  const blob = new Blob([bom + csvContent], { type: 'text/csv;charset=utf-8;' });

  downloadBlobFile(blob, filename);
}

// 使用示例
const headers = ['工号', '姓名', '部门', '入职日期'];
const rows = [
  ['1001', '张三', '技术研发部', '2024-03-01'],
  ['1002', '李四', '产品设计部', '2024-04-15'],
];
exportCsv(headers, rows, '员工列表.csv');
3. 导出 Canvas 图形或海报
当页面上有 ECharts 图表、用户涂鸦画板或前端合成的海报需要导出为图片时,可以直接调用 HTML5 Canvas 提供的 toBlob 异步接口。
function exportCanvasImage(canvasElement, filename = 'chart.png') {
  // 直接利用浏览器的原生图像编码能力输出 Blob
  canvasElement.toBlob((blob) => {
    if (blob) {
      downloadBlobFile(blob, filename, 'image/png');
    }
  }, 'image/png', 0.95);
}
四、技术方案对比与扩展选择
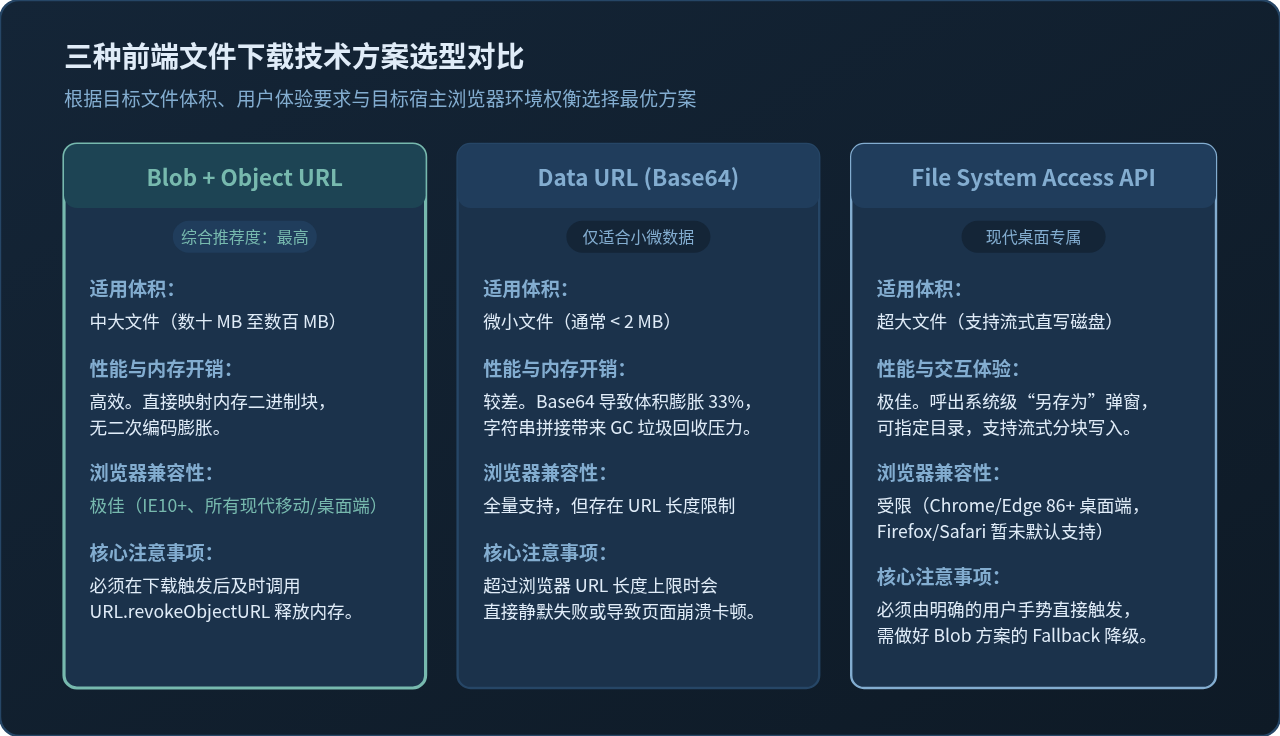
除了基于 Blob 的主流方案,前端还存在其他文件导出途径。了解不同方案的边界有助于根据业务需求做出精准选型:
| 对比维度 | Blob + Object URL(推荐) | Data URL(Base64 字符串) | File System Access API |
|---|---|---|---|
| 实现原理 | 内存二进制映射为 blob: URI |
文件内容内联编码为 data: URI |
操作系统句柄,流式直写磁盘 |
| 内存与性能 | 极高,内存零二次复制 | 较差,Base64 带来约 33% 额外体积膨胀 | 最高,支持分块写盘,内存占用极低 |
| 文件尺寸极限 | 支持数百 MB,取决于可用 RAM | 严重受限(各浏览器 URL 长度约 2MB 限制) | 支持数 GB 超大文件,无内存堆积风险 |
| 交互体验 | 直接保存到默认下载目录 | 直接保存到默认下载目录 | 弹出系统级“另存为”窗,可由用户选路径 |
| 兼容性 | 所有现代移动端与桌面端均支持 | 全量支持,但极易触发长度截断 | 仅现代 Chrome / Edge 桌面端 |
扩展:现代浏览器的 showSaveFilePicker 优雅降级
在企业级工作台或重度生产力工具中,如果需要让用户自己选择保存目录并获取更接近原生软件的“另存为”体验,可以尝试使用 Chromium 内核的 window.showSaveFilePicker,并在不支持的浏览器上自动回退到 Blob 方案:
async function modernSaveFile(content, suggestedName, mimeType) {
  // 检测现代浏览器专属的 File System Access API
  if ('showSaveFilePicker' in window) {
    try {
      const handle = await window.showSaveFilePicker({
        suggestedName,
        types: [{
          description: '目标文件',
          accept: { [mimeType]: ['.' + suggestedName.split('.').pop()] }
        }]
      });
      const writable = await handle.createWritable();
      await writable.write(content);
      await writable.close();
      return;
    } catch (err) {
      // 用户取消保存无需处理,其他异常回退到传统方式
      if (err.name === 'AbortError') return;
      console.warn('showSaveFilePicker 失败,回退到 Blob 下载', err);
    }
  }

  // 回退至通用 Blob 下载
  downloadBlobFile(content, suggestedName, mimeType);
}
五、生产环境关键注意事项与避坑指南
将前端数据下载投产时,必须关注以下几项容易导致线上静默失败或性能瓶颈的细节:
1. 内存释放必须通过 URL.revokeObjectURL 保障
调用 URL.createObjectURL(blob) 后,浏览器内部会为该 Blob 保持一个强引用计数,直到该页面会话(Document)卸载关闭。如果用户在后台频繁执行导出操作而没有主动调用 revokeObjectURL,这些堆内存将无法被垃圾回收器(GC)回收,久而久之会导致页面占用内存持续走高甚至崩溃。
2. 异步请求与用户手势(User Activation)冲突
浏览器的安全防范机制通常要求 link.click() 的触发发生在直接的用户交互链路中(如用户真实点击了按钮)。如果代码中包含过长的异步等待(例如先执行复杂的耗时运算或跨多步 await 接口后才调用 click),部分浏览器会判定该行为脱离了用户手势上下文,从而当作恶意弹窗或未经允许的后台自动下载而直接予以静默拦截。最佳实践:尽可能在点击事件前完成数据就绪,或在发起下载时给用户明确的状态指示。
3. 移动端 iOS Safari 的表现差异
在 iOS 系统的移动端 Safari 中,对 <a download> 属性的支持并不完全等同于桌面端。对于诸如 text/plain、application/json 或图像等类型,iOS Safari 往往会直接在新标签页中打开并预览该文件,而不是弹出重命名并保存的对话框。如果业务强依赖重命名落盘,对于移动端用户更适宜提供直接在线查看或复制链接的替代方案。
4. 大文件内存溢出预防
前端生成文件的本质是“将整份文件存放在浏览器的 JavaScript 堆内存中”。如果数据量高达数百兆或数千万行,new Blob() 会直接触发浏览器内存上限(Out of Memory)导致标签页崩溃。对于超大体积的数据集,纯前端导出不再合适,应当由服务端通过流式(Streaming)接口生成并在响应头设置 Content-Disposition: attachment; filename="..." 交由浏览器原生流式落盘。
六、总结
纯前端数据生成并触发下载是一项高效且实用的技术方案。只要掌握“内存数据序列化 → 包装 Blob 声明格式 → 映射 Object URL → 模拟 a 标签点击 → 及时释放 URL”这条标准路径,并根据具体文件类型处理好诸如 CSV 的 UTF-8 BOM 防乱码等细节,就能在无需服务器介入的前提下,为用户提供秒级响应的文件导出体验。
D3.js 处理大规模数据点的性能优化策略
2026-11-05 15:37:25
JS实现网页摄像头实时扫码:结合getUserMedia与jsQR教程
2026-11-05 15:27:28
D3.js v5 迁移到 v7 的 API 变更与注意事项
2026-11-05 11:57:17
使用 animate.js 实现多元素协同的序列动画
2026-11-04 22:27:53
JS拖拽排序时怎么添加平滑动画效果?FLIP技术实战
2026-11-04 10:12:22