JS数组去重怎么兼容旧浏览器?
在旧版浏览器(如IE6/7/8)中,由于缺少ES6的Set和ES5的indexOf方法,现代数组去重代码会直接报错。本文详解兼容旧浏览器的纯ES3双重循环、类型化对象哈希及Polyfill等实用去重方案与避坑指南。
Array.from(new Set(arr)) 是一行代码就能搞定的标准做法;但如果项目需要兼容 IE8 及更早的老旧浏览器(或早期的 ES3/ES5 嵌入式宿主),这行代码会因为宿主缺少 Set 原生构造器而直接报出运行时错误。本文直接聚焦旧浏览器的环境限制,介绍纯 ES3 嵌套循环法、类型化对象哈希法、indexOf Polyfill 兼容层等切实可行的方案,并深入讲解“数组塌陷”补偿与原型属性隔离等避坑细节。
一、旧浏览器到底缺少什么?
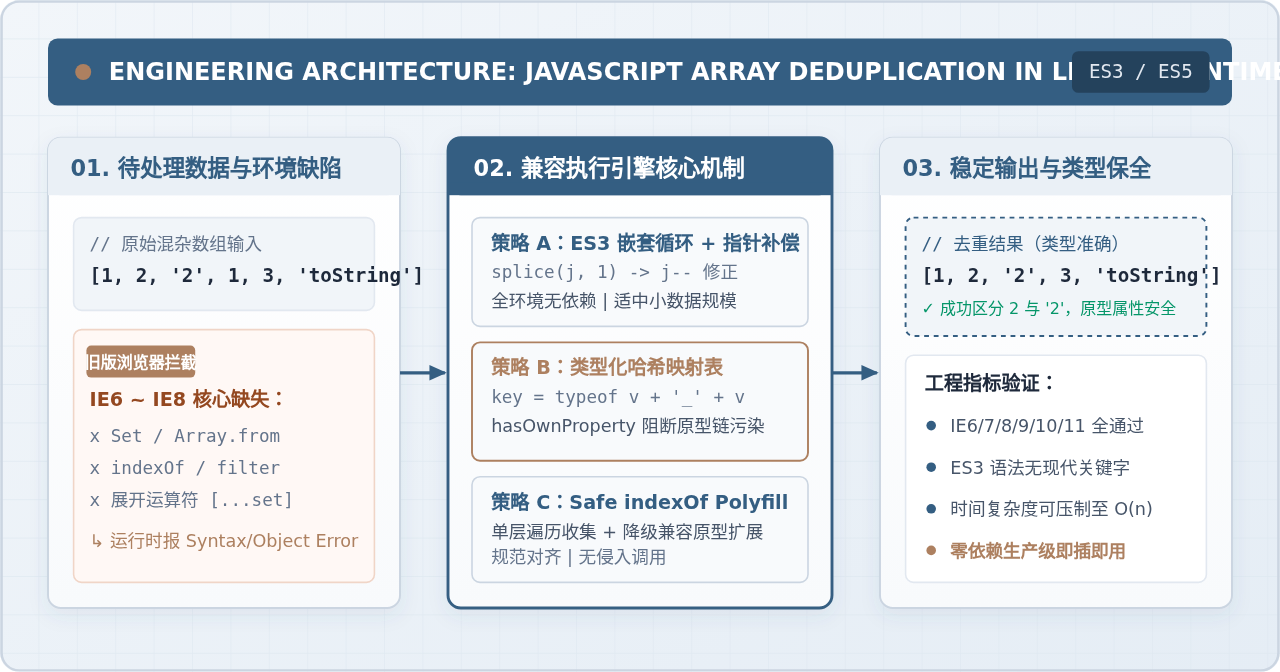
在排查兼容性问题前,我们需要明确“旧浏览器”的技术边界。在前端工程中,通常所说的旧浏览器主要是指 IE6、IE7、IE8 以及部分基于旧版 Trident/Webkit 内核的工控机内嵌浏览器。这些环境运行的 JavaScript 引擎只完整支持 ECMAScript 3(ES3) 规范。
现代开发者习惯使用的去重手段在这些环境下面临两大致命瓶颈:
-
ES6 语法与构造器全军覆没:
Set集合、解构赋值([...new Set(arr)])、箭头函数(=>)以及Array.from()均不存在。一旦在 IE8 下加载含有...的脚本,JScript 引擎会在词法解析阶段直接报“缺少标识符、字符串或数字”语法错误(SyntaxError),导致整段代码崩溃。 -
ES5 数组原生方法缺失:
Array.prototype.indexOf、Array.prototype.filter和Array.prototype.forEach直到 IE9(ES5 规范) 才被正式支持。在 IE8 及以下调用arr.indexOf()会抛出Object doesn't support property or method 'indexOf'。
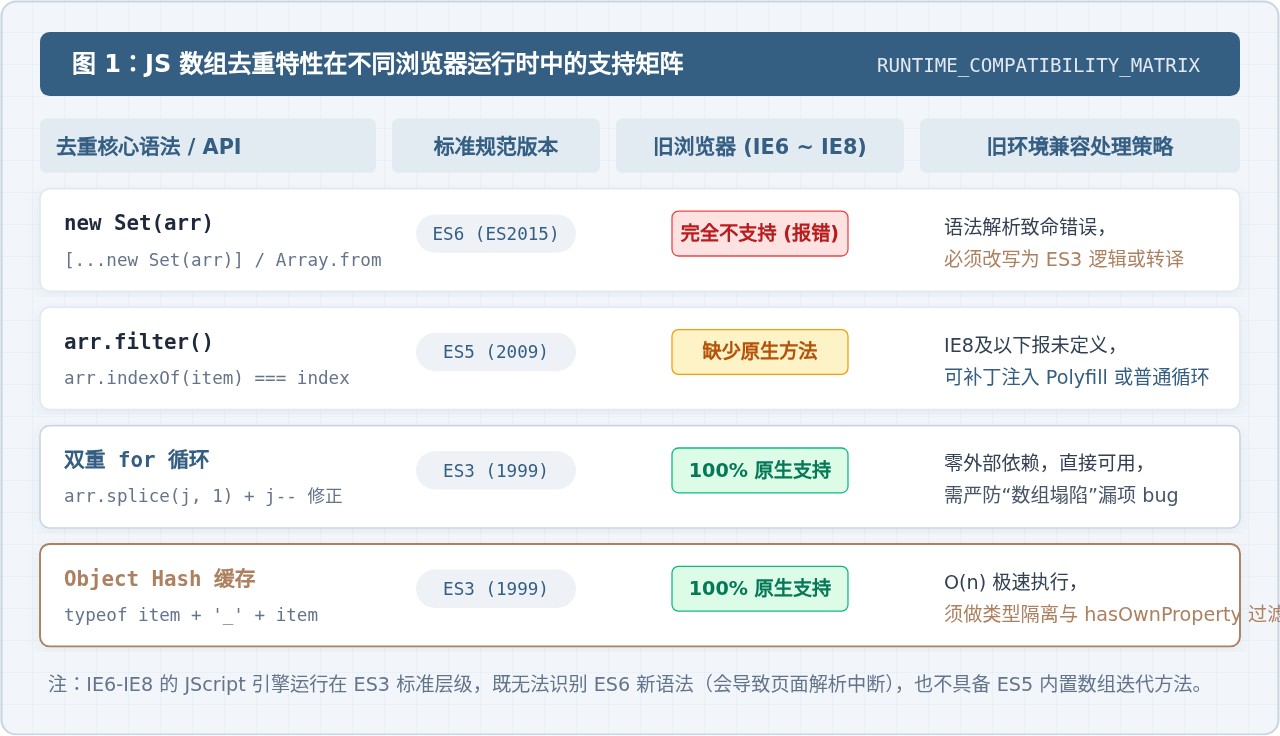
因此,要在不依赖 Babel 重度转译打包的前提下直接兼容旧浏览器,我们必须采用纯 ES3 兼容语法(使用 var 声明、普通 for 循环,且不调用 ES5+ 原生数组 API),或者显式注入合规的 Polyfill 补丁。
二、方案一:纯 ES3 双重循环法(零依赖且稳定)
双重循环是兼容性最好的方案,因为它完全依托 ES3 基础语法与 Array.prototype.splice,在从 IE5.5 开始的任何浏览器中都能完美运行。
该方案有两种实现方式:一种是就地修改原数组(In-place),另一种是返回新数组(Pure Function)。在实际业务中推荐返回新数组,避免对原数据造成意外污染。
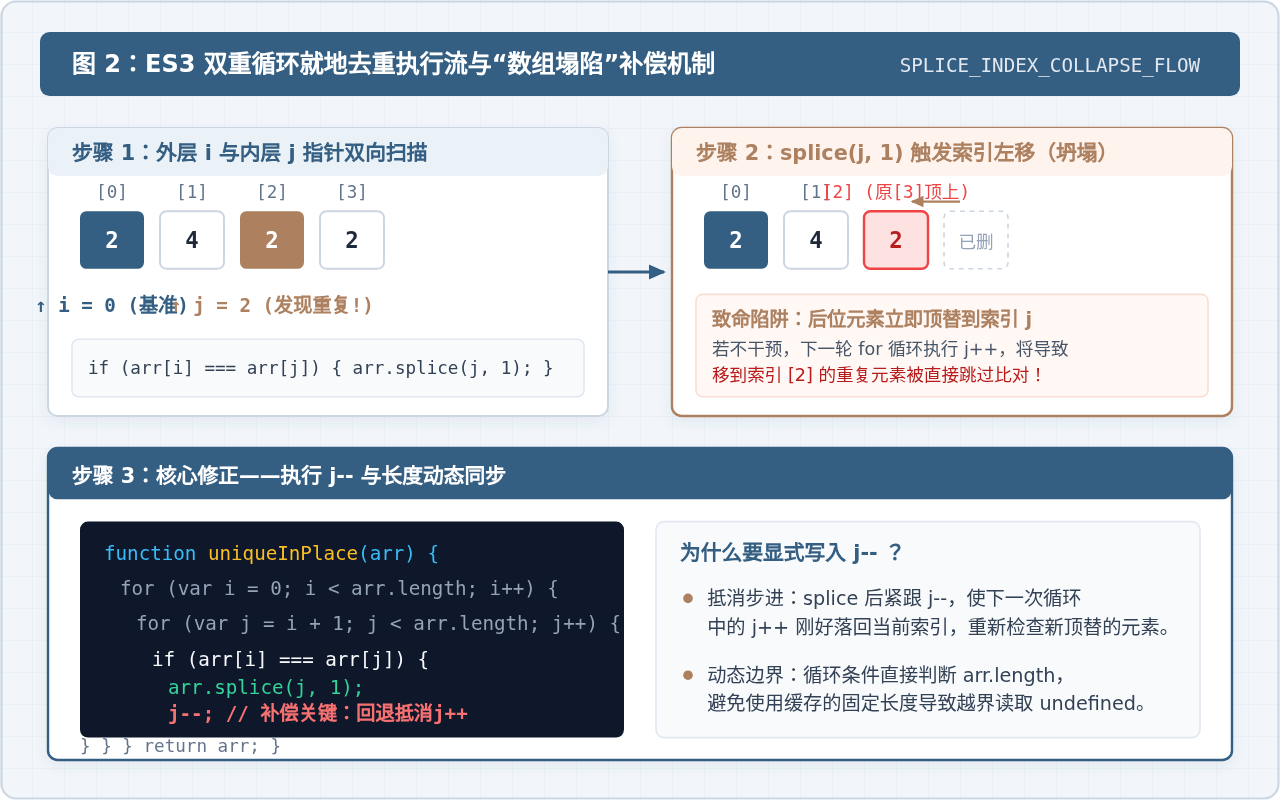
1. 就地去重与“数组塌陷”修正
许多初学者在写嵌套循环 splice 就地去重时,经常会漏掉连续重复项。原因在于 splice(j, 1) 移除元素后,后面的元素会自动向前挪一位(发生索引坍塌)。如果内层循环依然照常自增 j++,刚挪过来的新元素就会被跳过。
// 纯 ES3 规范:就地去重函数
function uniqueInPlace(arr) {
  if (!arr || arr.length <= 1) {
    return arr;
  }
  for (var i = 0; i < arr.length; i++) {
    for (var j = i + 1; j < arr.length; j++) {
      if (arr[i] === arr[j]) {
        // 移除重复项
        arr.splice(j, 1);
        // 核心修正:由于后序元素左移,必须将索引回退一位
        j--;
      }
    }
  }
  return arr;
}
2. 不改变原数组的安全写法
如果不希望修改原数组,可以通过内层查询构建全新结果数组。在外层遍历原始数组时,用一个内部循环检测结果数组中是否已存在该元素:
function uniquePureES3(arr) {
  if (!arr || arr.length <= 1) {
    return arr ? arr.slice(0) : [];
  }
  var result = [];
  for (var i = 0; i < arr.length; i++) {
    var isDuplicate = false;
    for (var k = 0; k < result.length; k++) {
      if (result[k] === arr[i]) {
        isDuplicate = true;
        break;
      }
    }
    if (!isDuplicate) {
      result.push(arr[i]);
    }
  }
  return result;
}三、方案二:类型化对象哈希法(O(n) 线性高速去重)
如果数组包含几千乃至上万条数据,双重循环的性能损耗是不可接受的。此时可以利用 JavaScript 对象的键值查找特性,构建类似于 Hash Map 的缓存表,将时间复杂度压缩至 \(O(n)\)。
然而,在旧浏览器中使用普通对象充当哈希表时,存在两个极为严重的经典陷阱:
-
弱类型键名冲突:JavaScript 对象的属性键名默认强制转为字符串。如果不做类型区分,数字
1与字符串'1'会变成同一个键"1",导致后出现的类型被错误剔除。 -
原型链属性污染:在 ES3/IE8 中,通过
var cache = {}创建的对象会隐式继承Object.prototype。如果数组中恰好含有'toString'、'valueOf'或'constructor'这类属性名,直接判断cache[key]会命中原型上的原生方法返回truthy,从而将正常数据丢弃!
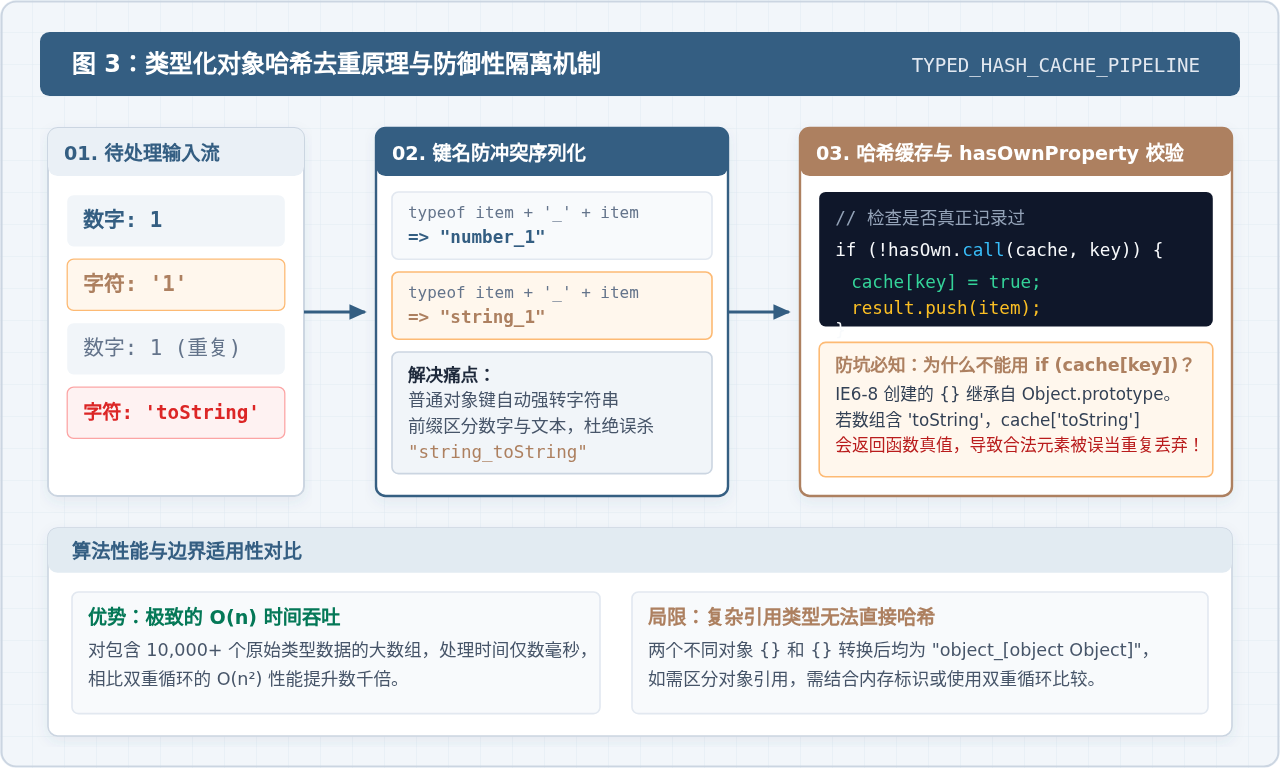
健壮的 ES3 类型化哈希实现
为了解决上述两个缺陷,我们需要使用 typeof item + '_' + item 组合键名进行类型隔离,并借助 Object.prototype.hasOwnProperty.call() 精准检测自有属性:
function uniqueByHash(arr) {
  if (!arr || arr.length <= 1) {
    return arr ? arr.slice(0) : [];
  }
  var cache = {};
  var result = [];
  var hasOwn = Object.prototype.hasOwnProperty;

  for (var i = 0; i < arr.length; i++) {
    var item = arr[i];
    // 构造带数据类型的唯一复合键名,例如: "number_1" 与 "string_1"
    var key = (typeof item) + '_' + item;

    // 安全检查,确保不被 Object.prototype 原型链内置属性误导
    if (!hasOwn.call(cache, key)) {
      cache[key] = true;
      result.push(item);
    }
  }
  return result;
}{ a: 1 },由于 typeof 均为 object,转换为字符串均为 "object_[object Object]",会导致所有对象被视作同一个。因此,包含复杂对象时仍需采用比对逻辑。
四、方案三:安全注入 indexOf Polyfill + 优雅降级
在大型项目中,通常更期望按照现代 ES5 标准编写去重代码(如使用 arr.indexOf() === -1),并通过引入微型 Polyfill 补齐老旧宿主的能力。
为 Array.prototype.indexOf 补充 Polyfill 时,务必遵循“防御性注入”原则,即先判定宿主是否已实现,避免覆盖现代浏览器的原生优化实现:
// 1. 防御性注入 indexOf 兼容补丁(支持 IE6 ~ IE8)
if (!Array.prototype.indexOf) {
  Array.prototype.indexOf = function(searchElement, fromIndex) {
    if (this === null || this === undefined) {
      throw new TypeError('"this" is null or not defined');
    }
    var obj = Object(this);
    var len = obj.length >>> 0; // 转为 32 位无符号整数
    if (len === 0) {
      return -1;
    }
    var n = fromIndex | 0; // 取整
    if (n >= len) {
      return -1;
    }
    var k = Math.max(n >= 0 ? n : len - Math.abs(n), 0);
    while (k < len) {
      if (k in obj && obj[k] === searchElement) {
        return k;
      }
      k++;
    }
    return -1;
  };
}

// 2. 利用 indexOf 编写简洁通用的去重函数
function uniqueWithIndexOf(arr) {
  var result = [];
  for (var i = 0; i < arr.length; i++) {
    if (result.indexOf(arr[i]) === -1) {
      result.push(arr[i]);
    }
  }
  return result;
}
五、特殊边界值处理(NaN 与引用类型)
无论在现代浏览器还是旧浏览器中,JavaScript 的 NaN 都有一个反直觉的特性:NaN === NaN 返回 false。
这意味着无论使用 indexOf 还是 === 严格相等判断,都无法正确去重多个 NaN(每个 NaN 都会被当成全新元素)。旧浏览器由于没有 Number.isNaN,我们可以通过利用 item !== item 这一唯一自不等特性来识别 NaN:
| 测试数据场景 | 双重循环 (===) | 基础对象哈希 (cache[item]) | 类型化哈希 (typeof item + '_' + item) | indexOf Polyfill |
|---|---|---|---|---|
[1, '1'] |
保留两者 (正确) | 误删一个 (错误) | 保留两者 (正确) | 保留两者 (正确) |
['toString'] |
正确保留 | 误当重复丢弃 (致命) | 正确保留 (hasOwn防护) | 正确保留 |
[NaN, NaN] |
重复保留 (无法去重) | 仅留一个 (正确) | 仅留一个 (正确) | 重复保留 (无法去重) |
[{}, {}] (不同对象引用) |
正确保留两者 | 误杀为一个 (错误) | 误杀为一个 (错误) | 正确保留两者 |
六、工程实践:全兼容生产级去重函数
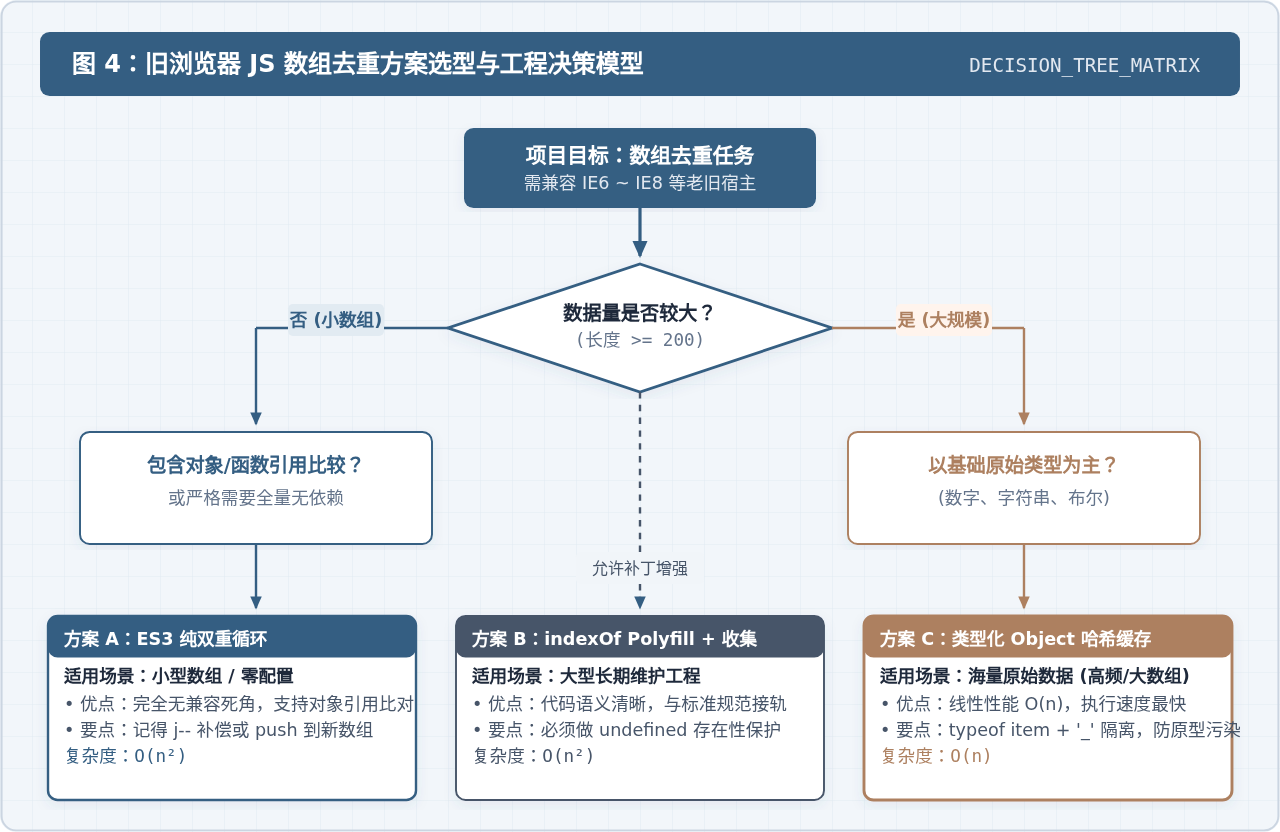
综合以上分析,在实际工程中,最理想的做法是封装一个自适应的兼容函数:针对原始类型优先使用高效的哈希缓存,针对特殊值(如 NaN)和引用类型保留正确语义。
/**
 * 生产级全兼容数组去重函数
 * 兼容环境:IE6+、Chrome、Firefox、Safari、Node.js
 */
function uniqueArray(arr) {
  if (!arr || !(arr instanceof Array || Object.prototype.toString.call(arr) === '[object Array]')) {
    return [];
  }
  if (arr.length <= 1) {
    return arr.slice(0);
  }

  var result = [];
  var hasOwn = Object.prototype.hasOwnProperty;
  var primitiveCache = {};
  var hasNaN = false;
  var objectList = [];

  for (var i = 0; i < arr.length; i++) {
    var item = arr[i];
    var type = typeof item;

    // 1. 单独处理 NaN (ES3 中只有 NaN 不等于自身)
    if (item !== item) {
      if (!hasNaN) {
        hasNaN = true;
        result.push(item);
      }
      continue;
    }

    // 2. 原始类型(数字、字符串、布尔值、undefined、null)使用高速类型哈希
    if (item === null || (type !== 'object' && type !== 'function')) {
      var key = type + '_' + item;
      if (!hasOwn.call(primitiveCache, key)) {
        primitiveCache[key] = true;
        result.push(item);
      }
      continue;
    }

    // 3. 引用类型(对象、数组、函数)采用引用比对,避免 JSON 转换或误杀
    var isObjectSeen = false;
    for (var k = 0; k < objectList.length; k++) {
      if (objectList[k] === item) {
        isObjectSeen = true;
        break;
      }
    }
    if (!isObjectSeen) {
      objectList.push(item);
      result.push(item);
    }
  }

  return result;
}
七、选型与避坑总结
在需要兼容旧版浏览器的项目中实现数组去重,牢记以下三条工程准则:
-
杜绝 ES6 语法直接打包至旧环境:哪怕仅写了一处
[...set]或箭头函数,旧版 IE 都会全盘中断执行。必须配置构建脚本编译为 ES3 语法,或者直接编写原生 ES3 函数。 -
数据量小选用双重循环,数据量大选用类型化哈希:当数组长度小于 200 时,纯 ES3 嵌套循环实现最为轻巧稳定;当数据量达到千级以上且为原始值时,务必使用带有
typeof前缀隔离和hasOwnProperty校验的哈希缓存。 -
重视边界值:严防
splice引起的索引坍塌、对象键名的自动转字符串机制以及NaN !== NaN特性,确保去重后的数组保持严谨的数据契约。
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
p5.js 中 setup() 和 draw() 函数的执行机制详解
2026-11-05 12:32:38