

怎么用JS数组push和pop实现栈数据结构
本文详细讲解如何在 JavaScript 中利用数组的 push 和 pop 方法实现栈(Stack)数据结构。分析后进先出(LIFO)原理、为什么选择末端操作而非首端 shift/unshift、面向对象封装方式以及实际开发中的边界与性能考量。
push 和 pop 方法。因为栈是一种严格遵循“后进先出”(LIFO)特性的线性数据结构,而数组末端天然具备常数级时间复杂度的追加与弹出能力,将数组末尾视为“栈顶”,就能在几行代码内构建一个性能优良的栈。
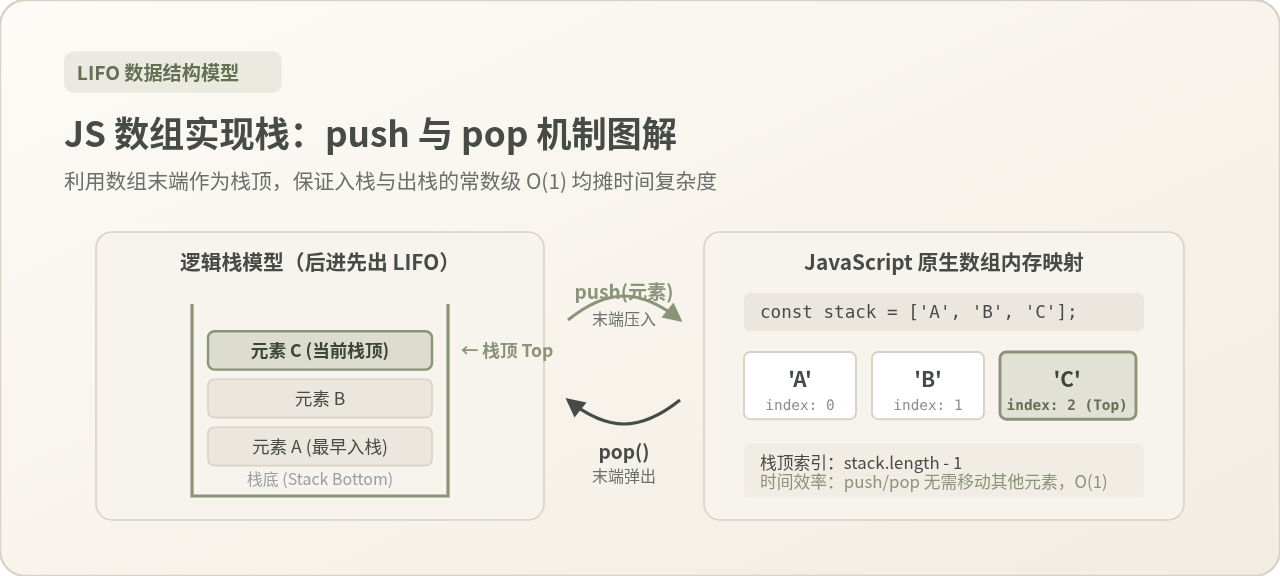
一、栈的核心规则与 JS 数组的天然契合点
栈(Stack)要求所有插入与删除操作都只能在同一端进行,这一端被称为栈顶(Top),相对的另一端则称为栈底(Bottom)。最晚压入栈的元素最先被弹出,即“后进先出”(Last In, First Out,简称 LIFO)。
在许多传统静态语言(如 C 或 Java)中,构建栈通常需要预分配一段固定长度的内存空间并维护一个移动的栈顶指针,或者构建单向链表。而在 JavaScript 中,数组是动态大小的对象,并且原生内置了在数组尾部操作的方法:
Array.prototype.push(element):向数组尾部追加一个或多个元素,并返回更新后的数组长度。这完全对应栈的入栈(Push)操作。Array.prototype.pop():移除并返回数组尾部的最后一个元素;若数组为空则返回undefined。这完全对应栈的出栈(Pop)操作。- 数组末尾元素
arr[arr.length - 1](或 ES2022 的arr.at(-1)):直接读取但不删除最后存入的数据,完全对应栈的查看栈顶(Peek)操作。
二、关键原理解析:为什么选 push/pop 而非 unshift/shift?
初次接触栈的开发者有时会产生一个直觉疑问:“如果我把数组第 0 位(开头)当作栈顶,用 unshift 存、用 shift 取,逻辑上不也是后进先出吗?”
逻辑确实成立,但在工程实现中严禁这么做。根本原因在于底层引擎(如 V8)对数组的存储方式与算法时间复杂度:
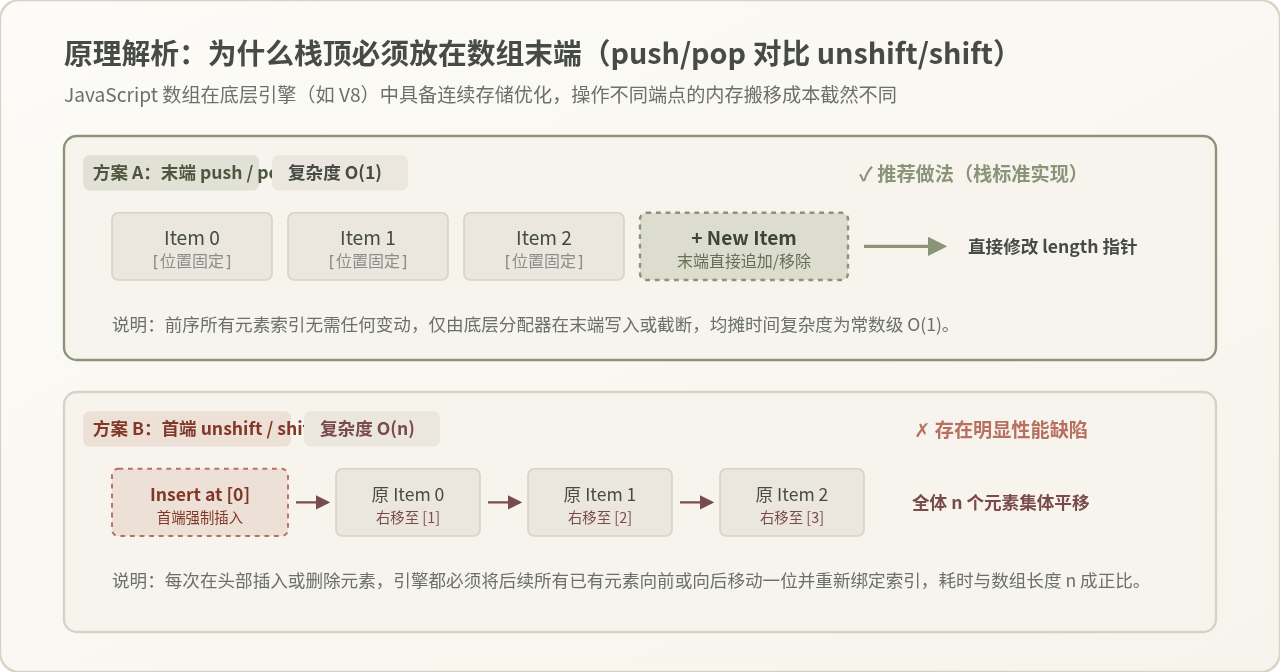
从底层机制来看,二者的差异主要体现在以下两个维度:
- 时间复杂度差异:
push和pop仅在数组末尾写入或截断一个元素,前序所有元素的内存地址与索引均无需改动,其均摊时间复杂度为O(1)。相反,unshift在索引0插入元素或shift删除索引0元素时,引擎必须将现存的全部n个元素逐一向右或向左位移一位并重排索引,时间复杂度为O(n)。 - 数据量扩大时的性能分水岭: 当栈内只有几个或几十个元素时,二者的耗时差异在毫秒级内微乎其微;一旦元素量达到上万级别,首端操作会因频繁内存搬移引发严重的性能损耗与垃圾回收压力。
三、基础实现:使用原生数组快速模拟栈
在日常算法刷题、短平快的脚本开发中,我们不需要任何多余的类包装,直接声明一个空数组即可作为栈来使用:
// 1. 初始化空栈
const stack = [];

// 2. 入栈(Push)
stack.push("Task 1");
stack.push("Task 2");
stack.push("Task 3");
console.log("当前栈内容:", stack);

// 3. 读取栈顶(Peek,不移除)
const topElement = stack.at(-1); // 推荐写法,等同于 stack[stack.length - 1]
console.log("当前栈顶元素:", topElement);

// 4. 出栈(Pop)
const popped = stack.pop();
console.log("弹出元素:", popped);
console.log("弹出后栈内容:", stack);

// 5. 判断栈是否为空及获取大小
const isEmpty = stack.length === 0;
const currentSize = stack.length;
console.log("栈是否为空:", isEmpty, "当前大小:", currentSize);当前栈顶元素: Task 3
弹出元素: Task 3
弹出后栈内容: [ 'Task 1', 'Task 2' ]
栈是否为空: false 当前大小: 2
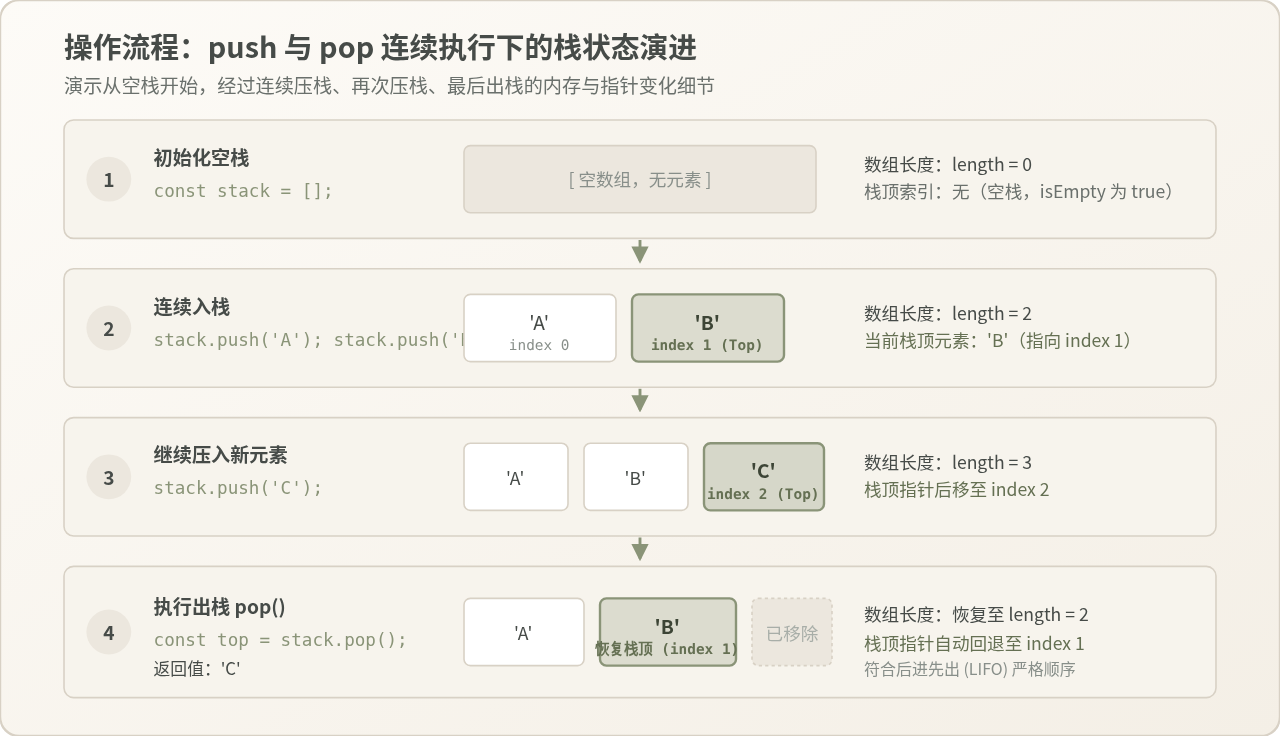
四、进阶封装:用 ES2022 私有属性构建安全的 Stack 类
直接使用裸数组虽然编写迅速,但在团队协作或复杂业务模块中存在显著的设计隐患:裸数组的方法没有受到任何约束,任何外部代码都可以随意调用 stack.splice() 删除中间节点,或者通过 stack[0] = 'hack' 篡改栈底,甚至直接使用 shift(),这会彻底破坏栈的 LIFO 保证。
为了保护栈的数据完整性,建议使用 ES2022 原生私有字段语法(# 前缀)将底层数组隐藏起来,只对外暴露标准栈 API:
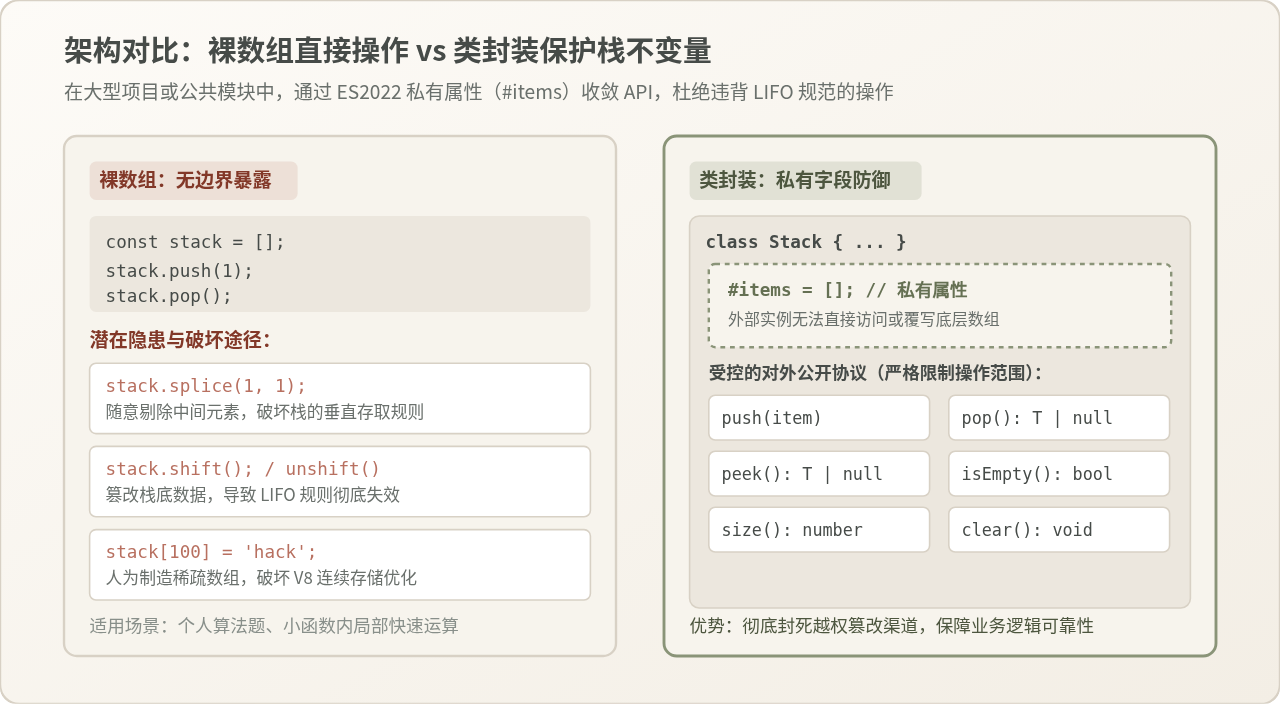
下面是一个经过类型防护与边界检查的完整 Stack 类实现:
/**
 * 基于 JS 数组与私有属性封装的通用栈结构
 */
class Stack {
  // ES2022 私有属性:外部无法直接通过 instance.#items 访问底层数组
  #items = [];

  /**
   * 将元素压入栈顶
   * @param {*} element 需要入栈的数据
   */
  push(element) {
    this.#items.push(element);
  }

  /**
   * 弹出并返回栈顶元素
   * @returns {*} 栈顶元素;若栈为空则返回 null
   */
  pop() {
    if (this.isEmpty()) {
      return null; // 明确空栈返回值,避免与合法存储的 undefined 混淆
    }
    return this.#items.pop();
  }

  /**
   * 查看当前栈顶元素(不出栈)
   * @returns {*} 栈顶元素;若栈为空则返回 null
   */
  peek() {
    if (this.isEmpty()) {
      return null;
    }
    return this.#items.at(-1);
  }

  /**
   * 判断栈是否为空
   * @returns {boolean}
   */
  isEmpty() {
    return this.#items.length === 0;
  }

  /**
   * 获取栈中当前元素总数
   * @returns {number}
   */
  size() {
    return this.#items.length;
  }

  /**
   * 清空栈内所有元素
   */
  clear() {
    this.#items.length = 0; // 直接归零 length,高效清空内部存储
  }

  /**
   * 便于调试输出当前栈内容(自底向顶)
   * @returns {string}
   */
  toString() {
    return this.#items.join(" -> ");
  }
}
我们可以通过以下调用代码验证该类的封装效果与边界行为:
const s = new Stack();
console.log("初始是否为空:", s.isEmpty()); // true
console.log("空栈执行 pop:", s.pop());       // null

s.push(100);
s.push(200);
s.push(300);

console.log("当前栈顶:", s.peek());          // 300
console.log("栈大小:", s.size());           // 3
console.log("出栈操作:", s.pop());           // 300
console.log("出栈后栈顶:", s.peek());        // 200

// 尝试外部直接访问私有字段会触发语法错误:
// console.log(s.#items); // SyntaxError: Private field '#items' must be declared in an enclosing class空栈执行 pop: null
当前栈顶: 300
栈大小: 3
出栈操作: 300
出栈后栈顶: 200
五、容易混淆的细节与注意事项
1. 空栈 pop 时的 undefined 歧义陷阱
原生数组在空状态下调用 arr.pop() 不会抛出异常,而是静默返回 undefined。
undefined(例如 stack.push(undefined)),那么当你执行 const val = stack.pop() 时,返回的 undefined 究竟代表“弹出了原本存进去的 undefined”还是“栈已经空了”?解决方案:在执行关键业务前,始终先调用
isEmpty() 进行显式判定,或者在封装类中让空栈统一返回 null 或特定 Symbol。
2. 查看栈顶时的无损访问
有些初学者在需要查看栈顶时,会写出 const temp = stack.pop(); stack.push(temp); 这样的代码。这不仅平白无故执行了两次写操作,在并发异步或者状态监听场景下还会触发多余的副作用。直接读取 stack.at(-1) 或者 stack[stack.length - 1] 即可进行纯粹的无损读取。
3. 避免破坏 V8 内部的连续内存优化
在现代 JavaScript 引擎中,数组默认采用连续密集存储(PACKED 元素模式)。如果使用 stack[1000] = 'value' 这类跳跃索引赋值,数组会被降级为类似字典的慢速哈希存储(DICTIONARY 模式)。只要坚持只使用 push 和 pop 进行增删,数组就能始终保持最快的密集存储与操作效率。
六、典型应用实战:利用栈解决括号匹配校验
为了验证实现的可用性,我们来看一个经典的计算机应用场景:检查一段字符串中的括号(()、[]、{})是否闭合且嵌套合法。通过栈的 LIFO 特性,遇到左括号就入栈,遇到右括号就出栈核对:
function isValidBracketSequence(str) {
  const stack = [];
  const map = {
    ')': '(',
    ']': '[',
    '}': '{'
  };

  for (const char of str) {
    if (char === '(' || char === '[' || char === '{') {
      stack.push(char); // 左括号压栈
    } else if (char === ')' || char === ']' || char === '}') {
      // 遇到右括号,弹出最近压入的左括号进行匹配
      if (stack.length === 0 || stack.pop() !== map[char]) {
        return false;
      }
    }
  }

  // 全部扫描完毕后,栈内为空则代表完全匹配
  return stack.length === 0;
}

// 验证用例
console.log(isValidBracketSequence("([{()}])")); // true
console.log(isValidBracketSequence("([)]"));     // false
console.log(isValidBracketSequence("(()")); // falsefalse
false
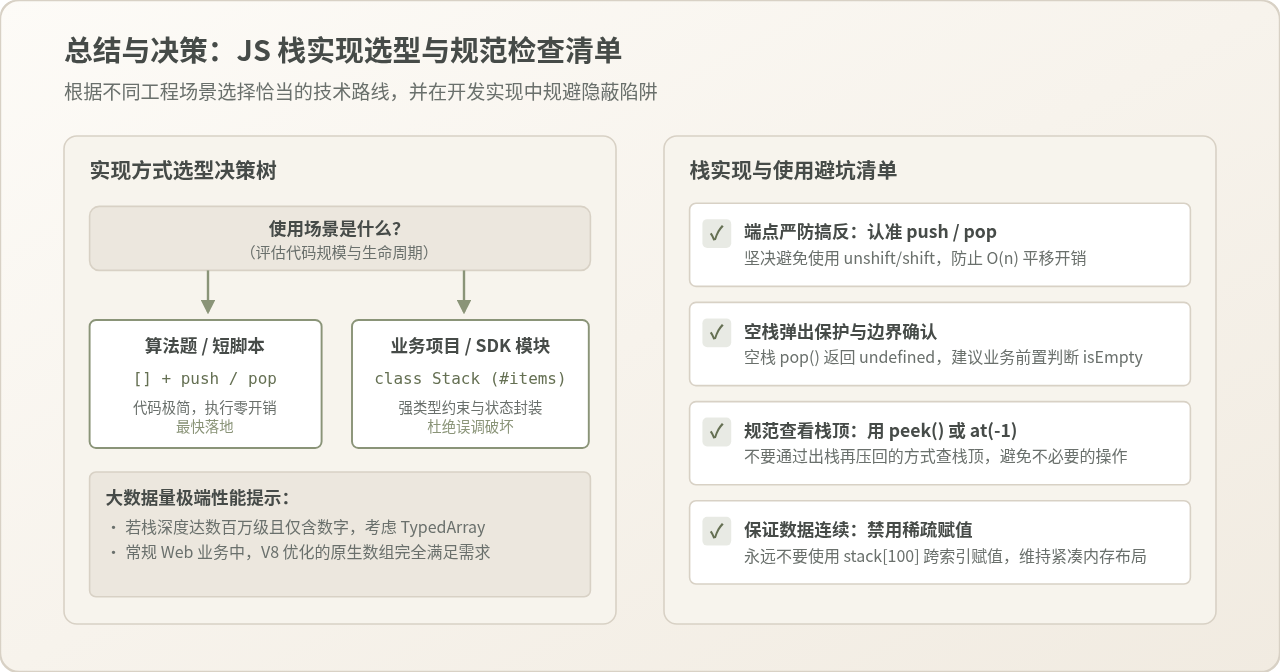
七、总结与选型指南
| 实现模式 | 实现机制 | 优点 | 适用场景 |
|---|---|---|---|
| 原生数组直接操作 | const stack = []push() / pop() |
零样板代码、无内存额外开销、编写速度最快 | 算法题、短小函数局部逻辑、性能敏感的高频轻量计算 |
| 面向对象类封装 | class Stack私有属性 #items |
API 边界收敛、防止外部越权篡改、类型友好 | 中大型业务系统、开源工具库、状态管理器、撤销重做模块 |
| 定长类型化数组 | Int32Array + 自增指针 |
避免 V8 动态扩容重分配、极致内存占用 | 音频图像处理、WebAssembly 互操作、百万级密集纯数值计算 |
归纳而言,在 JavaScript 中用数组实现栈的关键在于:锁定数组末端作为栈顶,统一使用 push 和 pop 保证 O(1) 的均摊复杂度;在工程项目中通过类与私有属性收敛操作入口,配合 isEmpty 防范空栈边缘情况。 只要遵循这一规范,就能写出兼顾高性能与健壮性的栈结构。
JS动态构建复杂嵌套JSON对象的方法
2026-11-05 15:41:52
JS负数取余为什么是负数?详解余数与模运算区别
2026-11-05 13:34:41
JS 解压出现乱码或报错怎么解决?
2026-11-05 12:32:38
JS 中 startsWith、indexOf 与正则判断字符串前缀的对比
2026-11-04 22:19:43
JS解析Excel后怎么将数据转换为JSON格式
2026-11-04 20:58:28







