

js导出PDF中文乱码怎么办?嵌入自定义字体解决方案
针对前端使用JavaScript导出PDF时出现的中文乱码、问号或空白问题,详细解析PDF标准字体限制与字符映射根源,提供完整的TTF字体转Base64、虚拟文件系统挂载、字体注册及体积子集化优化解决方案。
addFont() 注册并在绘制前调用 setFont() 激活该字体。
一、为什么前端导出 PDF 会出现中文乱码?
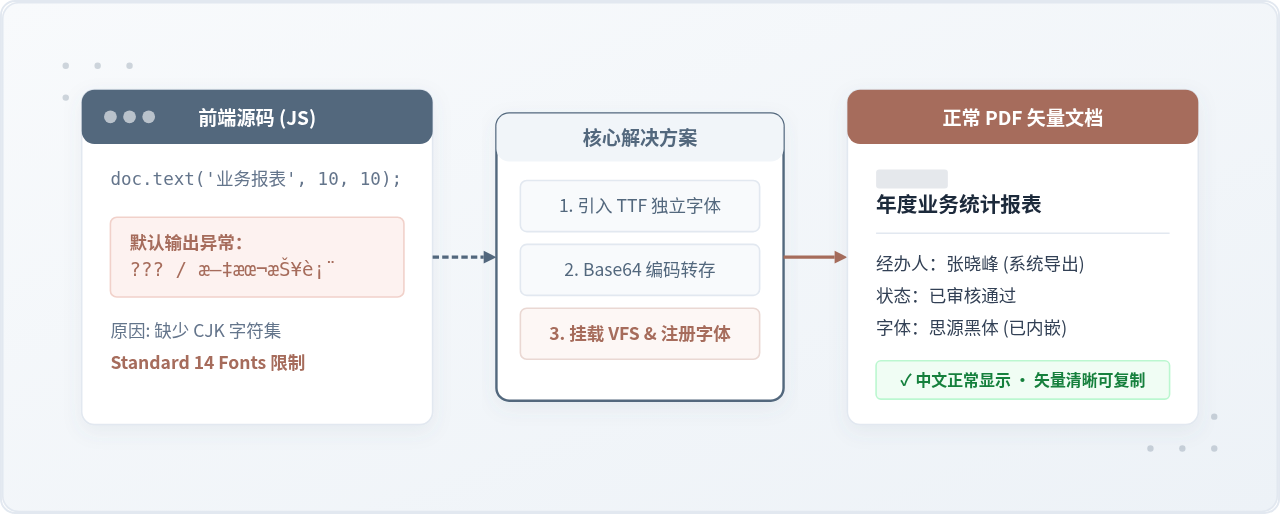
很多开发者在项目中初次引入 jspdf 库,调用 doc.text('你好,世界', 10, 10) 保存文件后,打开 PDF 往往会看到一连串问号 ????、方块空白符,或者是完全无法辨认的乱码。这种现象并非网络传输错误,也不是简单的字符编码声明遗漏,而是由于 PDF 底层的字体渲染与字符映射机制决定的。
PDF 文件规范定义了一组称为 Standard 14 Fonts(标准 14 种核心字体) 的基础字体,包括 Helvetica、Times-Roman、Courier 及其粗斜体变体。为了控制生成体积,主流 JavaScript 导出库在未指定外部字体时,均默认引用这些标准字体:
- 标准字体的编码限制:标准 14 字体仅内置了 WinAnsiEncoding(基于 ISO 8859-1 / Windows-1252)所涵盖的拉丁字符集。它根本不包含 CJK(中日韩)文字所需的字形轮廓(Glyph Outlines)和编码映射(CMAP)。
- 映射丢失导致的乱码表现:当 JavaScript 传入中文字符时,渲染引擎尝试在当前字体表的有限编码范围中定位字形。对于超出范围的 Unicode 编码,引擎要么直接丢弃并替换为未定义标记(如问号
?),要么错误地按单字节高位拆分,从而生成完全错误的乱码。 - 画布截图与矢量文字的差异:通过
html2canvas截图后再插入 PDF 虽然能规避字体问题,但生成的本质是一张位图图片,文字无法被选择、复制或检索,且打印放大时会出现明显模糊。要生成真正高质量的矢量 PDF,必须直接在文档流中嵌入中文字体。
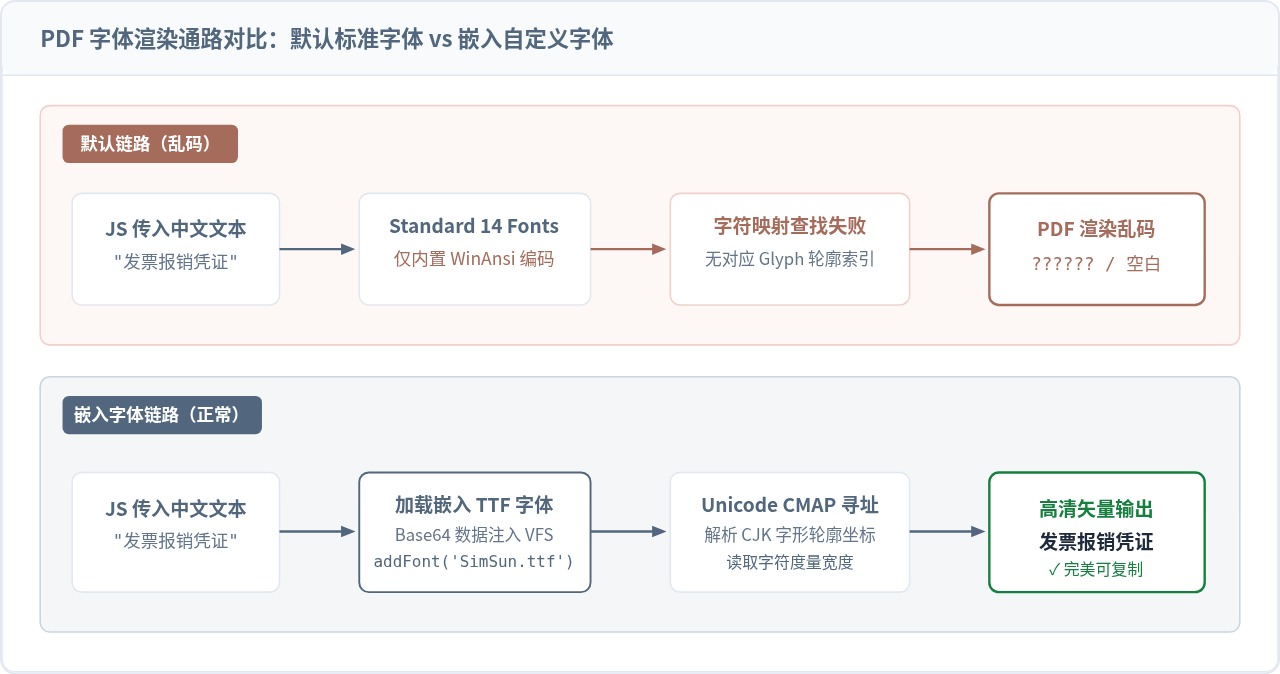
二、嵌入自定义字体的四个核心步骤
解决乱码的根本方法是让 PDF 携带自定义字体的轮廓数据与字符映射表。以当前前端生态最广泛使用的 jspdf 为例,完整操作可以清晰地划分为四个阶段:
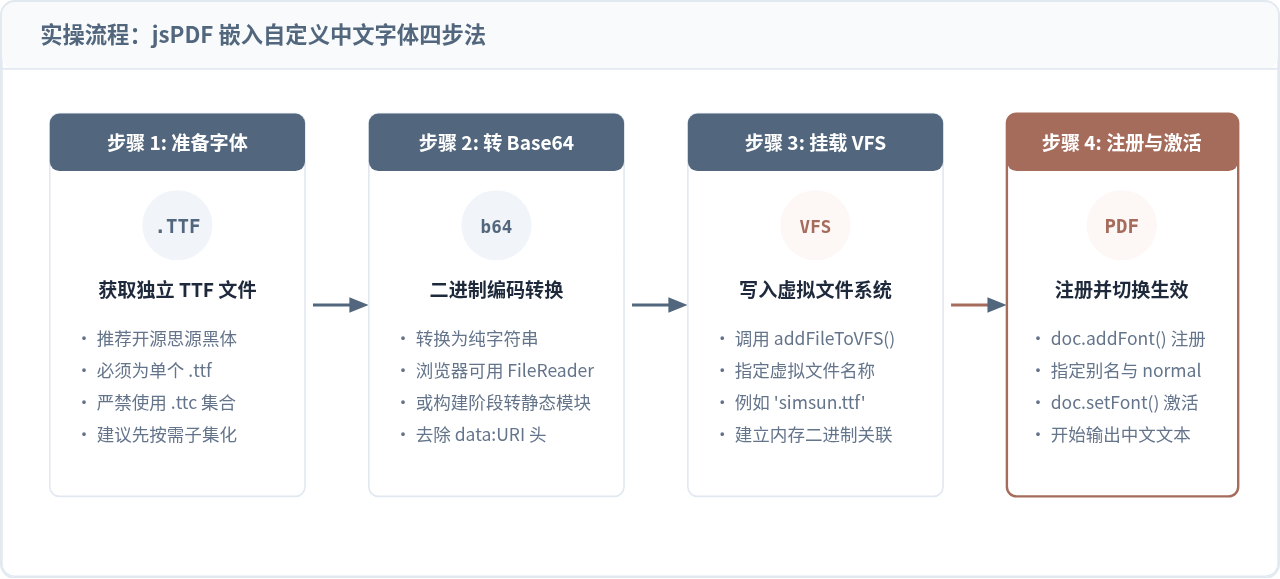
1. 准备字体文件(严格限定 TTF 格式)
由于 jsPDF 的内置字体解析器只完整支持单一 TrueType Font(.ttf)格式,不能直接传入复合字体包 .ttc(TrueType Collection)或网页专用压缩字体 .woff / .woff2。推荐优先使用开源免费商用字体,例如:
- 思源黑体(Source Han Sans CN / Noto Sans SC):现代感强,屏幕与打印清晰度极高。
- 中易宋体 / 仿宋(SimSun / FangSong):适合传统合同、正式公文等严谨报表场景。
2. 将字体转换为 Base64 编码
PDF 库运行在浏览器内存中,无法直接读取客户端本地硬盘路径。我们需要将 .ttf 二进制内容编码为纯文本字符串(Base64)。你可以通过现代前端构建工具打包,或者在运行时通过异步 fetch 请求获取字体后进行动态转换。
3. 挂载至虚拟文件系统(VFS)
jsPDF 内部维护了一个名为 Virtual File System (VFS) 的键值对象。调用 doc.addFileToVFS(filename, base64Content),将 Base64 数据与一个虚拟文件名(例如 custom-font.ttf)绑定,使其作为虚拟文件驻留在内存中。
4. 注册并设置当前字体
挂载完成后,需要告知 PDF 实例将该虚拟文件映射为一个可在页面中调用的字体族名称,最后调用 setFont() 切换:
// 注册字体:参数依次为 (虚拟文件名, 字体别名, 样式)
doc.addFont('custom-font.ttf', 'MyCustomFont', 'normal');

// 激活当前字体
doc.setFont('MyCustomFont');

// 输出中文
doc.text('中文测试文本正常渲染', 20, 20);
三、前端工程化完整实现代码
在生产环境中,中文字体动辄 10MB 以上。如果直接将几万个汉字的 Base64 字符串硬编码打包到 bundle.js 中,会导致首屏体积爆炸。推荐的做法是:将字体文件放置在静态资源服务器(CDN),用户点击“导出 PDF”按钮时按需动态加载。以下是完整的可运行示例代码:
import { jsPDF } from 'jspdf';

/**
 * 辅助函数:将远程 ArrayBuffer 转换为 Base64 字符串
 */
function arrayBufferToBase64(buffer) {
  let binary = '';
  const bytes = new Uint8Array(buffer);
  const len = bytes.byteLength;
  for (let i = 0; i < len; i++) {
    binary += String.fromCharCode(bytes[i]);
  }
  return window.btoa(binary);
}

/**
 * 核心导出函数
 */
async function exportChinesePdf() {
  try {
    // 1. 初始化 jsPDF 实例 (纵向 A4 纸,单位毫米)
    const doc = new jsPDF({
      orientation: 'portrait',
      unit: 'mm',
      format: 'a4'
    });

    // 2. 动态异步获取静态服务器上的 TTF 字体文件
    console.log('正在加载中文字体...');
    const fontResponse = await fetch('/fonts/SourceHanSansCN-Normal-subset.ttf');
    if (!fontResponse.ok) {
      throw new Error(`字体下载失败,状态码: ${fontResponse.status}`);
    }
    const fontBuffer = await fontResponse.arrayBuffer();
    const fontBase64 = arrayBufferToBase64(fontBuffer);

    // 3. 挂载到 jsPDF 虚拟文件系统
    const virtualFontName = 'SourceHanSansCN-Normal.ttf';
    doc.addFileToVFS(virtualFontName, fontBase64);

    // 4. 注册字体 (参数: 虚拟文件名, 字体别名, 样式类型)
    doc.addFont(virtualFontName, 'SourceHanSans', 'normal');

    // 5. 设置当前字体为已注册的字体别名
    doc.setFont('SourceHanSans', 'normal');

    // 6. 执行中文绘制
    doc.setFontSize(18);
    doc.text('业务数据结算统计报表', 20, 25);

    doc.setFontSize(12);
    doc.text('生成时间:2026年11月01日', 20, 35);
    doc.text('经办部门:技术运营中心', 20, 42);
    doc.text('验证说明:本文件为完全自主嵌入矢量的 PDF 文本,支持选中文本复制。', 20, 50);

    // 7. 保存并下载文件
    doc.save('结算报表-中文正常.pdf');
    console.log('PDF 导出完成!');
  } catch (error) {
    console.error('PDF 导出异常:', error);
  }
}

// 绑定按钮事件即可触发调用
// document.getElementById('exportBtn').addEventListener('click', exportChinesePdf);
四、体积优化:字形子集化(Subsetting)方案
这是在前端嵌入中文字体时绝不能忽视的关键问题。英文字体只包含数十个基础字母,文件通常只有几十 KB;而一套完整的中文字符集(GB2312 或 GBK)包含几千到几万个字符,原始 .ttf 文件往往达到 12MB ~ 25MB。
如果直接将未经处理的完整字体转为 Base64,不仅会增加至少 33% 的体积(达到 20MB+),还会导致低端设备在内存解码时发生卡顿甚至崩溃。解决此瓶颈的标准工业级方案是:字形子集化(Font Subsetting)。
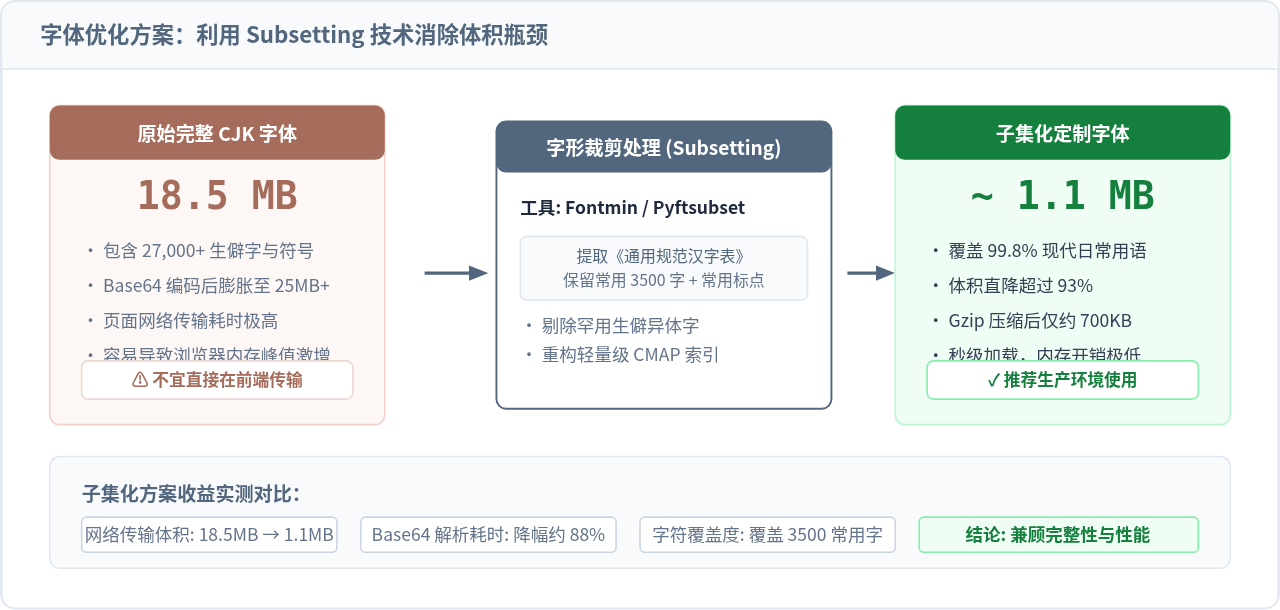
如何实施字体子集化?
你可以使用 Node.js 社区的 fontmin 库,在项目构建脚本中自动处理:
// 自动化构建脚本示例:font-subset.js
const Fontmin = require('fontmin');
const fs = require('fs');

// 读取《通用规范汉字表》常用 3500 字或业务固定的词库字符
const commonChineseChars = fs.readFileSync('./chinese-chars-3500.txt', 'utf-8');

const fontmin = new Fontmin()
  .src('src/assets/fonts/SourceHanSansCN-Normal.ttf')
  .use(Fontmin.glyph({
    text: commonChineseChars + '0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ,。!?:;()“”《》¥%'
  }))
  .dest('public/fonts/');

fontmin.run((err, files) => {
  if (err) {
    console.error('子集化失败:', err);
    return;
  }
  console.log('子集化完成!生成文件大小仅约 1MB。');
});
五、常见报错与排查决策树
即使按照教程操作,开发过程中依然可能由于细节疏忽导致中文字体无法生效或报错。以下是几个最典型的陷阱及排查要点:
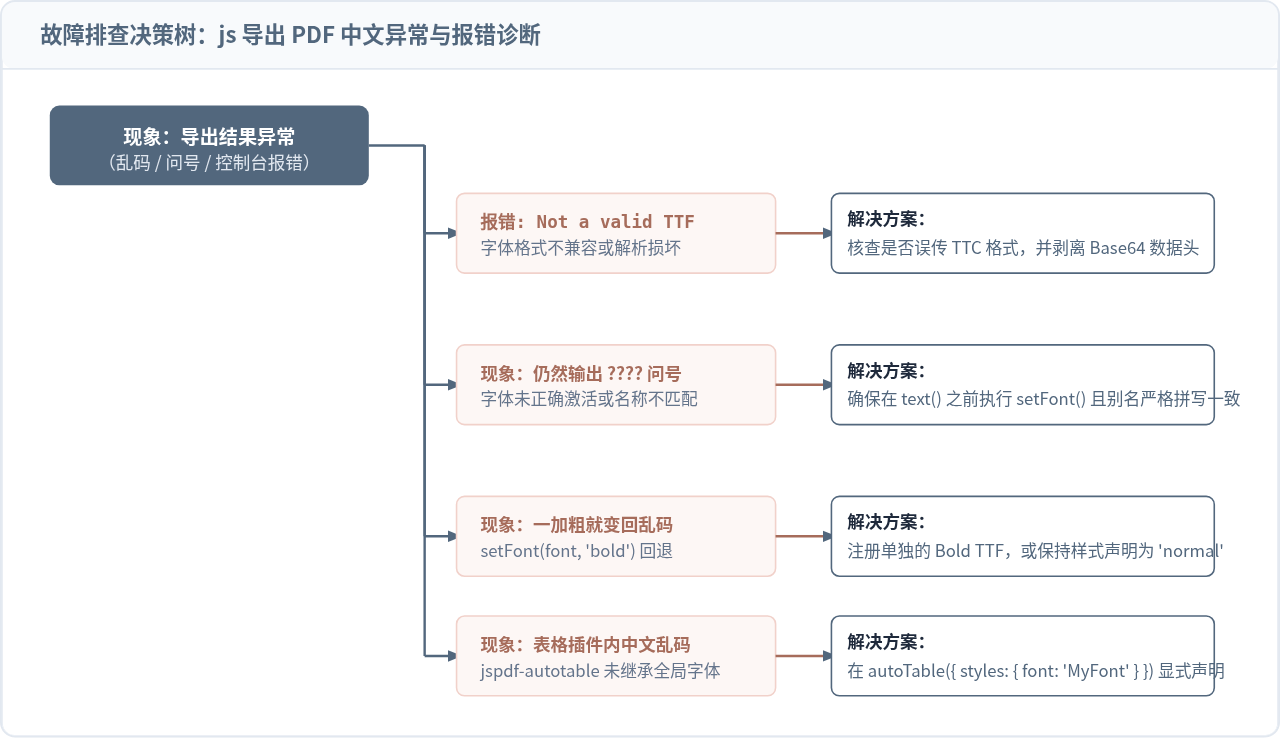
- Base64 不要带 Data URI 头部:
addFileToVFS要求的第二个参数是纯 Base64 内容。如果使用FileReader.readAsDataURL(),务必使用base64.split(',')[1]截取掉data:font/ttf;base64,这一前缀,否则字体头部结构校验会直接失败报错。 - 不能混淆 TTC 与 TTF:Windows 系统的
simsun.ttc是 TrueType 字体集合文件,内部打包了多种字形。直接传入 jsPDF 会导致报 “Invalid font header” 错误。请使用字体工具提取出单体的.ttf文件后再使用。 - 样式(Style)未注册导致的回退:如果你只用
addFont(..., 'MyFont', 'normal')注册了常规体,而后续调用了doc.setFont('MyFont', 'bold'),由于不存在bold的映射,jsPDF 会静默回退至 Helvetica-Bold,导致后续文字瞬间打回原形变回乱码。若需加粗,必须显式注册对应的粗体 TTF,或在绘制时保持normal样式。
六、导出方案技术选型对比
除了 jsPDF 纯矢量方案,前端生成 PDF 还有其他几种常见实现方式。根据具体项目的业务场景、排版复杂度和设备性能,建议参考下表进行权衡:
| 方案类型 | 代表技术 | 中文乱码处理方式 | 清晰度与体积 | 最佳适用场景 |
|---|---|---|---|---|
| 客户端矢量直出(本文方案) | jsPDF / PDFKit / pdfmake | 需嵌入 TTF / 自定义字体并挂载 VFS | 文本完全矢量化,高保真,可复制,PDF 文件极小 | 结构化票据、合同、发票凭证、大批量表格导出 |
| 客户端 DOM 转位图 | html2canvas + jsPDF | 依赖系统/浏览器 DOM 字体,天然不乱码 | 本质为图片贴图,文件体积偏大,放大失真,文字不可选 | 现有复杂 CSS 页面仪表盘、数据可视化图表的一键截图归档 |
| 服务端无头浏览器渲染 | Puppeteer / Playwright | 服务器安装对应 CJK 字体包即可自动渲染 | 100% 还原 CSS 复杂打印样式,排版最强,但需服务端计算资源 | 多页复杂报告、打印出版级文档、对排版保真度要求极高的场景 |
总结
JavaScript 导出 PDF 中文乱码的核心根源,是 PDF 规范自带的 14 种标准字体不包含中文字符与 CJK 字形轮廓。要从根本上解决乱码并获得高质量矢量文档:
- 使用独立的
.ttf格式字体文件,结合addFileToVFS()与addFont()将字体注册至内存文件系统; - 在文本输出前显式调用
doc.setFont()激活该中文字体; - 在生产环境中结合
fontmin等子集化工具裁剪常用 3500 字,将字体体积压缩到 1MB 左右,并通过异步按需加载避免阻塞页面。
掌握这套字体嵌入与子集化工作流,即可彻底告别乱码与失真,稳定输出排版规范、字符清晰、体积轻量的中文 PDF 文档。
JS处理含Emoji或中文的字符串转数组乱码问题
2026-11-05 16:12:28
JS怎么使用展开运算符合并对象
2026-11-05 14:42:18
ES6+环境下判断JS对象为空的简洁写法
2026-11-05 12:12:23
怎么通过replacer函数自定义JS中JSON的格式化输出
2026-11-05 11:19:44
JS正则表达式基础:字面量与RegExp构造函数的区别及常用元字符
2026-11-05 11:16:58







