

Node.js使用axios批量下载网页源码并保存
本文详细介绍在Node.js环境下使用axios批量下载多个网页HTML源码并持久化保存至本地文件的完整方案,涵盖环境搭建、基础单页抓取、并发队列控制、异常容错及本地目录写入。
在数据采集、网页归档和离线分析等场景中,批量抓取目标网页的 HTML 源码并将其持久化到本地磁盘是一项非常基础且关键的操作。借助 Node.js 异步非阻塞的 I/O 特性与灵活的 axios HTTP 客户端,我们能够用简洁的脚本完成高吞吐量的网页下载任务。然而,直接通过简单的循环发起数十或数百个网络请求往往会导致目标服务器封禁、连接超时甚至本地进程内存溢出。本文将完整梳理在 Node.js 中使用 axios 配合原生 fs/promises 模块批量下载网页源码的实现方案,重点讲解请求头伪装、并发窗口控制以及网络重试等关键技术节点。
一、系统架构与数据流转
批量网页下载的核心在于“受控的生产者-消费者机制”。我们将 URL 列表组织为任务队列,通过滑动窗口控制同一时间发起的 HTTP 请求数量,并在响应到达后立即通过文件系统 API 写入磁盘,避免在内存中大量积压字符串数据。
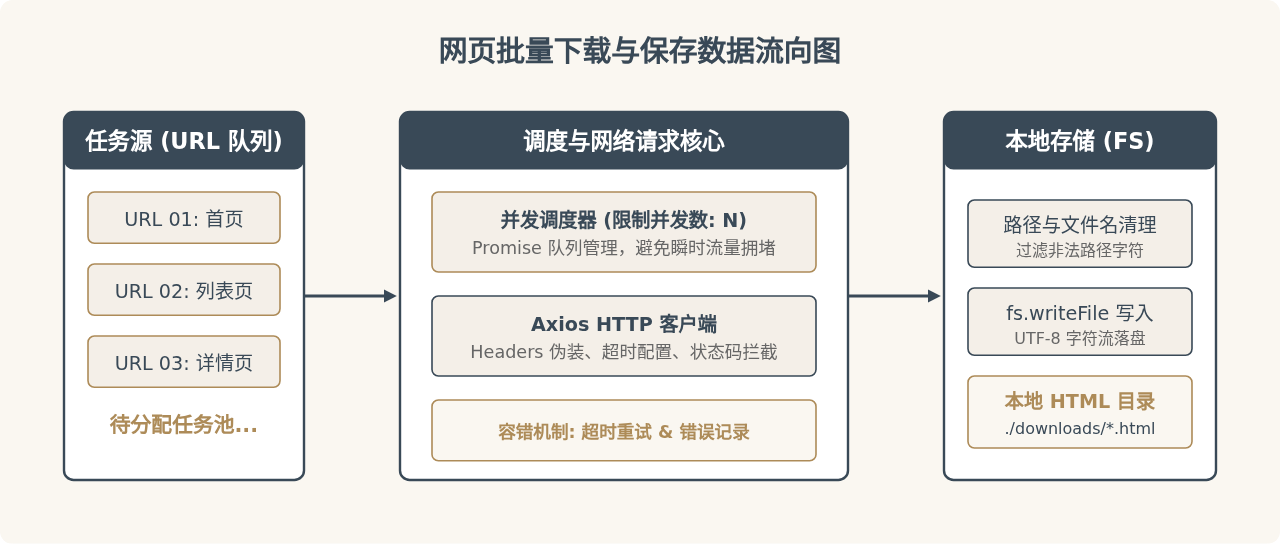
二、基础环境与单页下载实现
在开始编写批量逻辑之前,先初始化一个干净的 Node.js 项目并安装必要的依赖。本方案仅需 axios 一个三方网络库,文件读写直接使用 Node.js 内置的 fs/promises 模块。
# 初始化项目目录
mkdir batch-html-downloader
cd batch-html-downloader
npm init -y

# 安装 axios
npm install axios
单个网页的下载主要涉及三个关键设置:自定义 User-Agent 规避简易的反爬策略、设置合理的请求超时时间防止线程挂起,以及使用 fs.mkdir 确保目标存储目录已存在。
// downloadSingle.js
const axios = require('axios');
const fs = require('fs/promises');
const path = require('path');

async function downloadSinglePage(url, outputPath) {
  try {
    const response = await axios.get(url, {
      timeout: 10000,
      headers: {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36',
        'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',
        'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8'
      },
      responseType: 'text' // 确保以字符串格式接收 HTML
    });

    // 确保目标父级目录存在
    await fs.mkdir(path.dirname(outputPath), { recursive: true });
    // 将源码以 UTF-8 编码写入文件
    await fs.writeFile(outputPath, response.data, 'utf-8');
    console.log(`[成功] 已保存: ${url} -> ${outputPath}`);
    return true;
  } catch (error) {
    console.error(`[失败] ${url}: ${error.message}`);
    return false;
  }
}
三、单任务与批量并发的处理机制对比
在处理多个 URL 时,初学者常常面临两种极端:一种是使用 for...of 搭配 await 串行执行,耗时过长;另一种是使用 Promise.all 将所有请求瞬间全量抛出,导致网络风暴和服务器连接拒绝。合理的做法是采用受控并发池模式。
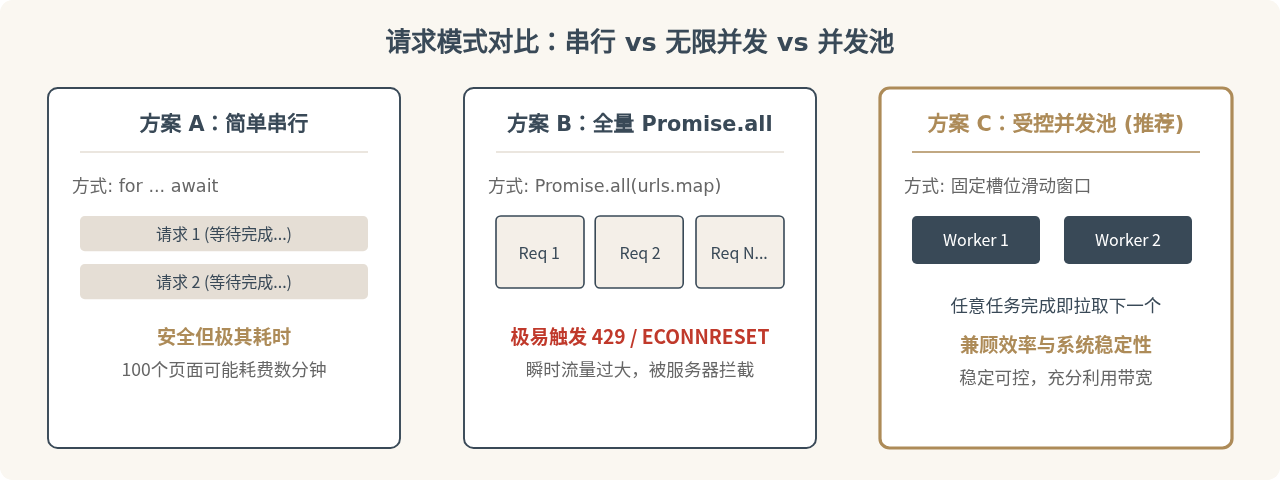
四、批量下载完整执行流程
为了让批量下载具备生产环境的可用性,我们必须按照严格的标准流水线执行。从任务初始化到持久化保存,整体流程分为六个不可或缺的阶段:
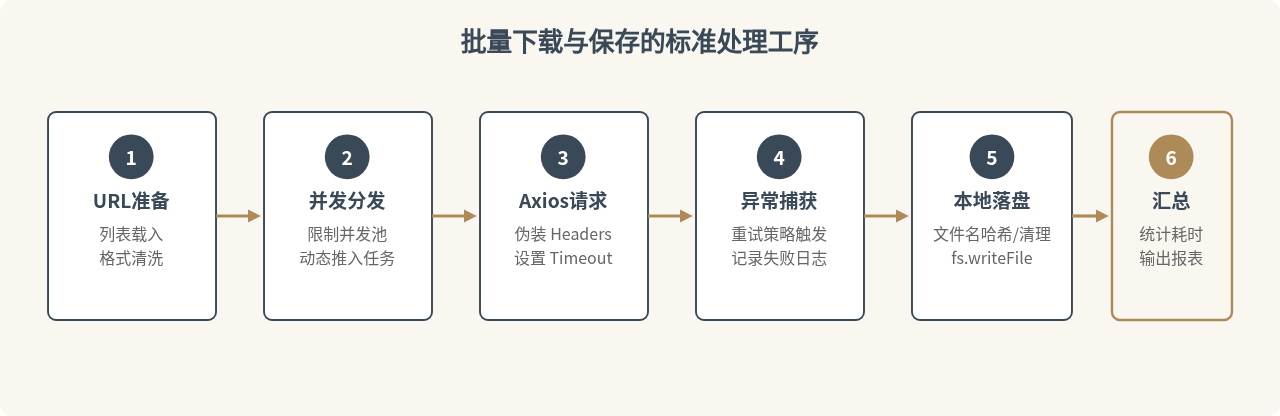
五、生产级批量下载实现代码
下面是一个完整的、不依赖任何第三方并发控制库(如 p-limit)的原生实现方案。我们实现了一个简洁轻量的 asyncPool 算法,保证同时运行的下载任务数始终维持在指定的阈值以内。
// batchDownloader.js
const axios = require('axios');
const fs = require('fs/promises');
const path = require('path');
const crypto = require('crypto');

// 1. 根据 URL 安全生成本地存储文件名
function sanitizeFilename(url) {
  try {
    const parsed = new URL(url);
    const pathname = parsed.pathname.replace(/[^a-zA-Z0-9_-]/g, '_');
    const hash = crypto.createHash('md5').update(url).digest('hex').slice(0, 8);
    const baseName = pathname === '_' || pathname === '' ? 'index' : pathname;
    return `${parsed.hostname}_${baseName}_${hash}.html`;
  } catch {
    const hash = crypto.createHash('md5').update(url).digest('hex').slice(0, 10);
    return `page_${hash}.html`;
  }
}

// 2. 带重试机制的单页下载
async function fetchAndSave(url, outputDir, maxRetries = 2) {
  const filename = sanitizeFilename(url);
  const targetPath = path.join(outputDir, filename);

  for (let attempt = 1; attempt <= maxRetries + 1; attempt++) {
    try {
      const response = await axios.get(url, {
        timeout: 8000,
        headers: {
          'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36',
          'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8'
        },
        responseType: 'text'
      });

      await fs.writeFile(targetPath, response.data, 'utf-8');
      return { success: true, url, targetPath };
    } catch (err) {
      if (attempt <= maxRetries) {
        // 退避等待 1 秒后重试
        await new Promise(resolve => setTimeout(resolve, 1000 * attempt));
      } else {
        return { success: false, url, error: err.message };
      }
    }
  }
}

// 3. 原生并发池调度器
async function runConcurrentTasks(tasks, concurrency, iteratorFn) {
  const executing = new Set();
  const results = [];

  for (const item of tasks) {
    const p = Promise.resolve().then(() => iteratorFn(item));
    results.push(p);
    executing.add(p);

    const clean = () => executing.delete(p);
    p.then(clean, clean);

    if (executing.size >= concurrency) {
      await Promise.race(executing);
    }
  }

  return Promise.all(results);
}

// 4. 统一调度入口
async function startBatchDownload(urlList, outputDirectory, concurrency = 5) {
  console.log(`[启动] 开始下载任务,目标数: ${urlList.length},并发数: ${concurrency}`);
  const startTime = Date.now();

  // 创建输出目录
  await fs.mkdir(outputDirectory, { recursive: true });

  const summary = await runConcurrentTasks(urlList, concurrency, (url) => {
    return fetchAndSave(url, outputDirectory);
  });

  const succeeded = summary.filter(r => r.success).length;
  const failed = summary.filter(r => !r.success).length;
  const elapsed = ((Date.now() - startTime) / 1000).toFixed(2);

  console.log(`\n============== 执行汇总 ==============`);
  console.log(`总任务数: ${urlList.length}`);
  console.log(`成功数量: ${succeeded}`);
  console.log(`失败数量: ${failed}`);
  console.log(`总耗时:   ${elapsed} 秒`);
  console.log(`保存路径: ${path.resolve(outputDirectory)}`);
  console.log(`======================================`);
}

// 示例运行
const testUrls = [
  'https://www.example.com',
  'https://www.wikipedia.org',
  'https://nodejs.org/en',
  'https://github.com'
];

startBatchDownload(testUrls, './downloads', 3);downloads 文件夹中。
六、关键异常与排错排查
在批量下载场景下,网络抖动或目标站点防御策略会导致各种错误。开发者需要掌握以下常见故障的根本原因与应对策略:
- ETIMEDOUT / ECONNABORTED(请求超时):通常由网络延迟或目标服务器响应缓慢导致。建议在
axios配置中设置合理的timeout(如 8000ms),并在 catch 块中结合计数器进行递增等待时间的退避重试。 - HTTP 403 Forbidden / 418 I'm a teapot:目标站点通过特征库识别出了爬虫脚本。请检查是否配置了标准浏览器的
User-Agent和Accept,或者降低并发数,避免单一 IP 在短时间内的突发高频访问。 - HTTP 429 Too Many Requests:触发了服务端的速率限制。遇到此类状态码应立即暂停该站点的任务执行,或增大任务之间的间隔时间(
delay)。 - 文件名非法导致写入崩溃:URL 中通常包含
?、&、/等在本地文件系统中保留的特殊字符。保存前必须使用正则替换或者哈希摘要(如 MD5)对文件名进行脱敏清洗。
七、知识总结与最佳实践
通过本文的探讨,我们可以将 Node.js 批量抓取网页的核心技巧归纳为以下几条核心经验:
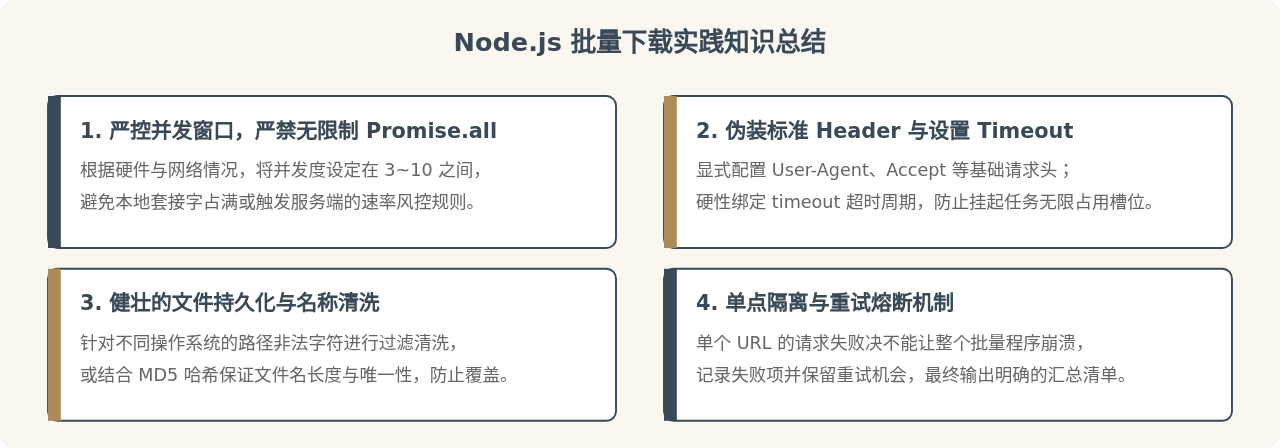
在 NestJS 中使用管道验证数据与守卫控制访问权限
2026-11-05 12:43:41
Node.js后端生成高强度随机字符串的方法
2026-11-04 16:29:54
Node.js环境中怎么使用axios或http模块发送GET请求
2026-11-03 21:57:15
Node.js环境下怎么实现JS反混淆自动化?常用库与CLI工具推荐
2026-11-03 21:15:54
解决JS逆向常见报错:缺少DOM环境导致代码运行失败
2026-11-03 20:41:59
相关标签:







