JavaScript函数式编程入门:纯函数与不可变数据详解
深入解析 JavaScript 函数式编程两大基石:纯函数与不可变数据。通过原理对比、重构步骤、内存模型图解与工程避坑指南,带你写出高可预测、易测试且稳健的代码。
在实际的 JavaScript 工程开发中,难以追踪的状态篡改与难以复现的副作用往往是程序 Bug 的主要根源。函数式编程(Functional Programming, FP)通过约束状态的变化与计算过程,大幅提升了代码的确定性与可维护性。要真正迈入函数式编程的大门,并不需要一开始就钻研晦涩的范畴论或复杂的代数数据类型,掌握其最核心的两大基石——纯函数(Pure Functions)与不可变数据(Immutable Data),就能立即在日常开发中写出易调试、高内聚、易测试的优秀代码。
一、纯函数的核心原则与判定依据
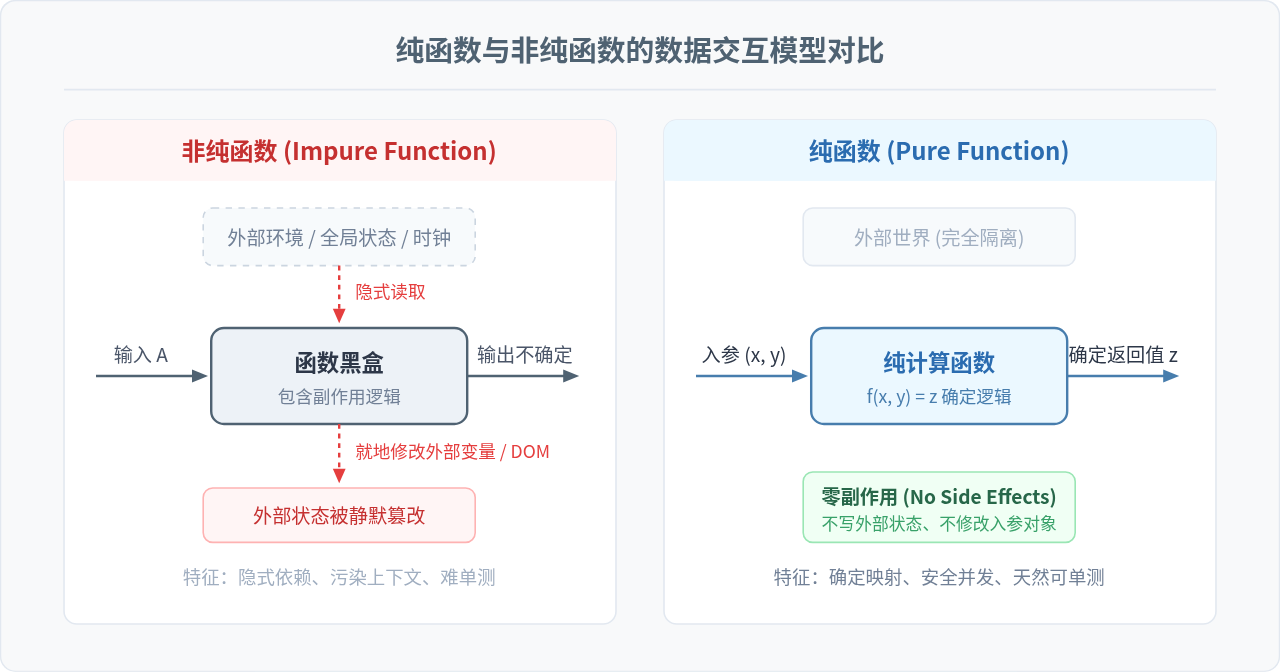
一个函数能否被称为“纯函数”,并不取决于它的代码行数或语法结构,而是严格取决于其行为特征。具体而言,纯函数必须同时满足以下两个刚性条件:
- 相同的输入,始终返回相同的输出:函数的结果仅依赖于显式传递给它的入参,不依赖任何外部可变环境变量、全局配置、系统时间或随机数。
- 执行过程中没有任何可观察的副作用(Side Effects):函数在运行期间不能以任何形式改变外部世界的状态,包括但不限于修改全局变量、修改外部引用对象的属性、发起网络请求、读写本地存储或直接操作 DOM。
为了直观体会二者的区别,我们可以观察下面这两段计算折扣金额的代码示例:
// 示例一:非纯函数(隐式依赖外部状态,且可能造成外部污染)
let discountRate = 0.1;

function calculateDiscountImpure(price) {
  // 依赖了外部自由变量 discountRate,若外部变量被其他模块修改,相同的 price 会得到不同结果
  return price * (1 - discountRate);
}

// 示例二:纯函数(显式依赖,确定性映射)
function calculateDiscountPure(price, rate) {
  // 仅依赖入参,只要 price 和 rate 固定,输出绝对确定,且不影响外部任何变量
  return price * (1 - rate);
}
当函数保持纯净时,它就像数学中的公式 $f(x) = y$。这种特质为工程带来三大直接收益:一是完全可测试,无需构造繁杂的 Mock 环境或伪造全局对象;二是安全可缓存(Memoization),由于输入输出严格对应,可以依据入参放心地将高开销计算结果缓存起来;三是无时序耦合,在异步调用与并发执行时不会产生竞态冲突。
二、副作用识别与函数纯化重构步骤
日常业务逻辑往往充斥着各种隐式副作用。最常见的副作用来源包括:
- 直接对入参对象或数组执行就地修改(如
arr.push()、arr.sort()或user.active = true); - 函数内部直接调用了带有系统不确定性的 API(如
Date.now()、Math.random()); - 函数直接参与了 I/O 操作(如发起 Fetch 请求、操作
localStorage、向页面插入 DOM 节点)。
要把一个混杂了副作用的过程式代码重构为清晰的函数式结构,通常可以按照以下标准的三步法展开:
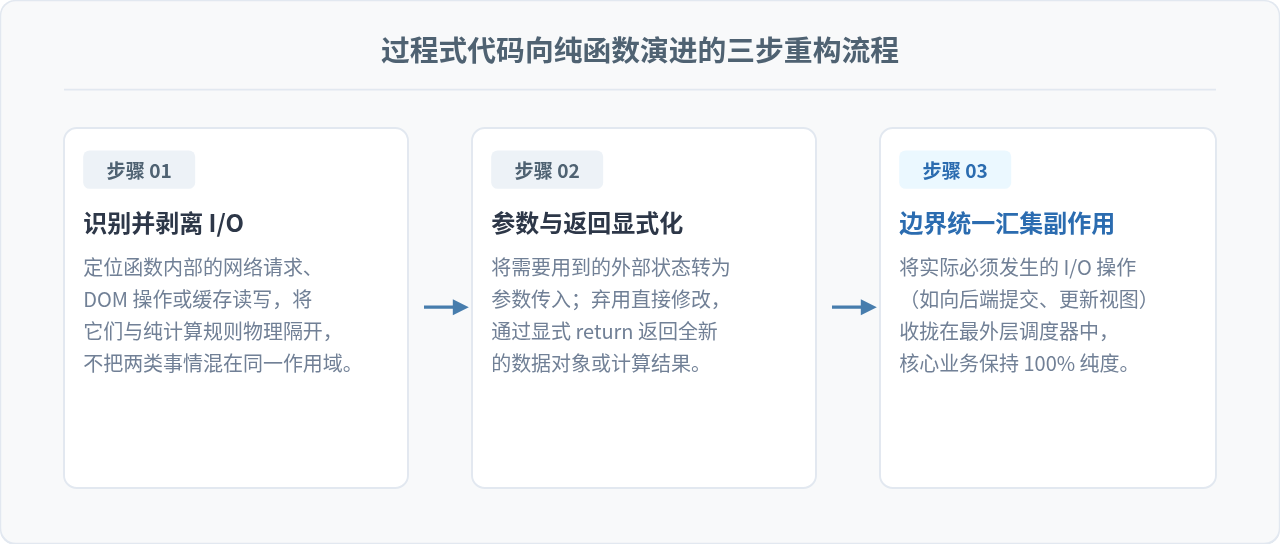
我们来看一个具体的电商订单积分结算改造实例。改造前的传统做法往往把参数修改与页面渲染混在了一起:
// 改造前:修改了原始对象,且直接产生 DOM 渲染副作用
function processOrderBad(order) {
  // 副作用 1:直接修改入参对象属性(在外部可见)
  order.points = order.amount * 10;
  order.processedAt = new Date().toISOString(); // 副作用 2:不确定的时间源

  // 副作用 3:耦合 DOM 更新
  document.getElementById('status').innerText = `已处理订单 ${order.id}`;
}
应用三步法重构后,我们将纯核心与副作用边界清晰分离:
// 改造后 步骤一与步骤二:纯计算函数,不碰任何外部环境
function calculateOrderReward(order, timestamp) {
  // 显式传入确定时间戳,返回全新对象,原始 order 不受任何影响
  return {
    ...order,
    points: order.amount * 10,
    processedAt: timestamp
  };
}

// 步骤三:在顶层事件边界处理不可避免的副作用
function handleOrderSubmit(rawOrder) {
  const currentTimestamp = new Date().toISOString();
  // 调用纯函数进行核心状态派生
  const updatedOrder = calculateOrderReward(rawOrder, currentTimestamp);

  // 显式在边界执行 I/O 副作用
  document.getElementById('status').innerText = `已处理订单 ${updatedOrder.id}`;
  return updatedOrder;
}
三、不可变数据(Immutable Data)的机制与实现
既然纯函数要求“不得产生副作用”,那么当我们需要在业务中更新数据时,该如何操作?答案就是不可变数据。
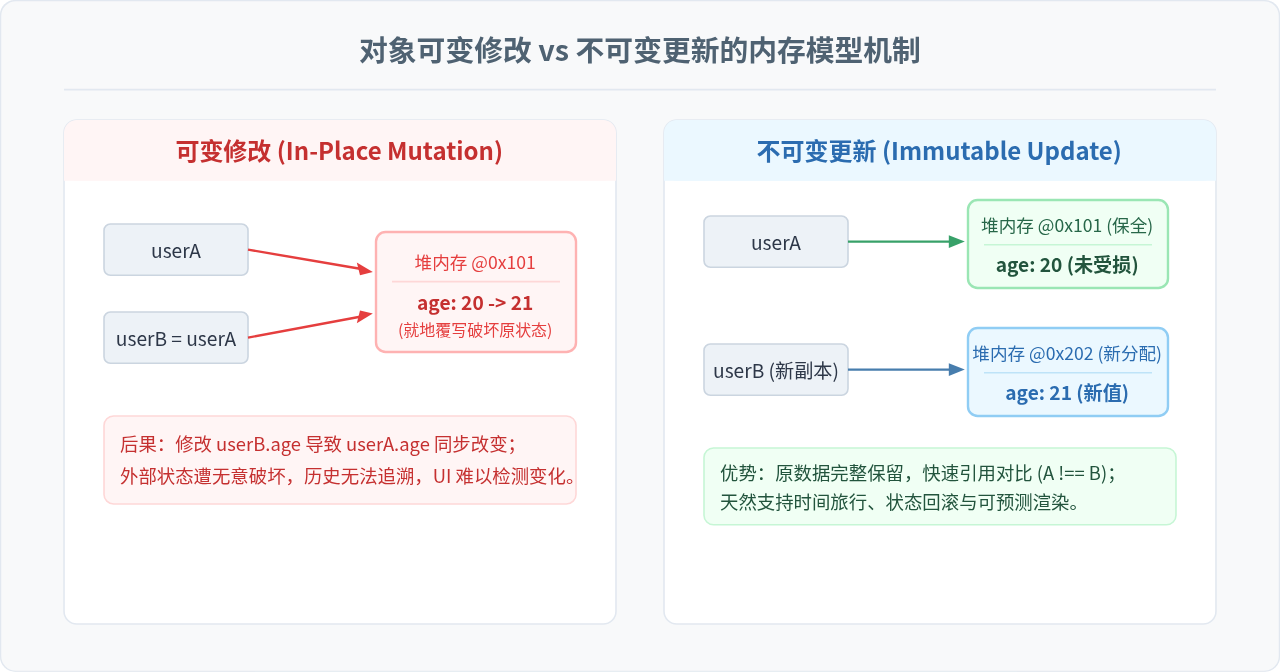
在 JavaScript 中,原始类型(string、number、boolean、null、undefined、symbol、bigint)本身就是不可变的;无论如何操作一个字符串,都不会改变原有字符串的值。然而,对象(Object)与数组(Array)是引用传递类型。一旦将对象直接赋值给新变量,两个变量将指向堆内存中的同一个地址,对其中任何一个变量的属性进行修改,都会污染另一方。
1. 数组的不可变操作规范
在 JavaScript 中操作数组时,需要严格区分哪些原生方法具有破坏性,哪些是安全的不可变方法:
- 禁用的就地修改方法:
push()、pop()、shift()、unshift()、splice()、sort()、reverse()。这些方法会直接改动原数组。 - 推荐的安全替代方案:
- 添加元素:使用展开运算符
[...arr, newItem]; - 删除或过滤:使用
arr.filter()或arr.slice(); - 映射转换:使用
arr.map(); - 排序与反转(ECMAScript 2023 新标准):使用
toSorted()、toReversed()、toSpliced(),它们会自动返回新数组而不动原数组。
- 添加元素:使用展开运算符
// 原始数组
const initialList = [3, 1, 4, 1, 5];

// 错误示范:就地排序污染原数组
// initialList.sort(); // initialList 自身变为 [1, 1, 3, 4, 5]

// 正确做法 1:ES2023 toSorted() 原生不可变排序
const sortedList = initialList.toSorted((a, b) => a - b);

// 正确做法 2:添加元素
const addedList = [...initialList, 9];

// 正确做法 3:安全剔除元素(删除所有值为 1 的项)
const filteredList = initialList.filter(item => item !== 1);

console.log(initialList); // 仍然是 [3, 1, 4, 1, 5],原数据未受任何破坏
2. 对象的不可变更新与深层拷贝界限
对于对象,通常使用对象展开运算符(Spread Operator)进行属性更新或合并:
const user = {
  id: 101,
  name: "Alex",
  profile: {
    city: "Beijing",
    theme: "dark"
  }
};

// 浅层更新:修改顶层属性
const updatedUser = {
  ...user,
  name: "Alexander"
};注意浅拷贝的陷阱:展开运算符 { ...user } 仅对第一层属性有效。如果对象包含嵌套对象(如上述 profile),展开后 updatedUser.profile 与 user.profile 指向的仍然是同一个内存地址!
若要安全更新深层嵌套属性,有以下两种规范实践:
// 实践一:手动逐层浅拷贝(结构共享,性能开销小)
const updatedProfileUser = {
  ...user,
  profile: {
    ...user.profile,
    theme: "light" // 仅覆盖深层目标属性
  }
};

// 实践二:原生全量深拷贝(ES2022+ structuredClone)
// 适用于无需保留函数、仅处理深层纯数据的场景
const completelyCloned = structuredClone(user);
completelyCloned.profile.theme = "system";
3. 防御性保障:Object.freeze()
在工程中,为了防止团队其他成员或第三方库不小心对核心数据做就地修改,可以在数据产出时使用 Object.freeze() 进行冻结。在严格模式('use strict')下,任何尝试改写被冻结对象的行为都会立即抛出 TypeError 错误,从而将潜在隐患扼杀在开发阶段。
四、工程误区、性能权衡与架构决策
在推行函数式编程时,开发者常陷入几个极端误区,需要在架构设计时建立清晰的界限:
- 误区一:混淆 const 与不可变
const仅保证变量标识符所绑定的内存地址不能被重新赋值,它完全不限制对象内部属性的修改。const obj = { count: 0 }; obj.count = 1;是合法的 JavaScript 代码。因此,const并不是不可变数据的充分条件。 - 误区二:盲目进行全量深拷贝造成内存爆炸
不可变数据并不等于每次改动都把整个应用的状态树做一次JSON.parse(JSON.stringify(state))。现代前端架构推崇的是结构共享(Structural Sharing):只为被修改的节点及其父路径创建新引用,未受影响的庞大子树直接复用旧引用。 - 误区三:追求 100% 纯函数的极端乌托邦
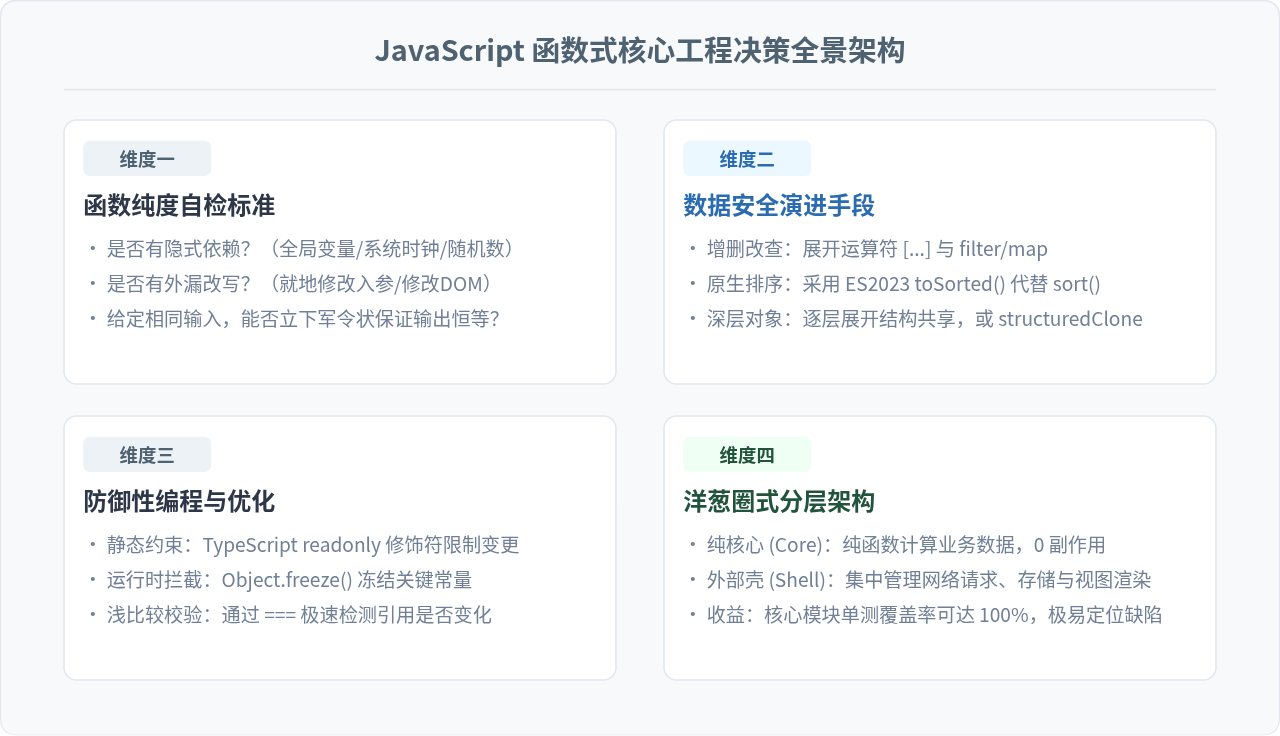
任何有实际价值的计算机程序都必须产生副作用(展示给用户、发送至服务器或写入本地)。函数式编程的目标绝不是消灭副作用,而是驯服副作用——将不纯的、不可控的代码赶到系统的外部边界(Shell),让系统的内部核心(Core)保持 100% 的纯函数与不可变数据。
总结
纯函数与不可变数据并非孤立的技术教条,而是相辅相成的工程思维:纯函数以不可变数据为计算原料,不可变数据为纯函数的执行提供确定性保障。在日常前端与 Node.js 开发中,逐步摒弃直接修改入参、善用对象/数组的不可变操作符、并将不可避免的副作用统筹在系统外缘,就能让整个代码库的复杂度大幅降低,拥有更清晰的数据流和更高的工程健壮性。
JS处理含Emoji或中文的字符串转数组乱码问题
2026-11-05 16:12:28
JS怎么使用展开运算符合并对象
2026-11-05 14:42:18
ES6+环境下判断JS对象为空的简洁写法
2026-11-05 12:12:23
怎么通过replacer函数自定义JS中JSON的格式化输出
2026-11-05 11:19:44
JS正则表达式基础:字面量与RegExp构造函数的区别及常用元字符
2026-11-05 11:16:58