JavaScript批量下载图片怎么实现?解决浏览器并发限制的技巧
深入讲解JavaScript实现批量下载图片的核心方案,分析浏览器同域名并发限制与内存瓶颈,详解Promise并发控制池与JSZip打包下载的工程化实现技巧。
在前端业务开发中,批量下载图片是一个常见但容易踩坑的需求。很多初学者在初次实现时,往往会通过循环动态创建 <a> 标签并触发点击,或者使用 Promise.all 一次性发起上百个请求。这种简单粗暴的方式通常会在图片数量增多时引发严重问题:浏览器下载弹窗被拦截、同域名网络请求阻塞排队、大量占用内存甚至导致页面卡死崩溃。要实现稳定高效的批量下载,核心在于掌握浏览器底层网络限制机理、受控的并发调度池(Promise Pool)以及合适的交付策略(打包归档 vs 串行触发)。
一、浏览器批量下载的底层限制与常见瓶颈
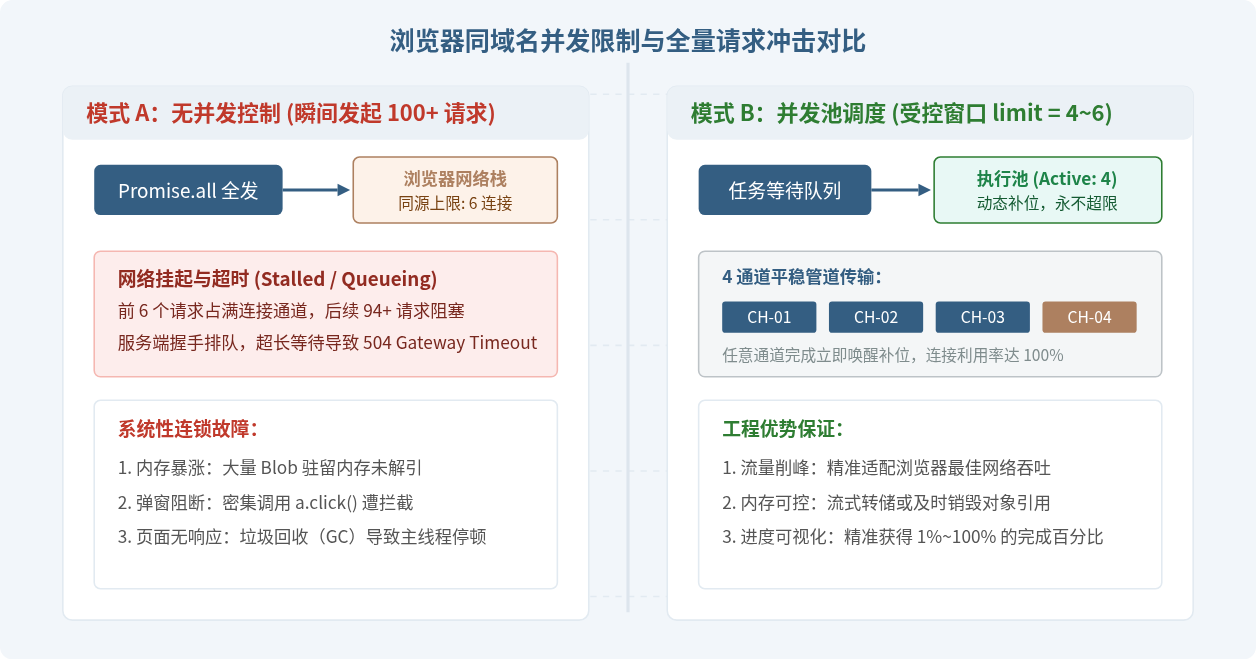
在编写代码前,必须先弄清楚为什么不能无节制地“一股脑发起全部下载”。现代浏览器在处理批量网络请求与下载行为时,设置了三道天然的防御屏障与资源红线:
- 同域名并发连接数限制(HTTP/1.1 最大 6 个):在 HTTP/1.1 协议下,Chrome、Firefox 等主流浏览器对同一个域名限制同时建立 6 个 TCP 连接。如果瞬间发起 100 个图片请求,第 7 到第 100 个请求必须在网络栈中排队挂起(Queueing / Stalled)。若等待时间过长,可能直接触发网关或服务端请求超时(504 Gateway Timeout)。
- 内存累积与垃圾回收(GC)压力:为了跨域下载图片并保持正确的文件名,通常需要先通过
fetch获取二进制数据(Blob),再利用URL.createObjectURL生成虚拟下载链接。若几百张高分辨率图片同时进驻内存,不仅容易造成几百兆甚至数吉字节的内存毛刺,若未及时调用URL.revokeObjectURL释放引用,页面会直接发生内存泄漏直至崩溃。 - 浏览器多弹窗/自动下载拦截机制:为了防止流氓网页恶意弹窗投毒,浏览器安全引擎对非用户直接手势(User Gesture)激发的连续下载行为具有严格拦截策略。如果在 1 秒内连续调用数十次
a.click(),浏览器会默认将其判定为恶意行为并直接阻断后续下载。
二、单张图片可靠下载的基石实现
很多开发者在下载图片时直接使用 <a href="url" download="name.jpg">。然而,在跨域图片或现代安全策略限制下,若图片所在 CDN 未开启特殊的 Content-Disposition 响应头,直接点击跨域 href 链接只会触发浏览器新标签页预览,而不会触发真正的文件保存。
因此,可靠的前端下载必须走 Fetch -> Blob -> ObjectURL -> 模拟触发 链路。下面是经过健壮性封装的单图下载基础函数:
/**
 * 安全下载单个远程图片资源
 * @param {string} imgUrl - 图片绝对路径或网络URL
 * @param {string} fileName - 期望保存的文件名
 * @returns {Promise<void>}
 */
async function downloadSingleImage(imgUrl, fileName) {
  try {
    // 1. 发起跨域资源请求(服务端必须配置 Access-Control-Allow-Origin)
    const response = await fetch(imgUrl, {
      method: 'GET',
      mode: 'cors',
      cache: 'no-cache'
    });

    if (!response.ok) {
      throw new Error(`HTTP error! status: ${response.status}`);
    }

    // 2. 转换为二进制 Blob
    const blob = await response.blob();

    // 3. 创建临时对象 URL
    const objectUrl = window.URL.createObjectURL(blob);

    // 4. 构建隐藏锚点并触发下载
    const link = document.createElement('a');
    link.href = objectUrl;
    link.download = fileName || 'download-image.jpg';
    link.style.display = 'none';
    document.body.appendChild(link);
    link.click();

    // 5. 延迟清理资源,确保浏览器已完成文件句柄接管
    setTimeout(() => {
      document.body.removeChild(link);
      window.URL.revokeObjectURL(objectUrl);
    }, 1000);
  } catch (error) {
    console.error(`下载图片失败 [${fileName}]:`, error);
    throw error;
  }
}link.click() 是一个异步派发的事件。在某些低性能设备或旧版浏览器中,如果立即同步执行 revokeObjectURL,浏览器底层的下载进程可能尚未读取该 Blob 内存块,导致生成 0 字节的损坏文件或报错“网络错误”。因此,建议使用 setTimeout 给予 500~1000 毫秒的安全期缓冲。
三、核心解决方案:手写 Promise 并发调度器(Concurrency Pool)
当需要下载数十或上百张图片时,我们需要一个控制并发上限的任务调度器。调度器的核心思路是:设定一个最大执行通道数(如 limit = 4),先启动前 4 个任务。当其中任意一个任务完成时,立刻从待处理队列中取出下一个任务塞入空出的槽位,始终保持当前正在进行的任务数不超过限制,直到全部任务执行完毕。
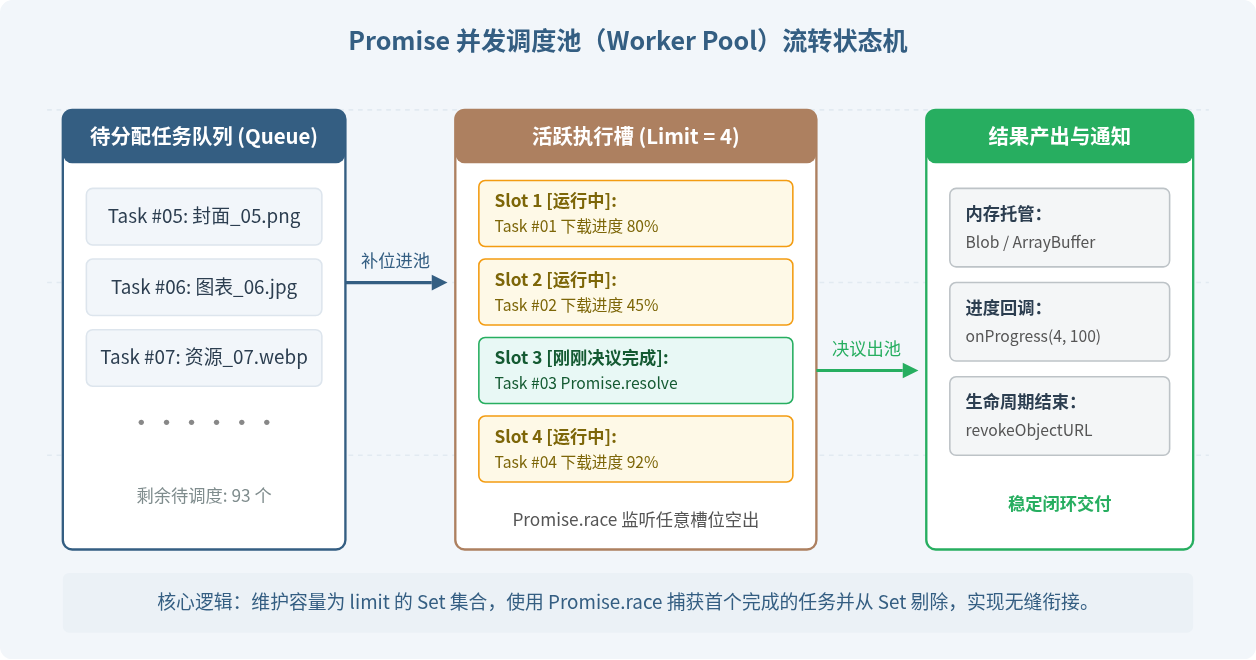
通用并发调度器代码实现
以下为一个零第三方依赖的高性能并发调度器实现。它不仅支持设置并发上限,还提供了实时进度回调和错误隔离机制:
/**
 * 高性能并发控制器
 * @param {number} poolLimit - 最大并发数(推荐 3-6)
 * @param {Array<T>} items - 输入任务参数数组
 * @param {Function} iteratorFn - 处理单项的异步函数,入参为 (item, index)
 * @param {Function} onProgress - 进度变动回调 (completedCount, totalCount)
 * @returns {Promise<Array>}
 */
async function asyncPool(poolLimit, items, iteratorFn, onProgress) {
  const results = [];
  const executing = new Set();
  let completed = 0;
  const total = items.length;

  for (const [index, item] of items.entries()) {
    // 包装单个 Promise,执行完毕后从 executing 集合中移除自身
    const p = Promise.resolve().then(() => iteratorFn(item, index));
    results.push(p);
    executing.add(p);

    const clean = () => {
      executing.delete(p);
      completed++;
      if (typeof onProgress === 'function') {
        onProgress(completed, total);
      }
    };
    p.then(clean).catch(clean);

    // 当正在执行的任务达到限制时,挂起等待最快的一个结束
    if (executing.size >= poolLimit) {
      await Promise.race(executing);
    }
  }

  return Promise.all(results);
}
四、两种批量交付策略:串行触发 vs 打包为 ZIP 归档
通过并发池成功获取图片数据后,在将图片“落盘”给用户时,通常有两种主流策略:
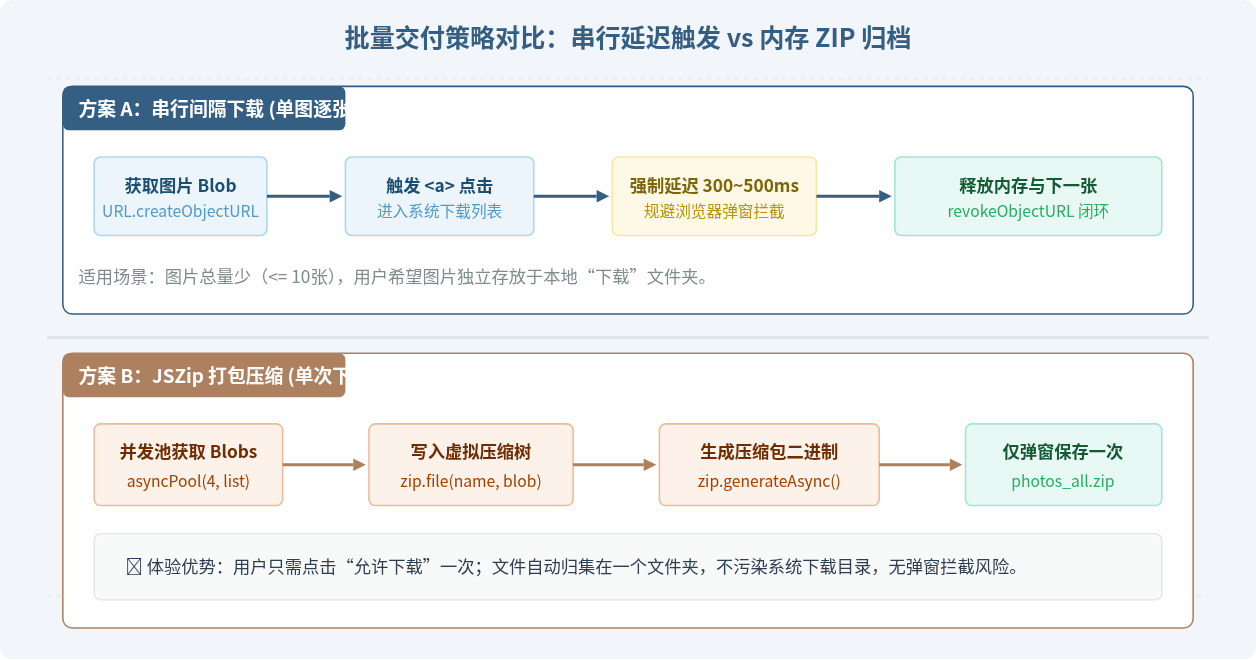
方案 B 实践:结合并发池与 JSZip 实现一键打包
在企业级管理后台中,最推荐的做法是将所有图片打包为单个 .zip 压缩包。使用社区标准库 JSZip,配合我们的并发调度池,可以实现流畅、内存友好的批量打包:
// 需提前引入 JSZip 库 (例如: <script src="https://cdn.jsdelivr.net/npm/jszip@3.10.1/dist/jszip.min.js"></script>)

/**
 * 批量拉取图片并打包为 zip 文件下载
 * @param {Array<{url: string, name: string}>} imageList - 图片列表
 * @param {string} zipFileName - 压缩包名称
 * @param {Function} onProgressUpdate - 进度变动回调 (percent)
 */
async function downloadImagesAsZip(imageList, zipFileName = 'images.zip', onProgressUpdate) {
  const zip = new JSZip();
  let downloadedCount = 0;

  // 1. 定义单个任务的处理函数:仅获取 Blob,不触发本地落盘
  const fetchImageBlob = async (item) => {
    const res = await fetch(item.url, { mode: 'cors' });
    if (!res.ok) throw new Error(`Fetch fail: ${item.url}`);
    const blob = await res.blob();
    // 写入 JSZip 虚拟文件树
    zip.file(item.name, blob);
  };

  // 2. 启用并发池调度,设置并发数为 4
  console.log('开始并发拉取图片...');
  await asyncPool(4, imageList, fetchImageBlob, (completed, total) => {
    downloadedCount = completed;
    const fetchProgress = Math.round((completed / total) * 70); // 前 70% 权重分配给下载
    if (onProgressUpdate) onProgressUpdate(fetchProgress);
  });

  // 3. 开始执行前端压缩生成
  console.log('图片拉取完成,正在生成压缩包...');
  const zipBlob = await zip.generateAsync(
    {
      type: 'blob',
      compression: 'DEFLATE',
      compressionOptions: { level: 6 } // 6 级压缩平衡速度与体积
    },
    (metadata) => {
      // 压缩进度占剩余 30% 权重
      const compressProgress = 70 + Math.round((metadata.percent / 100) * 30);
      if (onProgressUpdate) onProgressUpdate(compressProgress);
    }
  );

  // 4. 一次性触发下载
  const downloadUrl = window.URL.createObjectURL(zipBlob);
  const a = document.createElement('a');
  a.href = downloadUrl;
  a.download = zipFileName;
  document.body.appendChild(a);
  a.click();

  setTimeout(() => {
    document.body.removeChild(a);
    window.URL.revokeObjectURL(downloadUrl);
  }, 1000);

  console.log('批量打包下载完成!');
}
五、方案选型对比与决策依据
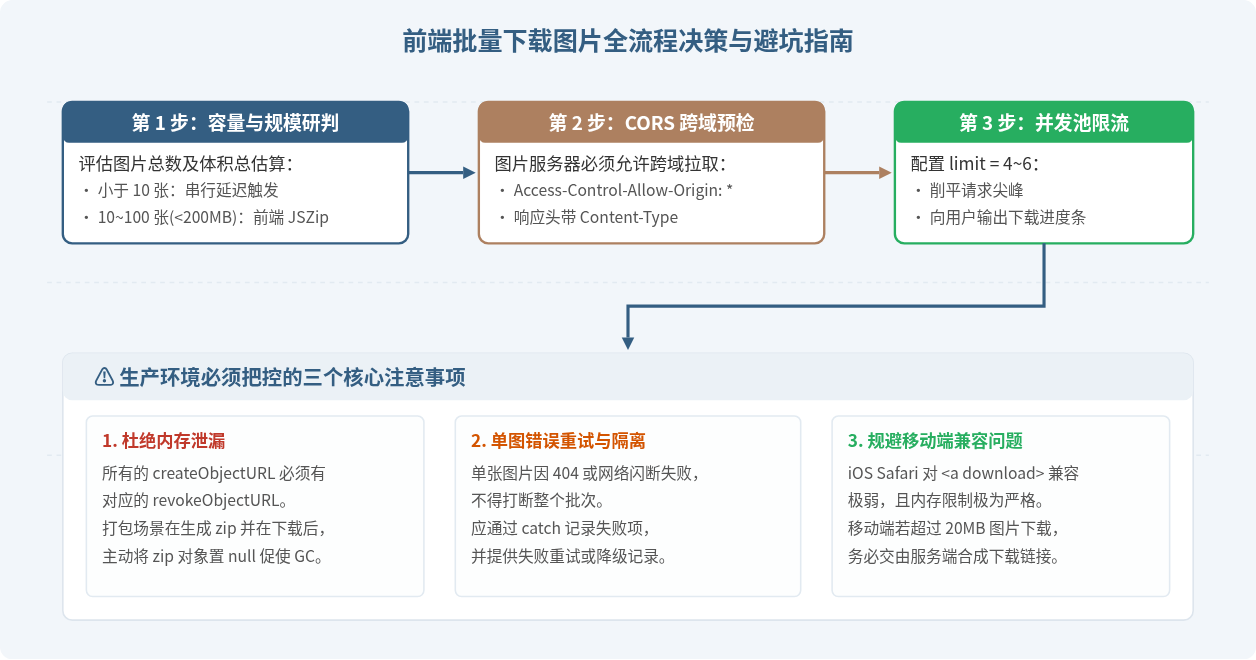
为了让不同规模的项目能够选用合适的技术方案,下面给出不同方案的关键指标对比:
| 对比维度 | 直接循环循环 a.click() | 受控并发 + 串行延迟触发 | 并发池 + JSZip 打包 | 后端异步打包 + OSS 预签名 |
|---|---|---|---|---|
| 适用数量 | <= 3 张 | 5 ~ 20 张 | 10 ~ 100 张 (总大小 < 200MB) | > 100 张 或 > 500MB |
| 网络吞吐 | 瞬间拥塞,易丢包超时 | 平稳可控 (恒定 4~6 连接) | 平稳可控 (恒定 4~6 连接) | 单连接极速拉取最终大包 |
| 用户交互体验 | 多次弹窗,极易被拦截 | 需等待多张逐一下载,目录零散 | 仅弹窗 1 次,整洁 zip 压缩包 | 后台异步通知,生成单个下载链接 |
| 前端内存占用 | 极高且无法预估 | 低(即下即清) | 中等(需容纳 zip 实例与 Blobs) | 极低(纯浏览器网络下载) |
| 实现复杂度 | 极低 | 中等 | 中等 | 较高(需后端服务与消息队列) |
六、生产级完整代码封装与异常重试机制
在实际网络环境中,偶尔会出现某张图片请求偶发性超时。如果在并发池中不进行错误捕获,整个 Promise.all 将直接中断失败。下面展示带有自动重试机制的生产级任务执行封装:
/**
 * 带有指数退避重试的 fetch 封装
 * @param {string} url - 请求地址
 * @param {number} maxRetries - 最大重试次数
 * @param {number} delay - 基础重试间隔(ms)
 */
async function fetchWithRetry(url, maxRetries = 2, delay = 500) {
  for (let attempt = 0; attempt <= maxRetries; attempt++) {
    try {
      const response = await fetch(url, { mode: 'cors' });
      if (!response.ok) {
        throw new Error(`HTTP ${response.status}`);
      }
      return await response.blob();
    } catch (err) {
      if (attempt === maxRetries) {
        console.error(`请求达到最大重试次数仍然失败: ${url}`);
        throw err;
      }
      // 指数退避等待重试
      await new Promise(resolve => setTimeout(resolve, delay * Math.pow(2, attempt)));
    }
  }
}
七、总结
在 JavaScript 中实现图片批量下载,不仅是简单的 DOM 接口调用,更是一项涉及网络并发规整、内存生命周期管理与用户体验优化的工程任务。核心总结如下:
- 拒绝无控循环:永远不要使用没有限流机制的循环直接调用
a.click()或Promise.all,这会触碰同源 6 连接限制并触发浏览器安全防御。 - 使用并发池削峰:通过手写或引入成熟的并发控制器(如
asyncPool),将并发通道数严格约束在 4 到 6 个,保证网络吞吐与内存平稳。 - 首选打包归档(JSZip):图片数量大于 5 张时,优先推荐在前端通过 JSZip 打包后单次触发保存,避免多弹窗轰炸和散落丢失。
- 及时清理对象引用:在任何涉及
URL.createObjectURL的场景,必须确保在下载触发后安全释放,避免长时间运行的 SPA 应用发生内存泄漏。
JS处理含Emoji或中文的字符串转数组乱码问题
2026-11-05 16:12:28
JS怎么使用展开运算符合并对象
2026-11-05 14:42:18
ES6+环境下判断JS对象为空的简洁写法
2026-11-05 12:12:23
怎么通过replacer函数自定义JS中JSON的格式化输出
2026-11-05 11:19:44
JS正则表达式基础:字面量与RegExp构造函数的区别及常用元字符
2026-11-05 11:16:58