

JavaScript正则表达式实例:表单验证与字符串匹配实战
深入浅出讲解JavaScript正则表达式在实际开发中的应用,涵盖常用表单验证规则、核心字符串匹配API对比、前瞻断言实战及性能避坑指南。
在前端交互与表单开发中,用户输入的不确定性常常直接威胁到系统的数据可用性与业务安全。正则表达式(Regular Expression)作为描述字符模式的严谨语法体系,是实现客户端格式验证、敏感信息过滤以及结构化文本提取的核心手段。本文围绕实际工程场景展开,系统拆解 JavaScript 中正则表达式的基础用法、核心匹配方法、表单校验实例与字符串匹配实战,帮助开发者建立稳固且高效的模式匹配逻辑。
一、核心选型:JavaScript 正则与字符串方法
JavaScript 提供了两类操作正则的接口:RegExp 实例方法与 String 原生方法。在执行不同业务逻辑时,必须根据具体目标(是判断真假、提取内容,还是整体替换)选择匹配开销最低的 API,避免误用导致性能下降或意外状态污染。
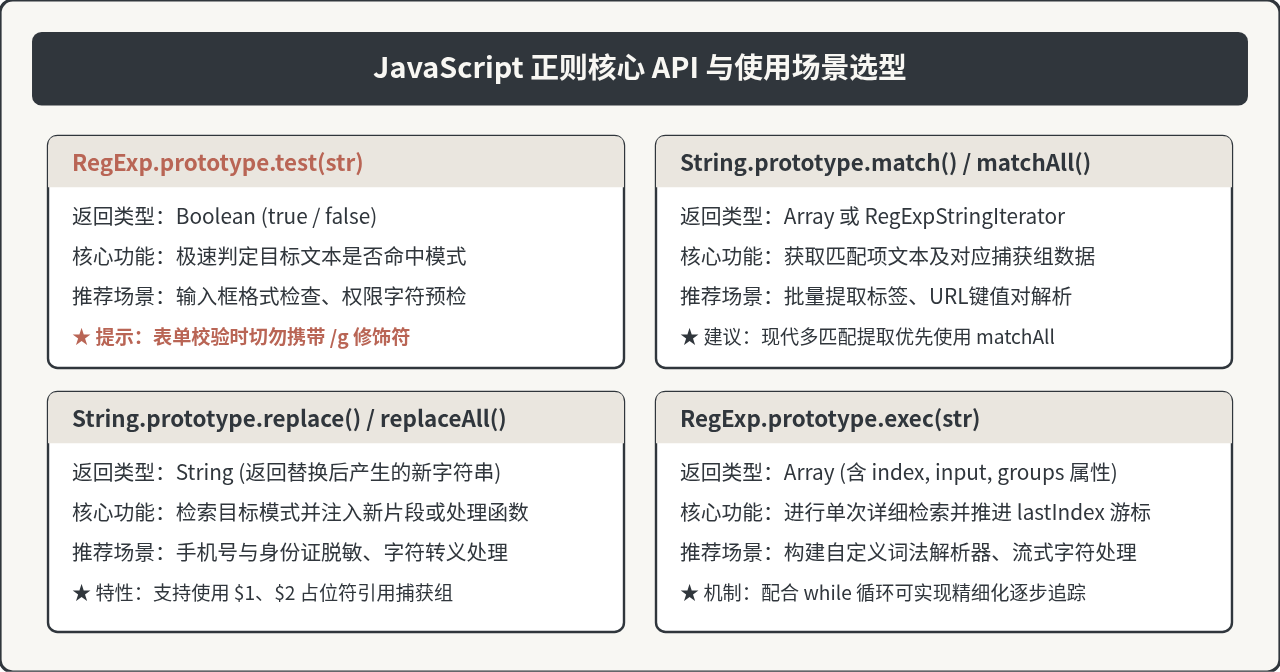
在表单验证业务中,90% 以上的场景仅需要判断输入合法性。因此,执行效率最高、内存消耗最小的方法是 RegExp.prototype.test()。该方法只返回布尔值,不会构造额外的匹配详情数组,是前端字段判空与格式合规校验的首选。
二、表单验证四大核心实例拆解
表单验证的核心在于“精准限定边界”与“穷举合法字符”,绝不能让未过滤的非法字符越过客户端防线。以下通过四个典型业务场景,剖析正则表达式的设计推导过程。
1. 手机号码验证(中国大陆 11 位)
中国大陆移动电话号码由 11 位数字组成。第一位固定为数字 1;第二位代表网络运营商号段,目前已开放 3 至 9 的全部数字;后 9 位则为任意十进制数字。
// 手机号码正则表达式
const phoneReg = /^1[3-9]\d{9}$/;

// 示例测试
console.log(phoneReg.test("13812345678")); // true
console.log(phoneReg.test("12812345678")); // false(第二位不合法)
console.log(phoneReg.test("138123456789")); // false(超过11位)
规则解析:
^与$:分别标记字符串的起始与结束。若缺少这两个边界符,输入abc13812345678xyz也会被判定为通过,造成严重安全漏洞。1[3-9]:锁定前两位,第一位必须为 1,第二位必须在 3 到 9 之间。\d{9}:\d等价于[0-9],花括号中的{9}精确限定重复 9 次。
2. 电子邮箱格式验证
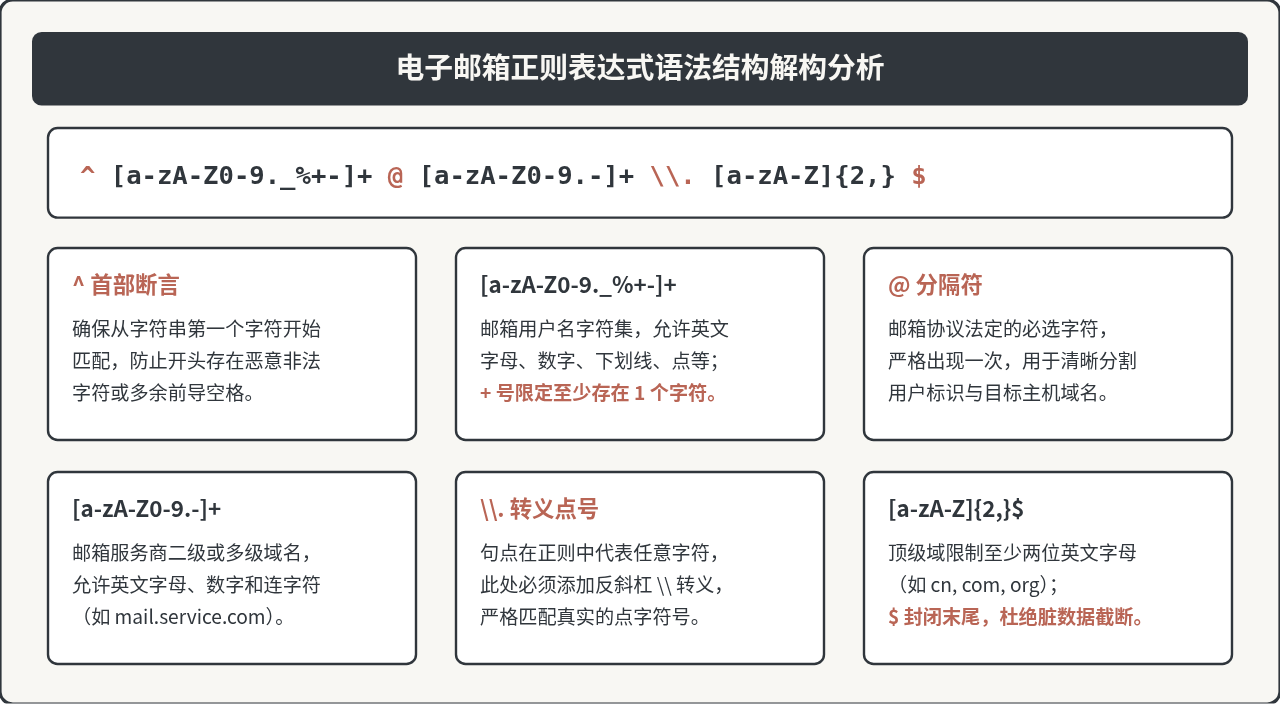
电子邮箱通常由“用户名”、“@ 符号”、“二级域名”及“顶级域名”构成。不同邮件服务商对特殊字符的容纳度有所差异,但基础通用规则具有高度一致性。
// 邮箱验证函数
function isValidEmail(email) {
  const emailReg = /^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$/;
  return emailReg.test(email.trim());
}

console.log(isValidEmail("user.name+tag@example.com")); // true
console.log(isValidEmail("user@example")); // false(缺少合法顶级域)
3. 强密码策略验证(正向先行断言)
安全等级较高的系统通常要求密码必须满足:长度在 8 到 20 位之间,且同时包含大写字母、小写字母、数字及特殊字符。许多初学者试图通过拆写多个子串来匹配,但利用正则表达式的“正向先行断言”(Lookahead Assertion (?=...))可以在单个表达式内以零字符消耗完成全套检查。
// 强密码验证正则
// 规则:8-20位,至少1个大写、1个小写、1个数字、1个特殊字符(@$!%*?&)
const strongPasswordReg = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[@$!%*?&])[A-Za-z\d@$!%*?&]{8,20}$/;

console.log(strongPasswordReg.test("Pass1234")); // false(缺少特殊字符)
console.log(strongPasswordReg.test("Password123!")); // true
原理解析:(?=.*[A-Z]) 是一种“零宽断言”。它在当前位置向前探测,只检查后续文本中是否至少包含一个大写字母,并不消耗字符串指针。多个前瞻按顺序排在开头,分别断言小写、大写、数字与特殊字符后,最后的 [A-Za-z\d@$!%*?&]{8,20}$ 才会真正对整个字符串的长度与字符合法集进行闭环匹配。
4. 纯中文字符与汉字姓名验证
在中文网站的个人实名资料录入中,常需对姓名做合规校验。根据 Unicode 标准编码,常用汉字的编码范围为 \u4e00 至 \u9fa5:
// 校验 2 至 8 位的中文姓名(允许生僻字常见分隔点 ·)
const chineseNameReg = /^[\u4e00-\u9fa5]{2,8}(?:·[\u4e00-\u9fa5]{2,8})*$/;

console.log(chineseNameReg.test("张三")); // true
console.log(chineseNameReg.test("买买提·阿不都")); // true
console.log(chineseNameReg.test("John")); // false
三、前端表单验证交互流程与工程化实践
在工程项目中,直接在提交事件里写 if (!reg.test(str)) 往往会导致用户体验割裂。高可用表单通常遵循“预处理 -> 边界测试 -> 状态分发”的三层流水线设计。
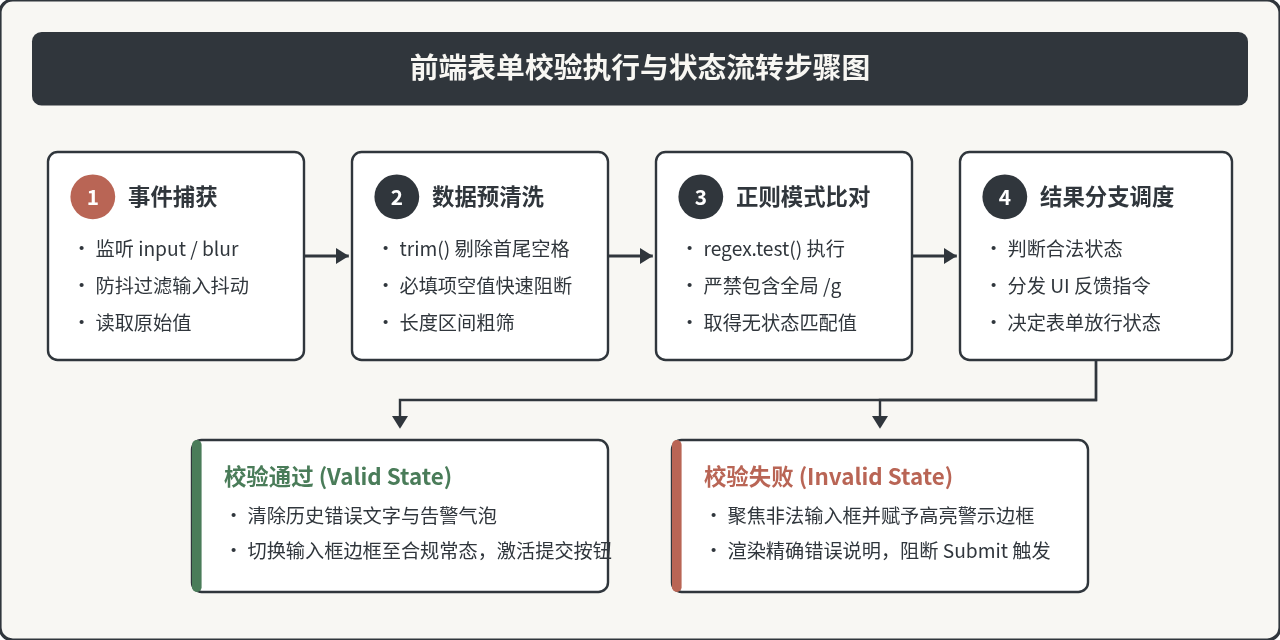
以下为一个可直接复用的通用表单字段验证器封装示例:
// 字段校验规则配置字典
const validators = {
  phone: {
    rule: /^1[3-9]\d{9}$/,
    message: "请输入正确的 11 位中国大陆手机号码"
  },
  email: {
    rule: /^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$/,
    message: "电子邮箱格式有误,示例:user@domain.com"
  }
};

// 校验执行入口
function validateField(type, value) {
  const cleanVal = (value || "").trim();
  if (!cleanVal) {
    return { valid: false, message: "该字段为必填项" };
  }
  const config = validators[type];
  if (!config) {
    return { valid: true, message: "" };
  }
  const isValid = config.rule.test(cleanVal);
  return {
    valid: isValid,
    message: isValid ? "" : config.message
  };
}
四、字符串匹配与内容处理实战
除了布尔判断,正则表达式在数据提取、清洗与字符掩码处理中同样扮演不可替代的角色。
1. 隐私数据脱敏(手机号与身份证掩码)
利用小括号 () 创建捕获组,并配合 String.prototype.replace() 中的反向引用符号 $1、$2,可以极具可读性地完成数据脱敏。
// 手机号码隐藏中间 4 位
function maskPhone(phone) {
  return phone.replace(/(\d{3})\d{4}(\d{4})/, "$1****$2");
}

console.log(maskPhone("13912345678")); // "139****5678"

// 身份证号码保留前 6 位与后 4 位,中间全部掩码
function maskIdCard(id) {
  return id.replace(/^(\d{6})\d+(\d{4})$/, "$1********$2");
}

console.log(maskIdCard("110101199003072345")); // "110101********2345"
2. URL 查询参数结构化提取
当页面需要从复杂的查询字符串(Query String)中抽离所有键值对时,使用 String.prototype.matchAll() 配合全局标志 /g 可以避免复杂的字符串手动分割:
function parseQuery(queryString) {
  const params = {};
  // 匹配所有形如 key=value 的键值对
  const queryReg = /([^?&=]+)=([^&=]*)/g;
  const matches = queryString.matchAll(queryReg);

  for (const match of matches) {
    const [, key, val] = match;
    params[decodeURIComponent(key)] = decodeURIComponent(val);
  }
  return params;
}

const url = "https://example.com/api?keyword=js%E6%AD%A3%E5%88%99&page=2&sort=desc";
console.log(parseQuery(url));
// 输出: { keyword: "js正则", page: "2", sort: "desc" }
如果对用于
test() 的正则表达式添加了 /g 标志,JavaScript 的正则引擎会在内部维护一个 lastIndex 属性。这意味着连续两次对同一个有效手机号调用 reg.test(),第二次调用会从上一次匹配成功的末尾继续往后找,直接导致返回 false!用于表单格式校验的正则表达式,严禁添加 /g 标志。
五、核心语法与实战规则速查总结
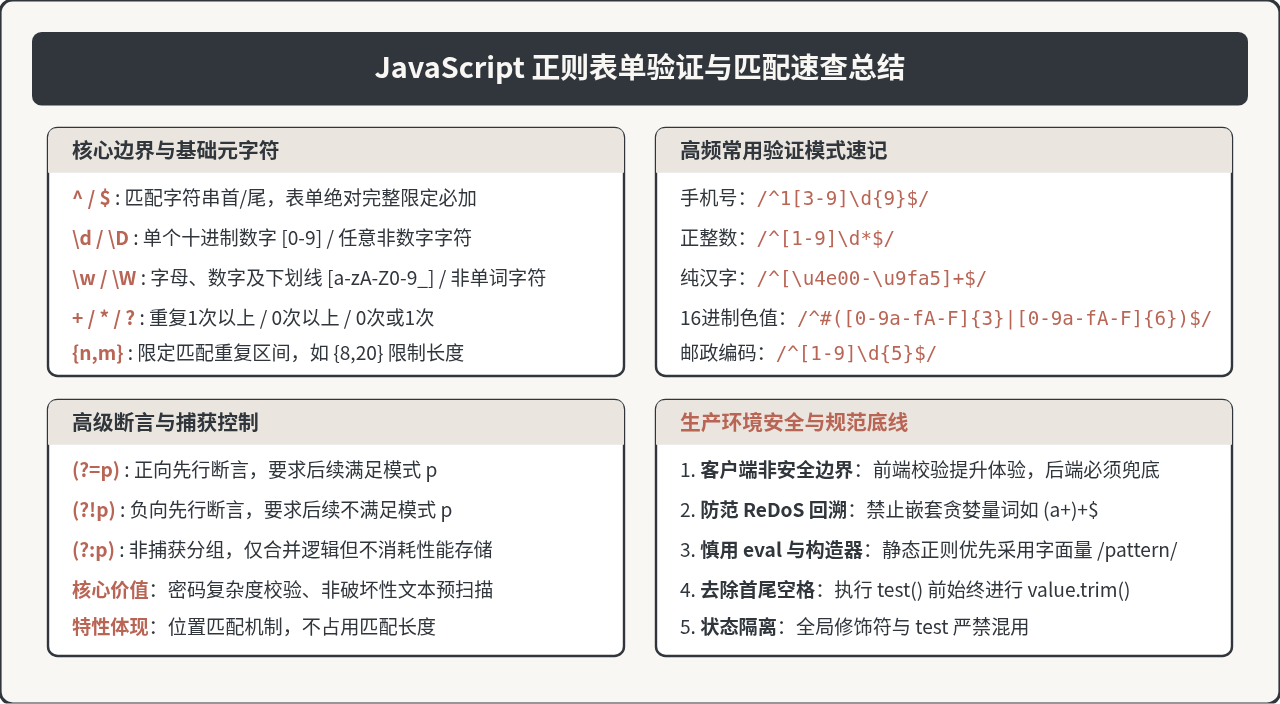
编写高质量正则表达式的关键在于掌握基本元字符、锚点以及前瞻逻辑的边界语义,并在开发过程中严格防范潜在的灾难性回溯(ReDoS)。
六、总结
正则表达式在 JavaScript 中兼具强大的模式表达能力与严谨的计算效率。在日常开发中:
- 明确场景选型:仅做格式校验时坚定选用
RegExp.prototype.test(),提取和解析时选用matchAll(),字符脱敏与替换时使用replace()。 - 始终锚定边界:表单输入校验必须同时具备开头
^与结尾$锚点,确保对用户输入做全文本校验,避免局部匹配带来的验证遗漏。 - 防御性编程思维:前端正则表达式的本质是“交互优化”而非“最终安全防线”。所有关键业务数据在到达服务端后,仍需执行严格的二次校验与清洗,前后端协同才能保障 Web 系统的稳定与健壮。
JavaScript入门书籍避坑:这些书不适合初学者
2026-11-05 16:31:15
JS使用Math.round实现保留两位小数的原理与代码
2026-11-05 15:35:55
JavaScript 原生 Date 对象怎么实现日期加减
2026-11-05 14:30:00
JavaScript函数定义的三种方式:声明、表达式与箭头函数
2026-11-05 13:50:55
JavaScript中escape、encodeURI和encodeURIComponent对空格的处理差异
2026-11-05 12:47:23







