JavaScript数组处理实例:去重、排序与常用遍历方法
本文系统讲解JavaScript数组在实际开发中最常见的三大处理需求:数组去重、排序及常用遍历方法的原理、具体代码实例与避坑指南。
假设我们正在开发一个后台管理系统,接口返回了一批带有重复项的用户操作日志列表。我们需要展示无重复的操作人员名单、按操作时间从近到远排序,并将原始数据提炼为包含姓名与简短状态的展示格式。这类需求在前端与Node.js开发中几乎每天都会遇到。处理这类场景的核心在于准确掌握JavaScript数组的去重逻辑、排序机制以及不同遍历方法的适用边界。
一、数组去重的常用方法与适用边界
数组去重的核心目标是剔除重复数据,保留唯一值。由于JavaScript中原始类型(数值、字符串等)与引用类型(对象、子数组)在相等性判断机制上的不同,去重方案需要按实际数据结构来选择。
1. 基础类型去重:Set 与扩展运算符
对于数值、字符串等原始类型组成的扁平数组,ES6提供的 Set 结构是最简洁高效的选择。Set 本身只允许存储唯一值,内部基于类似全等(Strict Equality,但认为 NaN 等于 NaN)的逻辑判断唯一性:
// 原始类型数组去重示例
const rawIds = [101, 102, 101, 105, 103, 102, 105];
const uniqueIds = [...new Set(rawIds)];

console.log("去重后的ID列表:", uniqueIds);
// 输出结果示例: [101, 102, 105, 103]注意:Set 无法直接对引用类型对象去重。例如 [{ id: 1 }, { id: 1 }] 中的两个对象在内存中地址不同,传入 Set 依然会被当成两个独立元素全部保留。
2. 对象数组去重:Map 映射与单次线性遍历
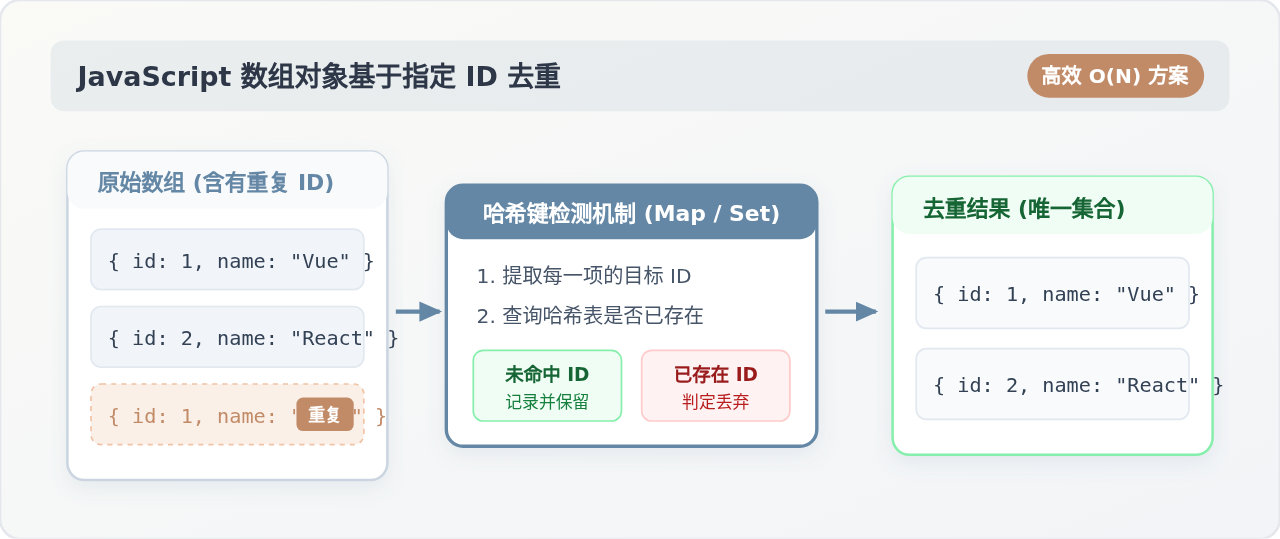
在业务中更常见的是根据某个唯一字段(如 id 或 orderNo)去除重复对象。此时可以借助 Map 以字段值作为键进行流式过滤,整体时间复杂度为 O(n):
// 对象数组根据属性去重示例
const users = [
  { id: 1, name: "张三", role: "管理员" },
  { id: 2, name: "李四", role: "运营" },
  { id: 1, name: "张三(重复提交)", role: "管理员" },
  { id: 3, name: "王五", role: "技术支持" }
];

function uniqueByField(list, key) {
  const seen = new Map();
  return list.filter(item => {
    const val = item[key];
    if (seen.has(val)) {
      return false;
    }
    seen.set(val, true);
    return true;
  });
}

const uniqueUsers = uniqueByField(users, "id");
console.log("去重后的用户列表:", uniqueUsers);
// 输出结果示例: 保留了 id 为 1(张三)、2、3 的前序对象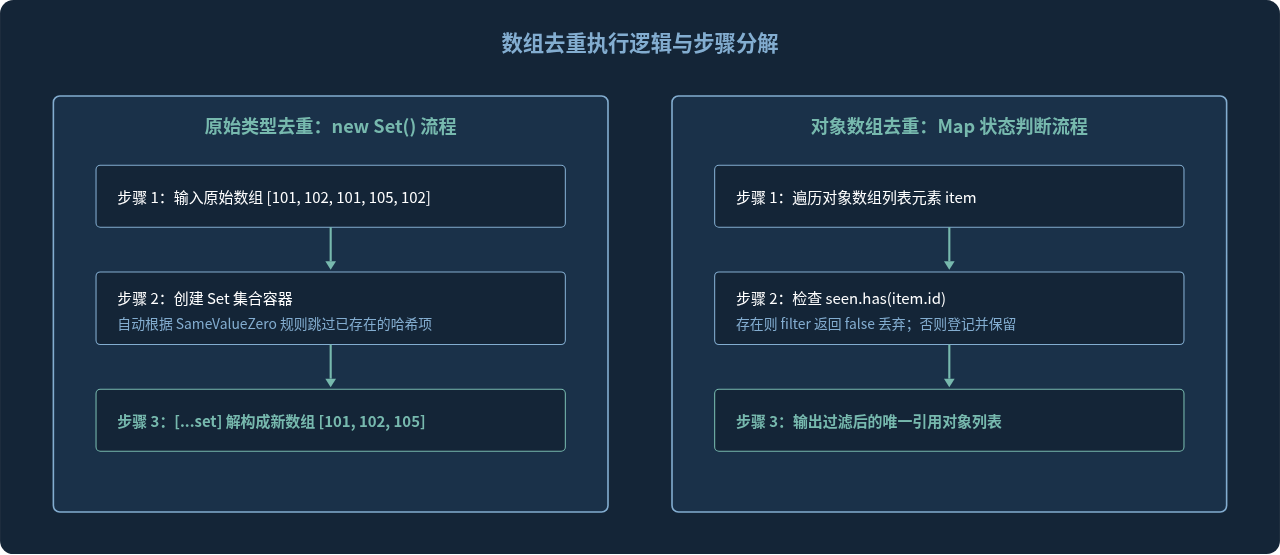
二、数组排序实战:sort() 机制与常见误区
JavaScript原生提供了 Array.prototype.sort() 方法,但直接调用 array.sort() 常常会导致让人意外的结果。理解其底层默认行为是正确排序的关键。
1. 默认字典序与数字比较函数
在不传任何参数时,sort() 会默认将所有元素先隐式转化为字符串,再按其 UTF-16 码元顺序排列。例如数字 [5, 20, 100, 15] 默认排序后会变成 [100, 15, 20, 5],因为字符 "1" 位于字符 "2" 和 "5" 前面。要实现数值升序或降序,必须显式传入比较函数 (a, b) => number:
// 数值排序标准示例
const scores = [5, 20, 100, 15, 8];

// 升序排列:a - b 小于0时 a 排在前面
const ascScores = [...scores].sort((a, b) => a - b);
console.log("升序结果:", ascScores); // [5, 8, 15, 20, 100]

// 降序排列:b - a 小于0时 b 排在前面
const descScores = [...scores].sort((a, b) => b - a);
console.log("降序结果:", descScores); // [100, 20, 15, 8, 5]
重要提醒:原地修改机制
sort() 是一个具有破坏性的就地(in-place)修改方法,调用后会直接变更原数组。如果需要保持原数组不可变,务必先浅拷贝一份(如使用 [...scores] 或 scores.slice())再执行排序。
2. 对象数组的多字段组合排序
在实际场景中,数据往往需要多级比较。例如先按部门升序排列,部门相同时再按员工工龄降序排列。我们可以通过在比较函数中组合条件来实现:
// 复合字段排序示例
const staff = [
  { name: "赵六", deptId: 2, tenure: 3 },
  { name: "孙七", deptId: 1, tenure: 5 },
  { name: "周八", deptId: 1, tenure: 2 },
  { name: "吴九", deptId: 2, tenure: 8 }
];

const sortedStaff = [...staff].sort((a, b) => {
  // 第一优先级:部门编号升序
  if (a.deptId !== b.deptId) {
    return a.deptId - b.deptId;
  }
  // 第二优先级:工龄降序
  return b.tenure - a.tenure;
});

console.log("复合排序结果:", sortedStaff);
// 结果示例:
// 1. 孙七 (dept: 1, tenure: 5)
// 2. 周八 (dept: 1, tenure: 2)
// 3. 吴九 (dept: 2, tenure: 8)
// 4. 赵六 (dept: 2, tenure: 3)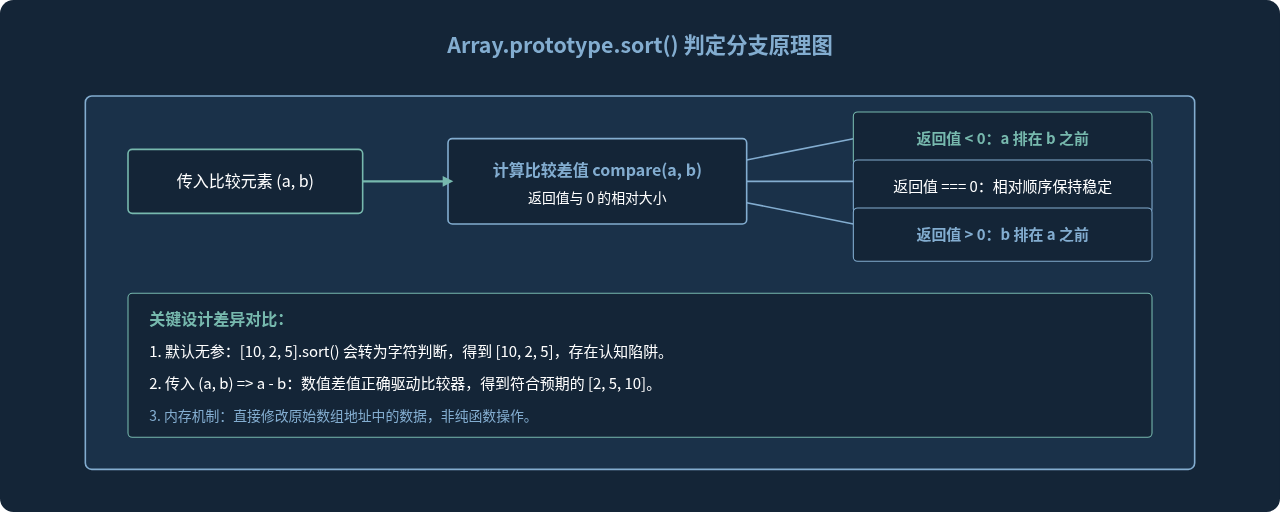
三、常用数组遍历方法对比与选型
JavaScript提供了多种迭代方法。许多初学者容易把 forEach、map、filter 混用,甚至在 map 内部产生大量副作用。选择正确的遍历方法不仅使代码语义更清晰,还能防止潜在的内存泄漏与意外bug。
1. 常用遍历方法的特性对比
- forEach(callback):用于产生纯副作用(如打印日志、触发网络请求、推送到外部数据结构),没有返回值(返回
undefined),不可被链式调用。 - map(callback):必须有返回值,将原数组每个元素一对一映射转换生成一个新数组,新数组长度严格等于原数组。
- filter(callback):断言过滤,回调函数返回布尔值。只保留返回
true的元素组成新数组。 - reduce(callback, initialValue):累加归纳,将数组汇总为一个最终值(如计算总和、构建复合字典、扁平化管道)。
- find / findIndex:检索符合条件的第一个元素或其索引,命中后立即终止后续查找,时间开销比过滤更低。
2. 典型实战示例:数据清洗与汇总管道
以下示例展示如何配合使用多种方法完成一个连贯的数据处理流程:过滤非活动项、计算折后金额并统计订单总额:
// 复合业务处理示例
const orderItems = [
  { id: "A01", price: 120, count: 2, isCanceled: false },
  { id: "A02", price: 350, count: 1, isCanceled: true },
  { id: "A03", price: 80, count: 4, isCanceled: false }
];

// 1. 过滤:只保留有效未取消订单
const activeItems = orderItems.filter(item => !item.isCanceled);

// 2. 映射:计算每项的小计金额
const itemsWithSubtotal = activeItems.map(item => ({
  ...item,
  subtotal: item.price * item.count
}));

// 3. 规约:计算总应付金额
const totalAmount = itemsWithSubtotal.reduce((acc, curr) => acc + curr.subtotal, 0);

console.log("有效项明细:", itemsWithSubtotal);
console.log("结算总额:", totalAmount); // (120*2) + (80*4) = 240 + 320 = 560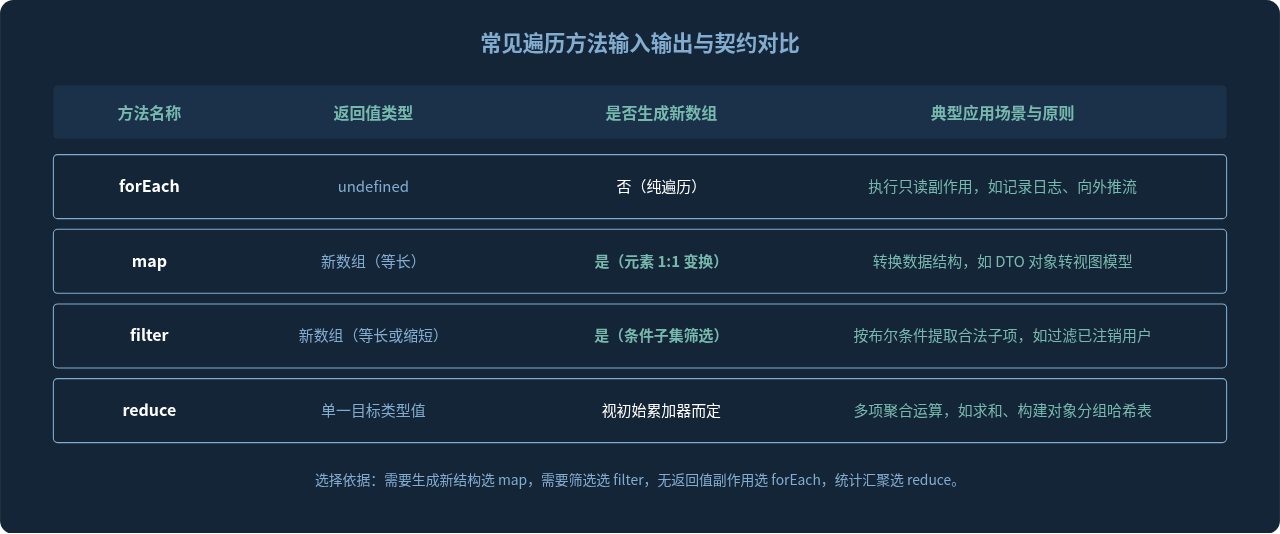
四、综合应用:全流程实战与总结
为了将去重、排序与遍历融会贯通,我们看一个完整的流水线任务:从原始接口的多个杂乱事件数据中,清洗出“唯一设备标识”、按最新上报时间排序,并最终生成前端可视化的摘要文本。
// 综合数据流处理示例
const rawTelemetry = [
  { deviceId: "DEV-02", timestamp: 1718002000, status: "online" },
  { deviceId: "DEV-01", timestamp: 1718001000, status: "offline" },
  { deviceId: "DEV-02", timestamp: 1718002500, status: "online" }, // 重复设备最新记录
  { deviceId: "DEV-03", timestamp: 1718000500, status: "error" },
  { deviceId: "DEV-01", timestamp: 1718000800, status: "offline" }
];

// 步骤 1:按时间从新到旧排序(确保去重时优先保留最新状态)
const sortedLogs = [...rawTelemetry].sort((a, b) => b.timestamp - a.timestamp);

// 步骤 2:利用 Map 按 deviceId 去重,自动保留排在前面的最新条目
const latestDeviceMap = new Map();
sortedLogs.forEach(item => {
  if (!latestDeviceMap.has(item.deviceId)) {
    latestDeviceMap.set(item.deviceId, item);
  }
});
const uniqueLatestList = Array.from(latestDeviceMap.values());

// 步骤 3:使用 map 进行数据格式化展示
const displaySummary = uniqueLatestList.map(dev => {
  const timeStr = new Date(dev.timestamp * 1000).toISOString().slice(11, 19);
  return `[${dev.deviceId}] 状态: ${dev.status.toUpperCase()} (更新于: ${timeStr})`;
});

console.log("最终清洗结果:");
displaySummary.forEach(line => console.log(line));
// 输出示例:
// [DEV-02] 状态: ONLINE (更新于: ...)
// [DEV-01] 状态: OFFLINE (更新于: ...)
// [DEV-03] 状态: ERROR (更新于: ...)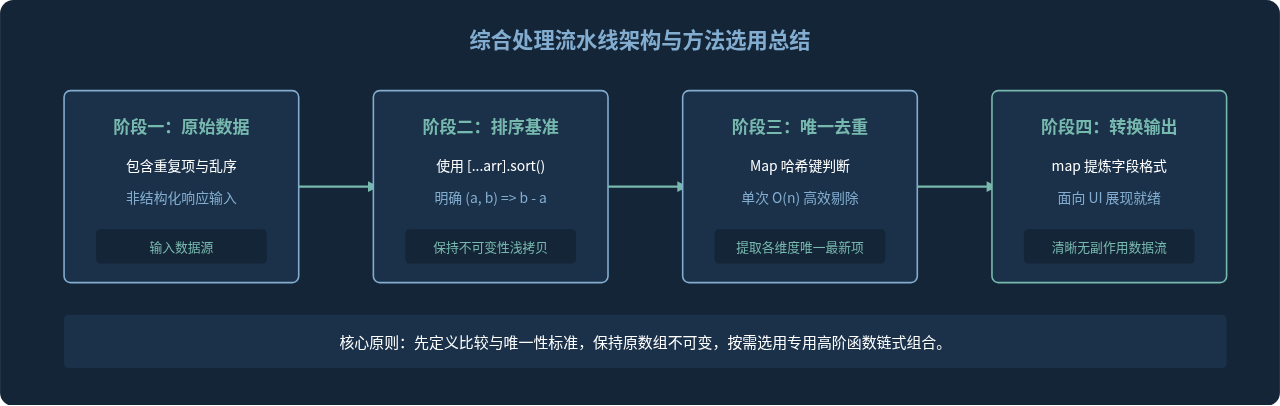
五、常见问题与注意事项
- 使用
includes/indexOf去重的性能损耗:在嵌套循环或filter内部反复调用includes会导致 O(n²) 的时间复杂度。当数组规模达到上万条时会出现明显卡顿,优先使用Set或Map保持 O(n) 复杂度。 sort()中的浮点数与减法溢出:使用(a, b) => a - b在大多数常规数值下表现良好;但若数值极大或包含Infinity,直接相减可能导致溢出。必要时可使用显式的if (a > b) return 1; if (a < b) return -1; return 0;进行严谨比较。forEach中无法直接break:forEach一旦开始无法中途跳出。若需要在满足条件时提前中断循环,应改用传统的for...of循环或使用some()/every()。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13