

JavaScript基本数据类型与引用类型在内存存储上的区别
深入解析JavaScript中基本数据类型与引用类型在栈内存与堆内存中的存储差异,包含赋值机制、参数传递、内存回收及核心架构图示。
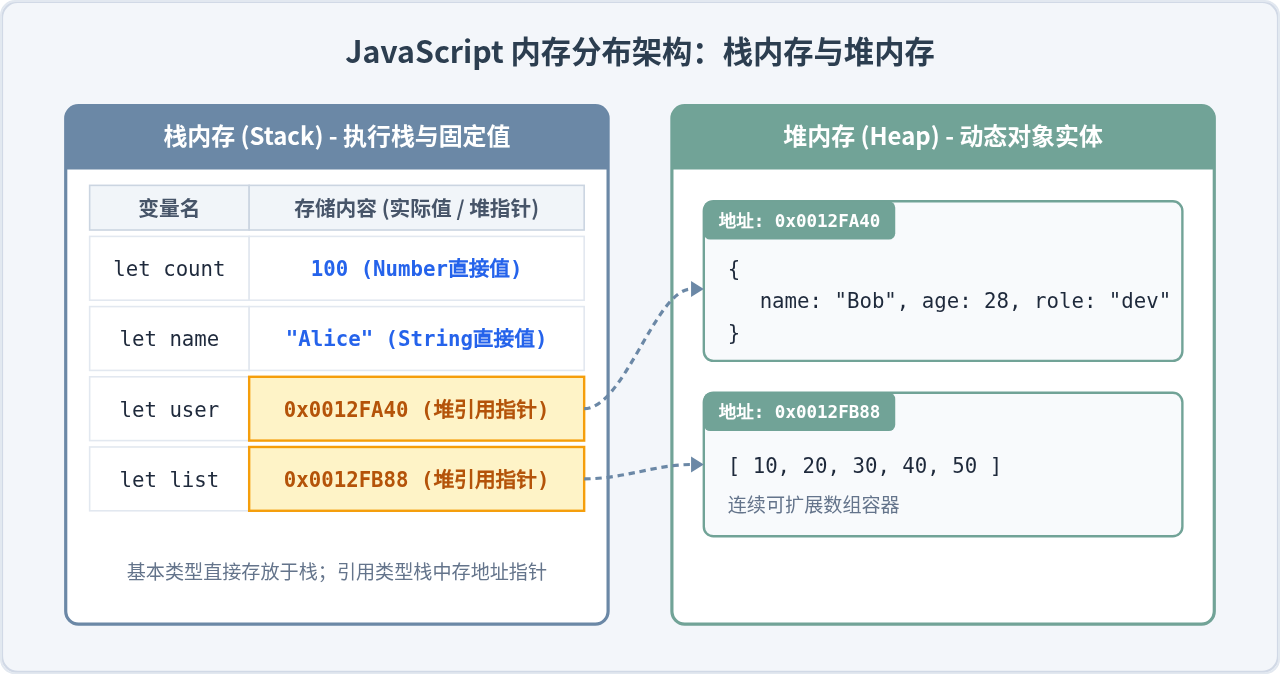
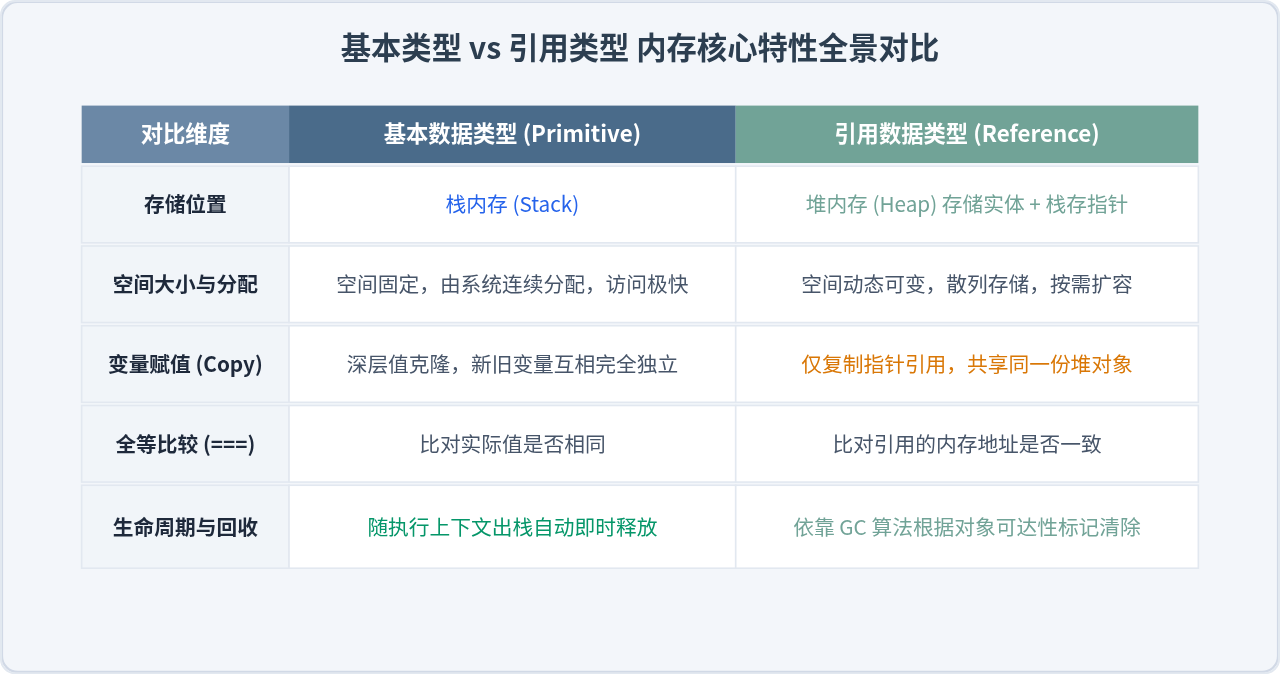
在 JavaScript 中,不同类型的变量在计算机内存中的存放方式存在本质差异:基本数据类型的值直接存储在操作速度极快的栈内存(Stack)中,而引用类型的实体对象存放在容量更大的堆内存(Heap)中,栈内存中仅仅保留指向该堆内存实体的地址指针。这一底层内存架构的分别,直接决定了变量在赋值复制、函数传参、等值比较以及垃圾回收时的所有外在行为表现。
一、两种类型与两个内存空间的对应关系
JavaScript 语言规范将数据划分为两大阵营:
- 基本数据类型(Primitive Types):包括
Number、String、Boolean、Undefined、Null、Symbol以及BigInt。它们的值具有确定且固定的大小,属于不可变值(Immutable)。 - 引用数据类型(Reference Types):主要是
Object及其衍生类型(如Array、Function、Date、RegExp等)。它们的内部结构可以动态扩展,所占内存大小无法在声明时完全固定。
现代 JavaScript 运行环境(如 V8 引擎)通常将内存主要划分为栈内存与堆内存:
- 栈内存(Stack):由系统自动按顺序分配和释放,呈现后进先出(LIFO)的连续内存结构。栈内存读写速度极高,专门用于记录当前执行上下文环境中的局部变量名及固定长度的数据。
- 堆内存(Heap):属于一片庞大且动态分配的无序内存空间。由于对象的大小和属性随时可能增删改变,系统将它们放置在堆内存中自由扩展,并通过一个固定长度的十六进制内存地址(引用地址/指针)与栈内存连接。
二、变量赋值与拷贝时的内部推导步骤
存储机制的差异最直观地反映在变量赋值时。当我们将一个变量赋值给另一个变量时,引擎的处理步骤完全不同:
1. 基本类型的赋值:完整值的物理副本
执行 let b = a 时,栈内存会开辟一段全新独立的栈空间给变量 b,并将变量 a 中的值原封不动拷贝一份存入。这两个变量在内存空间中完全解耦,后续修改 b 的任何操作,绝不会牵动 a。
let a = 10;
let b = a;   // 栈中为 b 新开辟空间,存入数字 10
b = 20;      // 仅修改 b 栈空间中的值
console.log(a); // 10(a 完全不受影响)
console.log(b); // 20
2. 引用类型的赋值:指针地址的共享
执行 let obj2 = obj1 时,栈内存同样会为 obj2 开辟一个新的栈槽位,但拷贝的并非堆内存中具体的对象,而是那串十六进制指针地址。结果是 obj1 和 obj2 同时指向堆内存中同一块物理区域。通过任何一个变量修改内部属性,另一个变量读取时都会发现数据已改变。
let obj1 = { score: 90 };
let obj2 = obj1; // 仅复制了指针 0x0012FA40 给 obj2
obj2.score = 100; // 顺着指针修改了堆中同一个对象的属性
console.log(obj1.score); // 100(被连带影响)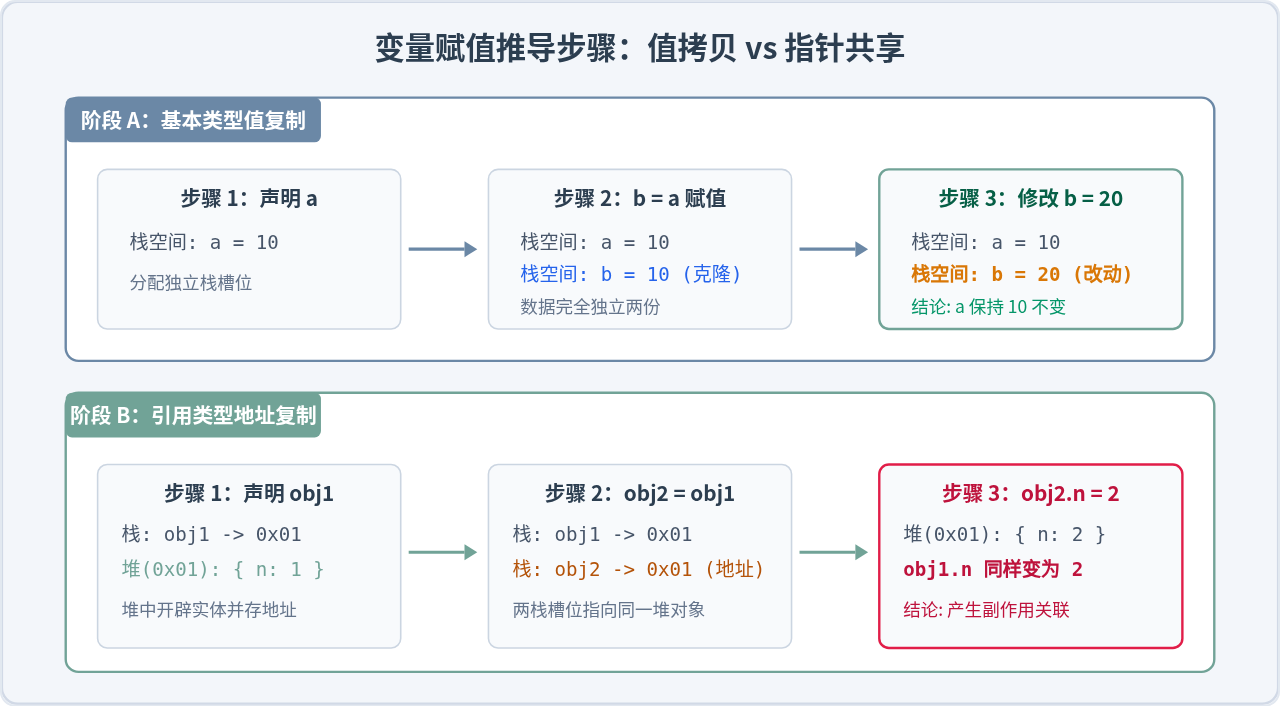
三、函数参数传递与比较运算的底层机制
1. 为什么“JavaScript 所有参数都是按值传递”?
很多开发者会产生误解,认为基本类型是“按值传递”,而对象是“按引用传递”。但从计算机底层视角来看,ECMAScript 规范明确规定所有函数的参数传递都是按值传递(Call by value):
- 传入基本类型时,形参在函数内部执行栈中分配新槽位,得到的是数值本身的拷贝。
- 传入引用类型时,形参在函数栈中得到的仍然是指针地址的拷贝。
区分这点的关键在于:“修改对象属性”与“重新对形参赋值”是两套完全不同的底层逻辑。
function test(item) {
  item.age = 30; // 顺着指针修改堆内存对象 -> 外部变量感知到改变
  item = { age: 99 }; // 形参在栈中的指针被改写指向新地址 -> 外部指针不受影响
}

let person = { age: 18 };
test(person);
console.log(person.age); // 输出 30,而不是 99!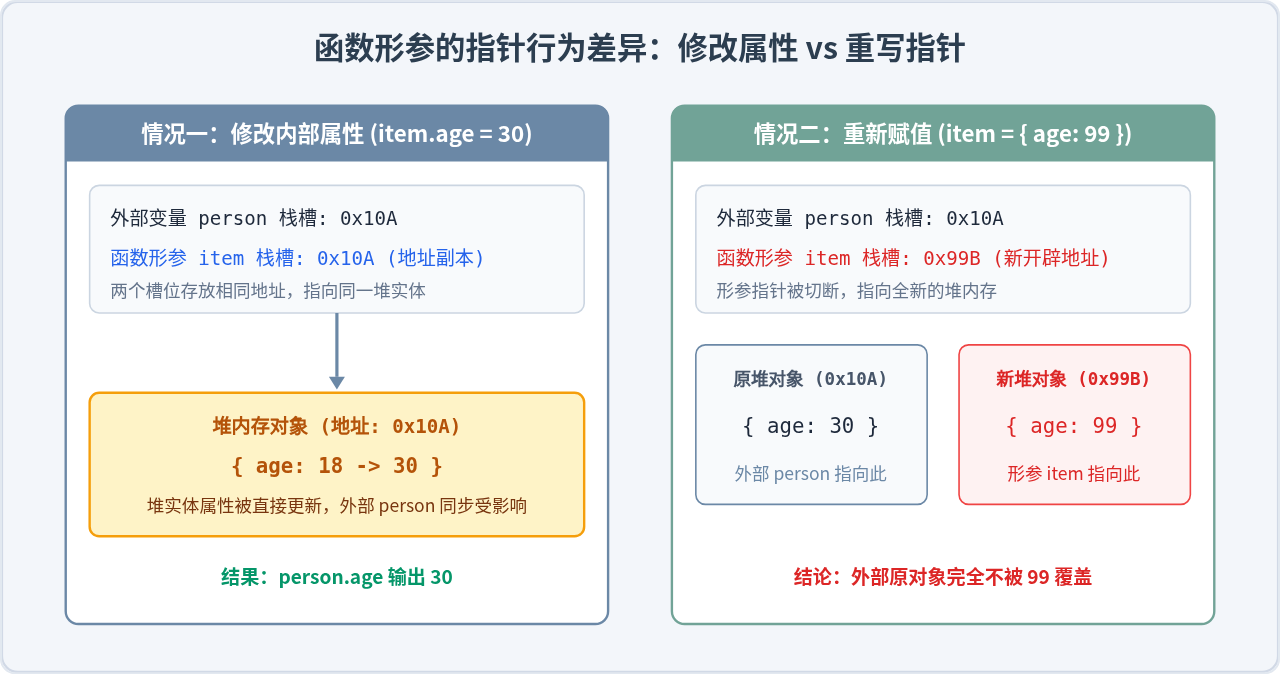
2. 比较运算时的逻辑差异
严格相等运算符 === 检验的永远是栈内存中存放的数据内容:
- 对于基本类型:比较的是字面量值是否完全相等。例如
10 === 10为true。 - 对于引用类型:比较的是两者的指针是否指向同一个内存地址。因此,即便两个对象内部的键值对一模一样,只要它们分别在堆中独立创建,比较结果依然是
false。
let objA = { x: 1 };
let objB = { x: 1 };
console.log(objA === objB); // false!因为堆地址 0x01 !== 0x02

let objC = objA;
console.log(objA === objC); // true!指向同一个堆地址 0x01
四、为什么需要将栈内存与堆内存分开?
许多初学者会问:为什么不把所有数据都直接塞在栈里,或者全部放进堆里?这关乎浏览器的运行性能与内存管理效率的平衡:
- 保障执行上下文的高性能压栈出栈:JavaScript 依赖单线程事件循环。函数调用形成调用栈,执行上下文需要快速创建与销毁。栈内存的连续排布和固定槽位使得 CPU 寻址效率极高。如果把大小动辄几百 KB 甚至变长增减的复杂对象强行塞入栈中,调用栈的移动和上下文切换开销将大幅增加,极易导致栈溢出(Stack Overflow)。
- 支持复杂数据结构的动态收缩扩展:对象与数组的属性数量在代码运行期间是不固定的(可以随意
push或新增属性)。堆内存提供了足够的自由度供引擎做动态分配与扩容。 - 垃圾回收(GC)策略的精准分工:
- 栈内存中的基本变量,随着函数执行完毕、上下文出栈而立即由系统自动回收,几乎零成本。
- 堆内存中的对象则需要通过垃圾回收器(如 V8 的标记清除算法与新生代/老生代代际假说)周期性扫描可达性(Reachability)。当没有任何栈指针或全局变量引用该堆地址时,GC 才会将这片堆空间标为垃圾并释放。
五、实践建议与避坑指南
在日常实际编码中,牢记内存模型的差异能帮助我们避免诸多常见缺陷:
- 防止意外的属性联动篡改:在组件传参、Vue/React 状态更新或配置传递时,如果需要保护原数据不被污染,不能使用简单的
const nextState = state,而应进行真正的深拷贝(如现代原生支持的structuredClone(state)或深拷贝函数)。 - 规避堆内存泄漏:堆内存中的数据只有在“不可达”时才会被垃圾回收。如果不慎将临时对象挂载到全局变量、闭包上下文、未解绑的 DOM 事件监听器或
setInterval中,堆内存会持续膨胀无法释放,最终导致页面卡顿甚至崩溃。
Three.js 渲染黑屏或模型不显示怎么排查?常见原因与解决步骤
2026-11-03 13:18:27
Auto.js官方下载地址在哪?GitHub与Gitee最新资源汇总
2026-11-03 11:44:14
CodePen、JSFiddle与Replit怎么选?JavaScript在线编程平台对比
2026-11-02 09:24:16
JS和Java有什么区别
2026-10-30 19:00:59
JavaScript编程用什么软件?新手首选VS Code及安装配置
2026-10-30 18:46:58







