JavaScript中IndexedDB的基本读写操作流程
详细讲解JavaScript中IndexedDB的基本读写操作流程,包括数据库连接、版本升级、创建对象仓库、只读与读写事务的开启,以及数据的添加、检索与更新步骤。
一、IndexedDB 核心概念与分层模型
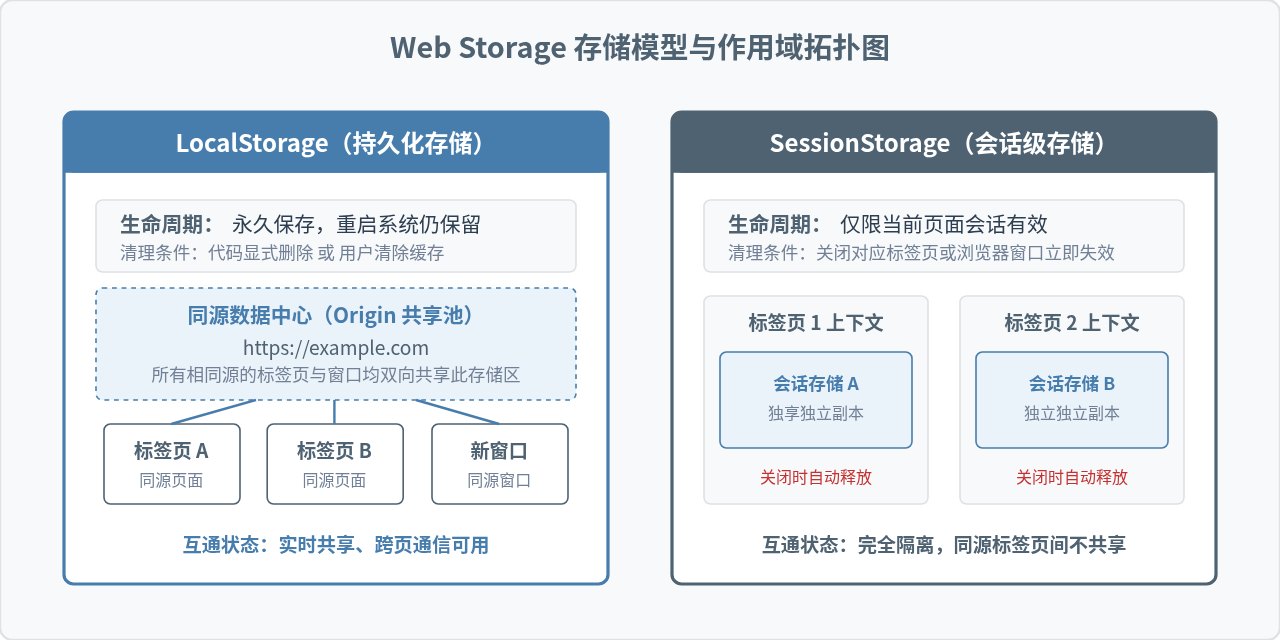
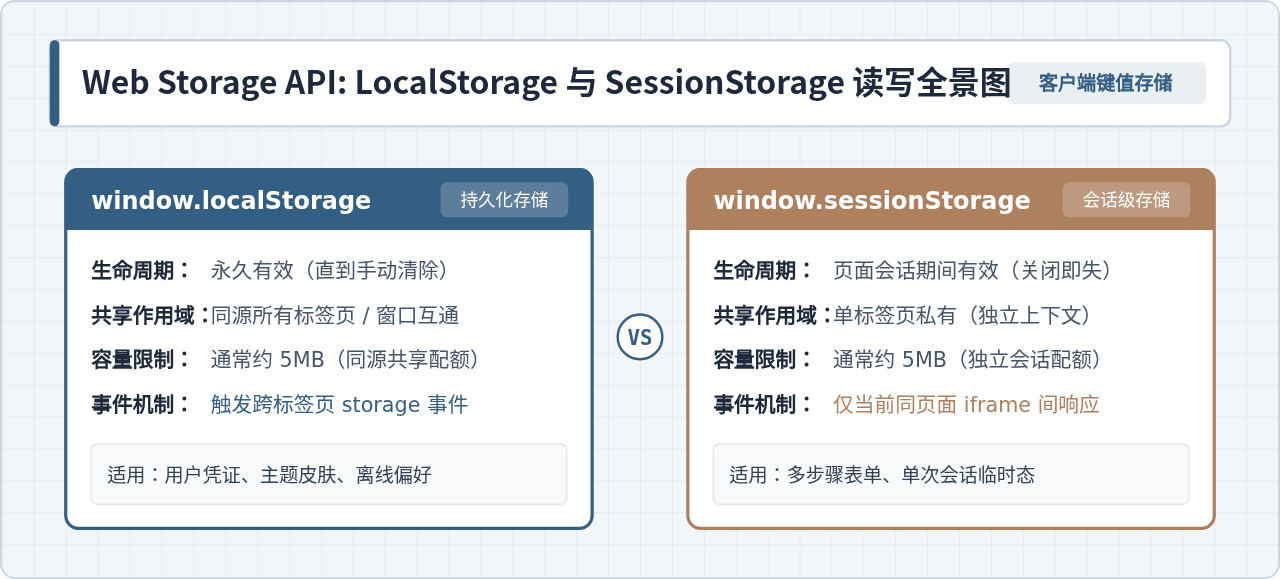
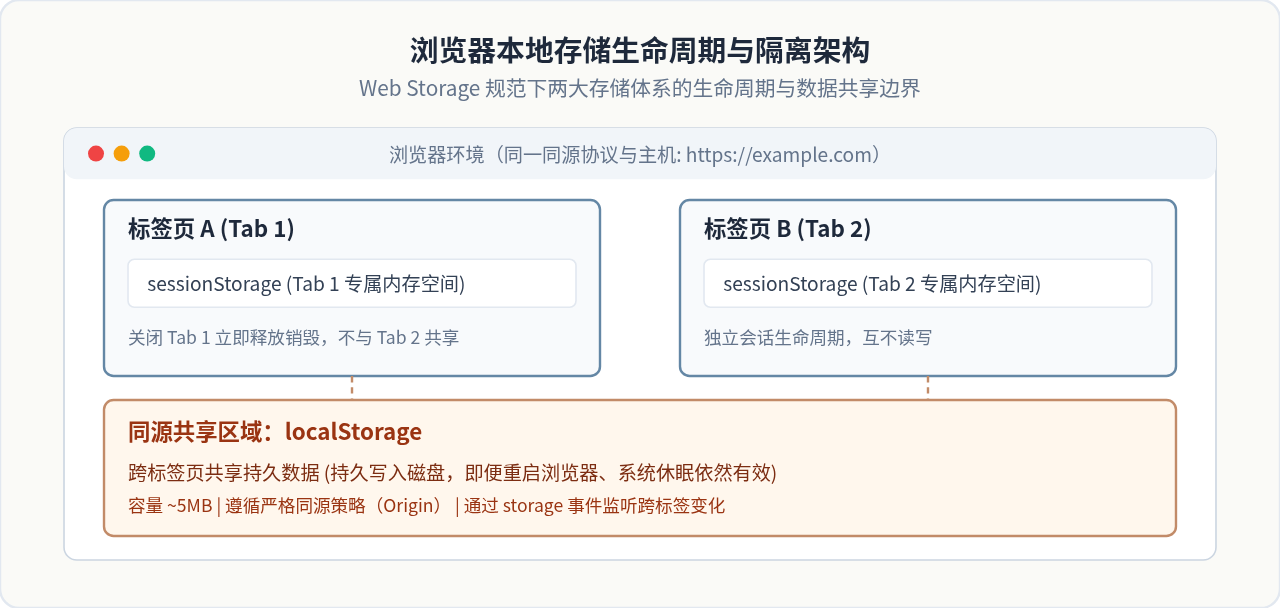
在开始编写读写代码前,必须建立对 IndexedDB 层级体系的清晰理解。与 localStorage 的纯键值对同步字符串存储不同,IndexedDB 是完全异步、事件驱动并基于事务控制的结构化存储机制。
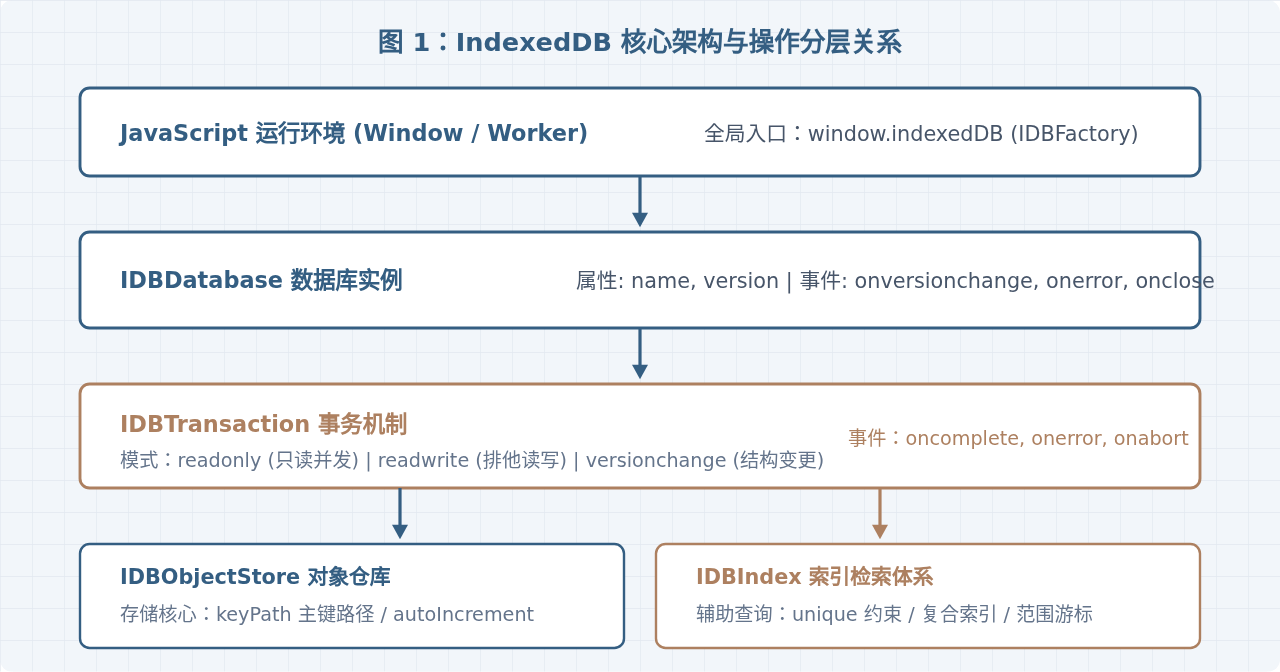
IndexedDB 的内部组织自顶向下分为四个核心层级:
- 数据库(Database): 数据的逻辑容器,由域名同源策略隔离。每个数据库拥有名称与整数版本号(Version)。
- 对象仓库(Object Store): 类似于关系型数据库中的“数据表”,用于存放具体的 JavaScript 对象、数组或基本数据类型。每条记录必须包含或自动生成一个键(Key)。
- 索引(Index): 建立在对象仓库特定属性上的检索结构,允许根据非主键字段快速检索数据记录。
- 事务(Transaction): 所有的读写操作必须包裹在事务中执行。事务保证了数据操作的隔离性与原子性,并在所有请求处理完毕后自动提交。
二、打开数据库与创建对象仓库(升级机制)
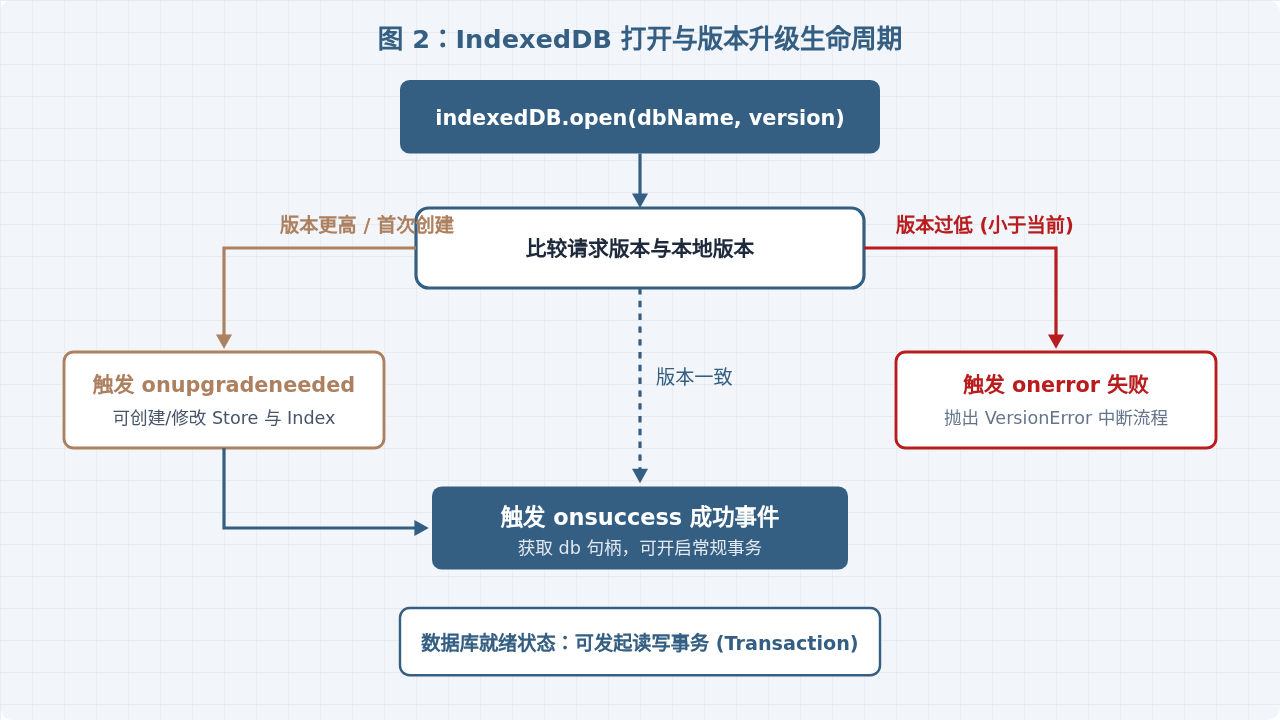
操作 IndexedDB 的第一步是建立连接。所有针对数据库表结构的更改(如新建或删除对象仓库、添加索引),都只能在版本升级事件 onupgradeneeded 的回调上下文中执行。
1. 数据库打开与版本比较逻辑
通过 window.indexedDB.open(dbName, version) 发起异步请求。浏览器会比较传入的 version 与当前本地已存在的版本号:
- 如果本地数据库尚不存在,或者传入的版本号大于本地当前版本,则触发
onupgradeneeded事件,随后触发onsuccess。 - 如果传入版本号与本地当前版本一致,直接触发
onsuccess。 - 如果传入版本号小于本地当前版本,会立即触发
onerror,抛出VersionError。
2. 建立连接与初始化代码示例
以下是创建或打开数据库的标准封装,包含了处理版本升级、创建主键对象仓库与索引的完整逻辑:
function openAppDatabase() {
  return new Promise((resolve, reject) => {
    const DB_NAME = 'UserStorageDB';
    const DB_VERSION = 1;

    // 发起连接请求
    const request = window.indexedDB.open(DB_NAME, DB_VERSION);

    // 仅在初次创建或版本递增时触发,专用于结构初始化
    request.onupgradeneeded = (event) => {
      const db = event.target.result;

      // 避免重复创建已存在的对象仓库
      if (!db.objectStoreNames.contains('users')) {
        // 创建对象仓库,指定 id 为内联主键
        const userStore = db.createObjectStore('users', {
          keyPath: 'id',
          autoIncrement: false
        });

        // 在 email 字段上建立唯一索引
        userStore.createIndex('idx_email', 'email', { unique: true });
        // 在 role 字段上建立非唯一索引
        userStore.createIndex('idx_role', 'role', { unique: false });
      }
    };

    // 打开成功,返回数据库实例
    request.onsuccess = (event) => {
      const db = event.target.result;
      resolve(db);
    };

    // 打开失败(如权限被拒、版本降级等)
    request.onerror = (event) => {
      reject(event.target.error);
    };
  });
}
三、数据写入流程(添加与更新)
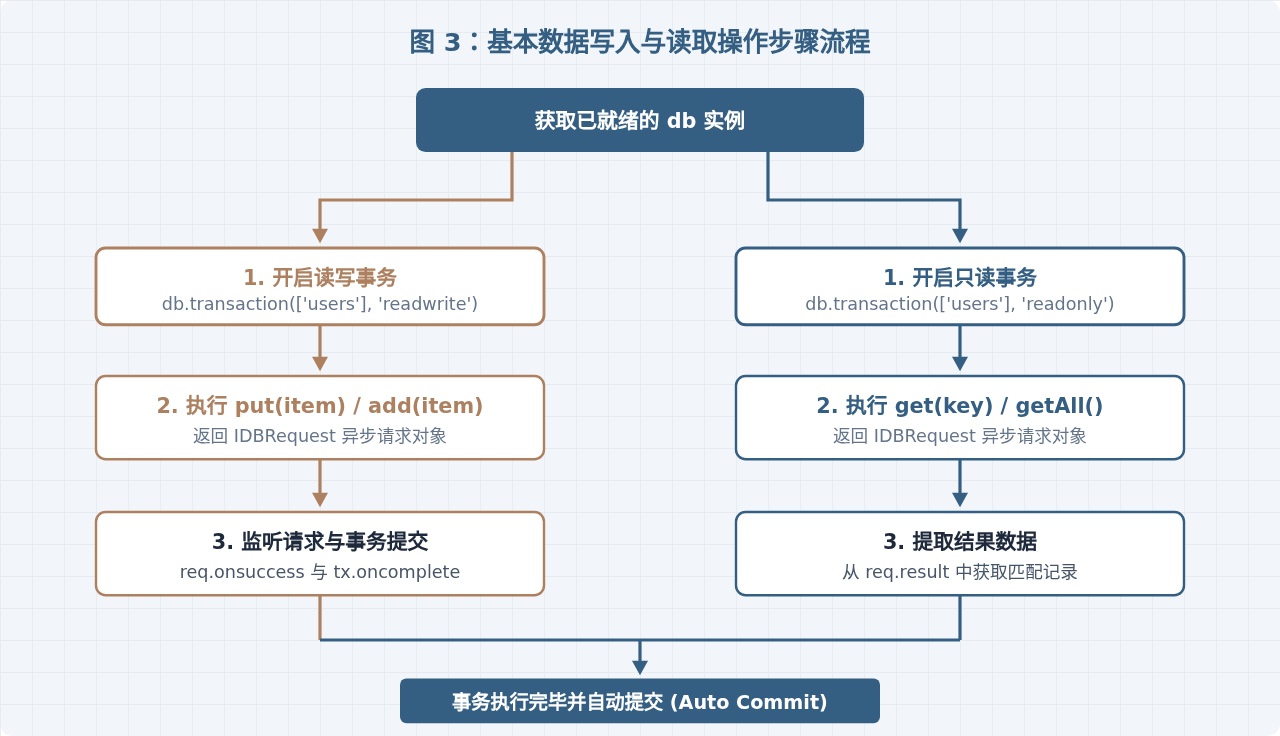
向对象仓库写入数据时,必须申请 readwrite(读写)模式的事务。写入主要依赖 add() 与 put() 两个方法:
add(data):仅在主键不存在时添加成功;如果已存在相同主键,会立即触发错误并抛出ConstraintError。put(data):更新或插入。如果主键已存在,则替换旧数据;如果不存在,则作为新记录插入。
写入操作标准实现
执行写入时,建议将事务和请求包装进 Promise,确保外部能够精准捕捉写入状态与异常:
function saveUserData(db, userItem) {
  return new Promise((resolve, reject) => {
    // 1. 开启读写事务,明确指定操作的目标对象仓库
    const transaction = db.transaction(['users'], 'readwrite');
    // 2. 获取对象仓库句柄
    const store = transaction.objectStore('users');

    // 3. 发起写入请求(使用 put 兼顾新增与更新)
    const request = store.put(userItem);

    // 请求单项成功
    request.onsuccess = (event) => {
      // event.target.result 返回当前保存记录的主键
      const recordKey = event.target.result;
    };

    // 4. 监听整个事务的完成与异常
    transaction.oncomplete = () => {
      // 事务已持久化到磁盘
      resolve(userItem);
    };

    transaction.onerror = (event) => {
      reject(event.target.error);
    };

    transaction.onabort = (event) => {
      reject(new Error('事务被意外中止'));
    };
  });
}request.onsuccess 会在单条数据放入缓冲区后触发,但只有 transaction.oncomplete 触发时,才代表数据已经安全提交到持久化底层。
四、数据读取流程(主键检索与索引查询)
数据读取使用 readonly 模式。只读事务并发性能高,不会锁定对象仓库阻止其他只读操作。读取方式通常分为三种:通过主键精确读取、通过索引检索以及范围游标遍历。
1. 通过主键读取记录
主键是对象仓库中唯一确定一条记录的标识,使用 store.get(key) 能够以最快速度检索:
function getUserById(db, userId) {
  return new Promise((resolve, reject) => {
    // 开启只读事务
    const transaction = db.transaction(['users'], 'readonly');
    const store = transaction.objectStore('users');

    // 提交读取请求
    const request = store.get(userId);

    request.onsuccess = (event) => {
      // 如果未找到记录,event.target.result 为 undefined
      const user = event.target.result;
      resolve(user || null);
    };

    request.onerror = (event) => {
      reject(event.target.error);
    };
  });
}
2. 通过索引字段检索记录
当查询条件不是主键(例如需要根据邮箱地址或角色查询)时,先从仓库取得索引对象,再调用其检索方法:
function getUserByEmail(db, email) {
  return new Promise((resolve, reject) => {
    const transaction = db.transaction(['users'], 'readonly');
    const store = transaction.objectStore('users');

    // 获取在 onupgradeneeded 中声明的索引
    const emailIndex = store.index('idx_email');
    const request = emailIndex.get(email);

    request.onsuccess = (event) => {
      resolve(event.target.result || null);
    };

    request.onerror = (event) => {
      reject(event.target.error);
    };
  });
}
3. 使用游标(Cursor)遍历多条数据
当需要按条件筛选或批量读取记录时,使用 openCursor() 可以在内存中逐条处理数据,避免一次性加载过大数据集导致主线程卡顿:
function getUsersByRole(db, targetRole) {
  return new Promise((resolve, reject) => {
    const transaction = db.transaction(['users'], 'readonly');
    const store = transaction.objectStore('users');
    const roleIndex = store.index('idx_role');

    const resultList = [];
    // 打开针对特定角色的游标
    const request = roleIndex.openCursor(IDBKeyRange.only(targetRole));

    request.onsuccess = (event) => {
      const cursor = event.target.result;
      if (cursor) {
        // 将当前指向的记录推进结果集
        resultList.push(cursor.value);
        // 步进到下一条记录,重新触发 onsuccess
        cursor.continue();
      } else {
        // 游标遍历结束
        resolve(resultList);
      }
    };

    request.onerror = (event) => {
      reject(event.target.error);
    };
  });
}
五、关键机制与常见避坑指南
在实际操作 IndexedDB 时,初学者往往会遇到事务提早关闭、键路径解析失败等问题。以下四个机制是保证代码健壮性的核心:
1. 事务的自动提交与微任务挂起
IndexedDB 事务具有**自动生命周期管理机制**。一旦在同一个事件循环(Event Loop)轮次中没有后续请求被挂上,事务就会自动尝试提交。如果在开启事务后插入了普通的异步操作(例如 fetch()、setTimeout()),事务在异步恢复前就会被自动关闭,抛出 TransactionInactiveError。
2. 主键(KeyPath)与自动递增
创建对象仓库时,如果指定了 keyPath(例如 id),写入的对象必须包含该属性。如果写入的对象缺少主键字段且未开启 autoIncrement: true,调用 add() 或 put() 将直接报错。
3. 错误事件的冒泡机制
IndexedDB 的错误事件具有冒泡特性:请求上的 onerror 若未被阻止冒泡(event.stopPropagation()),会逐级冒泡到事务(IDBTransaction),最后冒泡到数据库实例(IDBDatabase)。如果未在全局或事务级别捕获,未处理的异常会导致整个事务自动中止(Abort)并回滚数据。
六、总结
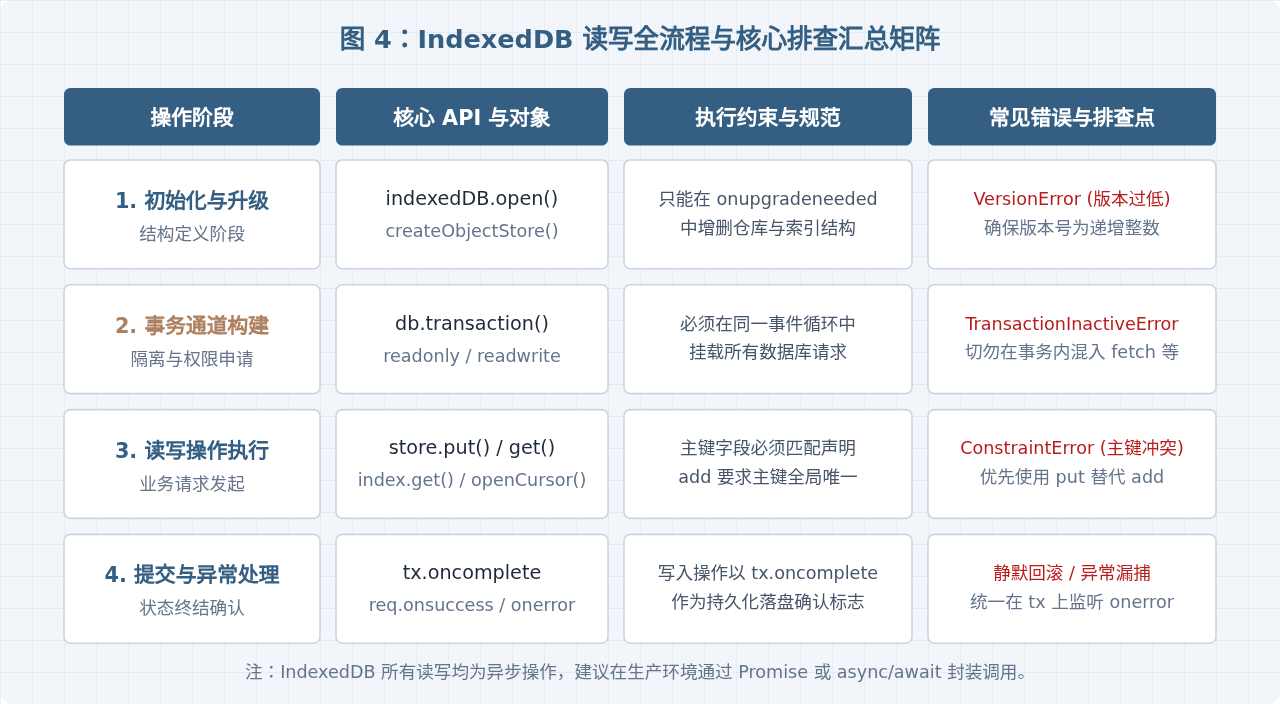
在 JavaScript 中使用 IndexedDB 进行基本读写,整体流程可以概括为四个稳定步骤:
- 建立连接与升级维护: 调用
indexedDB.open(),并在onupgradeneeded中统一定义对象仓库的主键与索引结构。 - 申请事务与获取仓库: 使用
db.transaction()明确声明只读(readonly)或读写(readwrite)权限,并通过transaction.objectStore()取得操作入口。 - 执行增删改查方法: 针对具体业务调用
put()、add()、get()或openCursor(),获得对应的请求对象。 - 处理事件与状态闭环: 监听请求的
onsuccess取得返回数据,监听事务的oncomplete确认写入提交,并做好onerror异常捕获。
掌握这套基于事务和请求的标准模式,便能在前端构建出高效、稳定且能承载海量离线数据的现代 Web 应用。
JavaScript 结合 HTML5 操作 SQLite 数据库的封装实现
2026-10-29 21:21:12
JavaScript 连接 Access 数据库完整实例
2026-10-29 13:04:39
MongoDB JavaScript脚本编程入门:MapReduce与代码复用
2026-10-28 09:39:05
深入理解JavaScript二进制数据处理:Blob、File与ArrayBuffer详解
2026-10-26 10:50:33
NodeJS读取分析Nginx错误日志的方法
2026-10-23 07:12:53
相关标签: