

前端全栈还是后端开发?JavaScript和Java的职业路径对学习深度的要求
深度剖析前端全栈与Java后端开发的职业路径差异,对比JavaScript全栈在端到端链路与工程化上的广纵交织,与Java后端在JVM、并发编程及分布式高可用上的深井下潜要求,帮助开发者根据学习深度特征理性规划技术路线。
一、核心判断:两种技术路径对“深度”的不同定义
在很多初学者的认知中,“全栈”常被误解为“学得浅但学得全”,而“专职后端”则被视作“天生技术门槛更高”。这种二元对立的判断并不符合现代工业级软件的实际研发要求。
深度从来不等于代码量的多寡,而是取决于系统出现非预期异常或面对极端负载时,工程师需要调动哪一层的底层知识来定位和解决问题。
- JavaScript前端全栈的深度:核心在于“上下文切换能力”与“跨环境链路感知”。一个合格的全栈开发者不仅要理解浏览器DOM渲染树的重排重绘,还需要掌握现代编译器(如Babel、SWC、Rollup)的抽象语法树转换,理解Node.js事件循环与Libuv线程池的调度差异,并在服务端渲染(SSR)中处理状态注水与脱水带来的内存泄漏隐患。
- Java后端开发的深度:核心在于“契约稳定性”、“高吞吐治理”与“极低容错率”。Java生态承载着金融、电信与企业级复杂业务的核心账本。其深度体现在对JVM内存屏障、垃圾回收器停顿时间(STW)控制、Java并发包(JUC)锁升级机制,以及MySQL InnoDB存储引擎中聚簇索引与事务隔离级别的精准把握。
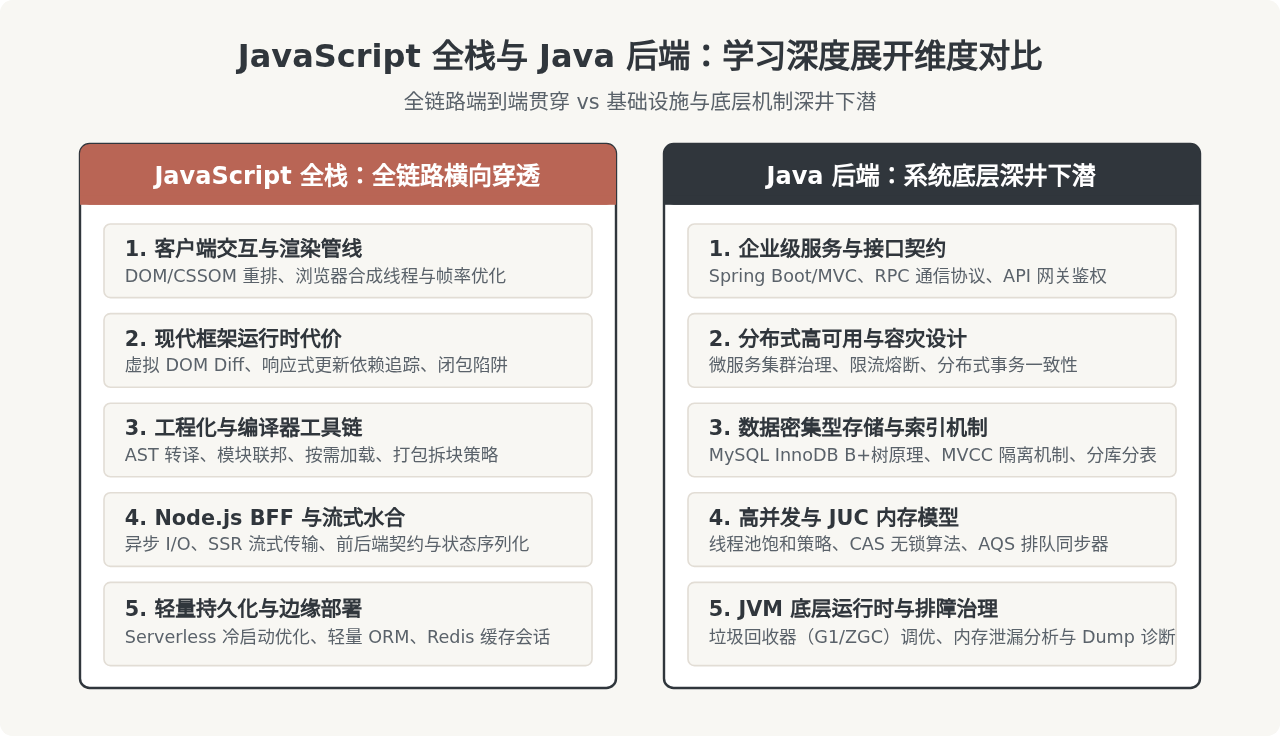
二、JavaScript 全栈的深度落脚点:全链路上下文与工程化穿透
很多学习者以为学完 React 或 Vue,再加上简单的 Express/NestJS 编写几个接口,就掌握了前端全栈。这种停留在 API 调用的认知,往往会在面对真实工程问题时迅速失效。
JavaScript 全栈的真正深度,体现在能够将浏览器运行机制、构建工具与服务端运行环境串联为一体:
1. 运行时与事件循环的差异理解
JavaScript 虽然在前后端采用相同语法,但宿主环境的底层机制截然不同。在浏览器中,事件循环服务于 UI 渲染帧(微任务、宏任务与 requestAnimationFrame 的执行顺序直接影响页面是否掉帧);而在 Node.js 环境中,事件循环由 Libuv 驱动,分为 Timers、Pending I/O、Poll、Check(setImmediate)、Close 几个严格阶段。全栈开发者必须清楚在服务端调用大量 CPU 密集型任务会直接阻塞 Poll 阶段,进而瘫痪整个服务的请求吞吐。
2. 前端工程化与抽象语法树(AST)
现代前端全栈项目几乎无法脱离复杂的工程化构建体系。深入理解构建工具并非仅仅是配置 Webpack 或 Vite,而是理解模块规范(CommonJS 与 ESM 的静态分析与动态执行差异)、Tree-shaking 的死代码消除原理,以及利用 AST 插件进行代码静态检查与代码注入。当构建耗时从 30 秒飙升到 10 分钟时,能否排查出依赖循环和递归转译瓶颈,正是深度的分水岭。
3. 服务端渲染(SSR)与状态注水(Hydration)
在 Next.js 或 Nuxt.js 构建的全栈应用中,组件代码会在服务端执行一次生成静态 HTML,再在客户端浏览器二次执行进行事件绑定(Hydration)。这要求开发者对变量作用域有极强的敏感性:一旦在模块全局作用域缓存了请求上下文信息,就会在并发请求下导致极其严重的用户数据交叉泄露;如果服务端与客户端渲染的 DOM 结构不一致,还会引发昂贵的客户端全量重新渲染。
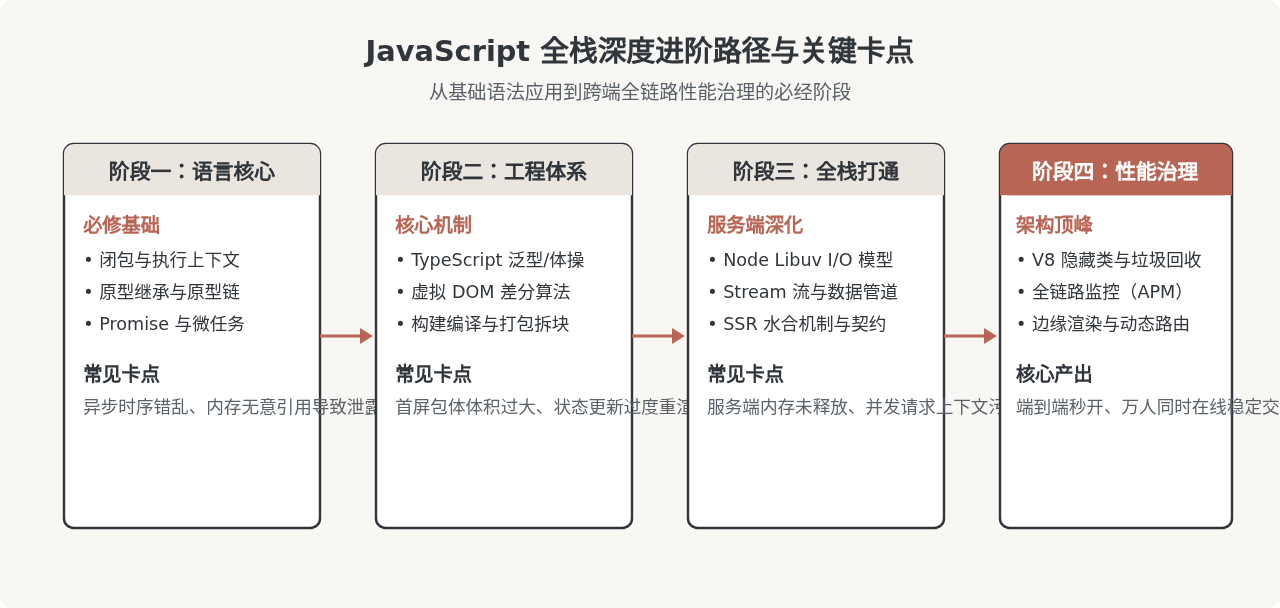
三、Java 后端开发的深度落脚点:系统可靠性与底层机制下潜
与 JavaScript 全栈追求“从前端界面到 BFF 接口的无缝闭环”不同,Java 后端的学习曲线呈现出典型的“陡峭下沉”特征。在企业级开发中,业务逻辑代码本身的编写通常只占开发精力的一小部分,更多精力花在保证系统的并发安全性、数据持久一致性以及高负载下的稳定性。
1. JVM 运行时与排障能力
Java 的跨平台与自动内存管理极大提升了生产力,但也将底层机制封装在了 JVM 之中。当线上系统突然发生 Full GC 导致系统停顿数秒,或者服务器内存溢出(OOM)崩溃时,不能指望通过查看业务日志解决问题。深入的 Java 开发者必须掌握:
- 内存布局分配:堆内存(新生代 Eden、Survivor 区与老年代)与非堆内存(元空间、直接内存)的流转与晋升判定。
- 垃圾收集算法演进:CMS 的标记清除碎片缺陷、G1 的 Region 分区与停顿预测模型,以及 ZGC 的着色指针与读屏障技术。
- 实战排障手段:能够熟练使用 jstat 观察 GC 频率,使用 jstack 定位死锁或高 CPU 线程,并在生产环境中导出与解析 Heap Dump 文件。
2. 并发编程与 Java 内存模型(JMM)
多线程并发是 Java 技术栈深度的一大试金石。初学者容易停留在 synchronized 关键字的表面用法,而深入学习要求理解:
- CPU 多级缓存与 JMM 的
happens-before原则、指令重排与内存可见性。 - J.U.C(java.util.concurrent)核心组件的基石:抽象队列同步器(AQS)的状态设计与双向链表排队机制。
- 线程池的核心参数(corePoolSize, maximumPoolSize, workQueue, rejectHandler)在生产环境下的边界配置,防止因使用无界队列导致物理内存耗尽。
3. 关系型数据库与存储引擎机制
在大型业务系统中,性能瓶颈往往首先出现在数据库层。Java 开发者对深度的要求必然包含对 MySQL 等存储引擎的深刻理解。这包括 InnoDB 为什么使用 B+ 树作为索引结构而不是红黑树或哈希表、聚簇索引与二级索引的回表开销、覆盖索引设计、事务在 MVCC 机制下的多版本一致性读实现,以及行锁在 Next-Key Lock 模式下防止幻读的具体范围判定。
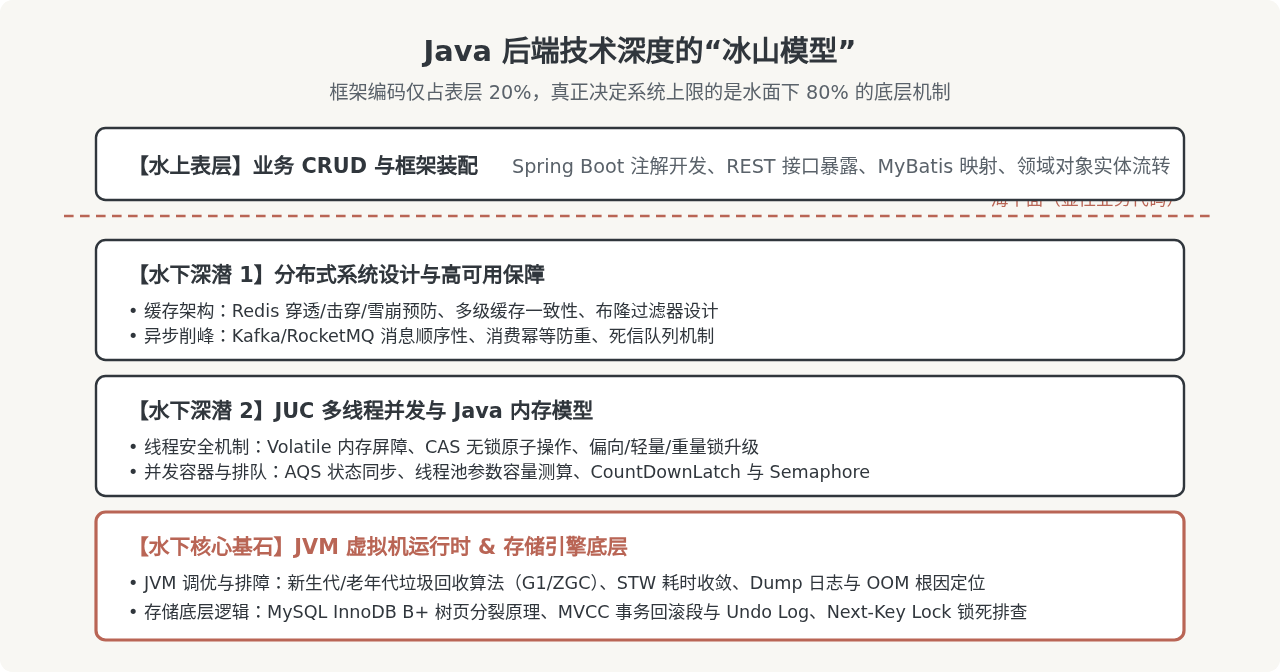
四、业务场景匹配度与工程特征对照
为了更清晰地评估两者的学习深度要求,下表从工程实践与职业发展的各个关键维度进行了横向对照:
| 比较维度 | JavaScript 全栈开发 | Java 后端开发 |
|---|---|---|
| 技术深度形态 | T 型 / 链路穿透型:前端交互、渲染优化、BFF 接口与部署端到端打通 | I 型 / 深井下潜型:在服务稳定性、并发模型、JVM 与数据库机制上深度钻研 |
| 学习反馈周期 | 短反馈:界面改动立即可见,产品交互容易获得直观的正向激励 | 长反馈:多为无界面的数据流、逻辑测试与性能指标,反馈更偏抽象 |
| 生态更新频率 | 极高:构建工具、渲染架构(CSR/SSR/RSC)和库几乎每两年发生显著演变 | 稳定:核心语法与 Spring 生态演进节奏可预期,沉淀的底层知识保值期极长 |
| 工程容错率 | 相对宽松:客户端偶发脚本异常可通过前端热修复或局部重试弥补 | 极度严苛:事务失败或死锁可能导致资金对账不平或核心业务大面积瘫痪 |
| 核心突破卡点 | 全链路状态一致性、浏览器底层机制、打包与性能调优 | JVM 内存排障、高并发锁竞争、分布式事务与海量数据索引调优 |
| 适配企业形态 | 初创团队、SaaS 产品、出海独立项目、互联网中台敏捷验证组 | 中大型互联网大厂、金融证券、智能制造、政企电信核心业务系统 |
五、决策路径与实践建议
面对技术路径的选择,开发者不应根据“哪个名头更响亮”做决定,而应根据自身的思维方式偏好、当前知识储备以及目标就业市场来综合判断。
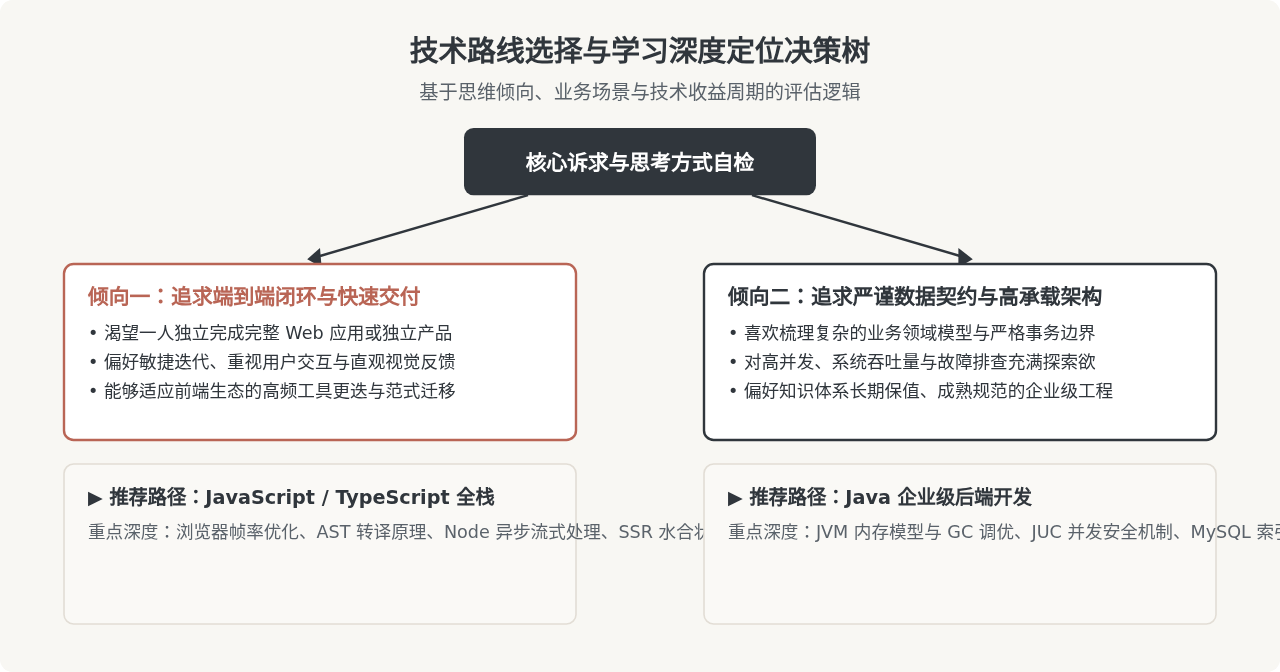
1. 警惕全栈变成“全都会,全都不精”:选择 JavaScript 全栈路线绝不是为了逃避对底层原理的学习。如果在简历中罗列了十几种框架,却无法解释 V8 的垃圾回收过程,或者不知道如何排查 Node.js 内存泄漏,那么在面对中高级技术评审时会非常脆弱。
2. 警惕 Java 沦为“注解粘贴工程师”:Spring 框架高度成熟的依赖注入机制让业务开发变得极其便利,但过早沉浸在业务胶水代码中会让人丧失对底层知识的敏感度。遇到慢 SQL 仅会加索引、遇到并发只知道加全局锁,都说明缺乏对 JUC 和存储引擎底层的实际钻研。
六、总结
无论是选择 JavaScript 全栈还是 Java 后端,技术进阶的本质都是将表面语法转化为对底层运行规律的掌控。
如果选择 JavaScript 全栈,请把学习的深度扎根在端到端全链路的贯通与极致的用户交互体验上,用严密的工程化治理化解生态快速迭代的复杂度;如果选择 Java 后端,请把学习的深度沉淀在高可靠、强一致与复杂分布式的底座上,用对底层的透彻理解保障大规模生产系统的稳定运行。看清两条路径对深度的不同要求,根据自身长板专注深耕,才能在长期的职业发展中建立真正不可替代的核心竞争力。
在 NestJS 中使用管道验证数据与守卫控制访问权限
2026-11-05 12:43:41
Node.js后端生成高强度随机字符串的方法
2026-11-04 16:29:54
Node.js环境中怎么使用axios或http模块发送GET请求
2026-11-03 21:57:15
Node.js环境下怎么实现JS反混淆自动化?常用库与CLI工具推荐
2026-11-03 21:15:54
解决JS逆向常见报错:缺少DOM环境导致代码运行失败
2026-11-03 20:41:59







