

JS实现高性能关键词匹配:基于字典树与哈希表原理
本文介绍在JavaScript中利用字典树(Trie)结构实现高效关键词匹配的方法。通过预构建哈希表形式的树结构,避免多次正则或indexOf调用带来的性能损耗。结合哈希表底层原理分析,探讨如何利用对象属性访问特性提升匹配速度,并对多关键词匹配场景下的算法优化策略进行简要探讨。
关键词匹配需求与字典树结构
在论坛和聊天室等场景中,为了保障用户体验,通常需要屏蔽大量不良词汇。对于单个关键词的查找,使用indexOf或正则表达式效率较高。然而,当关键词数量较多时,对长文本反复调用这些方法会导致巨大的性能开销。由于目标字符串通常体积较大,必须保证仅通过一次遍历即可得出结果。基于此需求,自然想到对全文字符依次匹配的方式。例如,对于文本“Mike Jordan had said "Just do IT", so Mark has been a coder.”,若关键词为“Mike”和“Mark”,则遍历整句,当遇到“M”时,继续检查后续字符是否能匹配“i”或“a”,若能一直匹配至关键词末尾,则视为成功匹配,否则继续遍历。此时,关键词的数据结构应如下所示:
var keywords = {
 M: {
 i: {
  k: {
  e: {end: true}
  }
 },
 a: {
  r: {
  k: {end: true}
  }
 }
 }
}
由上述分析可知,该数据结构本质上是一棵树。虽然根据关键词组构建这棵树较为耗时,但关键词通常是预先给定的,因此可以在匹配前预先创建该数据结构。具体实现代码如下:
function buildTree(keywords) {
 var tblCur = {},
 key, str_key, Length, j, i;
 var tblRoot = tblCur;

 for(j = keywords.length - 1; j >= 0; j -= 1) {
 str_key = keywords[j];
 Length = str_key.length;
 for(i = 0; i < Length; i += 1) {
  key = str_key.charAt(i);
  if(tblCur.hasOwnProperty(key)) {
  tblCur = tblCur[key];
  } else {
  tblCur = tblCur[key] = {};
  }
 }
 tblCur.end = true; //最后一个关键字
 tblCur = tblRoot;
 }
 return tblRoot;
}
这段代码中使用了一个连等语句:`tblCur = tblCur[key] = {}`。这里需要注意语句的执行顺序,由于`[]`运算符的优先级高于`=`,因此首先会在`tblCur`对象中创建一个名为`key`的属性。结合`tblRoot = tblCur = {}`来看,其执行顺序如下:
var tblRoot = tblCur = {};
tblRoot = tblCur;
tblCur['key'] = undefined; // now tblRoot = {key: undefined}
tblCur['key'] = {};
tblCur = tblCur['key'];
JavaScript字典树实现与查询接口
通过上述代码,我们构建了所需的查询数据结构。接下来查看查询接口的实现。
对于目标字符串的每一个字符,我们都从关键词树的根节点开始匹配。首先检查`keywords[a]`是否存在,若存在,则继续检查`keyword[a][b]`,若最终`keyword[a][b]…[x]=true`,则说明匹配成功;若`keyword[a][b]…[x]=undefined`,则从下一个字符位置重新开始匹配`keywords[a]`。
function search(content) {
 var tblCur,
 p_star = 0,
 n = content.length,
 p_end,
 match, //是否找到匹配
 match_key,
 match_str,
 arrMatch = [], //存储结果
 arrLength = 0; //arrMatch的长度索引

 while(p_star < n) {
 tblCur = tblRoot; //回溯至根部
 p_end = p_star;
 match_str = "";
 match = false;
 do {
  match_key = content.charAt(p_end);
  if(!(tblCur = tblCur[match_key])) { //本次匹配结束
  p_star += 1;
  break;
  } else {
  match_str += match_key;
  }
  p_end += 1;
  if(tblCur.end) //是否匹配到尾部
  {
  match = true;
  }
 } while (true);

 if(match) { //最大匹配
  arrMatch[arrLength] = {
  key: match_str,
  begin: p_star - 1,
  end: p_end
  };
  arrLength += 1;
  p_star = p_end;
 }
 }
 return arrMatch;
}
以上即为整个关键词匹配系统的核心逻辑。这里充分利用了JavaScript的语言特性,效率非常高。我使用一篇50万字的《搜神记》进行测试,从中查找给定的300个成语,匹配耗时约为1秒。重要的是,由于目标文本仅遍历一次,因此目标文本的长度对查询时间的影响几乎可以忽略不计。对查询时间影响较大的主要是关键词的数量,因为目标文本的每个字都要遍历一遍关键词,从而对查询性能产生一定影响。
哈希表原理与性能优势分析
简单分析
阅读上文后,你可能会疑惑:对每个字都遍历一遍所有关键词,即使部分关键词有相同前缀,完全遍历似乎也耗时。但在JavaScript中,对象的属性是基于哈希表构建的,这种数据结构与单纯的数组遍历有显著不同,其效率远高于基于顺序的数组遍历。可能部分同学对数据结构不太熟悉,这里简要介绍哈希表的相关内容。
首先观察数据的存储方式。
内存中的数据由两部分组成:值(Value)和地址(Address)。可以将内存想象成一本新华字典,字的解释即为值,而目录即为地址。字典按拼音排序,例如相同发音的“ni”排在同一区域,这意味着数组整齐排列在连续的内存区域中,这种结构即为数组。你可以指定“ni”的1号或10号下标进行访问。其结构图如下:
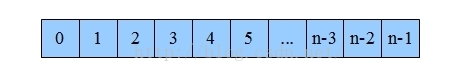
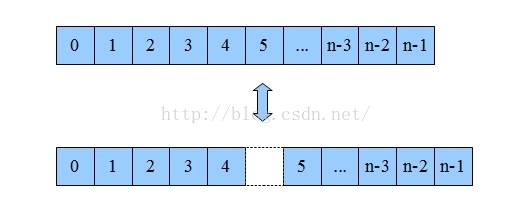
数组的优势在于遍历简单,通过下标可直接访问相应数据。但其增删操作非常困难。例如,若要删除第6项,第5项之后的所有数据都需要向前移动一位;若删除第一项,整个数组的数据都需移动,消耗极大。
为了解决数组增删困难的问题,链表应运而生。如果将值分为两部分,一部分存储原值,另一部分存储指向下一个相同结构的地址,依次类推,便构成了链表。其结构如下:
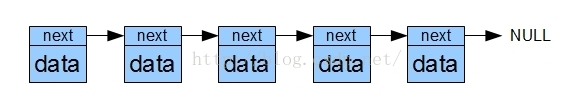
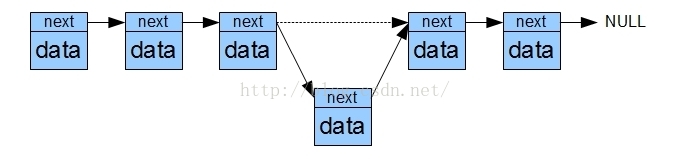
从上图可明显看出,链表的增删操作非常简单,只需修改目标项和前一项的`next`指针即可完成。然而,查询链表中的某个值却非常困难,必须依次遍历才能访问到目标位置。
为了整合这两种结构的优势,想必聪明的你一定想到了下面的结构。
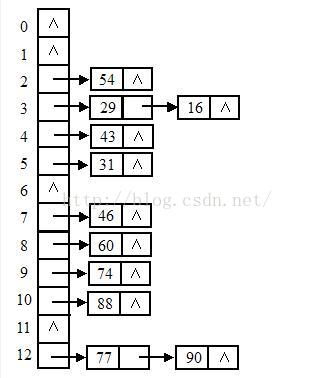
这种数据结构即为哈希表(Hash Table)。数组中存储链表的头地址,从而形成二维数据表。至于数据如何分布,这涉及哈希算法(散列算法)。虽然算法种类繁多,但其原理均是通过一个函数对key进行计算,再根据计算结果安放数据。也就是说,key与实际地址之间形成了映射关系。此时,我们不再以数组下标或单纯遍历来访问数据,而是通过散列函数的计算结果直接定位数据。JavaScript中的对象即为哈希结构。例如定义一个对象`obj`,`obj.name`经过散列计算后,其在内存中的位置可能是上图中的90。当我们操作`obj.name`时,底层会自动通过哈希算法定位到90的位置,即直接从数组的第12项开始查找链表,而非从0开始遍历整个内存块。
在JavaScript中定义对象`obj{key: value}`时,key会被转换为字符串,经过哈希处理得到内存地址,然后将值放入其中。这解释了为何我们可以随意增删属性,也解释了为何在JavaScript中可以为数组添加属性,且数组不存在所谓的越界问题。
在数据量较大的场合,哈希表具有显著优势,因为它通过哈希算法减少了大量不必要的计算。所谓性能优化,本质上是让计算机减少运算;最大的优化,就是不进行计算!
多关键词匹配算法优化策略
算法的优化
理解了算法的底层实现后,我们可以考虑对算法进行优化。但在优化前需强调:不要盲目追求性能!例如本案例中,匹配字数最多为5000字,现有算法已足够,所有优化均为不必要的。此处讨论优化旨在提高对算法和程序的理解,而非为了那1毫秒的性能提升。
我们发现关键词中均没有单字情况,因此按单字单位进行关键词遍历显然是浪费。这里的优化策略是预先统计关键词的最大和最小长度,每次以最小长度为单位进行查找。例如,若测试用例中的关键词为成语,最短均为4个字,则每次匹配时一次性匹配4个字,若命中则继续深入查找至最大长度。也就是说,在最初构造树时,首先以最小长度构建,然后逐字增加。
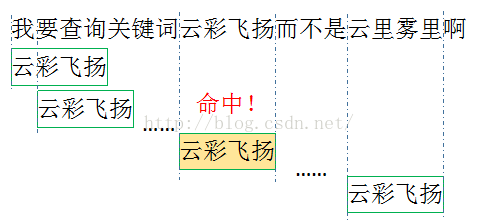
简单计算一下,按照我们的测试用例,300个成语,匹配一个词只需一次对比,而单字查询则需要对比4次,且每次对比都要访问树结构,这就是可避免的性能消耗。更重要的是,这里的对比并非字符串对比,关键字均作为key存在,其效果等同于`key in obj`,即对key进行哈希变换后访问相应地址!因此,无需纠结对比一个字和对比4个字的差异,因为我们并未进行字符串对比。
关于多关键词的匹配就介绍到这里,优化版代码此处不再贴出,因为一般情况下也用不到。
JS 鼠标滚轮事件频繁触发导致卡顿怎么优化?
2026-11-05 17:08:07
优化JS回到顶部性能:防抖节流与requestAnimationFrame应用
2026-11-05 16:33:51
JS中Array、Set与Map的区别及应用场景选择
2026-11-05 16:03:02
PixiJS 常见报错排查:纹理跨域、黑屏与内存泄漏解决
2026-11-05 10:05:21
JS数组find与filter取值区别及性能对比
2026-11-05 08:39:21