

Node.js 中通过 C/C++ Addon 实现多线程处理 CPU 密集型任务
Node.js 单线程模型在 CPU 密集型场景下存在性能瓶颈。本文通过 C/C++ Addon 调用 pthread 库,在 Node.js 中实现多线程质数计算。实验对比了单线程与多线程的性能差异,验证了 Amdahl 定律,并指出线程数需根据 CPU 核心数合理配置,以最大化并行计算收益。
Node.js 多线程编程背景与动机
在前文《别说不可能,nodejs中实现sleep》中,已介绍过 Node.js Addon 的基本用法。本文将继续深入探讨 Addon 技术,进一步挖掘 C/C++ 的能力,以弥补 Node.js 在特定场景下的不足。
Node.js 的性能常被讨论。就语言本身而言,其性能相当高,虽不及多数静态语言,但差距并不显著;相较于其他动态语言,其速度优势明显。然而,为何常认为 Node.js 难以胜任 CPU 密集型场景?原因在于其单线程特性,导致无法充分利用多核 CPU 资源。计算机科学中的 Amdahl 定律对此有明确描述:
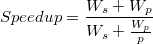
假设总工作量为 W,可分解为串行部分 Ws 和并行部分 Wp。在 p 个 CPU 并行计算时,性能提升倍数为 speedup。Amdahl 定律描述了并行计算的极限,但这仅是理想情况。实际中,并发可能引发资源争夺,需引入锁机制,导致线程等待;同时,操作系统线程调度切换也会增加时间开销,从而增大 Ws。不过,当任务中 Wp 远大于 Ws,且拥有多个 CPU 核心时,并行带来的性能提升依然显著。
质数计算场景设计与对比基准
回到 Node.js 场景。我们设定一个计算 4000000 以内质数数量的场景。该场景以除法运算为主,不涉及内存分配或复杂对象操作,理论上能让 Node.js 保持较快速度,便于与 C/C++ 进行对比。
JavaScript 查找质数的方法此前已在博客中提供,此处直接引用:
代码如下:
function zhishu_js(num) {
if (num == 1) {
return false;
    }
if (num == 2) {
return true;
    }
for (var i = 2; i <= Math.sqrt(num); i++) {
if (num % i == 0) {
return false;
        }
    }
return true;
}
接下来编写 C 语言版本:
代码如下:
#include <math.h>
bool zhishu(int num){
 if (num == 1) {
 return false;
 }
 if (num == 2) {
 return true;
 }
 for (int i = 2; i <= sqrt(num); i++) {
 if (num % i == 0) {
 return false;
 }
 }
 return true;
};
在 Node.js 中,我们使用从 1 到 4000000 的循环来检索质数;而在 C 语言中,我们设置多个线程,定义 count 为 4000000,每个线程执行以下操作:若 count 大于 0,则取出 count 值,计算是否为质数,并将 count 减 1。基于此思路,JavaScript 版本代码如下:
代码如下:
var count = 0;
for (j = 1; j < 4000000; j++) {
 if(zhishu(j)){
 count++;
 }
}
C/C++ Addon 多线程实现细节
关键难点在于 C 语言的多线程编程。早期 C/C++ 标准库未提供并行计算支持,且不同操作系统的实现存在差异。为简化处理,本文采用 pthread 库来处理线程。
下载 pthread 最新版本。由于我对 gyp 不够熟悉,链接依赖 lib 花费了不少时间,最终采用的方法是将 pthread 源代码直接放入项目目录,并在 binding.gyp 中将 pthread.c 添加到源代码列表,编译项目时一并编译 pthread。修改后的 binding.gyp 如下:
代码如下:
{
"targets": [
    {
"target_name": "hello",
"sources": [ "hello.cc","pthreads/pthread.c" ],
"include_dirs": [
"<!(node -e \"require('nan')\")",
"pthreads"
      ],
"libraries": ["Ws2_32.lib"]
    }
  ]
}
当然,这种方法较为繁琐。如果仅添加 pthread 的 lib 和 include 目录引用且无依赖问题,则无需采用此方法。
接下来进入 C/C++ 多线程编程部分,定义一个线程处理函数:
代码如下:
pthread_mutex_t lock;
void *thread_p(void *null){
 int num, x=0;
 do{
 pthread_mutex_lock(&lock);
 num=count--;
 pthread_mutex_unlock(&lock);
 if(num>0){
 if(zhishu(num))x++;
 }else{
 break;
 }
 }while(true);
 std::cout<<' '<<x<<' ';
 pthread_exit(NULL);
 return null;
}
线程间对 count 变量存在竞争,需确保同一时间仅有一个线程操作该变量。我们通过 pthread_mutex_t lock 添加互斥锁。执行 pthread_mutex_lock(&lock) 时,线程检查锁状态:若已锁定,则等待并重试,阻塞后续代码;若锁已释放,则获取锁并执行后续代码。相应的,pthread_mutex_unlock(&lock) 用于释放锁状态。
编译器在编译时会进行优化,若某语句无明确作用且不影响其他语句,可能被优化掉。在上述代码中,我加入了统计质数数量的逻辑。若不加此统计,类似如下代码:
代码如下:
for (int j = 0; j < 4000000; j++) {
zhishu(j);
}
会被编译器直接跳过,实际不会运行。
Addon 的编写方法此前已介绍,此处实现从 JavaScript 接收一个表示线程数的参数,并在 C 中创建指定数量的线程完成质数检索。完整代码如下:
代码如下:
#include <nan.h>
#include <math.h>
#include <iostream>
#include "pthreads\pthread.h"
#define MAX_THREAD 100
using namespace v8;
int count=4000000;
pthread_t tid[MAX_THREAD];
pthread_mutex_t lock;
void *thread_p(void *null){
 int num, x=0;
 do{
 pthread_mutex_lock(&lock);
 num=count--;
 pthread_mutex_unlock(&lock);
 if(num>0){
 if(zhishu(num))x++;
 }else{
 break;
 }
 }while(true);
 std::cout<<' '<<x<<' ';
 pthread_exit(NULL);
 return null;
}
NAN_METHOD(Zhishu){
 NanScope();
 pthread_mutex_init(&lock,NULL);
 double arg0=args[0]->NumberValue();
 int c=0;
 for (int j = 0; j < arg0 && j<MAX_THREAD; j++) {
 pthread_create(&tid[j],NULL,thread_p,NULL);
 }
 for (int j = 0; j < arg0 && j<MAX_THREAD; j++) {
 pthread_join(tid[j],NULL);
 }
 NanReturnUndefined();
}
void Init(Handle<Object> exports){
 exports->Set(NanSymbol("zhishu"), FunctionTemplate::New(Zhishu)->GetFunction());
}
NODE_MODULE(hello, Init);
pthread_create 可创建线程,默认为 joinable 状态,此时子线程受主线程制约;pthread_join 阻塞主线程,等待子线程结束。若子线程已退出,pthread_join 不执行任何操作。因此,对所有线程执行 pthread_join,可确保所有子线程退出后,主线程才继续执行。
完善后的 Node.js 脚本如下:
代码如下:
var zhishu_c=require('./build/Release/hello.node').zhishu;
function zhishu(num) {
if (num == 1) {
return false;
    }
if (num == 2) {
return true;
    }
for (var i = 2; i <= Math.sqrt(num); i++) {
if (num % i == 0) {
return false;
        }
    }
return true;
}
console.time("c");
 zhishu_c(100);
console.timeEnd("c");
console.time("js");
var count=0;
for (j = 1; j < 4000000; j++) {
 if(zhishu(j)){
 count++;
 }
}
console.log(count);
console.timeEnd("js");
性能测试结果与分析
查看测试结果:
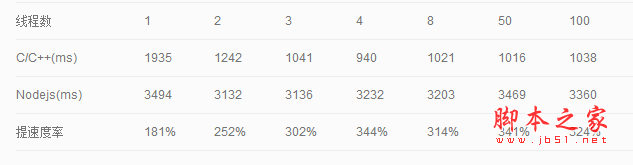
单线程时,C/C++ 运行速度约为 Node.js 的 181%,在动态语言中表现优异。双线程时速度提升最明显,因我的电脑是双核四线程 CPU,此时可能已启用两个核心处理任务。4 线程时速度达到最大,这是双核四线程 CPU 的极限;线程数再增加,速度不再提升。上述 Amdahl 定律中,p 已达上限 4。增加线程会引入操作系统进程调度时间和锁竞争时间,尽管增加了 CPU 时间竞争,但 Ws 的增加更为明显,导致性能下降。若在空闲机器上实验,数据可能更好。
从实验中可得出结论:对于 CPU 密集型运算,交由静态语言处理可显著提高效率;若计算涉及较多内存、字符串、数组或递归操作(后续验证),性能提升将更为惊人。同时,合理利用多线程可有效提高效率,但并非线程越多越好,需根据机器情况合理配置。
Node.js 本身确实不擅长处理 CPU 密集型任务,但通过本文经验,克服这一障碍并非不可能。
Java和JavaScript的应用场景分工:后端企业级开发与Web前端交互
2026-11-05 15:57:34
除了浏览器和Node.js,还有哪些轻量级Js脚本运行工具?
2026-11-04 17:38:24
无需后端:用JavaScript实现简单网站的本地数据存储
2026-11-03 23:03:30
Node.js 下载慢或官网打不开怎么办
2026-11-03 18:19:37
JS解析大体积Excel文件内存溢出怎么办
2026-11-03 18:19:37