JavaScript实现汇编器时符号表管理与地址解析策略
深入讲解使用JavaScript实现汇编器时符号表的数据结构设计、作用域隔离、前向引用的双遍扫描与单遍回填解析策略,包含完整的代码实现与工程实践避坑指南。
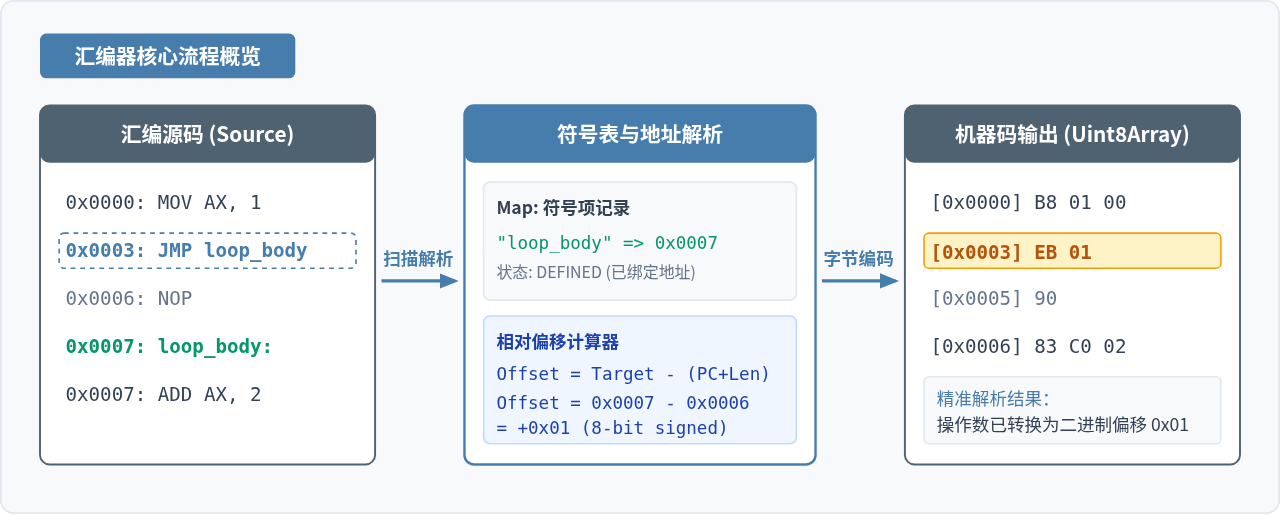
在 JavaScript 中编写一个汇编器,核心任务是将人类可读的汇编助记符和符号标签(Label)精确映射为目标体系结构的二进制机器码。在这个过程中,最棘手的难题是前向引用(Forward Reference):当跳转指令引用一个尚未在源文本中出现的标签时,汇编器无法预先获知该跳转的目标物理地址。解决这一矛盾依赖于两个核心机制的紧密配合:规范的符号表(Symbol Table)管理与严谨的地址解析策略(双遍扫描或单遍回填)。本文将针对 JavaScript 的运行环境特征,剖析符号表数据模型的设计要点,对比两种主流地址解析路径的实现细节,并给出完整的代码范式与边界防范策略。
一、符号表的核心数据模型与作用域隔离
符号表是汇编器贯穿整个翻译生命周期的中枢索引,用于记录标号、常量(如 EQU 伪指令定义)及数据段变量的物理或逻辑地址。在 JavaScript 运行环境中,符号表的实现应当优先选用原生的 Map 对象,而非传统的字面量对象 {}。这是因为普通 JavaScript 对象的原型链上默认存在 toString、valueOf、constructor 等原生属性,当汇编源码中恰好定义了名为 constructor: 或 toString: 的标号时,字面量对象会发生属性污染并引发不可预期的寻址崩溃;而 Map 保证了纯净的键值查找,且能维持 O(1) 的存取性能。
一个健壮的符号项(SymbolEntry)需要承载完整的元数据,通常包含符号名称、确定的内存地址、定义状态、所属作用域以及待修补引用列表:
// 符号项定义
class SymbolEntry {
  constructor(name, scope = 'global') {
    this.name = name;                     // 符号名称
    this.scope = scope;                   // 所属作用域(全局或父级标号)
    this.address = null;                  // 物理/逻辑地址 (未确定时为 null)
    this.isDefined = false;               // 是否已声明完成
    this.type = 'LABEL';                  // 类型: 'LABEL' | 'CONSTANT' | 'SECTION'
    this.declarationLine = -1;            // 声明行号(用于报错追踪)
    this.references = [];                 // 引用点记录 [{ address, type, line }]
  }
}
在大型汇编程序中,局部标号(如以点号开头的 .loop、.exit 或数字标号 1:)广泛存在于各个子程序内。如果符号表采用单层扁平存储,会导致不同子程序间的局部标号发生命名冲突。为实现优雅的作用域隔离,推荐采用作用域前缀命名空间化(Scope Prefixing)策略:在当前全局标号(如 main)生效期间,所有紧随其后的局部标号(如 .loop)在存入底层 Map 时统一转换为 main.loop。遇到下一个全局标号时,更新当前作用域上下文,从而以最低的内存损耗实现天然的同名标号隔离。
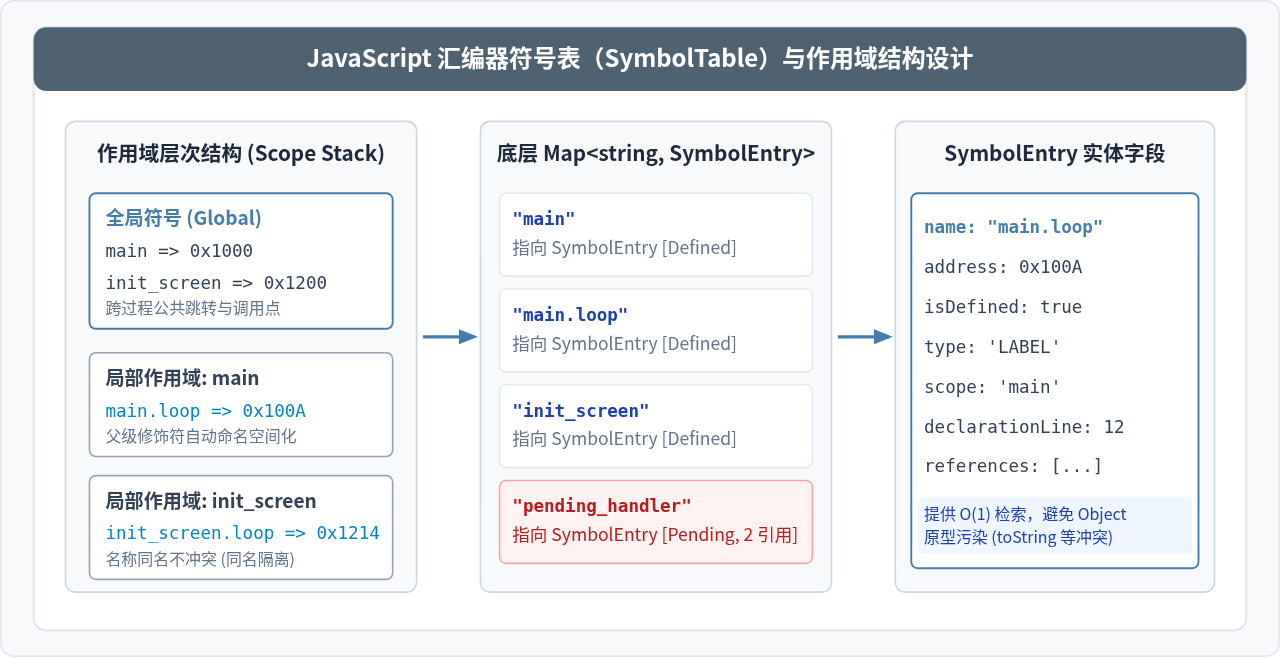
下面给出了一个具备作用域管理、重复定义拦截与完整性验证能力的 JavaScript SymbolTable 类实现:
class SymbolTable {
  constructor() {
    this.symbols = new Map();
    this.currentScope = 'global';
  }

  // 切换作用域上下文(遇到新的全局标号时调用)
  setScope(scopeName) {
    this.currentScope = scopeName || 'global';
  }

  // 生成作用域限定键
  resolveKey(name) {
    if (name.startsWith('.') || name.startsWith('@')) {
      return `${this.currentScope}${name}`;
    }
    return name;
  }

  // 注册或更新符号定义
  define(name, address, line = 0, type = 'LABEL') {
    const key = this.resolveKey(name);
    let entry = this.symbols.get(key);

    if (entry && entry.isDefined) {
      throw new Error(`[语义错误 第${line}行] 符号 "${name}" 重复定义,此前已在第 ${entry.declarationLine} 行声明`);
    }

    if (!entry) {
      entry = new SymbolEntry(key, this.currentScope);
      this.symbols.set(key, entry);
    }

    entry.address = address;
    entry.isDefined = true;
    entry.type = type;
    entry.declarationLine = line;

    // 若当前为全局标号,自动将后续局部标号的作用域锚定为本标号
    if (!name.startsWith('.') && !name.startsWith('@') && type === 'LABEL') {
      this.setScope(name);
    }

    return entry;
  }

  // 查询符号地址(支持向前/向后解析)
  lookup(name) {
    const key = this.resolveKey(name);
    return this.symbols.get(key) || null;
  }

  // 校验是否存在悬空引用(未定义的符号)
  validateAllDefined() {
    const missing = [];
    for (const [key, entry] of this.symbols.entries()) {
      if (!entry.isDefined) {
        missing.push(key);
      }
    }
    if (missing.length > 0) {
      throw new Error(`汇编失败:发现未定义的悬空符号引用: ${missing.join(', ')}`);
    }
  }
}
二、策略一:双遍扫描(Two-Pass Assembly)的地址解析流程
双遍扫描是经典汇编器最通用的设计架构。其核心思想是将“符号地址搜集”与“指令二进制发射”两项职责完全分离,通过在源程序上进行两次有序遍历,优雅化解前向引用的时序问题。
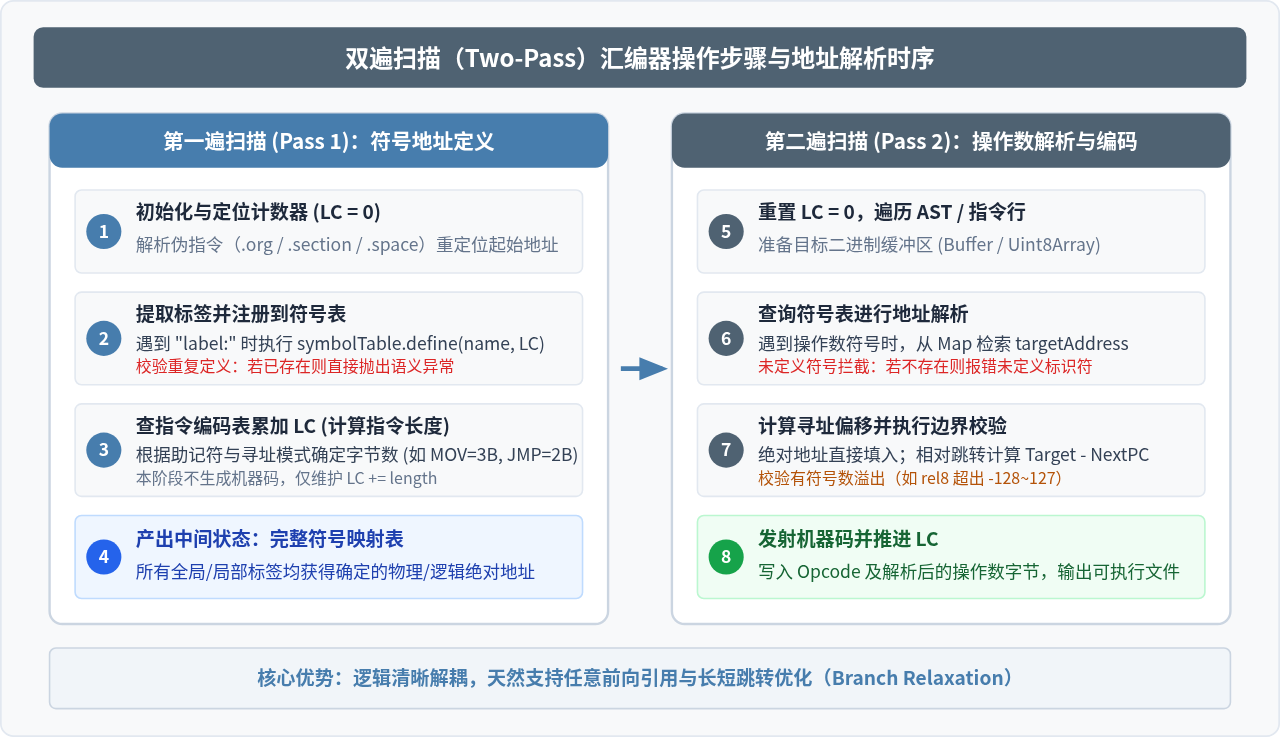
1. 第一遍扫描(Pass 1):确定符号地址与累加定位计数器
第一遍扫描的目标是填充完整的符号表,并不实际生成机器指令字节。汇编器维护一个定位计数器(Location Counter,简称 LC 或 PC),通常初始值为 0x0000(或由伪指令 .org 0x1000 指定)。逐行扫描中间解析后的指令序列:
- 处理标号声明:当行内包含标号声明(如
loop:)时,调用symbolTable.define(name, LC, line)将当前LC的精确数值记录为该符号的地址。 - 处理伪指令:若遇到分配内存的伪指令(如
.space 16或.byte 1, 2, 3),按预分配字节数推进LC;遇到.org 0x8000则将LC直接重设为指定绝对地址。 - 计算机器指令长度:即使不知道操作数引用的标号地址,汇编器也必须查阅操作码规范表(Opcode Table),计算出当前指令在最终机器码中占用的固定字节数(例如
MOV AX, BX占用 2 字节,JMP target占用 3 字节),并执行LC += instruction.byteLength。
完成 Pass 1 后,符号表中所有合法的标号都已拥有确定的绝对物理地址。
2. 第二遍扫描(Pass 2):符号解析、偏移求值与机器码发射
在第二遍扫描开始时,将 LC 重新置回初始地址,并开辟一段定长或动态增长的二进制缓冲区(如 Uint8Array 或 Node.js Buffer)。此时重新遍历指令序列:
- 对于包含标号引用的操作数,直接调用
symbolTable.lookup(name)检索目标地址。若符号未定义,此时即可精准抛出未定义异常。 - 若指令采用绝对寻址,直接将解析出的标号物理地址编码为小端(Little-Endian)字节写入缓冲区。
- 若指令采用相对寻址(如条件跳转
JNE label),则根据目标地址targetAddress与当前指令执行后的下一条指令地址(LC + instruction.byteLength)计算相对位移。 - 写入机器操作码与操作数字节,并同步推进
LC。
以下是使用 JavaScript 实现的双遍扫描核心流程示范代码:
// 指令元数据描述表(示例体系结构)
const INSTRUCTION_SET = {
  'NOP': { opcode: 0x90, length: 1, type: 'NO_OPERAND' },
  'MOV_REG_IMM': { opcode: 0xB8, length: 3, type: 'ABS16' }, // MOV AX, imm16
  'JMP': { opcode: 0xE9, length: 3, type: 'REL16' },         // 相对跳转 16位
  'JNE_SHORT': { opcode: 0x75, length: 2, type: 'REL8' }     // 相对短跳转 8位
};

function assembleTwoPass(astStatements) {
  const symbolTable = new SymbolTable();
  let lc = 0;

  // ===== 第一遍扫描 (Pass 1) =====
  for (const stmt of astStatements) {
    if (stmt.label) {
      symbolTable.define(stmt.label, lc, stmt.line);
    }

    if (stmt.type === 'INSTRUCTION') {
      const meta = INSTRUCTION_SET[stmt.mnemonic];
      if (!meta) throw new Error(`[第${stmt.line}行] 未知指令助记符: ${stmt.mnemonic}`);
      lc += meta.length;
    } else if (stmt.type === 'DIRECTIVE_ORG') {
      lc = stmt.address;
    }
  }

  // 校验所有引用的符号是否存在
  symbolTable.validateAllDefined();

  // ===== 第二遍扫描 (Pass 2) =====
  const outputBuffer = new Uint8Array(lc);
  const view = new DataView(outputBuffer.buffer);
  let emitOffset = 0;
  lc = 0;

  for (const stmt of astStatements) {
    if (stmt.type === 'DIRECTIVE_ORG') {
      lc = stmt.address;
      emitOffset = lc;
      continue;
    }

    if (stmt.type === 'INSTRUCTION') {
      const meta = INSTRUCTION_SET[stmt.mnemonic];
      const nextPC = lc + meta.length;

      // 1. 写入操作码
      view.setUint8(emitOffset++, meta.opcode);

      // 2. 解析操作数并写入寻址数据
      if (meta.type === 'REL8') {
        const sym = symbolTable.lookup(stmt.operand);
        const relOffset = sym.address - nextPC;
        // 8位有符号边界检查 (-128 ~ 127)
        if (relOffset < -128 || relOffset > 127) {
          throw new Error(`[第${stmt.line}行] 相对跳转偏移超出 8 位限制: ${relOffset} 字节`);
        }
        view.setInt8(emitOffset++, relOffset);
      } else if (meta.type === 'REL16') {
        const sym = symbolTable.lookup(stmt.operand);
        const relOffset = sym.address - nextPC;
        if (relOffset < -32768 || relOffset > 32767) {
          throw new Error(`[第${stmt.line}行] 相对跳转偏移超出 16 位限制: ${relOffset} 字节`);
        }
        view.setInt16(emitOffset, relOffset, true); // true 表示 Little-Endian
        emitOffset += 2;
      } else if (meta.type === 'ABS16') {
        const target = typeof stmt.operand === 'number'
          ? stmt.operand
          : symbolTable.lookup(stmt.operand).address;
        view.setUint16(emitOffset, target, true);
        emitOffset += 2;
      }

      lc += meta.length;
    }
  }

  return outputBuffer.subarray(0, emitOffset);
}
三、策略二:单遍扫描与回填(Single-Pass with Backpatching)
在 JIT(即时编译器)、流式传输编译或对运行内存极其敏感的场景下,保留完整的 AST 节点并进行二次扫描会引入额外的内存与调度开销。单遍扫描策略允许汇编器只对源代码进行一次遍历即可直接发射目标机器码。为了解决尚未声明标签的前向引用问题,汇编器采用回填机制(Backpatching)。
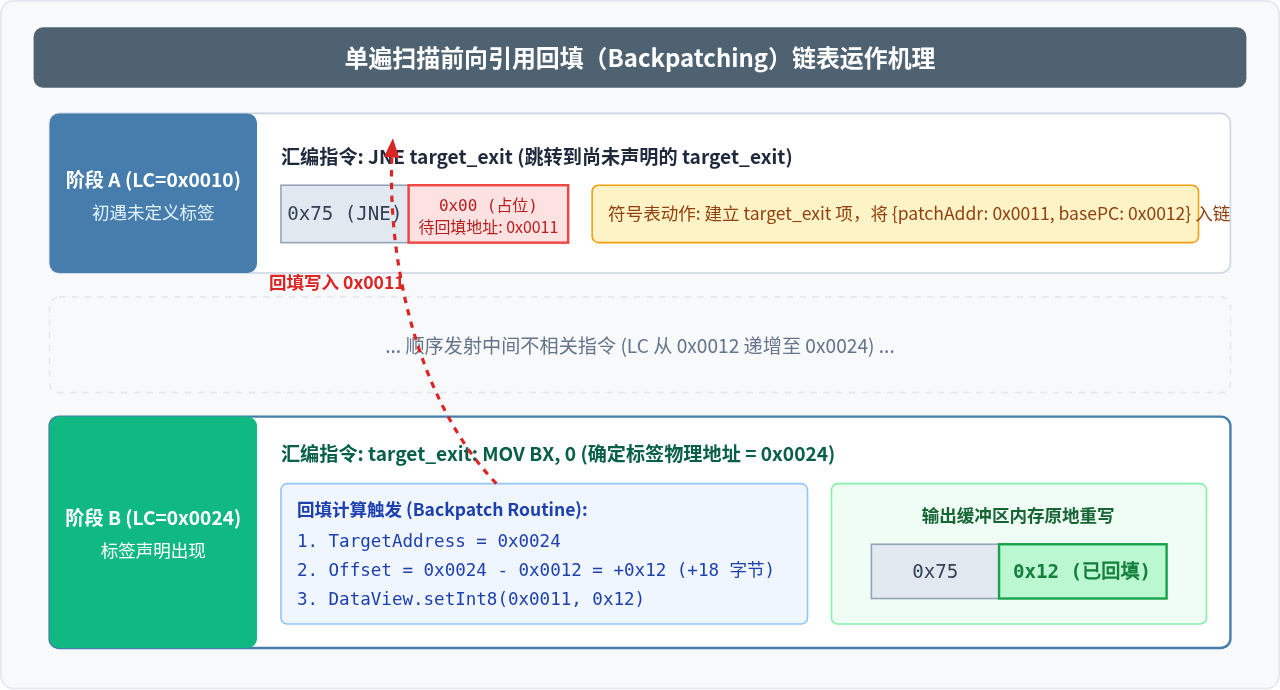
回填机制的运作原理如下:
- 遇到向后引用(已定义符号):当引用的标号此前已经出现并记录在符号表中时,直接计算物理地址或偏移量,正常发射机器码。
- 遇到前向引用(未定义符号):当引用的标号尚未在符号表中声明时,在输出缓冲区(如
Uint8Array)中为操作数先写入零值或无效占位字节(Placeholder),同时在符号表中为该标号建立一个待补丁链表(Pending Patches List)。每个补丁记录项保存了当前占位符在二进制缓冲区中的物理偏移(patchOffset)、基准程序计数器(basePC)、修补类型(rel8、rel16或abs16)以及源代码行号。 - 标号定义到达触发回填:当扫描到标号声明语句(如
target_exit:)时,该符号的物理地址立即明确。汇编器在将其标记为已定义的同时,立即遍历其名下挂起的待补丁链表,计算正确的相对偏移或绝对地址,并借助 JavaScript 的DataView原地修改Uint8Array对应位置的占位字节。 - 文件结束校验:扫描完源文件后,检查符号表中是否存在
isDefined === false且挂起补丁链表非空的符号。若有,说明源码中引用了从未定义的标号,随即中止输出并报错。
以下是使用 JavaScript 实现的单遍回填汇编器代码片段:
class BackpatchAssembler {
  constructor(bufferSize = 65536) {
    this.buffer = new Uint8Array(bufferSize);
    this.view = new DataView(this.buffer.buffer);
    this.lc = 0;
    this.pendingSymbols = new Map(); // name => { address, isDefined, patches: [] }
  }

  // 获取或初始化符号记录
  getOrCreateSymbol(name) {
    if (!this.pendingSymbols.has(name)) {
      this.pendingSymbols.set(name, {
        address: null,
        isDefined: false,
        patches: []
      });
    }
    return this.pendingSymbols.get(name);
  }

  // 标号定义:记录地址并立即触发回填
  defineLabel(name, line) {
    const sym = this.getOrCreateSymbol(name);
    if (sym.isDefined) {
      throw new Error(`[第${line}行] 标号重复定义: ${name}`);
    }

    sym.address = this.lc;
    sym.isDefined = true;

    // 执行回填修补
    for (const patch of sym.patches) {
      if (patch.type === 'REL8') {
        const offset = sym.address - patch.basePC;
        if (offset < -128 || offset > 127) {
          throw new Error(`[第${patch.line}行] 回填失败:相对偏移超出 8 位范围 (${offset})`);
        }
        this.view.setInt8(patch.patchOffset, offset);
      } else if (patch.type === 'REL16') {
        const offset = sym.address - patch.basePC;
        this.view.setInt16(patch.patchOffset, offset, true);
      } else if (patch.type === 'ABS16') {
        this.view.setUint16(patch.patchOffset, sym.address, true);
      }
    }
    // 回填完成后清空链表
    sym.patches = [];
  }

  // 发射单条指令
  emitInstruction(mnemonic, operandSymbolOrImm, line) {
    const meta = INSTRUCTION_SET[mnemonic];
    this.view.setUint8(this.lc++, meta.opcode);

    if (meta.type === 'REL8') {
      const sym = this.getOrCreateSymbol(operandSymbolOrImm);
      const patchOffset = this.lc;
      const basePC = this.lc + 1; // 相对基准为下一指令地址

      if (sym.isDefined) {
        // 向后引用:已知目标地址,直接写入
        const offset = sym.address - basePC;
        this.view.setInt8(this.lc++, offset);
      } else {
        // 前向引用:写入占位符 0x00,注册挂起补丁
        this.view.setInt8(this.lc++, 0x00);
        sym.patches.push({ patchOffset, basePC, type: 'REL8', line });
      }
    }
  }

  // 完成组装并获得最终机器码
  finalize() {
    for (const [name, sym] of this.pendingSymbols.entries()) {
      if (!sym.isDefined && sym.patches.length > 0) {
        throw new Error(`汇编错误:存在未定义的标号引用 "${name}",初次出现在第 ${sym.patches[0].line} 行`);
      }
    }
    return this.buffer.subarray(0, this.lc);
  }
}
四、地址计算模型:绝对寻址、相对偏移与边界校验
在地址解析过程中,数值的位宽计算与边界检查是直接影响生成代码正确性的关键环节。汇编器通常面对两类核心运算:
1. 绝对地址计算与段重定位
绝对寻址是指指令操作数直接存放内存的绝对物理或逻辑地址(例如 MOV AX, [0x2000])。若汇编器支持分段机制(如 .text 代码段和 .data 数据段),符号的实际地址由段基址与段内偏移相加得出:
const finalAddress = (sectionBaseAddress + symbolOffset) >>> 0;注意末尾的 >>> 0 操作:在 JavaScript 中,所有位运算均在 32 位有符号整数上执行。当处理大于或等于 0x80000000 的高位地址时,若不进行无符号右移转换,数值会被错误解释为负数。使用 >>> 0 可强制将其恢复为 32 位无符号非负整数。
2. 相对寻址与补码运算
分支跳转指令(如 JMP、CALL、BNE)多数采用相对于程序计数器的偏移量。其通用公式为:
Offset = TargetAddress - (CurrentInstructionAddress + InstructionLength);在 JavaScript 中计算出的结果是标准的十进制整数(可能为负数)。写入二进制缓冲区时,需特别注意:
- 范围校验:8 位有符号相对偏移范围为
[-128, 127];16 位范围为[-32768, 32767]。一旦超出范围必须立即拦截报错,否则会导致底层直接截断高位,生成跳转到完全错误地址的危险指令。 - 补码转化:使用
DataView.setInt8()或DataView.setInt16(..., true)时,JavaScript 引擎会在内部自动按照二进制补码格式写入。如果使用常规数组自行位移编码,则必须手动进行位与截断:const byteVal = (offset & 0xFF);。
五、双遍扫描与单遍回填的权衡对比与选型决策
两种策略在架构设计、运行开销与复杂特性支持度上各有长短,以下为详细的工程对比依据:
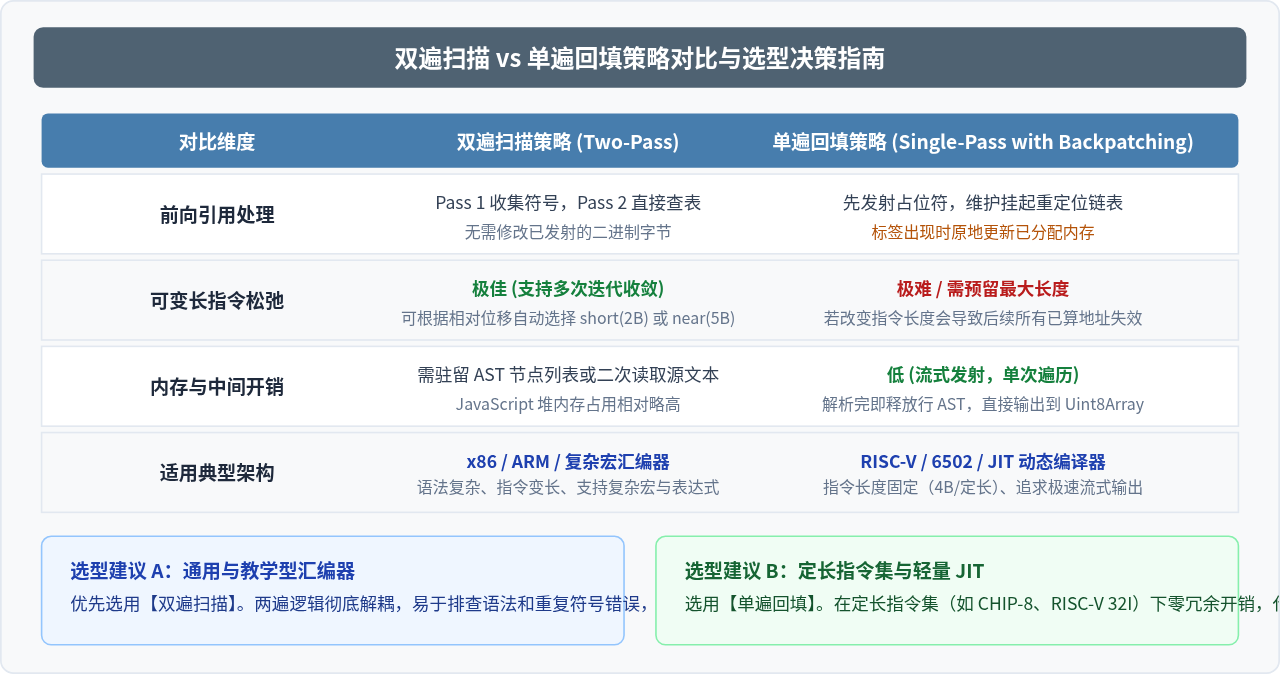
| 对比维度 | 双遍扫描策略 (Two-Pass) | 单遍扫描回填策略 (Single-Pass with Backpatching) |
|---|---|---|
| 前向引用处理 | Pass 1 收集全量符号,Pass 2 直接定值查表。机器码单向写入,无需修改已发射字节。 | 遇到前向引用需发射占位字节,维护未决补丁链表,待标号确定后原地覆盖修改。 |
| 可变长指令松弛 (Branch Relaxation) | 极佳。支持通过多次迭代测算跳转距离,自动将近距离跳转收缩为 short jump (2字节),远距离扩展为 near jump (5字节)。 | 极难。在单遍中若改变指令长度,会导致其后所有已经算好的物理地址全部发生偏移,导致雪崩式错位。 |
| JavaScript 内存占用 | 相对较高。需要在内存中保留完整抽象语法树(AST)或令牌列表以供 Pass 2 重复遍历。 | 极低。逐行解析、即时输出,解析完毕后行 AST 即可被 V8 垃圾回收,仅占用输出 Buffer。 |
| 架构复杂性 | 流程高度解耦,Pass 1 与 Pass 2 各自职责单一,代码可维护性强,报错定位清晰。 | 需要精心维护挂起补丁链表,并需在符号定义与 EOF 处插入修补逻辑,状态管理要求高。 |
| 典型适用场景 | 通用汇编器(如 x86、ARM)、宏汇编器、IDE 浏览器端集成编译插件。 | 定长指令集(如 RISC-V、CHIP-8、WebAssembly 字节码生成器)、轻量即时编译器。 |
工程选型建议:对于定长指令集或指令长度预先严格固定的场景(如 RISC-V 32I 基础指令均为 4 字节),单遍回填策略在执行速度与内存占用上具有显著优势;而对于包含复杂变长指令、宏展开或支持短跳转优化的高级汇编器,必须坚定选用双遍扫描(甚至多遍松弛迭代)架构。
六、工程实践中的关键细节与陷阱排查
- 大小端序(Endianness)一致性保证:x86、ARM(常见配置)及 RISC-V 均为小端序体系。在 Node.js 或浏览器中操作
DataView时,写入 16/32 位操作数务必显式传入littleEndian = true参数,避免因宿主环境默认行为差异导致机器码字节颠倒。 - 位运算截断特性:JavaScript 中的按位左移
a << b会将操作数隐式转为 32 位带符号整型,处理 32 位高地址(如0xFFFF0000)时极易发生符号翻转。地址拼接应优先使用乘法与加法(addr * 256 + byte)或配合BigInt保证精度。 - 源映射与友好错误提示:在符号表项中务必记录
declarationLine,并在补丁项中记录引用发生时的line与column。当发现重复定义或未定义标识符时,能够直接指出“第 42 行引用的标号从未声明”,而不是抛出冰冷的空指针异常。
JS数组基础取值:索引访问与解构赋值用法
2026-11-22 23:13:50
JS数组sort()默认字符串排序行为及自定义比较函数
2026-11-22 21:31:16
JS动态计算rowspan实现表格行合并算法
2026-11-22 21:20:02
JS转换JSON时Date、undefined等特殊类型丢失的处理方案
2026-11-22 20:48:53
JS数组sort默认按字符串排序?数字排序的正确写法
2026-11-22 16:49:06