

JS数组基础取值:索引访问与解构赋值用法
深入讲解JavaScript数组基础取值的两种核心方式:基于偏移量的索引访问与基于模式匹配的解构赋值。涵盖从0基索引、越界处理、at()方法,到位置解包、跳过元素、默认值触发规则与安全防御规范。
在 JavaScript 开发中,数组(Array)是最基础且使用频率最高的数据结构之一。从数组中提取目标数据通常有两种核心范式:传统的索引访问(Index Access)与 ES6+ 引入的解构赋值(Destructuring Assignment)。前者基于元素在物理连续槽位中的非负整数偏移量实现单点精确寻址;后者则通过直观的模式匹配(Pattern Matching)语法,将数组内部的多个元素批量拆包并直接赋予独立变量。理解这两种机制的工作原理、语法边界以及各自适用的场景,是编写高可读性、高健壮性前端与服务端代码的重要基石。
一、索引访问:基于偏移量的精准单值获取
JavaScript 的数组在底层实现上是特殊的对象,其内部键名为连续的非负整数字符串。通过方括号配合数值下标(即 arr[index]),可以以 $O(1)$ 的时间复杂度快速提取指定槽位中的值。
1. 零基索引与基础读写
JavaScript 数组采用以 0 为起始基准的零基索引(Zero-based Indexing)。第一个元素的索引为 0,第 $n$ 个元素的索引则为 $n - 1$。
const frameworks = ["React", "Vue", "Angular", "Svelte"];

// 读取首项元素
const first = frameworks[0];  // "React"

// 读取第三项元素
const third = frameworks[2];  // "Angular"
2. 越界访问的静默特性与潜在风险
在许多强类型静态语言(如 C++、Java)中,访问超出数组长度的索引会立即触发越界异常(如 ArrayIndexOutOfBoundsException)。而在 JavaScript 中,尝试读取不存在的索引位置绝不会抛出异常,而是直接静默返回 undefined。
const colors = ["red", "blue"];

console.log(colors[5]); // 输出:undefined(不报错)colors[5] 本身不会报错,但如果业务代码对返回结果假定为有效对象并直接调用方法(例如 colors[5].toUpperCase()),系统将立即抛出著名的致命错误:TypeError: Cannot read properties of undefined。在需要处理不可控长度的数组时,务必使用可选链操作符 colors[5]?.toUpperCase() 进行安全防护。
3. 尾部元素读取:传统 length 减一与现代 at() 方法
在原生方括号语法中,由于方括号内的负数会被视为普通对象的字符串属性名(例如 arr[-1] 实际查找的是键为 "-1" 的对象属性,而非倒数第一个数组元素),传统上获取末尾元素必须计算数组长度减一:
const items = ["A", "B", "C", "D"];

// 传统写法:需重复书写变量名以计算偏移量
const lastItemTraditional = items[items.length - 1]; // "D"
为了解决长变量名下取尾代码冗长、可读性差的痛点,ECMAScript 2022(ES13)正式引入了 Array.prototype.at() 方法。当传入负整数时,.at() 会自动从尾部反向计数:
// 现代写法:优雅提取倒数第一项与倒数第二项
const lastItem = items.at(-1);     // "D"
const secondLast = items.at(-2);   // "C"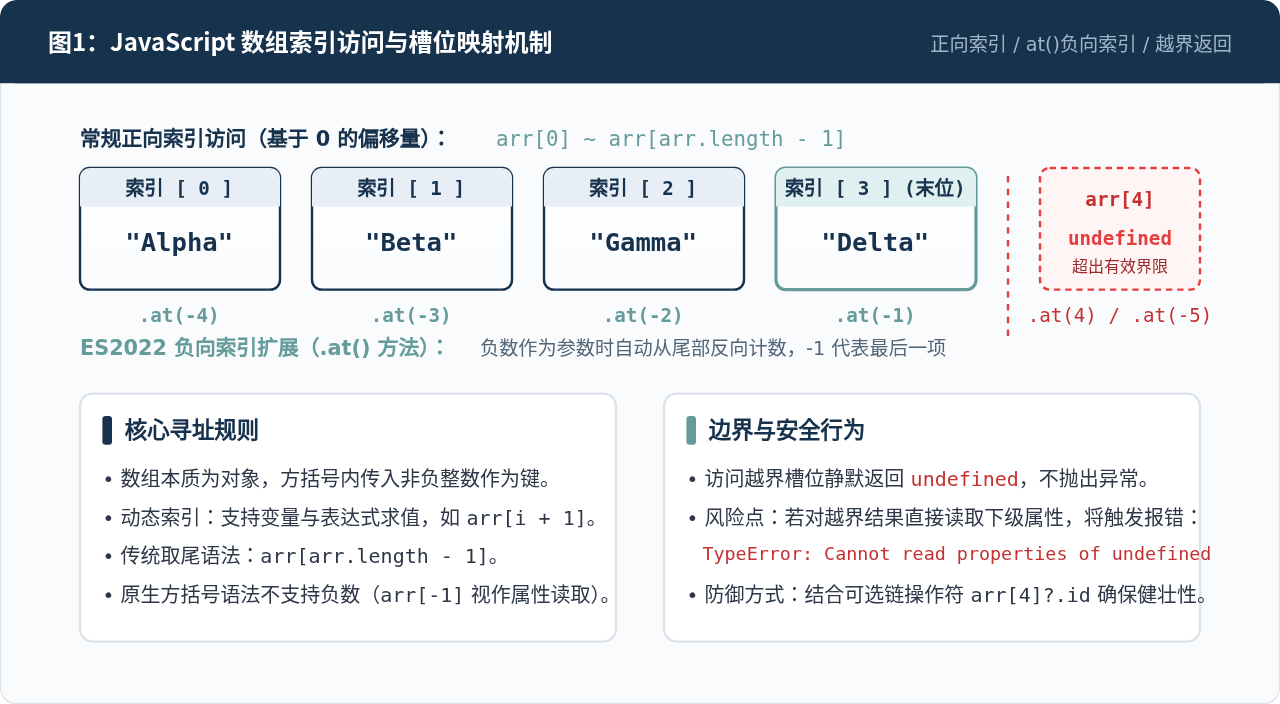
4. 动态索引与表达式计算
索引访问的一大核心优势在于其动态计算能力。方括号中不仅可以放置固定整数字面量,还可以放置任何变量、数学表达式或函数调用返回值,这是解构赋值无法原生替代的能力:
const scores = [88, 92, 79, 95, 84];

// 在循环或动态偏移场景中按需访问
for (let i = 0; i < scores.length; i++) {
  const current = scores[i];
  const next = scores[i + 1]; // 动态表达式寻址
  console.log(`当前: ${current}, 下一项: ${next ?? "无"}`);
}
二、解构赋值:基于模式匹配的多值与结构提取
ES6(ECMAScript 2015)引入的数组解构赋值,彻底改变了以往多值提取时必须反复书写 arr[0]、arr[1] 的机械繁琐。它允许开发者在赋值语句的左侧构建一个“形状匹配模板”,引擎将自动遍历右侧的数据迭代器,将各槽位的值一次性绑定至目标变量中。
1. 基础语法与位置对齐
解构赋值依据元素出现的先后顺序进行绑定。左侧括号内的每一个变量名,严格对应数组中相同序数位置的元素:
const coordinate = [120.15, 30.28, 15.0];

// 一步到位提取经度、纬度与海拔
const [longitude, latitude, altitude] = coordinate;

console.log(longitude); // 120.15
console.log(latitude);  // 30.28
console.log(altitude);  // 15.0
2. 逗号占位跳过非必要元素
当只需要提取数组中的某几个分散元素时,无需为无关项声明无用的临时变量。在解构模式中直接保留逗号(,)即可指示引擎跳过该位置:
const httpResponse = [200, "OK", { id: 1001, name: "Alice" }];

// 跳过索引 1("OK"),直接获取状态码与主体数据
const [statusCode, , payload] = httpResponse;

console.log(statusCode); // 200
console.log(payload.name); // "Alice"
3. 默认值兜底:严格的全等判定机制
当目标位置在数组中不存在,或者对应的值为 undefined 时,可以通过等号(=)指定默认回退值:
const tags = ["Frontend"];

const [primaryTag, secondaryTag = "General"] = tags;
console.log(secondaryTag); // "General"(成功触发默认值)value === undefined。如果数组槽位中显式存储了 null、0、false 或空字符串 "",这些都被视为有效数据,绝不会触发默认值!
const [val1 = 100] = [null];
console.log(val1); // 结果依然是 null,而不是 100!
4. 剩余元素模式(Rest Operator)
借助三点运算符(...rest),可以将数组头部项取出后,将其余所有未匹配的元素自动归集为一个全新的独立数组:
const queue = ["HeaderTask", "TaskA", "TaskB", "TaskC"];

const [currentTask, ...remainingTasks] = queue;
console.log(currentTask);     // "HeaderTask"
console.log(remainingTasks); // ["TaskA", "TaskB", "TaskC"]
需要特别强调:...rest 模式必须放置在解构列表的最末位。在 rest 之后若存在任何其他变量或逗号(如 [...head, tail]),解析器将直接抛出 SyntaxError: Rest element must be last element。
5. 原生变量交换应用
在传统语法中交换两个变量的值需要引入临时中介变量 temp。利用数组解构赋值,可以在一行内优雅完成值交换,逻辑紧凑且不存在变量污染:
let left = "左侧内容";
let right = "右侧内容";

// 快速交换两个变量的值
[left, right] = [right, left];

console.log(left);  // "右侧内容"
console.log(right); // "左侧内容"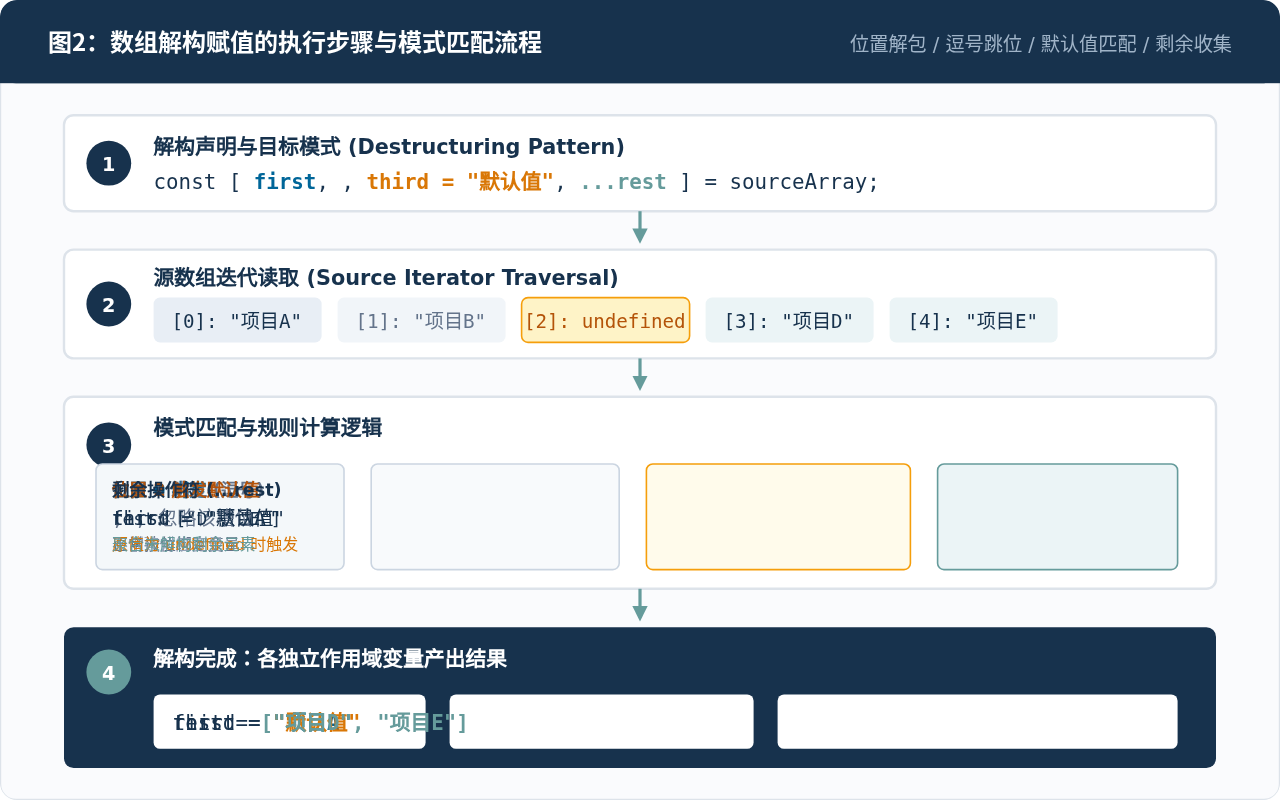
三、两种取值方式的差异对比与选型指南
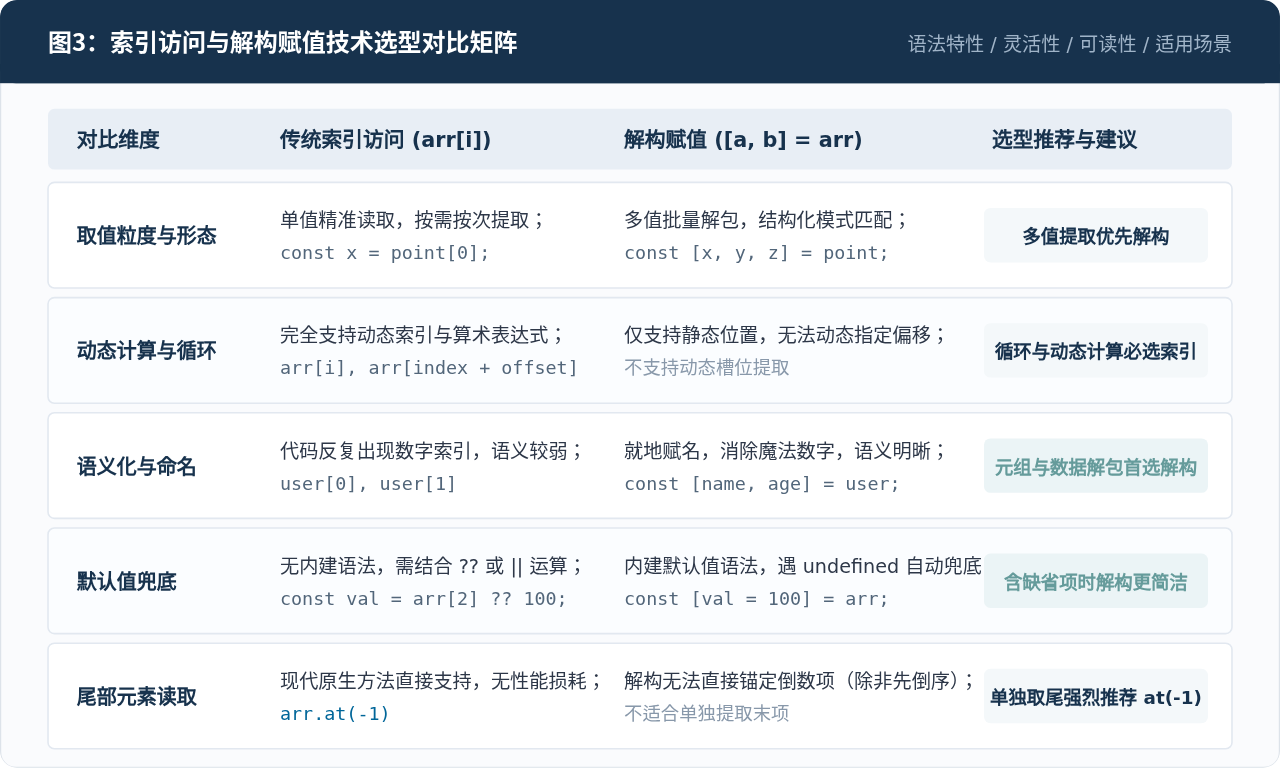
索引访问与解构赋值并不是非此即彼的对立关系,而是相互补充的两种工具。为了在实际工程中做出恰当的技术选型,可以参考下述多维度特性对比:
| 评估维度 | 索引访问(arr[i] / at()) | 解构赋值([a, b] = arr) | 选型推荐与最佳实践 |
|---|---|---|---|
| 取值粒度 | 单值按需获取,代码随处读取 | 多值批量提取,声明与绑定同步 | 仅提取 1 个值优先索引;提取 2 个及以上关联项优先解构 |
| 动态计算 | 支持变量、算术表达式与循环 | 仅支持静态位置模板,无法动态计算 | 遍历、排序、滑动窗口等动态场景必须使用索引访问 |
| 代码语义化 | 代码中频繁出现 arr[0] 等魔法数字 |
直接赋予具名变量,自解释性强 | 元组、坐标、函数返回的复合结果优先解构赋予语义 |
| 默认值支持 | 需配合 ?? 或 || 操作符 |
内建 = 默认值 语法,精炼直观 |
多项可能缺省的数据流解构更加干净整洁 |
| 尾部项读取 | arr.at(-1) 一步直达,性能优异 |
需先反转或复制数组,开销过大 | 仅需尾项时强烈建议使用 arr.at(-1) |
实际工程中的经典选型场景
-
解构赋值的高频场景:
- React Hooks 状态解包:例如
const [state, setState] = useState(initialValue);,数组解构让调用方可以自由对状态与更新函数命名。 - 字符串分割或正则匹配提取:例如
const [key, value] = cookieStr.split("=");,直接拆分为名值对。 - 多返回值函数:返回元组
[err, data]风格的异步错误处理模式。 - 首尾分离算法:例如
const [pivot, ...rest] = list;快速拆分基准元素与余下子集。
- React Hooks 状态解包:例如
-
索引访问的高频场景:
- 算法与密集循环:在
for (let i = 0; i < len; i++)中通过matrix[r][c]高频快速寻址。 - 状态栈或队列查看:通过
tokens.at(-1)查看栈顶元素而不弹出。 - 基于字典或哈希表索引映射:直接根据计算后的 hash 键定位槽位。
- 算法与密集循环:在
四、常见陷阱与防御性编码规范
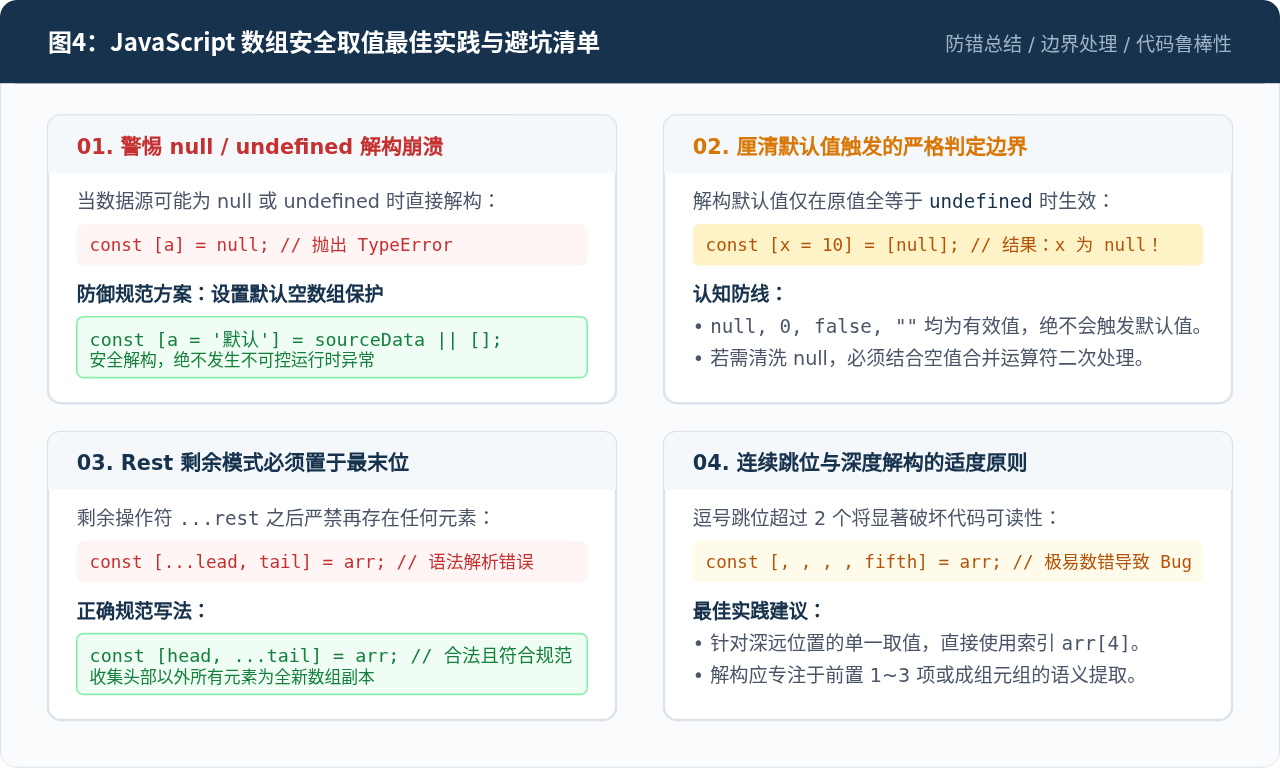
在编写生产环境代码时,因为边界条件不严密导致的 JavaScript 运行时崩溃屡见不鲜。以下整理了数组取值时最容易遭遇的四类问题及防御方案。
1. 防范 null 与 undefined 的解构崩溃
解构赋值底层依赖于目标对象的 [Symbol.iterator] 协议。如果尝试对 null 或 undefined 执行解构,JavaScript 引擎会立即抛出 TypeError:
// 危险:如果 fetchUserTags 返回 null,程序将崩溃
const [mainTag] = fetchUserTags(); // TypeError: fetchUserTags(...) is not iterable

// 安全规范:使用逻辑或(||)提供空数组作为防御底线
const [safeTag = "未分类"] = fetchUserTags() || [];
2. 避免过多连续逗号造成的“阅读车祸”
虽然逗号占位语法在跳过 1 个槽位时十分清晰,但一旦跳位超过 2 个,代码的可维护性将急剧下滑:
// 极差的代码风格:读者很难一眼数清到底跳过了几个元素
const [, , , , targetItem] = hugeList;

// 良好实践:对于较远位置的单值获取,直接使用清晰的索引访问
const targetItemClean = hugeList[4];
3. 稀疏数组(Sparse Array)中的空槽识别
使用 new Array(3) 或 [1, , 3] 创建的稀疏数组,其缺失的空槽位并不是显式的 undefined 值,而是未初始化的空洞(Hole)。
无论是使用 arr[1] 访问还是使用解构 const [, val] = arr,获取到的结果均为 undefined。但需要注意:如果是解构赋值,该空洞会成功触发预设的默认值;而若使用 arr.hasOwnProperty(1) 检测,该槽位返回的是 false。
五、总结与快速自查表
总结而言,JavaScript 数组取值体系兼具底层偏移寻址的效率与声明式解包的优雅:
- 取单值、动态值、查尾项:优先使用
arr[index]与arr.at(-1),表达直接、计算灵活、无冗余开销。 - 取多值、拆元组、赋语义:优先使用
const [a, b, ...rest] = arr,避免魔法数字,提升模块间数据传递的整洁度。 - 筑牢防御防线:对外部不可信输入始终结合
(source || [])兜底解构,对索引越界结合可选链arr[i]?.prop,确保线上代码在边界数据下始终保持稳健。
JavaScript实现汇编器时符号表管理与地址解析策略
2026-11-22 23:46:32
JS数组sort()默认字符串排序行为及自定义比较函数
2026-11-22 21:31:16
JS动态计算rowspan实现表格行合并算法
2026-11-22 21:20:02
JS转换JSON时Date、undefined等特殊类型丢失的处理方案
2026-11-22 20:48:53
JS数组sort默认按字符串排序?数字排序的正确写法
2026-11-22 16:49:06







