

JS遍历DOM节点列表:NodeList转数组与高效迭代方法
深入解析JavaScript中DOM节点列表NodeList的核心机制,详解NodeList转为标准数组的三种主流方案、四种高效迭代方法,以及动态与静态节点集合的遍历陷阱与最佳实践。
一、核心认知:NodeList 与标准 Array 的本质区别
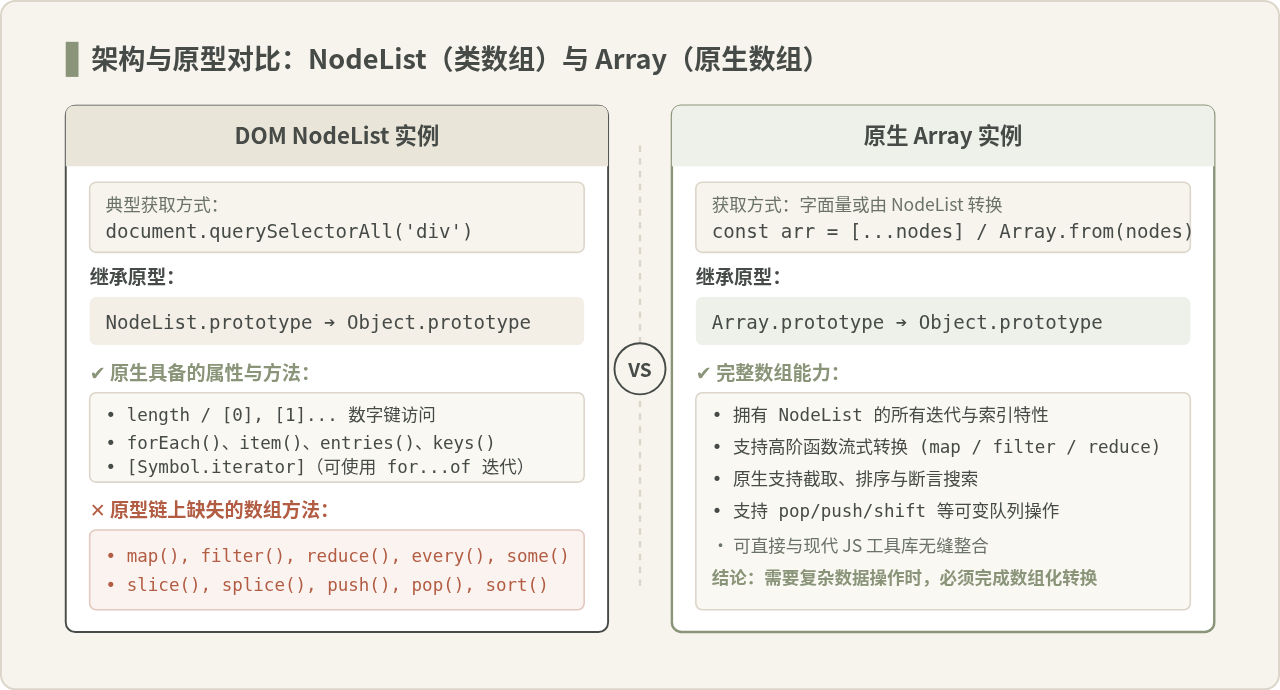
许多开发者在初学 DOM 操作时,经常容易把 NodeList 当作普通数组来使用。当尝试对 document.querySelectorAll('div') 的返回值直接调用 .map() 或 .filter() 时,控制台便会抛出 TypeError: ... is not a function 异常。这背后的根源在于两者的继承原型与对象构造完全不同。
从技术规范来看,NodeList 属于类数组对象(Array-like Object),同时它在现代 DOM 规范中实现了可迭代协议(Iterable)。它具有与数组相似的外在表现:
- 数字索引与 length 属性:可以通过
list[0]、list[1]访问节点,并能读取list.length获取节点总数; - 内置方法:拥有原生方法
item()、entries()、keys()、values()以及在现代浏览器中补齐的forEach(); - 支持
for...of:实现了[Symbol.iterator]接口,能够直接被for...of语法遍历。
然而,它的原型链终点是 NodeList.prototype ➔ Object.prototype,从未经过 Array.prototype。这就意味着它并不具备真正的数组变异(Mutation)与流式计算能力,包括 map()、filter()、reduce()、slice()、splice()、some()、every() 和 find() 等。
在早期的 DOM 规范(DOM Level 3 之前)中,NodeList 甚至连
forEach 都不支持,遍历它必须使用传统 for 循环。后来 W3C/WHATWG 在 DOM Level 4 标准中为 NodeList.prototype 单独增补了 forEach 实例方法,以提升常见遍历体验。但这只是单独补充的 API,NodeList 仍然独立于 Array,依然无法使用任何其他数组原型方法。
二、NodeList 转为标准数组的三种转换方法
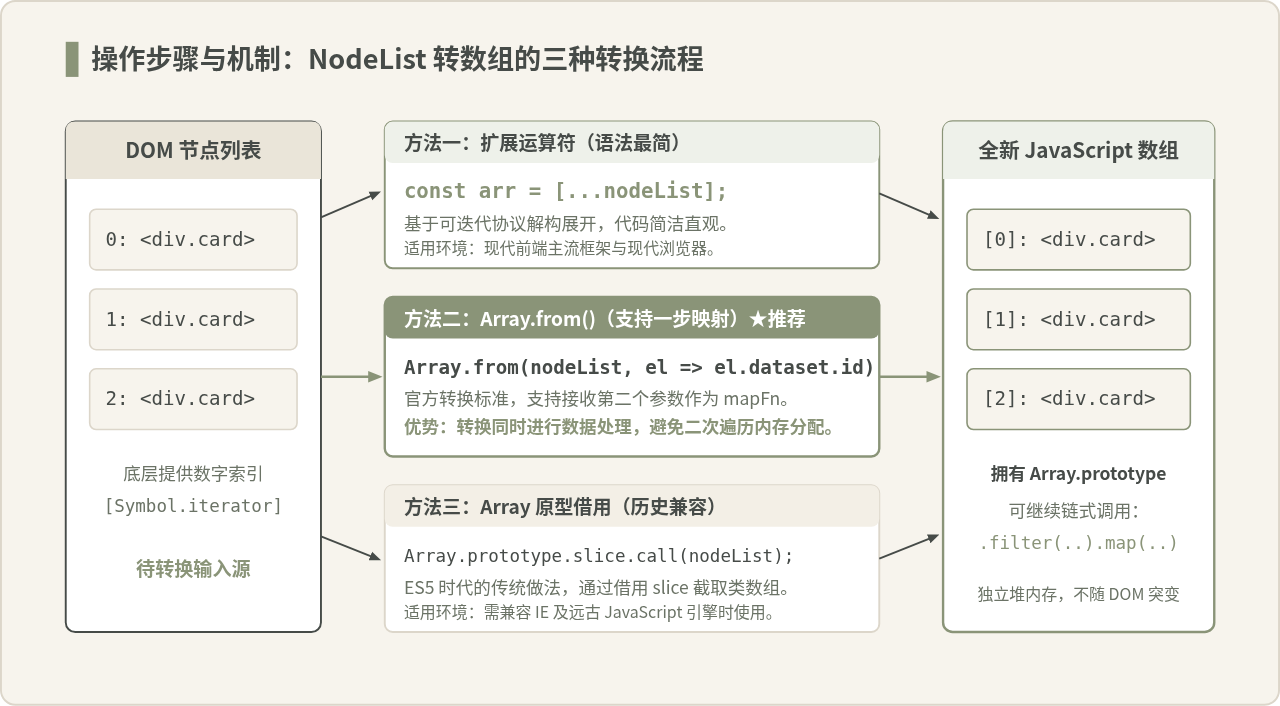
为了能够在节点集合上顺畅使用数组高阶方法,或者避免后续 DOM 结构动态变动干扰遍历逻辑,我们需要将 NodeList 转换为真正的 JavaScript 数组。在现代工程实践中,主要有以下三种转换路径:
1. 扩展运算符(Spread Syntax)
扩展运算符 [...nodeList] 是现代前端项目中最常用、语法最为简练的方式。其底层依赖于 NodeList 的 [Symbol.iterator] 迭代器协议,将集合中的每个节点逐一解构到新的数组字面量中。
// 1. 获取所有待处理元素
const nodeList = document.querySelectorAll('.card-item');

// 2. 使用扩展运算符转为标准数组
const cardArray = [...nodeList];

// 3. 顺畅使用数组链式高阶函数
const activeCardTitles = cardArray
  .filter(card => card.classList.contains('active'))
  .map(card => card.querySelector('h3').textContent.trim());

console.log(activeCardTitles); // 得到过滤并提取后的纯文本数组
扩展运算符代码紧凑,与 ES6 现代语法风格高度契合。只要运行环境支持 ES6(或经由 Babel/TypeScript 编译),这就是日常开发的首选语法。
2. Array.from() 标准方法(推荐用于带二次映射场景)
Array.from() 是 ES6 专门为类数组对象和可迭代对象设计的官方构造方法。与扩展运算符相比,它具备一个关键特权:支持传入第二个参数作为映射函数(mapFn)。
const nodeList = document.querySelectorAll('button[data-action]');

// 传统做法:先转数组,再调用 .map(),会创建两个中间数组
// const actions = [...nodeList].map(btn => btn.dataset.action);

// 优化做法:在 Array.from 转换的同时完成数据提取,单次遍历,性能更佳
const actions = Array.from(nodeList, btn => btn.dataset.action);

console.log(actions); // 示例输出: ['save', 'cancel', 'delete']
使用 Array.from(nodeList, mapFn) 可以直接在转换过程中生成目标数据结构,无需先在堆内存中分配一个 DOM 节点临时数组然后再跑一次 .map(),这在处理大量节点且只需要提取部分属性时尤其高效。
3. Array.prototype.slice.call()(经典兼容方案)
在 ES6 普及之前的时代,前端通常通过借用 Array.prototype.slice 方法来实现类数组转数组。因为 slice 内部仅依赖对象的数字索引和 length 属性,因此可以通过 call 或 apply 借调给 NodeList。
var nodeList = document.querySelectorAll('.legacy-item');

// ES5 原型借用方案
var nodeArr = Array.prototype.slice.call(nodeList);

// 或通过空数组字面量借用(写法略短)
var nodeArrShort = [].slice.call(nodeList);
该方法语法较为冗长且可读性较弱,现代开发中已极少主动书写。但在需要直接维护不支持 ES6 的遗留旧系统或未配置转译工具的环境中,它依然是可靠的兜底手段。
| 转换方案 | 适用标准 | 语法可读性 | 是否支持一步映射 | 推荐场景 |
|---|---|---|---|---|
[...nodeList] |
ES2015+ | 极佳 | 否(需后续链式调用) | 日常绝大多数常规转换场景 |
Array.from(nodeList, fn) |
ES2015+ | 优秀 | 支持(原生内置) | 需要转换并同时提取属性的高效处理 |
Array.prototype.slice.call() |
ES3/ES5 | 较差 | 否 | 遗留古老项目或无 Babel 编译环境兜底 |
三、高效遍历 NodeList 的四种方式与适用边界
并非所有场景都必须先将 NodeList 转为数组。如果业务逻辑仅仅是按顺序读取节点信息、修改类名或绑定事件监听,直接对 NodeList 进行遍历往往更加轻量。选择哪种迭代方式,取决于控制流的复杂程度与性能要求。
1. 直接使用 nodeList.forEach()
现代浏览器环境直接支持 nodeList.forEach(),其签名与数组的 forEach 完全一致,接收 (currentValue, currentIndex, listObj) 回调。
const sections = document.querySelectorAll('main section');

sections.forEach((section, index) => {
  section.setAttribute('data-index', String(index + 1));
  section.classList.add('rendered');
});
适用边界与限制:forEach 的最大限制在于它无法通过 break、continue 或 return 提前中断或跳过循环。如果只是为了查找某一个满足条件的节点,继续使用 forEach 会导致无谓的全量遍历。此外,在 forEach 回调函数中放置 await 无法实现真正的串行阻塞等待。
2. 使用 for...of 循环迭代(综合控制力最强)
因为 NodeList 实现了迭代器协议,for...of 可以原生无缝运行在 NodeList 之上。它是需要灵活控制流时最推荐的写法:
const inputs = document.querySelectorAll('form input[required]');

// 场景 A:命中条件即可提前退出,避免冗余运算
for (const input of inputs) {
  if (!input.value.trim()) {
    input.focus();
    input.classList.add('is-invalid');
    console.warn('发现首个未填写字段,提前跳出循环');
    break; // ✔ 完美支持 break 提前终止
  }
}

// 场景 B:在循环体中优雅处理异步串行操作
async function animateElementsSequentially(nodes) {
  for (const node of nodes) {
    node.classList.add('fade-in');
    // 串行等待当前节点动画结束,再进行下一个节点
    await new Promise(resolve => setTimeout(resolve, 200));
  }
}
for...of 既不需要将 NodeList 复制为数组,又具备语句级控制能力(break、continue、return),并且与 async/await 配合得天衣无缝。
3. 传统 for 循环(带长度缓存的极限性能方案)
在绝大多数常规前端交互中,各种遍历方式的执行速度都在亚毫秒级别,差别微乎其微。但在涉及上万个 DOM 节点的复杂数据可视化、虚拟滚动列表或游戏渲染等性能敏感路径中,传统的带长度缓存的 for 循环依然是执行开销最低的选择。
const items = document.querySelectorAll('.data-row');

// 优化点:在初始化表达式中同时缓存 items.length
// 避免在每次循环迭代时重复通过 getter 访问 length 属性
for (let i = 0, len = items.length; i < len; i++) {
  const item = items[i];
  // 执行密集计算或样式修改
  item.style.transform = `translateY(${i * 32}px)`;
}
4. 数组化后的链式操作(声明式数据流)
当业务目标是将 DOM 列表转换为特定结构的数据集合时,先使用 [...nodeList] 转为数组,再配合 .filter().map().reduce() 能够写出声明式、易测试、低副作用的高质量代码。
// 统计页面中所有已选商品的单价总和
const totalPrice = [...document.querySelectorAll('.cart-item')]
  .filter(item => item.querySelector('input[type="checkbox"]').checked)
  .map(item => parseFloat(item.dataset.price || '0'))
  .reduce((sum, price) => sum + price, 0);

console.log(`总金额: ¥${totalPrice.toFixed(2)}`);
四、关键陷阱与易错场景深度辨析
在处理 DOM 集合时,许多隐蔽 Bug 并非源于语法错误,而是源于对底层集合机制的误判。以下三个场景是实际开发中最高频的错误点。
1. 陷阱一:严禁使用 for...in 遍历 NodeList
初学者有时会混淆 for...of 与 for...in。for...in 是用来枚举对象可枚举属性的语法。当对 NodeList 使用 for...in 时,它不仅会遍历出 0, 1, 2 等数字键,还会遍历出集合原型上的属性与方法名称!
const items = document.querySelectorAll('.item');
// ❌ 错误做法:使用 for...in
for (const key in items) {
  console.log(key);
  // 输出不仅有 "0", "1", "2",还有 "length", "item", "forEach", "entries"...
  // 如果在循环中盲目当做节点操作:items[key].classList.add(...)
  // 会直接抛出 Uncaught TypeError: Cannot read properties of undefined!
}for...of、forEach 或常规 for,绝对不要使用 for...in。
2. 陷阱二:动态 NodeList 在遍历中修改 DOM 引发的跳项与死循环
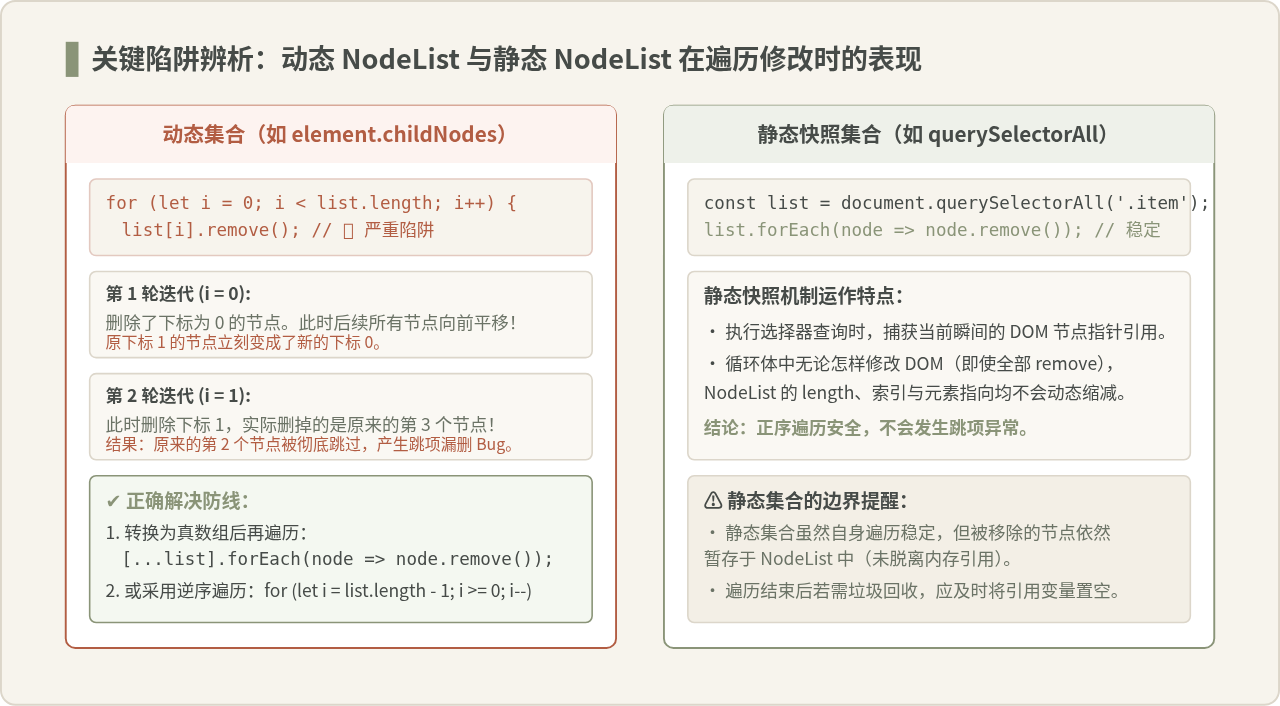
NodeList 存在静态快照(Static)与动态实时(Live)两种本质形态:
- 静态 NodeList:由
document.querySelectorAll()返回。它是在调用时捕获的快照,后续对 DOM 的增删不会改变该集合的元素指针; - 动态 NodeList:由
element.childNodes返回(类似地,getElementsByTagName返回的HTMLCollection也是动态的)。底层任何对 DOM 树的变动,都会实时反映在该集合中!
如果在正序循环中直接移除动态集合中的节点,就会引发严重的“漏删”跳项问题:
const container = document.getElementById('list-container');
const children = container.childNodes; // ⚠️ 注意:这是动态 Live NodeList!

// ❌ 错误示范:在正序遍历中删除
for (let i = 0; i < children.length; i++) {
  children[i].remove();
  // 当 i=0 被删除后,原来下标为 1 的节点立刻前移变为新的下标 0;
  // 下一轮循环 i 递增为 1,直接访问了原本的第 3 个节点!
  // 最终导致原来下标为 1、3、5 的节点全部被跳过,无法删干净。
}

// ✔ 正确解法 A:转换为真正的静态数组再遍历删除
[...children].forEach(node => node.remove());

// ✔ 正确解法 B:采用逆序遍历(从末尾向前删)
for (let i = children.length - 1; i >= 0; i--) {
  children[i].remove();
}
3. 陷阱三:混淆 NodeList 与 HTMLCollection
在 DOM API 中,还有另一个常见类数组——HTMLCollection(通过 getElementsByClassName 或 getElementsByTagName 获取)。与 NodeList 相比,HTMLCollection 只包含元素节点(不含文本与注释节点),且始终是动态实时集合。更重要的是,在一些旧环境或特定标准中,HTMLCollection.prototype 并未统一提供 forEach 方法。
在遇到 HTMLCollection 时,最安全稳妥的方式就是统一使用 [...collection] 或 Array.from(collection) 先行转为标准数组,从而抹平所有环境差异。
五、场景化选型指南与工程最佳实践
结合现代 JavaScript 规范与不同业务诉求,下表总结了在面对 DOM 节点列表时的黄金选型准则:
| 业务目标 | 推荐语法方案 | 选用理由与优势 |
|---|---|---|
| 全量只读访问或绑定事件 | nodeList.forEach((el, i) => { ... }) |
开箱即用,代码语义直接,无任何数组分配开销。 |
| 条件检索、需提前终止 (break) | for (const el of nodeList) |
支持 break 与 return,避免全量空转。 |
| 节点间需要串行异步等待 (await) | for (const el of nodeList) { await fn(el); } |
原生的语言级异步支持,代码逻辑线性清晰。 |
| 抽取节点属性生成纯数据数组 | Array.from(nodeList, el => el.value) |
单次遍历完成内存分配与属性提取,性能与可读性兼备。 |
| 多维度条件过滤与链式变换 | [...nodeList].filter(...).map(...) |
现代解构语法,完全释放 Array.prototype 链式表达力。 |
| 遍历中需要新增、删除子节点 | 强制转为静态真数组 [...nodeList] 后再操作 |
彻底切断与 DOM 树的动态联动,彻底杜绝跳项与死循环。 |
六、总结
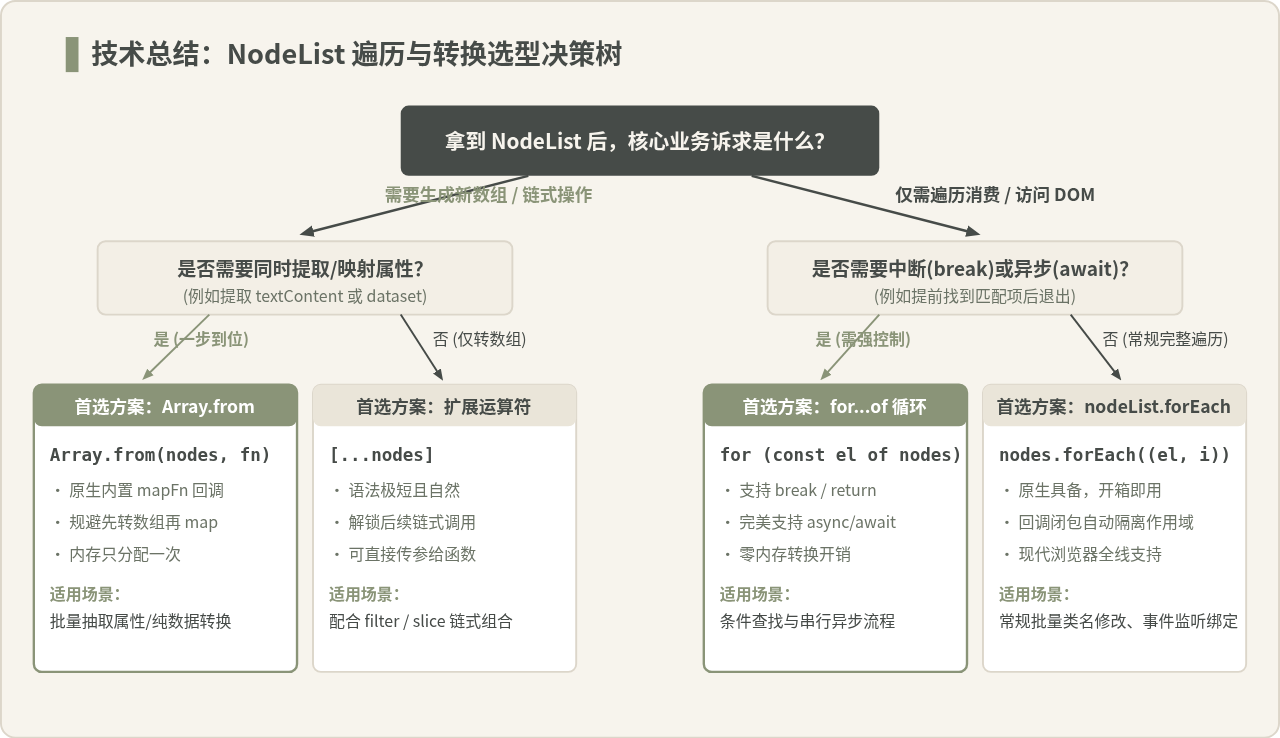
掌握 NodeList 的本质是写出健壮前端 DOM 操作代码的基础。虽然现代浏览器为 NodeList 赋予了 forEach 和可迭代特性,使得简单遍历变得轻便,但它依然不是真正的数组。
在日常开发中,应建立起明确的编码直觉:对于仅需遍历消费的操作,优先使用原生 nodeList.forEach 或控制力更强的 for...of;一旦涉及数据提取、条件过滤或动态 DOM 节点变动,果断使用 Array.from() 或扩展运算符 [...nodeList] 完成数组化。遵循这一逻辑,既能保证代码的执行效能,也能从根本上规避动态集合变动带来的各类隐蔽缺陷。
JS定时器不准怎么办?requestAnimationFrame高精度替代方案
2026-11-22 19:26:48
JavaScript获取复选框选中状态的方法
2026-11-22 17:25:01
JavaScript实现缩略图点击放大预览效果
2026-11-22 10:43:23
JS验证码点击刷新与前端校验逻辑怎么实现
2026-11-22 09:10:35
手写带省略号和跳转功能的复杂JS分页控件
2026-11-22 08:09:46







