

JavaScript解析带命名空间的XML标签方法
深入讲解在JavaScript中解析带命名空间(Namespace)的XML标签的标准方法。分析常规查询失效的底层原因,详细演示DOMParser、getElementsByTagNameNS、XPath与NSResolver的实际代码实现与异常排查。
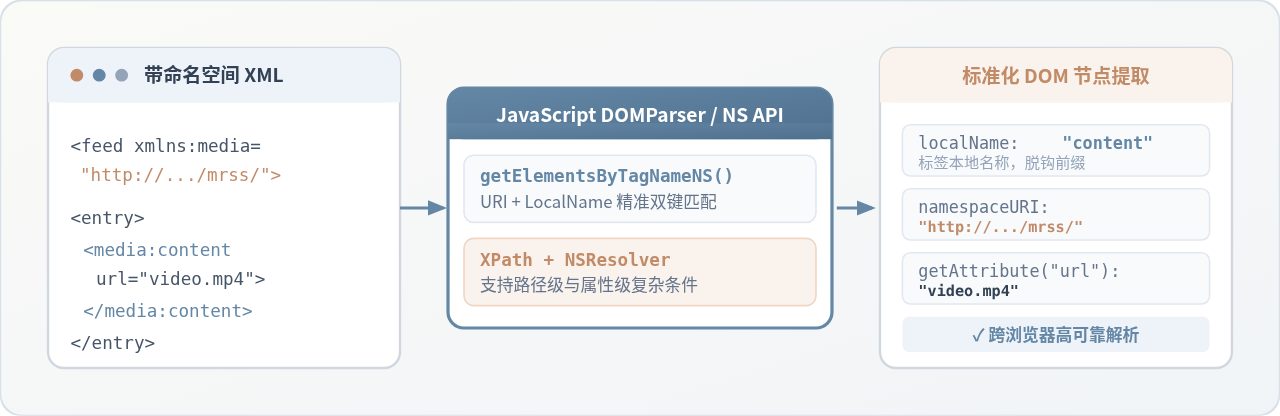
getElementsByTagName('prefix:tag') 或未转义的 querySelector 会因为缺少命名空间上下文而返回空集合或抛出语法错误。解决该问题的标准核心方法是:通过 DOMParser 解析为 XML 文档对象后,优先使用 W3C DOM Level 2 标准的 getElementsByTagNameNS(namespaceURI, localName) 方法;在需要深层路径或属性联合筛选时,使用 document.evaluate(XPath)配合自定义命名空间解析函数(NSResolver)。
一、XML 命名空间机制与常规查询失效原因
XML 命名空间的主要目的是避免在同一文档或多个合并文档中发生元素命名冲突。例如在 Atom Feed、Media RSS、SVG 或 SOAP 协议中,经常出现如下形式的标签:
<feed xmlns="http://www.w3.org/2005/Atom"
      xmlns:media="http://search.yahoo.com/mrss/">
  <entry>
    <title>示例文章</title>
    <media:content url="https://example.com/video.mp4" medium="video">
      <media:thumbnail url="https://example.com/poster.jpg" />
    </media:content>
  </entry>
</feed>
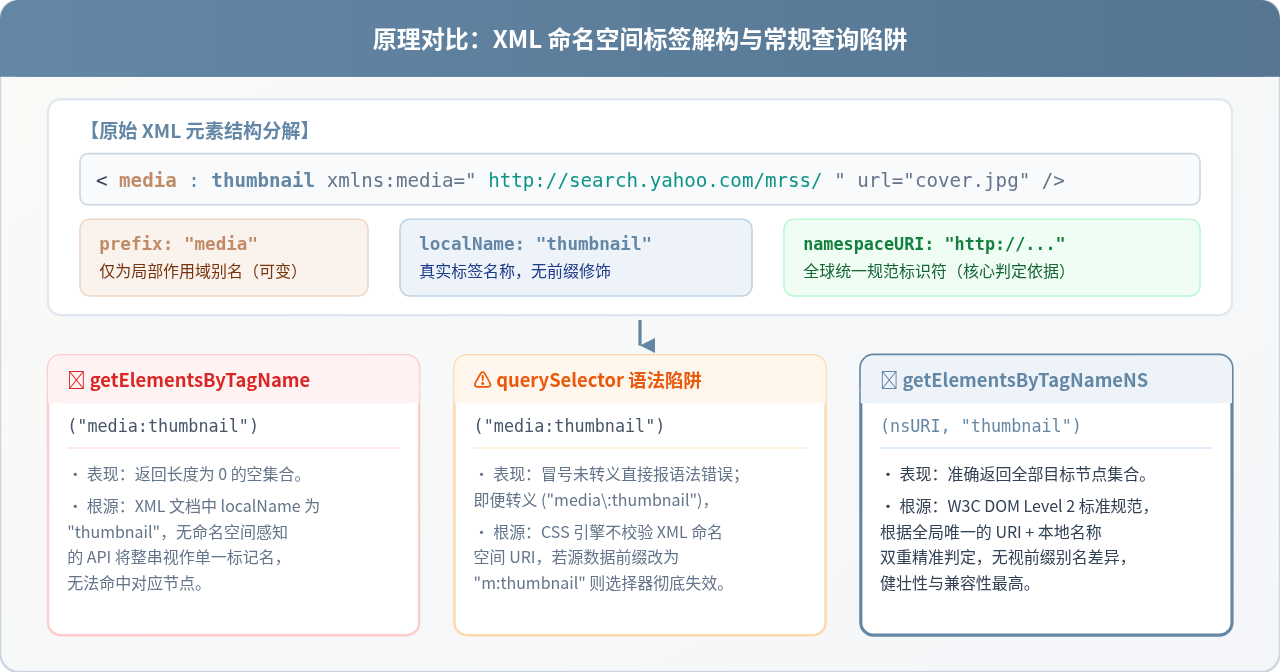
当浏览器通过 DOMParser 以 application/xml 模式解析上述字符串时,DOM 树会将每个节点解构为三个独立维度的属性:
- prefix:前缀别名(如
media),它仅在当前文档作用域内充当命名空间的缩写代号。 - localName:本地标签名称(如
thumbnail),不包含前缀。 - namespaceURI:全局唯一的命名空间统一资源标识符(如
http://search.yahoo.com/mrss/)。
初学者尝试读取 <media:thumbnail> 时,常见的两种失败现象及原因如下:
- 使用
getElementsByTagName("media:thumbnail")返回空集合:在符合规范的 XML DOM 中,元素的标签匹配依循本地名称,纯字符串匹配无法将media:thumbnail自动拆分为对应命名空间和本地名称,因此查找失败。 - 使用
querySelector("media:thumbnail")抛出语法错误:CSS 选择器标准中冒号:被保留为伪类标识符(如:hover、:first-child)。传入未转义的冒号会导致解析引擎报错DOMException: Failed to execute 'querySelector';即使采用双反斜杠转义写成querySelector("media\:thumbnail"),该选择器也仅在文本层面做前缀匹配,一旦提供方更换前缀(如将xmlns:media改为xmlns:m),选择器将彻底失效。
二、标准解析方法一:使用 getElementsByTagNameNS(推荐与最高效)
W3C DOM Level 2 规范专门针对命名空间文档提供了 getElementsByTagNameNS 方法。该方法接收两个参数:目标命名空间的完整 URI 以及本地标签名(localName)。由于它是基于全球唯一的 URI 进行精准绑定,因此不受源文档前缀命名的影响,稳定性最高。
1. 完整操作步骤与代码实现
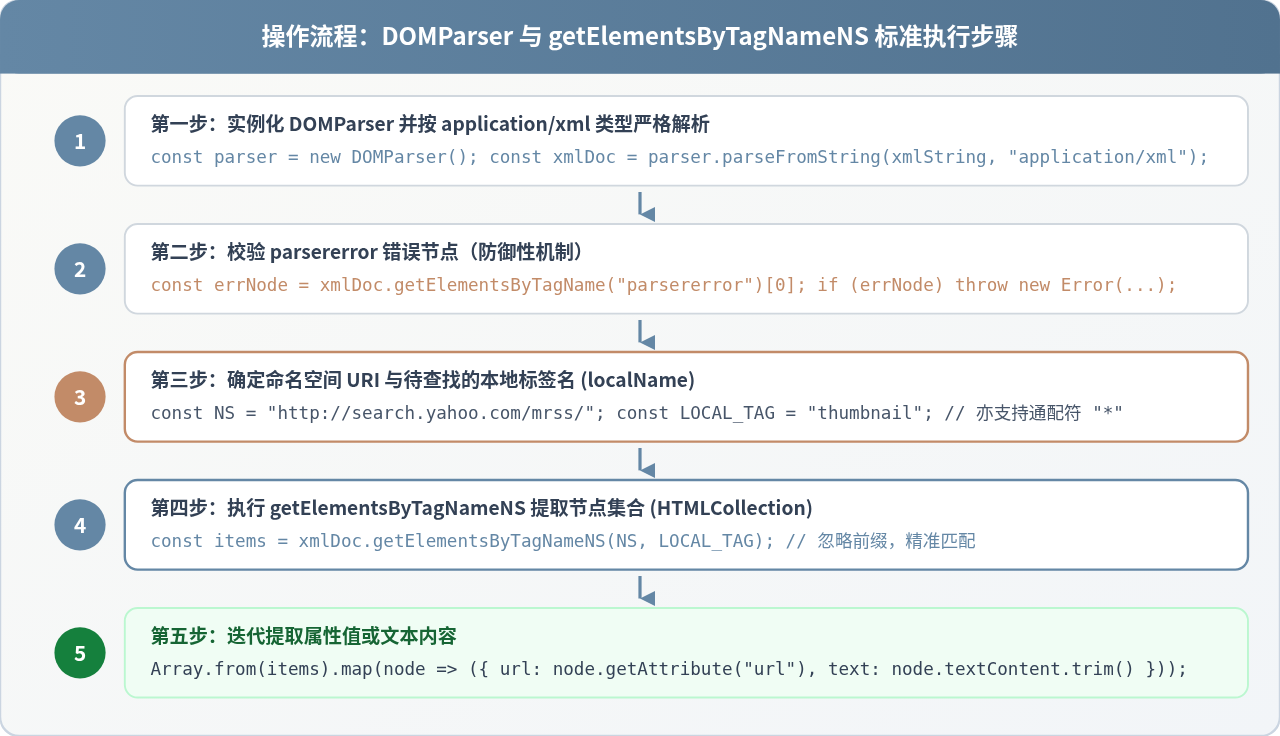
实现带命名空间 XML 标签解析的标准五步流程如下:
- 实例化
DOMParser,传入原始 XML 字符串并指定 MIME 类型为application/xml。 - 防御性校验返回文档根节点是否包含
parsererror,防止 XML 截断或格式损坏。 - 明确对应规范的命名空间 URI 与需要提取的
localName。 - 在文档或父节点上调用
getElementsByTagNameNS(namespaceURI, localName)获取节点列表。 - 遍历返回的
HTMLCollection,通过getAttribute()或textContent提取目标数据。
/**
 * 解析带命名空间的 Media RSS XML
 * @param {string} xmlString XML文本数据
 */
function parseMediaRss(xmlString) {
  // 第一步:实例化 DOMParser
  const parser = new DOMParser();
  const xmlDoc = parser.parseFromString(xmlString, "application/xml");

  // 第二步:检查解析错误
  const parseError = xmlDoc.getElementsByTagName("parsererror")[0];
  if (parseError) {
    throw new Error("XML 解析失败: " + parseError.textContent);
  }

  // 第三步:定义目标命名空间 URI 与本地名
  const MEDIA_NS = "http://search.yahoo.com/mrss/";
  const ATOM_NS = "http://www.w3.org/2005/Atom";

  // 第四步:使用 getElementsByTagNameNS 查询
  // 提取默认命名空间下的 entry(若有默认命名空间,需传入 Atom URI)
  const entries = xmlDoc.getElementsByTagNameNS(ATOM_NS, "entry");

  const results = [];

  for (let i = 0; i < entries.length; i++) {
    const entry = entries[i];

    // 从 entry 子作用域中提取 media:content 与 media:thumbnail
    const mediaContents = entry.getElementsByTagNameNS(MEDIA_NS, "content");
    const thumbnails = entry.getElementsByTagNameNS(MEDIA_NS, "thumbnail");

    const mediaList = Array.from(mediaContents).map(item => ({
      url: item.getAttribute("url"),
      medium: item.getAttribute("medium")
    }));

    const thumbList = Array.from(thumbnails).map(item => ({
      url: item.getAttribute("url")
    }));

    results.push({
      media: mediaList,
      thumbnails: thumbList
    });
  }

  return results;
}
"*":const nodes = xmlDoc.getElementsByTagNameNS("*", "thumbnail");该语句会检索整个文档中所有
localName 为 "thumbnail" 的元素,无论其前缀或命名空间属于何方。
三、标准解析方法二:使用 XPath 与自定义 NSResolver(复杂层级查询)
当面对层级结构较深、需要结合父子轴、同级关系或特定属性组合进行条件过滤时,单纯使用 getElementsByTagNameNS 需要编写多层嵌套循环和判断代码。此时,现代浏览器原生支持的 document.evaluate(XPath)能够提供更加精炼且声明式的查询能力。
XPath 查询带命名空间标签的关键在于提供一个命名空间解析器(NSResolver),它是一个映射函数,负责将 XPath 表达式中出现的自定义前缀解析为实际的命名空间 URI。
1. XPath 核心语法与代码演示
/**
 * 通过 XPath 提取所有带 video 属性的 media:content 标签
 * @param {Document} xmlDoc 已解析的 XML 文档对象
 */
function queryMediaByXPath(xmlDoc) {
  // 1. 定义 XPath 表达式,前缀可自定义,但必须在 resolver 中有映射
  const xpathExpr = "//atom:entry/media:content[@medium='video']";

  // 2. 自定义命名空间解析函数 (NSResolver)
  const nsResolver = function(prefix) {
    const nsMap = {
      atom: "http://www.w3.org/2005/Atom",
      media: "http://search.yahoo.com/mrss/"
    };
    return nsMap[prefix] || null;
  };

  // 3. 执行 document.evaluate
  const snapshot = xmlDoc.evaluate(
    xpathExpr,
    xmlDoc,
    nsResolver,
    XPathResult.ORDERED_NODE_SNAPSHOT_TYPE,
    null
  );

  const matchedUrls = [];

  // 4. 遍历快照节点结果
  for (let i = 0; i < snapshot.snapshotLength; i++) {
    const node = snapshot.snapshotItem(i);
    matchedUrls.push(node.getAttribute("url"));
  }

  return matchedUrls;
}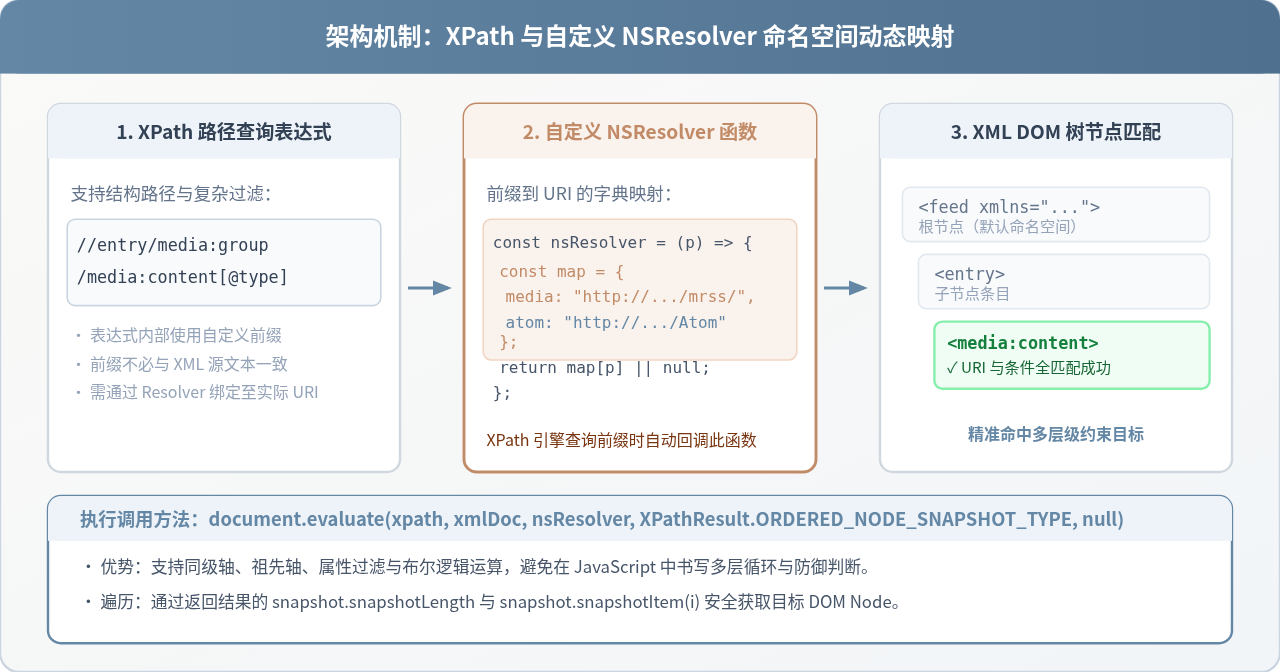
atom:)是用于驱动 nsResolver 查找 URI 的键名,并不要求与待解析 XML 源码中使用的前缀一致。只要 nsResolver("atom") 返回的 URI 与 XML 中定义的命名空间 URI 严格匹配,XPath 引擎就能正确定位元素。
四、兜底与边界处理:未知前缀、动态命名空间与原生属性过滤
在实际业务中,可能遇到上游服务端返回的 XML 前缀完全随机(例如同一个接口偶尔返回 <m:thumbnail>,偶尔返回 <media:thumbnail>,甚至未显式标注命名空间 URI)。针对这些边界情况,可以采取以下灵活方案:
1. 基于 localName 属性的原生过滤
每个 DOM 元素节点都会保留 localName 字段。在不知道 URI 或前缀不可预测时,可直接通过属性遍历进行筛选:
// 获取所有元素后按 localName 精准筛选
const allElements = xmlDoc.getElementsByTagName("*");
const thumbnails = Array.from(allElements).filter(el => el.localName === "thumbnail");

// 同时校验 namespaceURI(如果已知部分特征)
const mediaItems = Array.from(allElements).filter(el => {
  return el.localName === "content" &&
         el.namespaceURI?.includes("mrss");
});
2. Node.js 服务端环境适配
在 Node.js 环境中原生没有浏览器环境的 DOMParser 和 document.evaluate。在服务端处理命名空间 XML 时,推荐以下两种方案:
- 使用
@xmldom/xmldom:完整实现了 W3C DOM Level 2 规范,在 Node.js 中拥有与浏览器一致的DOMParser和getElementsByTagNameNS()API。 - 使用
fast-xml-parser:性能极高,在解析选项中开启removeNSPrefix: true可以自动剥离所有标签前缀,直接将 XML 转化为规整的 JavaScript JSON 对象。
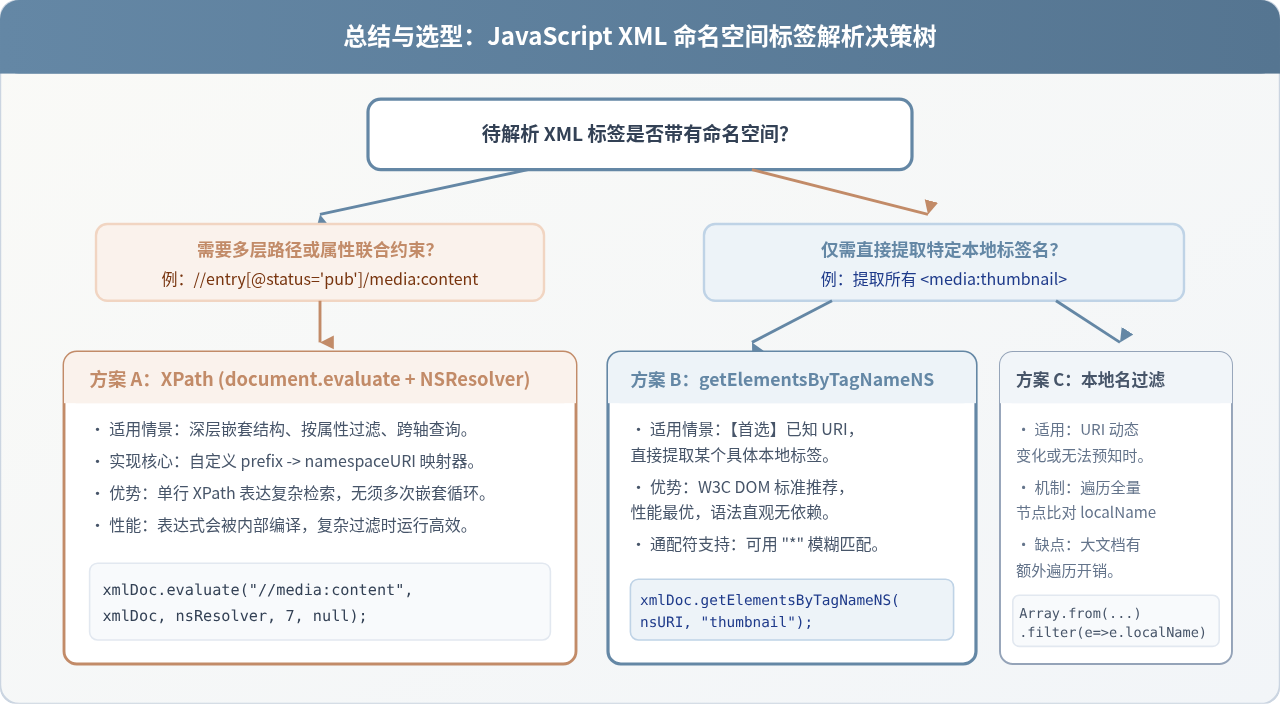
五、解析方法对比与选型指南
为了帮助读者根据实际项目需求快速选择最合适的技术路线,下表从多个维度对常用解析方法进行了系统对比:
| 解析方案 | 核心 API / 语法 | 命名空间解耦度 | 复杂层级筛选能力 | 推荐使用场景 |
|---|---|---|---|---|
| getElementsByTagNameNS | xmlDoc.getElementsByTagNameNS(URI, localName) |
完全解耦(按 URI + 本地名) | 基础(单标签直接拉取) | 【首选】已知明确命名空间 URI,读取特定标签及属性列表。 |
| XPath + NSResolver | xmlDoc.evaluate(xpath, xmlDoc, resolver, ...) |
完全解耦(通过映射表解析) | 极高(支持属性、同级与路径轴) | 多条件联合筛选、深层嵌套结构提取、复杂文档挖掘。 |
| 通配符 TagNameNS | xmlDoc.getElementsByTagNameNS("*", localName) |
忽略命名空间(仅匹配本地名) | 基础 | 命名空间 URI 经常变更或源文档声明不规范。 |
| 全量 DOM 过滤 | Array.from(all).filter(e => e.localName) |
手动编程控制 | 中等(依赖 JS 逻辑) | 轻量级临时抽取,不需要额外学习 API 的兜底场景。 |
六、常见问题与排错清单
- 大小写敏感性问题:与 HTML 不同,XML 是严格区分大小写的。
getElementsByTagNameNS(ns, "Thumbnail")与"thumbnail"属于完全不同的标签,调用时务必核对源文档的真实大小写。 - 默认命名空间的误区:当 XML 根节点声明了未加前缀的默认命名空间(如
xmlns="http://www.w3.org/2005/Atom")时,该文档内所有无前缀的子元素(如<entry>、<title>)均继承此命名空间 URI。此时若使用getElementsByTagNameNS,第一个参数必须传入该默认命名空间的完整 URI,不可传null或空字符串。 - 反斜杠转义遗漏:若尝试在
querySelector中使用包含冒号的前缀,字符串内部必须使用两个反斜杠"\:"进行转义。单反斜杠会被 JavaScript 字符串字面量解析转义吃掉,从而导致传给 DOM 引擎时仍为单一冒号。 - XML 实体截断问题:原始数据中如果包含未转义的特殊字符(如
&或<),DOMParser会直接在文档中插入<parsererror>标签。务必在解析完成后第一时间检查getElementsByTagName("parsererror")。
JS实现平滑滚动到指定高度的方法
2026-11-22 19:24:22
JS修改背景颜色无效怎么办?常见原因与排查
2026-11-22 18:07:06
怎么用JavaScript实现盒子的鼠标拖拽移动效果
2026-11-22 17:44:49
JavaScript实现页面自适应的三种核心方案
2026-11-22 17:38:43
JavaScript监听鼠标滚轮事件的标准写法
2026-11-22 16:39:15







