

JavaScript常见混淆原理解析:控制流平坦化与字符串加密还原
深入解析JavaScript常见代码混淆的核心机制,重点拆解控制流平坦化与字符串加密的AST生成原理,并提供基于Babel的静态分析与自动化AST还原实战方案。
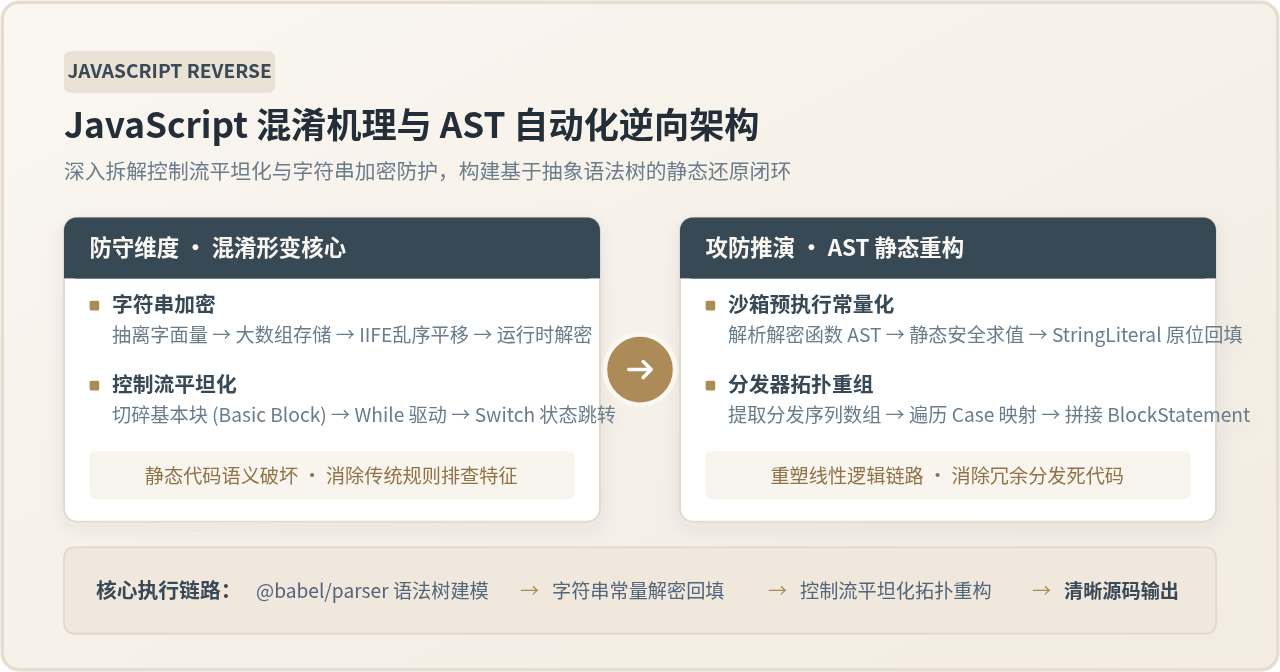
一、字符串加密混淆的核心机理与表现形式
在未经混淆的代码中,API 接口路径、参数键名、错误提示及业务关键常量均以明文字符串字面量(StringLiteral)直接呈现。分析人员只需全局检索关键词,便能迅速定位关键鉴权或数据加解密入口。
以知名混淆工具 javascript-obfuscator 为例,字符串混淆并非简单地把字符串替换为十六进制转义符,而是构建了一套高度联动的三位一体动态求值体系:
- 全局大数组(String Array):混淆器首先扫描整段代码中所有的字符串字面量,统一抽取并写入一个顶层数组,同时可对字符串内容进行 Base64 或 RC4 二次加密。
- 自执行平移乱序函数(Shuffle IIFE):紧随大数组之后,注入一个立即调用的自执行函数。该函数通过固定次数的
arr.push(arr.shift())循环操作,在代码加载时动态改变数组元素的物理索引位置。这使得静态查看大数组源码时看到的索引与实际运行态完全不符。 - 解密与缓存函数(Decryptor Function):业务代码中所有的原始字符串调用,被全部重写为对该函数的调用(例如
_0x2c3d('0x0'))。解密函数内部接收传入的十六进制索引,先扣除基数偏移,再从大数组中读取密文完成解码,并通常维护一个内部字典用于缓存已计算结果。
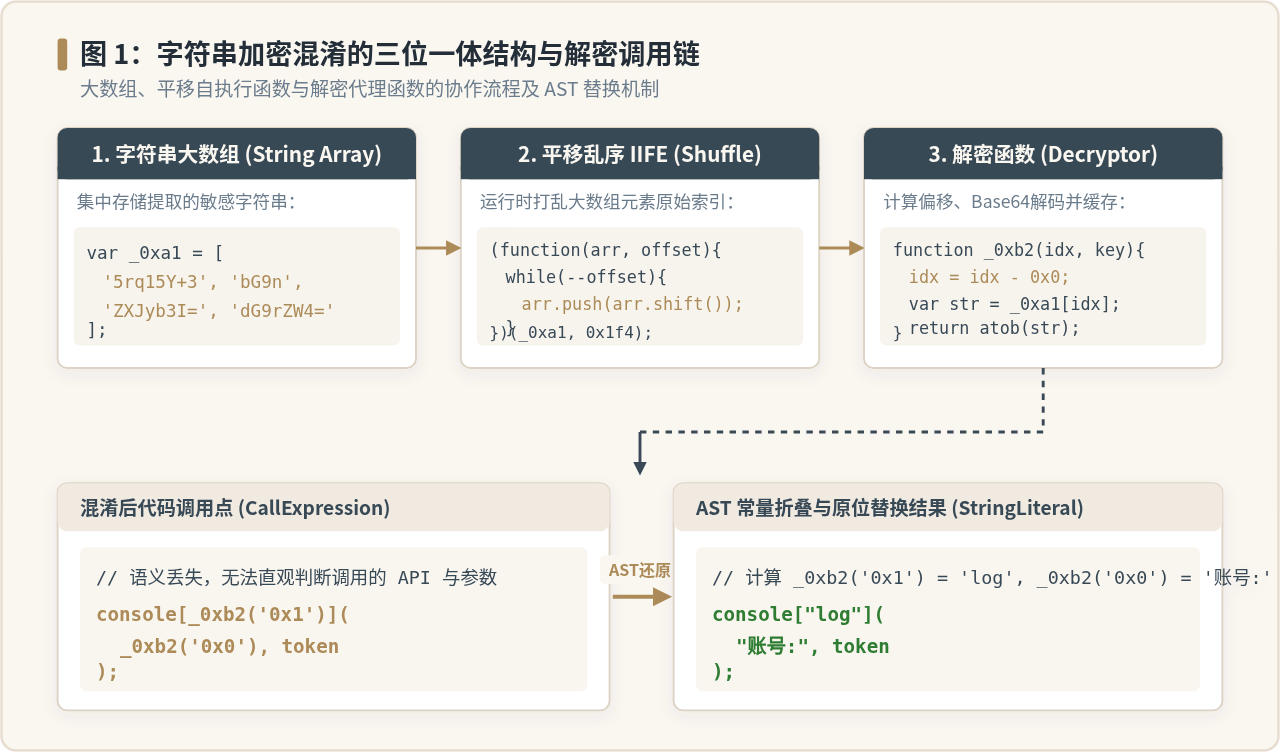
混淆前后代码对比剖析
通过一段精简的具体代码,可以直观观察到这一结构转变。假设原始业务逻辑为简单的接口请求配置:
// 原始业务逻辑
function fetchUserInfo(token) {
  console.log("请求用户数据:", "/api/v1/user/info");
  return request.get("/api/v1/user/info", { headers: { "Authorization": token } });
}
经过字符串抽取与加密混淆处理后,代码被转换为如下结构:
// 1. 顶层字符串大数组
var _0x5a1b = ['L2FwaS92MS91c2VyL2luZm8=', 'bG9n', '6K+35rGC55So5oi35pWw5o2uOg==', 'QXV0aG9yaXphdGlvbg=='];

// 2. 自执行平移乱序函数 (在运行时改变元素在数组中的实际存储位置)
(function (_0xarr, _0xoffset) {
  var _0xshift = function (_0xcount) {
    while (--_0xcount) {
      _0xarr['push'](_0xarr['shift']());
    }
  };
  _0xshift(++_0xoffset);
}(_0x5a1b, 0x1a4));

// 3. 解密函数 (负责偏移修正、Base64解码与结果返回)
var _0x4c2a = function (_0xidx, _0xkey) {
  _0xidx = _0xidx - 0x0;
  var _0xres = _0x5a1b[_0xidx];
  // 简化的 Base64 解码逻辑
  if (_0x4c2a['initialized'] === undefined) {
    _0x4c2a['base64Decode'] = function (_0xstr) {
      return Buffer.from(_0xstr, 'base64').toString('utf-8');
    };
    _0x4c2a['initialized'] = true;
  }
  return _0x4c2a['base64Decode'](_0xres);
};

// 4. 业务逻辑中的字符串调用点
function fetchUserInfo(_0xtoken) {
  console[_0x4c2a('0x1')](_0x4c2a('0x2'), _0x4c2a('0x0'));
  return request['get'](_0x4c2a('0x0'), {
    'headers': {
      [_0x4c2a('0x3')]: _0xtoken
    }
  });
}
由上可见,所有的语义关键信息全部沉没在 _0x4c2a(...) 的函数调用之后。常规的静态关键字搜索在此彻底失效。
二、基于 AST 的字符串加密自动化还原
手工查找每个索引并解密耗时且极易出错。还原字符串加密的关键思路在于“利用 Babel 遍历语法树,提取解密环境并在受控沙箱中执行,将所有解密调用节点原位折叠为明文字符串字面量”。
核心还原步骤
- 识别并提取环境节点:定位顶层的大数组定义节点(
VariableDeclarator)、自执行平移函数节点(ExpressionStatement)以及解密函数定义节点。 - 沙箱注入与初始化:利用 Node.js 提供的
vm模块,为上述三个节点生成的代码构建独立的上下文(Context),并在沙箱中执行。此时沙箱内的解密函数已具备完整的内存状态与解密能力。 - 遍历调用表达式(CallExpression):使用
@babel/traverse遍历整棵语法树,查找所有调用的函数名为解密函数(如_0x4c2a)且实参全为静态字面量的调用节点。 - 求值与节点替换:将参数送入沙箱中预先加载的解密函数计算出明文字符串,使用
@babel/types.stringLiteral(result)替换原始的CallExpression节点。 - 死代码剔除:当所有调用点均被替换为字面量后,解密函数与大数组的引用计数归零,即可安全地将其从 AST 中彻底删除。
混淆脚本可能掺杂恶意代码或针对运行环境的反调试探测。在提取并执行解密函数时,必须使用受限的沙箱(如 Node.js vm.createContext),并且不挂载宿主 process、文件系统(fs)等高危对象,避免脚本逃逸。
三、控制流平坦化原理解析
如果说字符串加密是给代码蒙上“面纱”,控制流平坦化(Control Flow Flattening)则是直接拆碎代码的“骨骼”。
控制流平坦化的理论源自代码混淆领域的经典算法。它的核心思想是:将一个函数内部原本自上而下或带有明确分支(if-else、for 等)的线性控制流图(Control Flow Graph, CFG),切割为若干个独立的基本块(Basic Blocks),然后将这些基本块统统塞入一个无限循环的 switch-case 结构中,通过一个状态变量或状态序列数组来控制下一跳执行哪一个基本块。
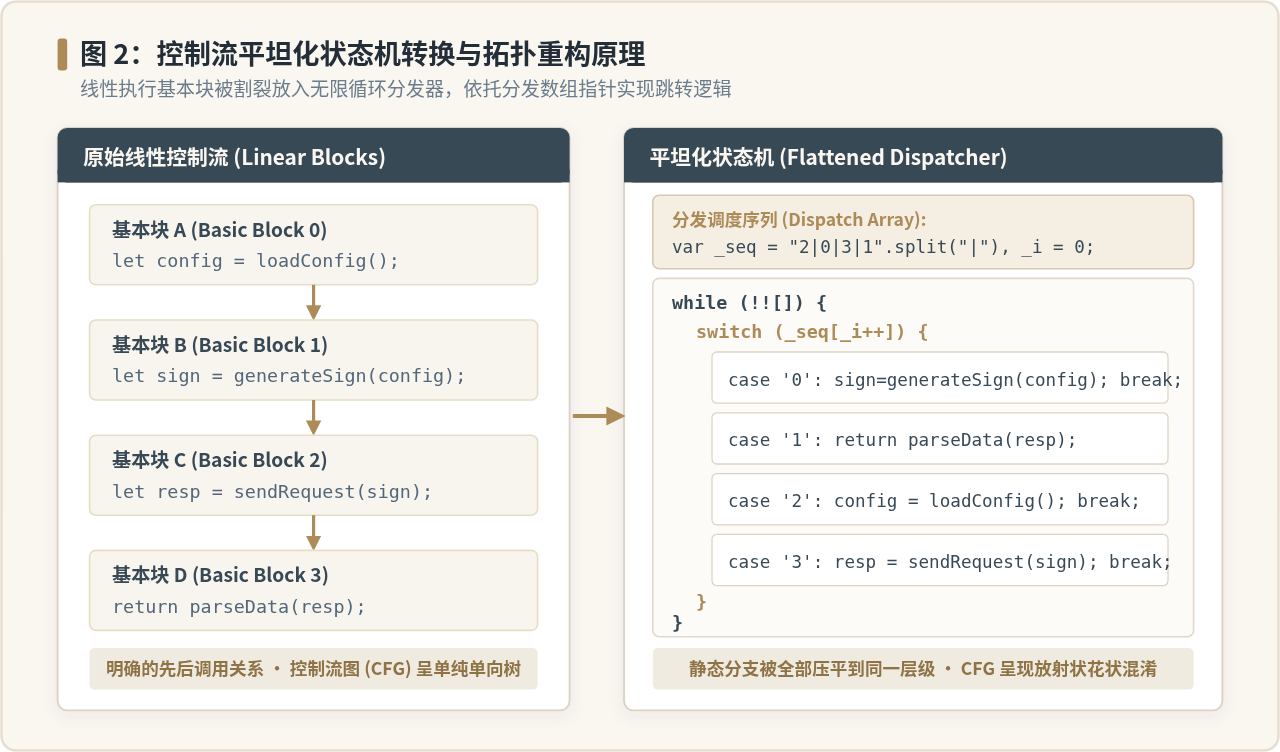
平坦化状态机的典型构成
- 分发序列(Dispatch Sequence):通常是一个经过字符串分割生成的数组,例如
var _seq = "3|1|0|2".split("|"),或者一个在每个 case 内部动态累加的状态游标_state = 2。 - 调度驱动器(While Loop):常见的形式为
while (true)、while (!![])或for (;;),充当永不停止的执行引擎。 - 状态分发核心(Switch Statement):以
_seq[_index++]为判断条件,各个 case 标签对应不同的代码碎片。每个 case 块执行完毕后,通常紧跟break或continue跳回到循环顶部,等待分发器指引下一跳。
平坦化代码实例剖析
// 原始顺序执行代码
function processTransaction(order) {
  var isValid = verifyOrder(order);
  var payment = calculatePayment(order);
  var receipt = executePayment(payment);
  notifyUser(receipt);
  return receipt.status;
}
经过平坦化混淆处理后,代码转变为高度晦涩的状态机:
// 平坦化后的状态机混淆代码
function processTransaction(order) {
  var _dispatcher = "3|0|4|1|2".split("|");
  var _step = 0;
  while (true) {
    switch (_dispatcher[_step++]) {
      case "0":
        var payment = calculatePayment(order);
        continue;
      case "1":
        notifyUser(receipt);
        continue;
      case "2":
        return receipt.status;
      case "3":
        var isValid = verifyOrder(order);
        continue;
      case "4":
        var receipt = executePayment(payment);
        continue;
    }
    break;
  }
}
混淆前代码直观清晰,混淆后代码在静态分析工具眼中变成了复杂的环形控制流图,人类阅读时需要频繁在各个 case 之间来回跳跃,认知负荷呈指数级上升。
四、基于 AST 的控制流平坦化逆向重构
平坦化混淆虽然破坏了源码在物理文本上的先后次序,但在逻辑上并未改变其执行顺序。对于由固定分发序列(如 "3|0|4|1|2".split("|"))驱动的标准平坦化,逆向重构的确定性极高。
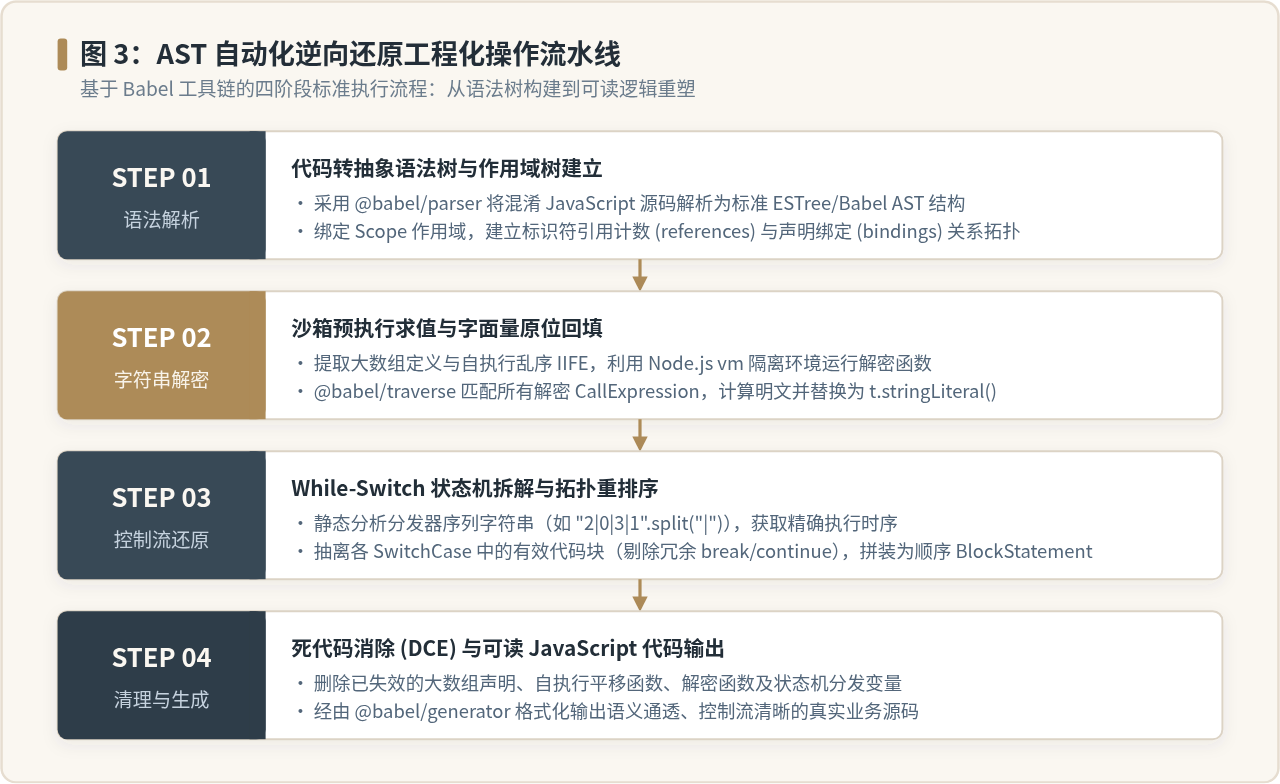
重构算法的关键阶段
- 特征匹配定位:遍历 AST,定位满足条件的
WhileStatement:循环体内部的第一个(且通常唯一的)核心子节点为一个SwitchStatement,且其判定条件来自于一个通过数组索引起调的变量。 - 分发序列静态求解:在
WhileStatement的前序同级兄弟节点中,查找分发序列数组的声明(例如MemberExpression带有"3|0|4|1|2"和split("|")调用)。直接在 AST 中计算出该数组的实际顺序["3", "0", "4", "1", "2"]。 - Case 映射字典构建:遍历该 switch 语句的所有
SwitchCase节点,以case.test.value为键,将其包含的有效语句列表(consequent)存入映射表。特别注意:需要过滤并剔除每个 case 末尾用于跳转的break;或continue;语句。 - 重组顺序基本块:按照分发序列
["3", "0", "4", "1", "2"]依次从映射字典中取出对应的语句节点,按序拼装成一个线性的语句数组。 - 语法树原位替换:调用 Babel 的
path.replaceWithMultiple(newStatements),将整个冗杂的while循环替换为干净的顺序语句块,并同时删除前序已失效的分发序列声明变量。
五、端到端完整还原脚本实战
在实际项目中,混淆器往往将“字符串加密”与“控制流平坦化”嵌套混用。必须遵循严格的逆向执行顺序:必须先解密字符串,再还原控制流平坦化。原因在于分发序列本身(如 "3|0|4|1|2")在初态下通常也是被加密函数包装的,只有完成字符串常量回填后,平坦化分发器的特征才能清晰暴露。
下面给出一个可在 Node.js 环境下直接运行的端到端自动化还原脚本实现:
/**
 * deobfuscate.js
 * 依赖安装:npm install @babel/core @babel/parser @babel/traverse @babel/types @babel/generator
 */
const parser = require("@babel/parser");
const traverse = require("@babel/traverse").default;
const t = require("@babel/types");
const generate = require("@babel/generator").default;
const vm = require("vm");

function deobfuscate(rawCode) {
  const ast = parser.parse(rawCode, { sourceType: "script" });

  // ==========================================
  // 第一阶段:字符串加密自动化还原
  // ==========================================
  // 1. 提取顶层前 3 个核心节点(大数组、自执行平移函数、解密函数)
  const decryptorNodes = ast.program.body.slice(0, 3);
  let decryptorCode = "";
  decryptorNodes.forEach(node => {
    decryptorCode += generate(node).code + "
";
  });

  // 2. 在独立的 VM 沙箱中初始化解密上下文
  const sandbox = {};
  vm.createContext(sandbox);
  try {
    vm.runInContext(decryptorCode, sandbox);
  } catch (e) {
    console.warn("沙箱预初始化解密环境失败:", e.message);
  }

  // 3. 遍历整棵树,原位计算并回填解密调用
  traverse(ast, {
    CallExpression(path) {
      const { callee, arguments: args } = path.node;
      // 匹配形式:_0x4c2a('0x1') 或 _0x4c2a(0)
      if (t.isIdentifier(callee) && sandbox[callee.name] && typeof sandbox[callee.name] === "function") {
        const isAllLiteral = args.length > 0 && args.every(arg => t.isLiteral(arg));
        if (isAllLiteral) {
          try {
            // 取出实参字面量值
            const evaluatedArgs = args.map(arg => arg.value);
            const decryptedValue = sandbox[callee.name](...evaluatedArgs);
            if (typeof decryptedValue === "string") {
              path.replaceWith(t.stringLiteral(decryptedValue));
            }
          } catch (err) {
            // 忽略非纯静态求值调用
          }
        }
      }
    }
  });

  // 4. 剔除解密前置代码(清除前3个节点)
  ast.program.body.splice(0, 3);

  // ==========================================
  // 第二阶段:控制流平坦化逆向重构
  // ==========================================
  traverse(ast, {
    WhileStatement(path) {
      const { node } = path;
      // 判定 While 循环条件是否为 true 或 !![]
      const isInfiniteLoop =
        t.isBooleanLiteral(node.test, { value: true }) ||
        (t.isUnaryExpression(node.test, { operator: "!" }) && t.isUnaryExpression(node.test.argument));
      if (!isInfiniteLoop) return;

      // 提取循环体内的 switch 语句
      const body = node.body.body || (node.body ? [node.body] : []);
      const switchNode = body.find(stmt => t.isSwitchStatement(stmt));
      if (!switchNode) return;

      // 寻找前序同级分发数组声明节点,形如:var _seq = "2|0|3|1".split("|")
      const prevSibling = path.getPrevSibling();
      if (!prevSibling.isVariableDeclaration()) return;

      let dispatchSequence = null;
      let declaratorPath = null;

      prevSibling.node.declarations.forEach(decl => {
        if (t.isCallExpression(decl.init) &&
            t.isMemberExpression(decl.init.callee) &&
            t.isStringLiteral(decl.init.callee.object) &&
            t.isIdentifier(decl.init.callee.property, { name: "split" })) {
          const splitArg = decl.init.arguments[0]?.value;
          if (splitArg) {
            dispatchSequence = decl.init.callee.object.value.split(splitArg);
            declaratorPath = prevSibling;
          }
        }
      });

      if (!dispatchSequence || !Array.isArray(dispatchSequence)) return;

      // 映射 SwitchCase 节点,提取各 Case 内部代码并剥离末尾的 break/continue
      const caseMap = new Map();
      switchNode.cases.forEach(c => {
        const key = c.test.value;
        const cleanStatements = c.consequent.filter(stmt => !t.isBreakStatement(stmt) && !t.isContinueStatement(stmt));
        caseMap.set(String(key), cleanStatements);
      });

      // 依据分发序列顺序拼装重组代码
      const restoredStatements = [];
      dispatchSequence.forEach(stepKey => {
        const stmts = caseMap.get(String(stepKey));
        if (stmts) {
          restoredStatements.push(...stmts);
        }
      });

      if (restoredStatements.length > 0) {
        // 原位替换 while 循环
        path.replaceWithMultiple(restoredStatements);
        // 删除分发序列声明节点
        if (declaratorPath) {
          declaratorPath.remove();
        }
      }
    }
  });

  // 重新生成语义通透、控制流清晰的 JavaScript 源码
  return generate(ast, { comments: false, minified: false }).code;
}

module.exports = { deobfuscate };
六、混淆对抗中的特殊边界与注意事项
在真实商业安全对抗场景中,混淆作者往往会设置针对性的反还原陷阱。进行自动化重构时需重点防范以下四类典型边界问题:
- 反调试与环境依赖探测陷阱:部分解密函数内部会调用
Function.prototype.toString检查自身的代码是否被美化排版或被注入挂钩(Hook),若检测到格式改变则触发无限递归死循环。针对此类场景,应严格保持沙箱内环境原生,或直接在 AST 层面识别其自检逻辑并予以裁剪。 - Case 内部包含业务局部 break/continue:在控制流平坦化的 case 代码块内部,如果原本包含业务自身的
for、while循环,盲目剔除所有BreakStatement会直接破坏内层循环的正常语义。正确的做法是仅剔除位于 case 顶层的第一个终止跳转语句。 - 块级作用域变量提升与重名冲突:平坦化前各代码块往往分布在不同的作用域或分支中,压平放入同一个 switch 后,使用
var声明的变量可能出现意外覆盖,使用let/const则可能因重复声明而报语法错误。还原为顺序代码后,应调用scope.crawl()刷新作用域,必要时通过 Babel 进行变量重命名消除冲突。 - 动态计算状态转移(非固定分发数组):某些高级混淆不再使用
split('|')固定序列,而是通过算术运算或状态转移方程计算下一跳(例如state = (state * 3 + 1) % 5)。此类情况属于符号执行(Symbolic Execution)与动态污点分析的范畴,需要借助模拟执行引擎追踪状态演化。
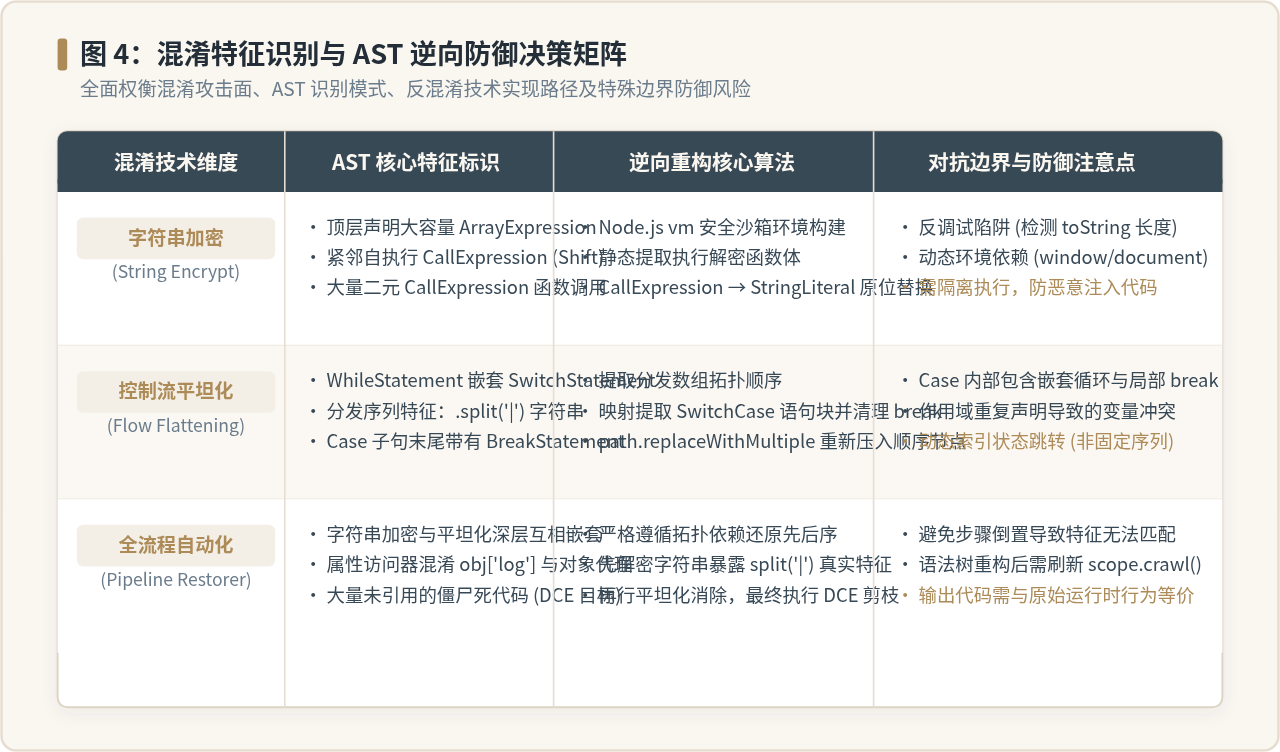
七、混淆与还原全景决策对比
针对不同防护层级的混淆代码,选用合适的识别标志与还原策略是保证逆向效率的核心依据。下表总结了两大核心混淆维度的特征与操作边界:
| 混淆技术 | 代码视觉表现 | AST 核心识别标识 | 逆向还原算法 | 关键防御与边界提醒 |
|---|---|---|---|---|
| 字符串加密 | 所有可见明文字符串消失,充斥 _0x1a('0x2') 密集调用 |
顶层 ArrayExpression + 紧邻 CallExpression (Shift) + 解密函数声明 |
VM 沙箱安全初始化 + AST CallExpression 遍历常量求值折叠 |
解密函数内嵌反调试自检;需防范沙箱逃逸与宿主注入风险。 |
| 控制流平坦化 | 原本线性的代码结构全部坍塌为深层循环中的 switch-case |
WhileStatement 嵌套单一 SwitchStatement + 字符串 split 数组分发器 |
解析分发序列数组 + 映射 Case 语句块(剥离末尾 break)+ 拓扑顺序原位替换 | 严谨区分 Case 顶层 break 与内部业务嵌套循环 break;还原后需刷新作用域。 |
| 复合嵌套防护 | 字符串加密与控制流平坦化深度交织,变量名全为十六进制 | 平坦化分发序列本身为解密函数返回值;各 Case 内部混杂对象代理与死代码 | 严格执行两阶段流水线:先全局解密字符串常量,再行控制流平坦化展开与死代码剪枝 | 必须严格遵循还原时序依赖,避免因特征未完全暴露导致解析失败。 |
掌握控制流平坦化与字符串加密的 AST 底层生成原理,不仅能帮助工程师高效逆向分析受保护脚本,更能够在安全防御架构设计中,更加理性地评估不同代码混淆技术的保护强度与运行时性能开销。
前端JS本地缓存数据加密存储策略及安全性建议
2026-11-22 10:14:33
Canvas与SVG在JS数据可视化中的技术差异与选型
2026-11-21 17:32:06
为什么JS不能直接通过绝对路径读取本地文件
2026-11-21 15:51:19
JavaScript忽略大小写查找字符串的两种实现方式
2026-11-21 11:45:03
解决JS图片轮播切换闪烁与卡顿的性能优化方案
2026-11-20 22:40:55







