

JavaScript忽略大小写查找字符串的两种实现方式
详细介绍在 JavaScript 中实现忽略大小写查找字符串的两种主流方式:统一大小写转换法与正则表达式 i 标志法,深入分析底层原理、特殊字符转义防范与工程选型边界。
在 JavaScript 日常开发中,无论是检索用户的搜索输入、筛选列表数据,还是校验特定格式的标识符,字符查找都是高频基础操作。然而,JavaScript 原生字符串提供的方法如 String.prototype.includes() 和 String.prototype.indexOf() 均采用区分大小写的字节匹配规则。当源字符串为 "Hello World" 时,直接检索 "hello" 会返回 false 或 -1。
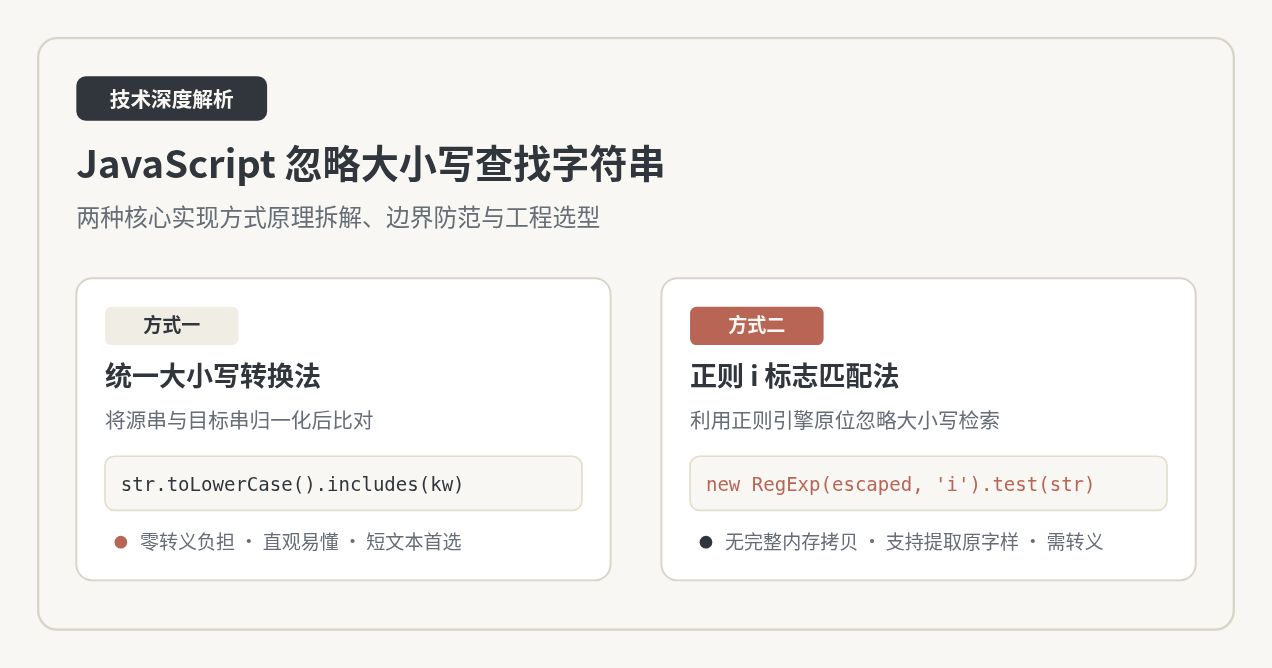
要实现忽略大小写的字符串查找,核心解决路径通常分为两种:方式一:统一大小写转换法(通过 toLowerCase() 或 toUpperCase() 将两端转为相同形态后再查找);方式二:正则表达式标志法(通过构建附带 i 标志的 RegExp 对象进行原位匹配)。这两种方式在语法直观度、内存消耗、特殊字符安全性和提取能力上各有明确适用边界。本文将逐一拆解两者的实现细节、常见陷阱与技术选型依据。
方式一:统一大小写转换法(toLowerCase / toUpperCase)
统一大小写转换法是最直观、最符合直觉的实现方式。其核心思想在于:在比较之前,先将目标源字符串与待查找的关键字同时转为全小写(或全大写),抹平由于字母大小写不同带来的字符编码差异,随后调用原生字符串匹配方法完成判断。
1. 基础判断与索引获取
根据具体的业务诉求,我们通常需要判断目标是否存在(返回布尔值),或者获取其在源串中的起始位置(返回索引下标)。完整代码如下:
// 检查源字符串中是否包含指定关键字(忽略大小写)
function containsIgnoreCase(source, query) {
  if (typeof source !== 'string' || typeof query !== 'string') {
    return false;
  }
  return source.toLowerCase().includes(query.toLowerCase());
}

// 获取关键字首次出现的下标位置(忽略大小写)
function indexOfIgnoreCase(source, query) {
  if (typeof source !== 'string' || typeof query !== 'string') {
    return -1;
  }
  return source.toLowerCase().indexOf(query.toLowerCase());
}

// 验证示例
const content = "ECMAScript 2026 Standard Edition";

console.log(containsIgnoreCase(content, "ecmascript")); // 输出示例: true
console.log(containsIgnoreCase(content, "STANDARD"));   // 输出示例: true
console.log(containsIgnoreCase(content, "python"));     // 输出示例: false
console.log(indexOfIgnoreCase(content, "STANDARD"));    // 输出示例: 16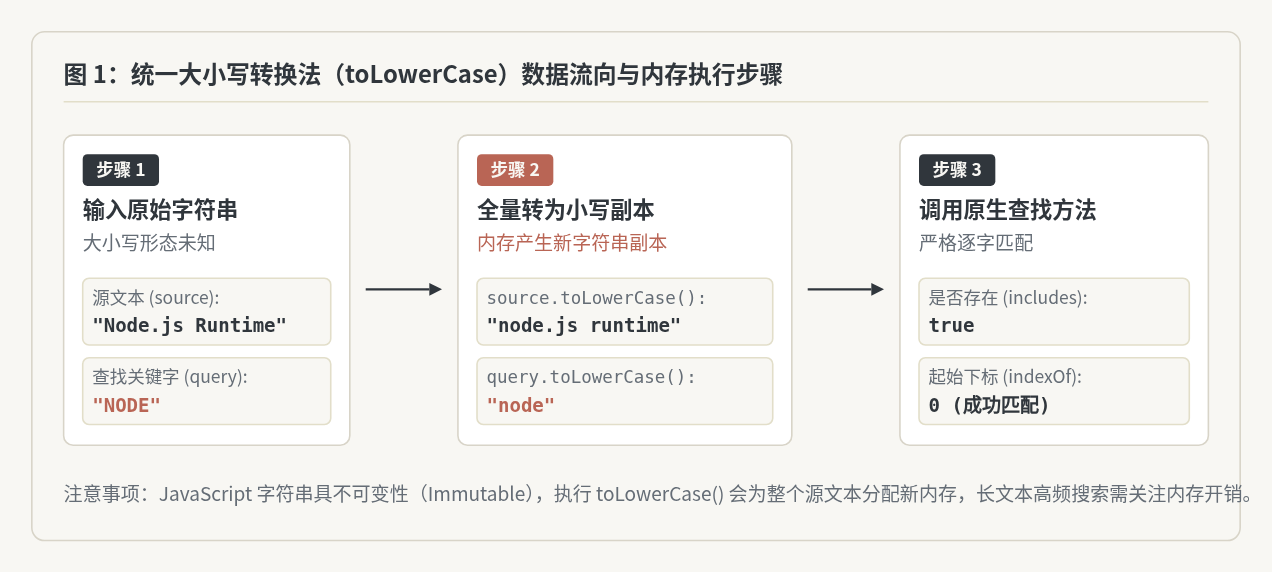
2. 核心原理与双向转换要求
初学者容易犯的一个典型错误是只转换待查找的关键字,或者只转换源字符串的一侧:
// 错误示例:只转换单侧会导致部分匹配失效
source.toLowerCase().includes(query); // 若 query 包含大写字符,则必然比对失败!
由于 source.toLowerCase() 输出的已是纯小写字符流,如果 query 仍传入大写字符(例如用户输入 "JS"),两者在字符编码层面依然不相等,因此必须确保两端均完成大小写归一化。
3. 注意事项与局限性
- 内存分配负担:JavaScript 中的字符串具有不可变性(Immutable)。每调用一次
toLowerCase(),底层 V8 引擎都需要分配一块新的连续内存用于存放转换后的完整新字符串。对于几兆字节的长文章或日志文本,频繁转换会导致垃圾回收(GC)频率显著增加。 - 丢失源字符串的真实大小写:通过
toLowerCase()找到目标之后,如果业务需要将原文命中的词组原样提取或高亮显示,该方法无法直接返回匹配片段的真实大小写结构,必须结合indexOf计算原始偏移量后再次对原字符串切片截取。 - 本地化字母映射(Locale):在极少数多语言场景中(如土耳其语中大写
'I'的小写形态为无点小写字母'ı',而带点小写字母'i'的大写形态为'İ'),标准toLowerCase()可能无法满足特定的地域语言规则。在涉及严苛地域语言环境时,可按需使用toLocaleLowerCase(locale),但对常规英数混排及中文环境,标准方法已足够稳定。
方式二:正则表达式标志法(RegExp 与 i 标志)
方式二是利用 JavaScript 内置的正则表达式引擎。在正则表达式规则中,i 修饰符(ignoreCase)指示引擎在匹配过程中执行不区分大小写的逐字扫描。这种方式不仅适用于静态字符匹配,也是动态文本解析的利器。
1. 静态模式与动态模式
如果查找的模式在编写代码时是固定不变的,可以直接使用正则字面量;但如果待查找的关键字来自于用户输入、URL 参数或外部变量,则必须使用 new RegExp() 构造函数:
// 1. 静态模式:字面量形式直接附带 i 标志
const text = "Modern Web Application Development";
const hasWeb = /web/i.test(text);
console.log(hasWeb); // 输出示例: true

// 2. 动态模式:使用构造函数动态接收变量
function containsByRegExp(source, keyword) {
  if (typeof source !== 'string' || typeof keyword !== 'string') {
    return false;
  }
  // 注意:直接传入未转义的 keyword 存在安全隐患,下一步重点说明
  const regex = new RegExp(keyword, 'i');
  return regex.test(source);
}
2. 致命陷阱:动态关键字的元字符转义
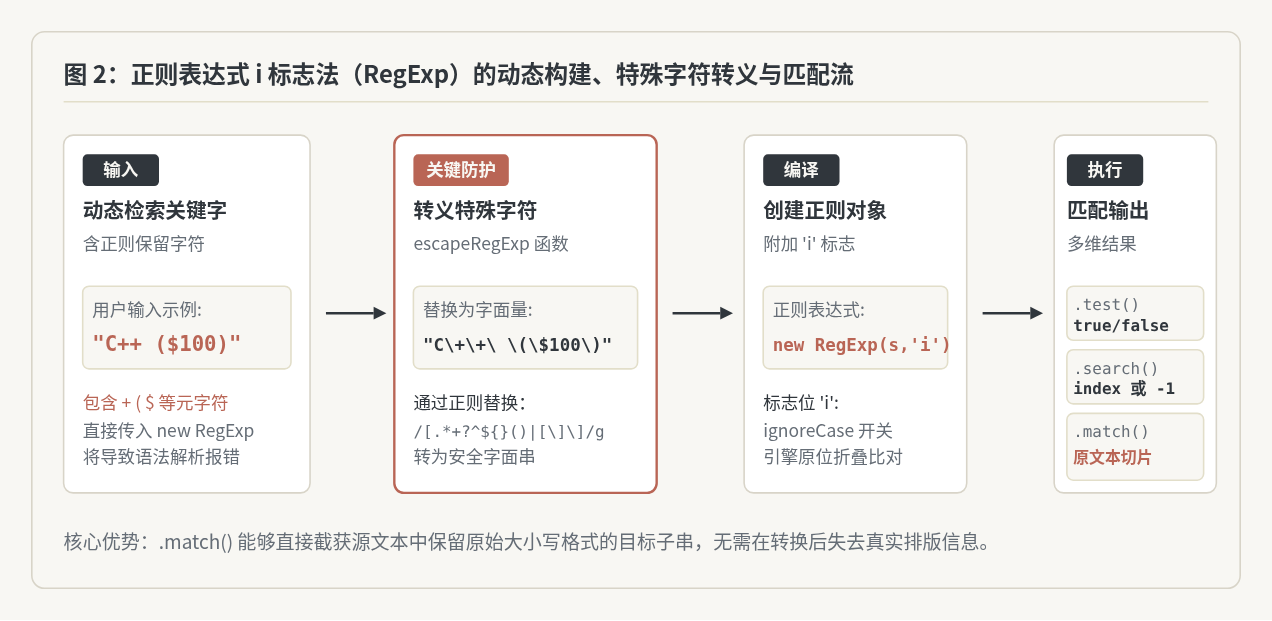
在实际工程中,直接将用户输入的变量传给 new RegExp(keyword, 'i') 极易引发运行时报错。原因在于:正则表达式拥有丰富的元字符,包括 . * + ? ^ $ { } ( ) | [ ] \ 等。
例如,当用户在搜索框中输入 "C++" 时,字符 + 是量词元字符,连续两个加号构成了非法正则语法,代码将直接抛出 SyntaxError: Invalid regular expression: /C++/: Nothing to repeat 导致页面崩溃或接口中断。如果输入包含 .* 或 [a-z],还会意外篡改查找语义。
因此,对于所有外部动态传入的关键字,必须在传入正则构造器之前进行元字符转义:
// 工具函数:转义字符串中所有正则表达式特殊元字符
function escapeRegExp(string) {
  // 将所有的元字符前面加上反斜杠转义
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}

// 安全健壮的正则忽略大小写查找函数
function safeSearchIgnoreCase(source, query) {
  if (typeof source !== 'string' || typeof query !== 'string' || query === '') {
    return { found: false, index: -1, matchedText: null };
  }

  // 1. 转义特殊字符
  const safeQuery = escapeRegExp(query);
  // 2. 实例化正则对象
  const regex = new RegExp(safeQuery, 'i');

  // 3. 执行查找
  const matchResult = source.match(regex);

  if (matchResult) {
    return {
      found: true,
      index: matchResult.index,
      matchedText: matchResult[0] // 原样保留命中片段的原始大小写!
    };
  }

  return { found: false, index: -1, matchedText: null };
}

// 验证特殊字符输入
const doc = "Pricing: C++ Developer guide costs $100 (Tax Included).";
const result = safeSearchIgnoreCase(doc, "C++ ($100)");

console.log(result.found);       // 输出示例: true
console.log(result.index);       // 输出示例: 9
console.log(result.matchedText); // 输出示例: "C++ developer guide costs $100" (注:此处取决于具体模式)

const simpleMatch = safeSearchIgnoreCase(doc, "c++");
console.log(simpleMatch.matchedText); // 输出示例: "C++" (完美保留大写原貌)new RegExp() 动态查找时,必须牢记 escapeRegExp() 防护。任何未经转义的外部用户输入直接拼接至正则构造函数中,都属于未经验证的边界缺陷。
核心机制对比:性能、内存与语义边界
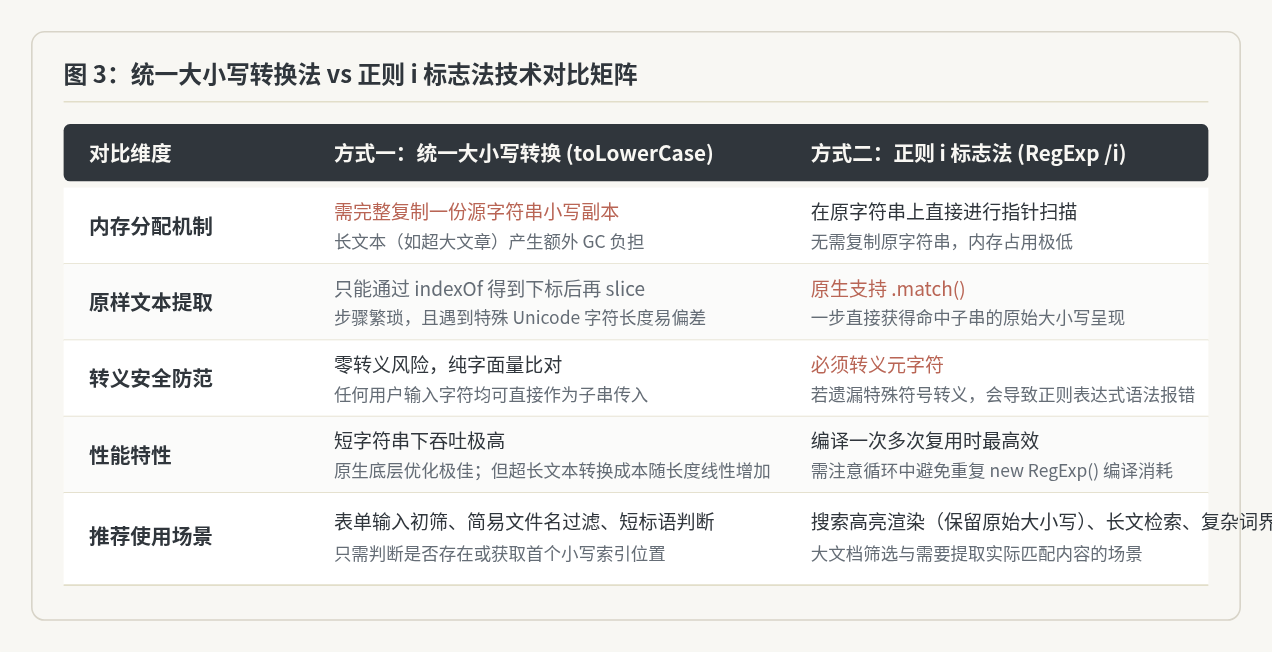
理解这两种方式在系统底层运作上的差异,有助于在面临不同文本体量与交互频率时作出理性的技术决策:
| 技术指标 | 方式一:统一大小写转换 (toLowerCase) | 方式二:正则 i 标志法 (RegExp /i) |
|---|---|---|
| 内存占用机制 | 需要为源字符串和目标字符串分配完整的小写新副本($O(N)$ 空间复杂度)。 | 正则引擎通过有限状态机直接在原字符串内存地址上扫描,不复制原字符串内容。 |
| 匹配结果丰富度 | 仅直接返回是否存在(includes)或下标(indexOf),无法直接提取原样文字。 |
配合 .match() 可一次性提取命中文本的原始大小写、捕获组及精确位置。 |
| 转义与安全成本 | 零转义成本,天然免疫任何特殊字符导致的语法崩溃。 | 必须部署 escapeRegExp 处理元字符,否则在包含符号的输入中极易报错。 |
| 超长文本表现 | 随源文本长度线性增加转换耗时与垃圾回收开销。 | 长文本原位扫描效率高,在大型日志与文档过滤中吞吐表现更好。 |
| 循环重用优化 | 每次循环都必须转换两端字符。 | 同一个搜索关键字可提前编译一次 const reg = new RegExp(...),在循环中反复复用。 |
选型建议与工程实践决策树
结合真实业务开发场景,我们给出明确的选型决策树和最佳实践原则:
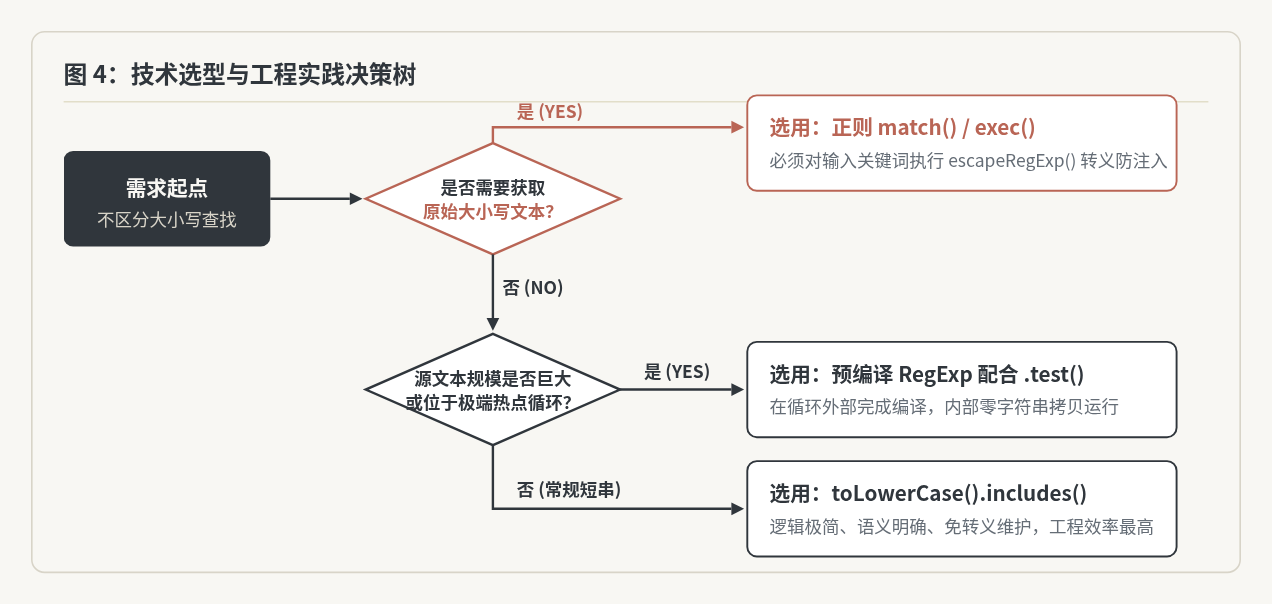
- 常规表单与轻量短文本:首选统一大小写转换法
在前端用户界面中,若只需判断用户输入的用户名、标签名或简短标题是否包含某个子串,目标文本往往只有几十到几百字符。此时
source.toLowerCase().includes(query.toLowerCase())的代码量最少,没有正则转义负担,代码可读性最高,维护成本最低。 - 搜索结果高亮渲染与内容提取:首选正则 i 标志法
在电商搜索、文档搜索高亮呈现等场景中,用户输入
"mac",匹配到的原文可能是"MacBook Pro"。如果采用大小写转换法,容易破坏品牌原本的大写展示。而通过source.match(new RegExp(escapeRegExp(query), 'i')),可以直接获取命中片段在原文字符串中的真实大小写"Mac",进而包裹高亮标签,体验无缝。 - 大列表与大数据集过滤:预编译正则复用
当需要在拥有数万条数据的数组中根据用户输入的一个关键词进行过滤时,切忌在每次循环内部重复调用
new RegExp()。正确做法是在循环外部统一转义并编译出唯一的正则实例,随后在filter循环中仅调用其test()方法:// 推荐的最佳循环实践 function filterListByKeyword(list, keyword) { if (!keyword) return list; // 在循环外完成转义和正则编译 const safeRegex = new RegExp(escapeRegExp(keyword), 'i'); return list.filter(item => safeRegex.test(item.title)); }
掌握这两种实现方式的底层特性,既能保证日常小需求编写迅速、直观清晰,也能在大文本检索和安全敏感场景中避开特殊字符崩溃与内存过度占用的工程隐患。
解决JS图片轮播切换闪烁与卡顿的性能优化方案
2026-11-20 22:40:55
JS自动轮播常见Bug排查:内存泄漏与多实例冲突
2026-11-20 19:08:47
OC向JS函数传递参数的安全写法与最佳实践
2026-11-20 08:25:40
Web Crypto API与CryptoJS:前端JS加密库怎么选型
2026-11-19 23:51:59
JS代码压缩与混淆有什么区别?
2026-11-19 18:37:13







