Node.js中怎么使用child_process调用Python脚本
深入讲解在Node.js中利用内置child_process模块调用Python脚本的核心机制与实践方案。全面涵盖spawn、exec、execFile选型对比、双向JSON数据通信、流式处理以及生产环境下的异常与超时容错。
在前后端分离或微服务架构尚未完全拆分的开发场景中,常会遇到需要结合多种技术栈特长的需求:例如使用 Node.js 处理高并发 Web 请求或实时 I/O 调度,而把密集型数据挖掘、NumPy 矩阵运算、Pandas 表格清洗或基于 Scikit-learn 的模型推断交由 Python 完成。此时,通过 Node.js 内置的原生模块 child_process 派生子进程执行 Python 脚本并进行输入输出调度,是一种无需额外引入网络中间件、部署轻量且执行直接的跨语言整合途径。
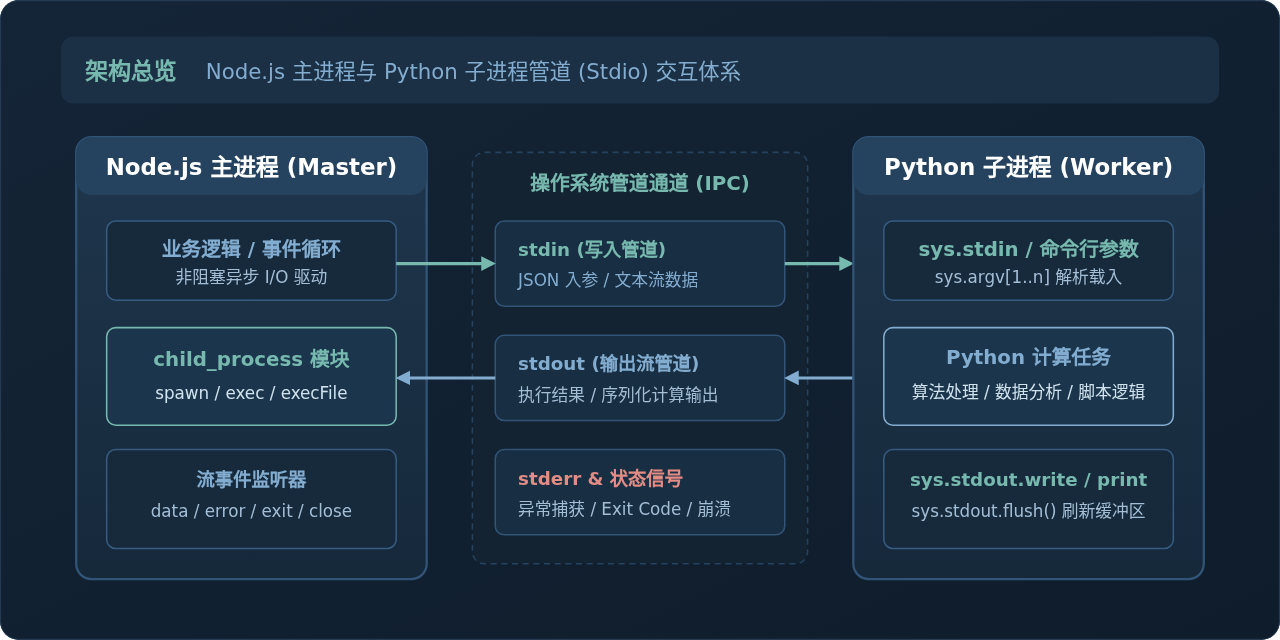
一、核心 API 选型依据与机制辨析
在 Node.js 标准库中,child_process 模块主要暴露了 spawn、exec 与 execFile 三个关键函数来衍生子进程。尽管它们最终都能执行 Python 命令,但在底层运作方式、内存开销以及安全性方面存在本质区别:
spawn:直接异步启动指定的可执行程序,返回一个封装了标准输入输出流(stdin、stdout、stderr)的ChildProcess对象。它不会衍生中间 Shell,数据以流(Stream)的形式分块传递,没有输出缓冲区的体积限制,适合长时间运行、处理大体积数据或需要实时读取执行进度的任务。exec:会在操作系统中首先衍生一个独立的系统 Shell(例如 Linux 上的/bin/sh或 Windows 上的cmd.exe),并在 Shell 中解析完整的命令行字符串。执行完毕后,一次性将所有输出内容收集到内存缓冲区并通过回调函数返回。其缺点在于存在预设的maxBuffer限制(默认通常为 1MB),且直接拼接外部参数极易引发命令注入漏洞。execFile:与exec类似使用回调返回结果,但它会跳过 Shell 直接调用目标二进制程序,因此执行效率更高,参数通过数组严格隔离,免疫了大部分 Shell 语法注入风险,但其返回结果仍受限于maxBuffer缓冲区容量。
| 方法名称 | 是否启动 Shell | 数据传输载体 | 输出容量限制 | 适用业务场景 |
|---|---|---|---|---|
spawn |
否(默认) | 连续流(Stream) | 无容量限制(按需消耗) | 长耗时、大数据交互、实时流式日志或模型推断 |
execFile |
否 | 内存缓冲区(Buffer) | 受限于 maxBuffer |
短任务、轻量计算结果、无需流式监听的明确输出 |
exec |
是(sh/cmd) |
内存缓冲区(Buffer) | 受限于 maxBuffer |
需要使用系统环境变量通配符或管道语法的简单维护脚本 |
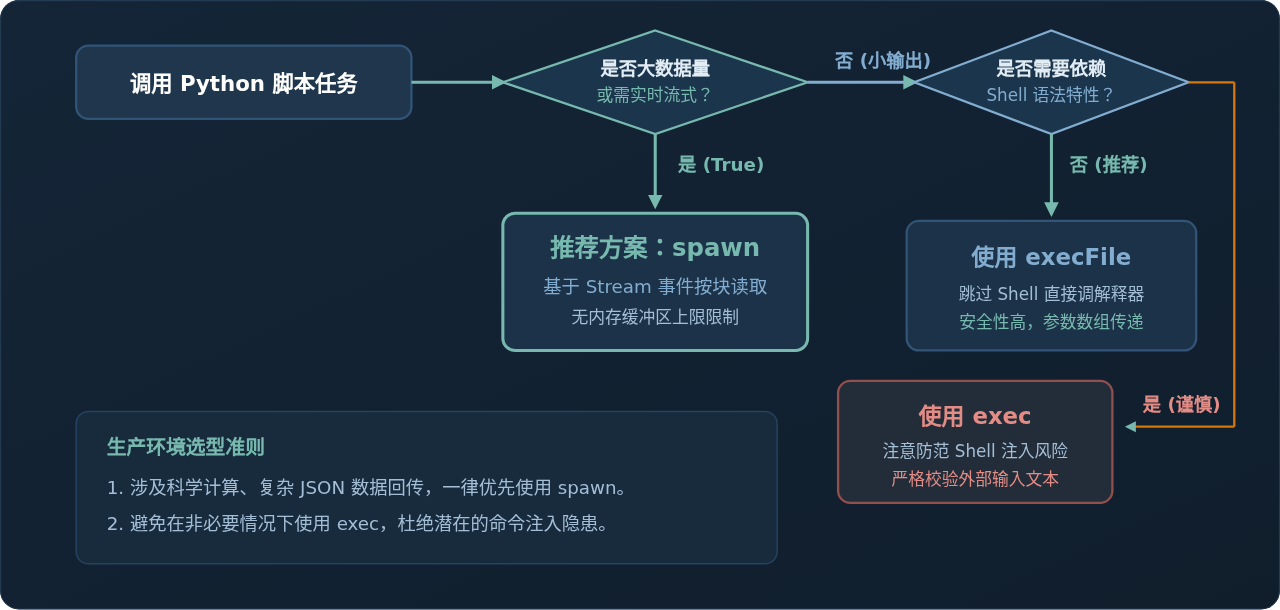
二、核心方案实现:使用 spawn 进行流式调用
spawn 是处理 Python 任务最为稳健的标准方式。下面通过一个完整的工程示例,演示如何在 Node.js 中启动 Python 脚本并传递命令行参数,同时监听标准输出流与退出事件。
import sys
import json
import time

def main():
    # 接收来自 Node.js 的命令行参数
    if len(sys.argv) < 2:
        sys.stderr.write("错误:未提供必要的输入参数。\n")
        sys.exit(1)

    input_param = sys.argv[1]

    # 模拟数据处理逻辑
    raw_numbers = [float(x.strip()) for x in input_param.split(",") if x.strip()]

    # 计算统计指标
    result = {
        "count": len(raw_numbers),
        "total": sum(raw_numbers),
        "average": sum(raw_numbers) / len(raw_numbers) if raw_numbers else 0,
        "max": max(raw_numbers) if raw_numbers else None,
        "min": min(raw_numbers) if raw_numbers else None,
        "processed_at": time.time()
    }

    # 将结果作为 JSON 格式打印到标准输出
    # 必须保证仅将最终有效结果打印至 stdout
    print(json.dumps(result, ensure_ascii=False))
    sys.stdout.flush()

if __name__ == "__main__":
main()const { spawn } = require('child_process');
const path = require('path');
function invokePythonCalculator(numbersString) {
return new Promise((resolve, reject) => {
const scriptPath = path.resolve(__dirname, 'process_data.py');
// 指定 python 解释器路径与脚本入参
const pythonProcess = spawn('python3', [scriptPath, numbersString]);
let outputChunks = [];
let errorChunks = [];
// 监听子进程的标准输出事件(流式数据块分片收集)
pythonProcess.stdout.on('data', (chunk) => {
outputChunks.push(chunk);
});
// 监听标准错误输出
pythonProcess.stderr.on('data', (chunk) => {
errorChunks.push(chunk);
});
// 监听底层操作失败(如解释器命令不存在或权限受限)
pythonProcess.on('error', (err) => {
reject(new Error(`无法启动 Python 子进程: ${err.message}`));
});
// 监听子进程及其 stdio 流完全关闭事件
pythonProcess.on('close', (code) => {
const stdoutResult = Buffer.concat(outputChunks).toString('utf8').trim();
const stderrResult = Buffer.concat(errorChunks).toString('utf8').trim();
if (code !== 0) {
return reject(new Error(`Python 进程退出异常 (退出码: ${code}): ${stderrResult}`));
}
try {
const parsedJson = JSON.parse(stdoutResult);
resolve(parsedJson);
} catch (parseErr) {
reject(new Error(`解析 Python 返回的 JSON 失败: ${parseErr.message},原始内容: ${stdoutResult}`));
}
});
});
}
// 执行调用示例
async function run() {
try {
const inputNumbers = "12.5, 45.2, 88.0, 103.4, 27.6";
const data = await invokePythonCalculator(inputNumbers);
console.log("计算成功,Python 回传结果:", data);
} catch (error) {
console.error("调用失败:", error.message);
}
}
run();- 流式分块累积:
stdout.on('data')回调接收到的数据块(Chunk)可能是大输出的一部分,切勿直接在data事件中执行JSON.parse(),必须将分片放入数组并在close事件中通过Buffer.concat()拼接后统一解析。 - 事件区别:
exit事件表示子进程操作系统进程本身已退出,但底层stdio管道中可能仍有待读取的残留数据;close事件则保证所有关联的 I/O 流已彻底关闭,因此解析输出数据应始终绑定在close事件中。
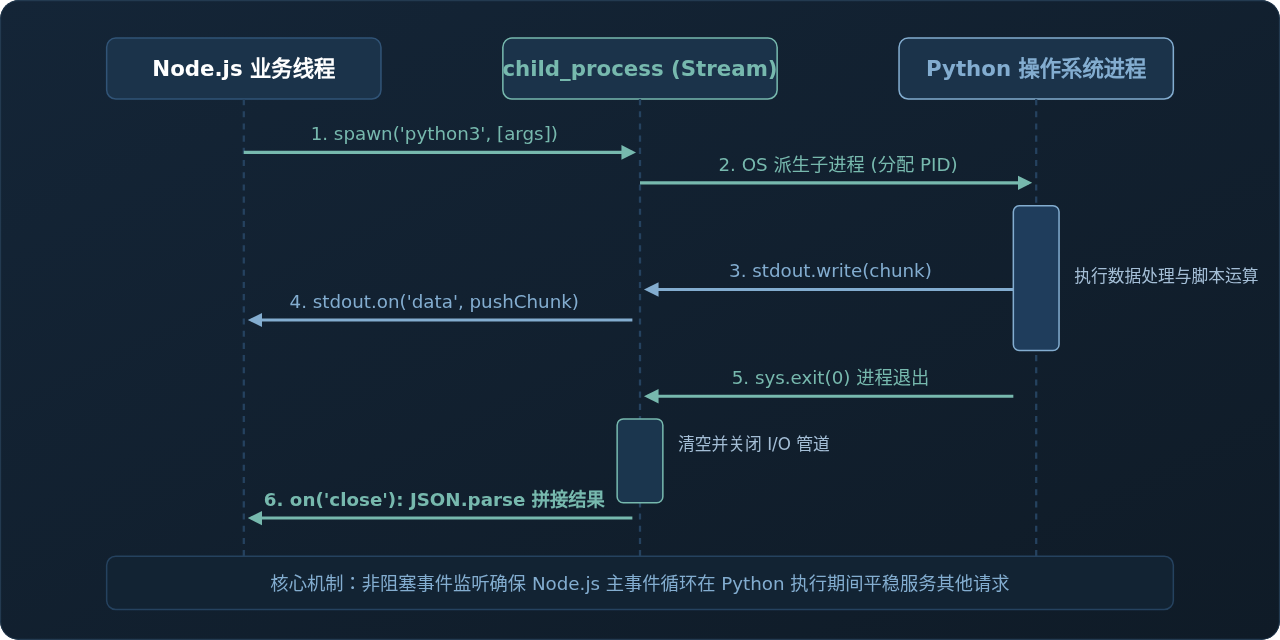
三、进阶数据交互:通过标准输入输出(Stdio)进行双向 JSON 通信
当传递的输入数据较为庞大或包含复杂嵌套对象(如包含数千条记录的数据库查询结果、长文本或图像 Base64)时,直接通过命令行参数(argv)传递会遭遇操作系统级别的参数长度上限(如 Linux 的 ARG_MAX 限制),且可能引发转义与敏感数据泄露问题。此时,利用 标准输入(stdin)写入、标准输出(stdout)读取 形成双向管道是工业级通用的解决方案。
import sys
import json

def process_payload(payload):
    # 对输入数据执行自定义处理(示例:矩阵归一化与数据增强)
    dataset = payload.get("records", [])
    scale_factor = payload.get("factor", 1.0)

    transformed = []
    for item in dataset:
        transformed.append({
            "id": item.get("id"),
            "scaled_score": round(item.get("score", 0) * scale_factor, 4),
            "status": "APPROVED" if item.get("score", 0) >= 60 else "REJECTED"
        })

    return {
        "status": "success",
        "total_processed": len(transformed),
        "data": transformed
    }

def main():
    try:
        # 从 sys.stdin 读取全部标准输入流内容
        input_data = sys.stdin.read()
        if not input_data.strip():
            raise ValueError("标准输入流为空")

        payload = json.loads(input_data)
        output_data = process_payload(payload)

        # 将处理完成的结构化 JSON 写入标准输出
        sys.stdout.write(json.dumps(output_data, ensure_ascii=False))
        # 显式刷新缓冲区,确保对端能即时捕获完整内容
        sys.stdout.flush()
    except Exception as ex:
        sys.stderr.write(json.dumps({"status": "error", "message": str(ex)}))
        sys.stderr.flush()
        sys.exit(1)

if __name__ == "__main__":
main()const { spawn } = require('child_process');
const path = require('path');
function processWithPythonPipe(payload) {
return new Promise((resolve, reject) => {
const scriptPath = path.resolve(__dirname, 'transform_data.py');
const py = spawn('python3', [scriptPath], {
stdio: ['pipe', 'pipe', 'pipe'] // 分别开启 stdin, stdout, stderr 管道
});
let stdoutBuffers = [];
let stderrBuffers = [];
py.stdout.on('data', (chunk) => stdoutBuffers.push(chunk));
py.stderr.on('data', (chunk) => stderrBuffers.push(chunk));
py.on('error', (err) => reject(new Error(`子进程派生失败: ${err.message}`)));
py.on('close', (code) => {
const stdoutText = Buffer.concat(stdoutBuffers).toString('utf8');
const stderrText = Buffer.concat(stderrBuffers).toString('utf8');
if (code !== 0) {
return reject(new Error(`Python 任务执行失败: ${stderrText || stdoutText}`));
}
try {
const result = JSON.parse(stdoutText);
resolve(result);
} catch (err) {
reject(new Error(`解析 Python 返回数据出错: ${err.message},原始内容: ${stdoutText}`));
}
});
// 核心操作:将 JavaScript 对象序列化后写入 Python 的 stdin 管道
const serialized = JSON.stringify(payload);
py.stdin.write(serialized, 'utf8', (err) => {
if (err) {
reject(new Error(`向 Python 管道写入数据失败: ${err.message}`));
} else {
// 结束输入流写入,触发 Python 端 sys.stdin.read() 的 EOF
py.stdin.end();
}
});
});
}
// 调用验证
async function main() {
const requestPayload = {
factor: 1.25,
records: [
{ id: 'REC-001', score: 85.5 },
{ id: 'REC-002', score: 42.0 },
{ id: 'REC-003', score: 91.0 }
]
};
const response = await processWithPythonPipe(requestPayload);
console.log("转换结果:", response);
}
main();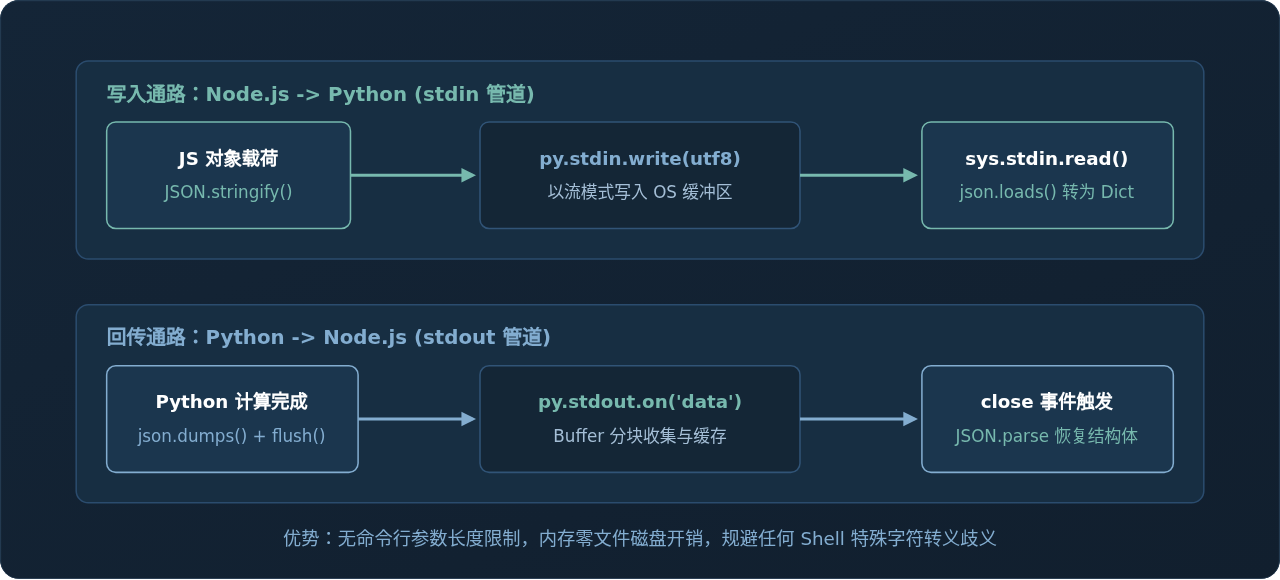
四、轻量替代方案:使用 execFile 执行轻量任务
对于执行时间短、返回文本量小(通常在几百字节到几十千字节以内)且仅需要一次性取得结果的场景,execFile 提供了更为简洁的回调式写法:
const { execFile } = require('child_process');
const path = require('path');

function getPythonEnvInfo() {
  return new Promise((resolve, reject) => {
    // 简单获取 Python 版本及关键环境信息
    const script = path.resolve(__dirname, 'info.py');

    execFile('python3', [script], {
      timeout: 5000,          // 5秒超时保护
      maxBuffer: 1024 * 1024  // 1MB 缓冲区上限
    }, (error, stdout, stderr) => {
      if (error) {
        if (error.killed) {
          return reject(new Error('子进程执行超时被系统强制终止'));
        }
        return reject(new Error(`执行出错: ${error.message},错误详情: ${stderr}`));
      }

      resolve(stdout.trim());
    });
  });
}
execFile 与 exec 的关键区别在于其不衍生外部 Shell,参数直接作为可执行文件的系统参数传递,从而杜绝了通过分号或管道符(如 ; rm -rf /)实施 Shell 注入攻击的可能。然而必须时刻关注其 maxBuffer 参数;一旦 Python 端因偶发打印过多日志导致缓冲区溢出,Node.js 会抛出 ERR_CHILD_PROCESS_STDIO_MAXBUFFER 错误并直接终止子进程。
五、生产环境高频陷阱与防范规范
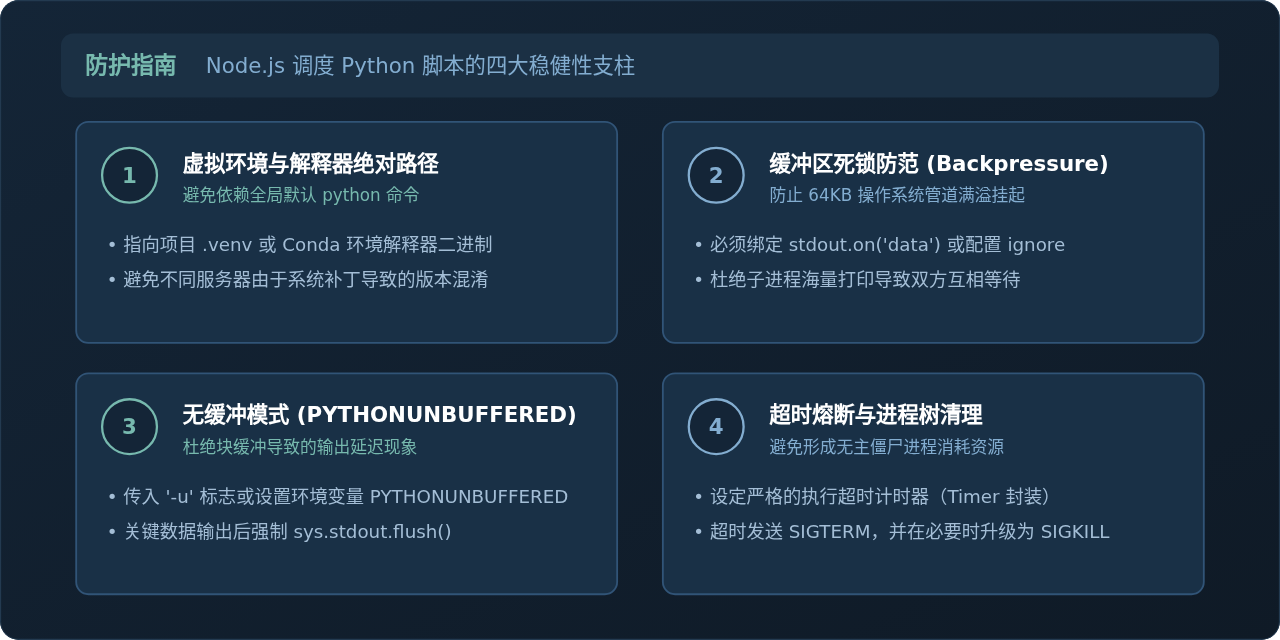
在将 Node.js 调用 Python 脚本的方案部署到生产环境(如 Docker 容器、云服务器或 CI/CD 流水线)时,常会遇到本地调试正常但线上偶发卡死或报错的情况。以下是四项核心检查规范:
1. Python 解释器路径兼容性与虚拟环境隔离
直接硬编码 python 或 python3 命令可能导致不可预料的环境混乱:很多生产环境系统(如 macOS 或部分精简 Linux 镜像)默认未配置全局 python 软链接,或者系统自带的 Python 与业务所需的虚拟环境(venv / conda)版本及依赖包不一致。推荐通过环境变量或绝对路径明确指定:
// 优先读取环境变量配置的解释器路径,缺省时根据平台选用
const PYTHON_PATH = process.env.PYTHON_EXECUTABLE_PATH ||
  (process.platform === 'win32'
    ? path.join(__dirname, '.venv', 'Scripts', 'python.exe')
    : path.join(__dirname, '.venv', 'bin', 'python3'));

const py = spawn(PYTHON_PATH, [scriptPath, ...args]);
2. 缓冲区死锁(反压反噬卡死)
操作系统为标准输入输出管道分配的缓冲区是有限的(通常为 64KB)。如果 Python 进程持续使用 print() 或 sys.stdout.write() 产生海量输出,而 Node.js 侧未主动监听 stdout.on('data') 去消费这些数据,管道缓冲区将被迅速填满。此时,Python 端对 stdout 的下一次写入调用会被操作系统挂起,直到有进程读取数据;如果 Node.js 还在等待进程退出,双方将陷入永久性死锁假死。因此,即使不需要处理输出,也必须显式读取流或在配置中将其重定向至 ignore。
3. 实时输出刷新与无缓冲模式(PYTHONUNBUFFERED)
在默认情况下,当 Python 的标准输出连接到管道(非交互式终端 TTY)时,其 I/O 库会启用默认块缓冲机制。这意味着 Python 中的 print() 语句不会立刻把数据刷入管道,而是等到积攒满 4KB 或 8KB 之后才向外推送。这会导致 Node.js 侧产生“卡顿长达数秒后突然收到一大坨数据”的现象。解决途径包括:
- 在启动子进程时传入
-u命令行标志:spawn('python3', ['-u', scriptPath])。 - 在
spawn的env配置项中注入PYTHONUNBUFFERED: '1'。 - 在 Python 代码中每次关键输出后显式调用
sys.stdout.flush()。
4. 超时控制与孤儿进程回收
若 Python 脚本内部因死循环、锁争用或第三方网络调用无响应而阻塞,子进程将长期占用服务器 CPU 与内存。为此,必须在 Node.js 端封装超时控制机制,并在超时触发时及时向子进程发送终止信号:
function executeWithTimeout(command, args, timeoutMs = 15000) {
  return new Promise((resolve, reject) => {
    const child = spawn(command, args);
    let isFinished = false;

    // 定时器监控超时
    const timer = setTimeout(() => {
      if (!isFinished) {
        isFinished = true;
        // 先发送优雅终止信号,若未响应可二次发送 SIGKILL
        child.kill('SIGTERM');
        reject(new Error(`执行超时(超过 ${timeoutMs}ms),已强制回收进程`));
      }
    }, timeoutMs);

    child.on('close', (code) => {
      if (!isFinished) {
        isFinished = true;
        clearTimeout(timer);
        resolve(code);
      }
    });

    child.on('error', (err) => {
      if (!isFinished) {
        isFinished = true;
        clearTimeout(timer);
        reject(err);
      }
    });
  });
}
总结
在 Node.js 中使用 child_process 调用 Python 脚本,不仅能够充分发挥 Node.js 的高并发异步优势,还能无缝承接 Python 生态在数据处理、科学计算与算法领域的强大算力:
- 对于常规及复杂数据交互,首选
spawn配合标准输入输出流(stdio)进行双向 JSON 通信,既避免了命令行字符长度限制,又能享有完全无限制的流式吞吐能力。 - 对于输出确定、返回极短的单次查询,可以使用
execFile提升编码简洁度,但需注意防范maxBuffer溢出风险。 - 在工程落地时,始终明确指定 Python 虚拟环境解释器的绝对路径,注入无缓冲环境变量,并辅以超时回收与错误管道监听机制,即可构建出健壮高效的跨语言协作系统。
Node.js中async/await异步读写文件最佳实践
2026-11-22 08:14:37
配置JS接口安全域名必须备案吗?HTTPS与备案状态要求说明
2026-11-19 21:48:35
LiteLLM v1.108.10 的兼容接口与 Vertex AI 转换规则有哪些变化?
2026-11-18 00:17:19
Node.js读取并解析本地JSON文件的方法
2026-11-17 19:11:58
Node.js Buffer用法:字符串、Hex与二进制的快速转换
2026-11-17 18:20:17