JS怎么用URLSearchParams高效提取查询参数
深入解析如何在 JavaScript 中使用原生 URLSearchParams 接口高效提取 URL 查询参数,涵盖数据源适配、单值与多值读取、自动解码原理及生产环境边界防护与避坑指南。
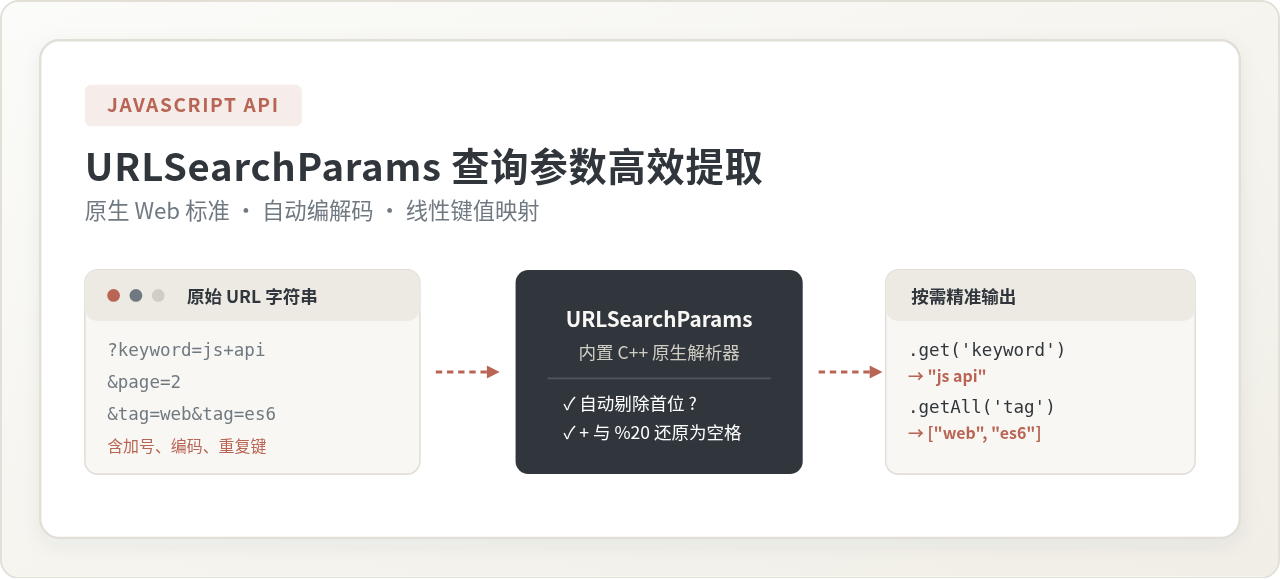
URLSearchParams 接口。它原生封装了键值切分、字符集解码以及多值聚合,不再需要编写容错率低的正则表达式或 split('&') 字符串拆分逻辑。无论在现代浏览器还是 Node.js 环境下,掌握其标准数据源接入与提取方法,都是编写健壮前端数据流的基础。
一、数据源识别与三种标准化实例化方式
在提取参数前,必须先将查询字符串喂给 URLSearchParams 构造函数。实际开发中参数来源主要分为三类:当前页面 URL、服务端接口返回的完整绝对 URL,以及单页应用中的 Hash 路由。
1. 读取当前浏览器地址栏参数
对于常规的前端页面,可以直接读取 window.location.search。构造函数会自动识别并剔除开头的问号 ?,不需要开发者手动执行 .substring(1) 或 .slice(1)。
// 假设当前地址为: https://example.com/search?keyword=javascript&page=2
const searchParams = new URLSearchParams(window.location.search);
console.log(searchParams.get('keyword'));2. 解析给定的完整 URL 字符串
当需要解析一个外部传入的完整网址时,严禁直接把整串 URL 传入 new URLSearchParams("https://...")。因为 URLSearchParams 只把入参当作纯查询字符串处理,协议与路径部分会被直接误识别为第一个参数的键名。推荐优先实例化 URL 对象,再通过其实例属性 .searchParams 直接获取已就绪的解析器。
const rawUrl = 'https://api.example.com/v1/posts?cat=tech&sort=desc';
const urlObj = new URL(rawUrl);
const searchParams = urlObj.searchParams; // searchParams 即为 URLSearchParams 实例
console.log(searchParams.get('cat'));3. 单页应用 Hash 路由参数截取
在部分基于 Hash 模式构建的老旧单页应用中(如 https://example.com/#/dashboard?orderId=1024),window.location.search 会返回空字符串,真实参数藏在 window.location.hash 之后。此时需要手动按问号切分后再构造:
const hashString = window.location.hash; // "#/dashboard?orderId=1024"
const queryString = hashString.includes('?') ? hashString.split('?')[1] : '';
const searchParams = new URLSearchParams(queryString);
console.log(searchParams.get('orderId'));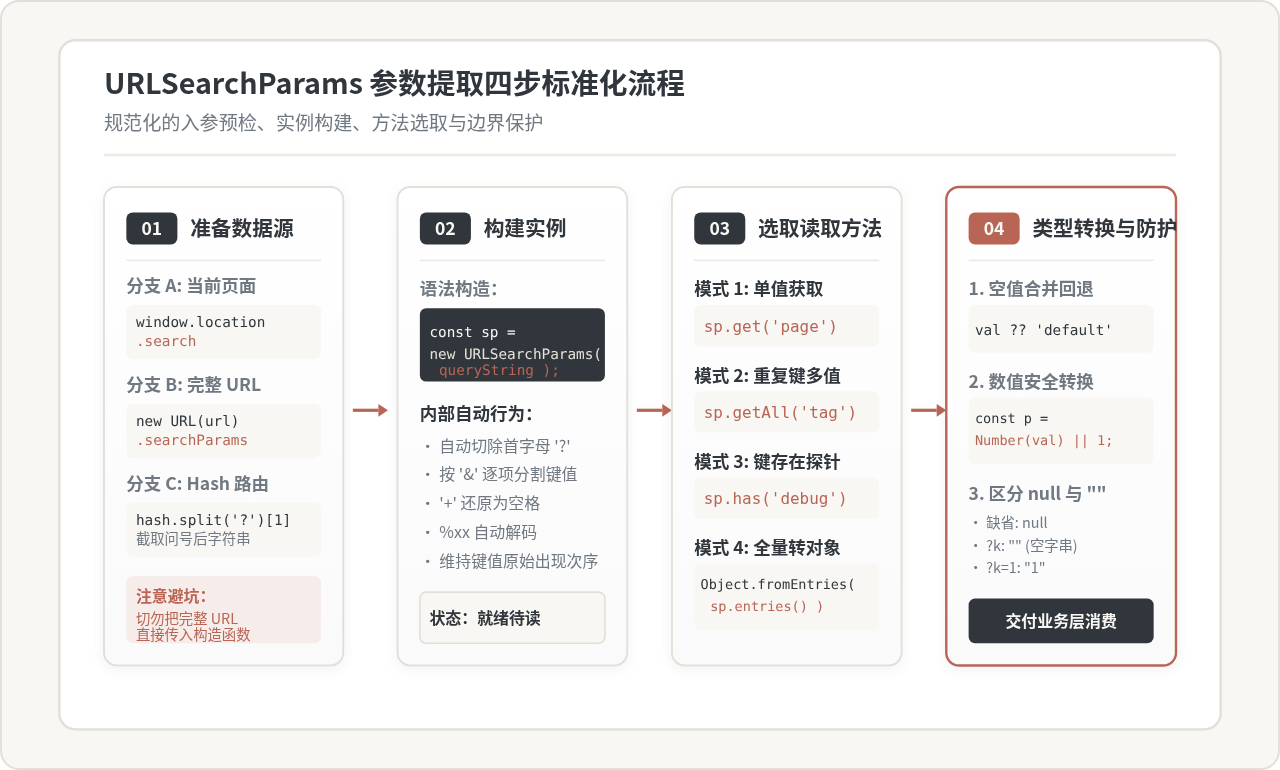
二、核心读取方法:单值、多值与全量转换
URLSearchParams 提供了多维度的提取接口。针对不同的业务场景,选用正确的方法能够避免空指针异常与隐性数据覆盖。
1. 获取单值:.get(name)
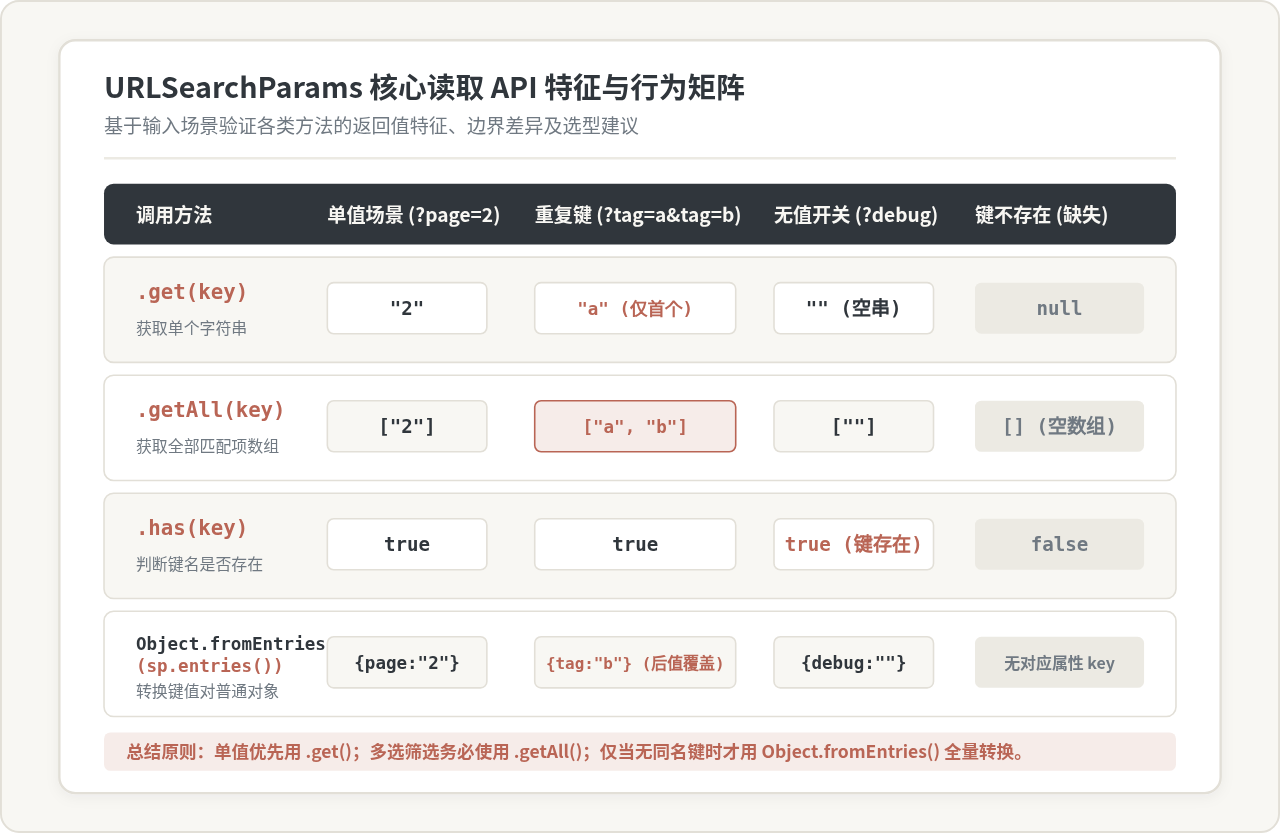
.get() 是最常用的提取方式。当传入指定的键名时,它返回对应的第一个字符串值。如果 URL 中不存在该参数,方法将明确返回 null,而绝非 undefined。
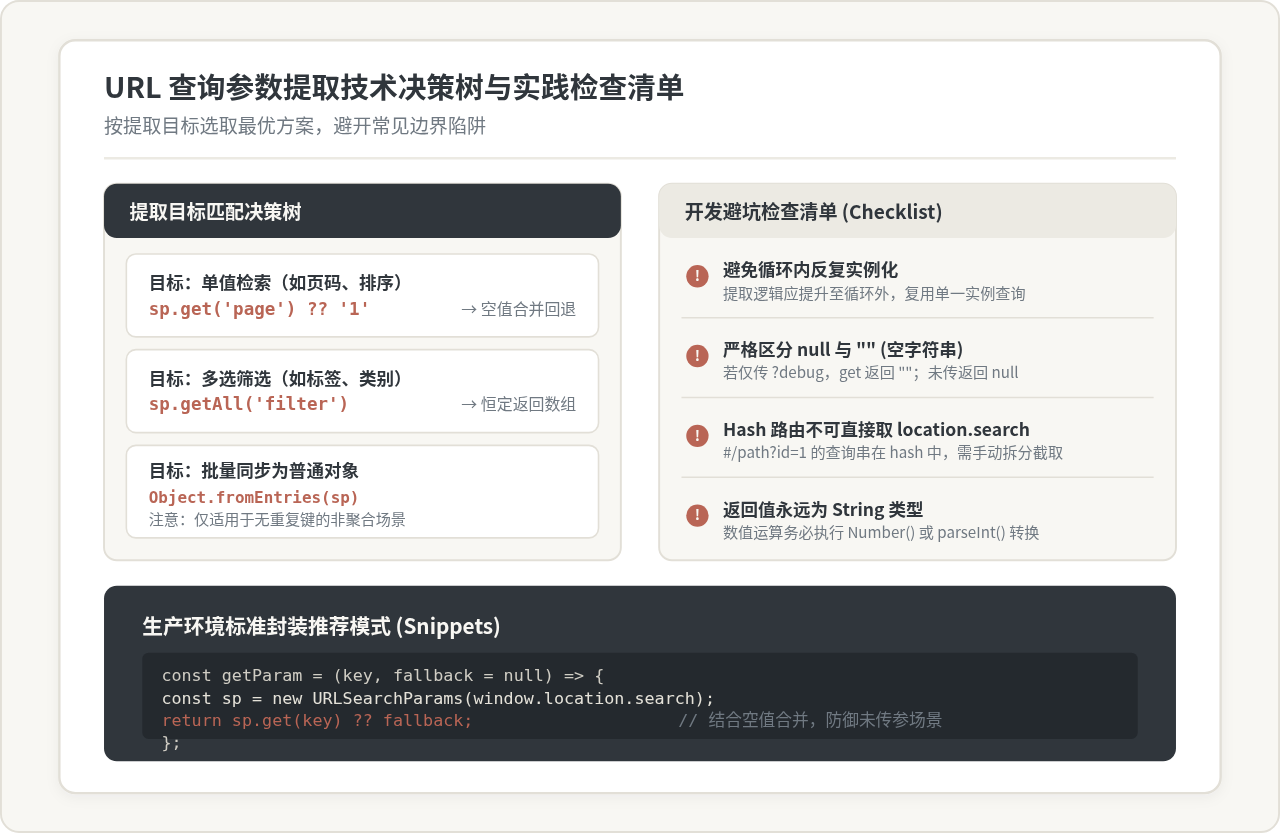
生产实践中,建议配合 ES2020 空值合并操作符 ?? 赋予合理的默认值。若需要将其作为数字参与业务逻辑,必须显式进行类型转换:
// 针对缺少 page 参数的场景,设定默认兜底值 1
const rawPage = searchParams.get('page');
const currentPage = rawPage !== null ? Number(rawPage) : 1;
console.log(currentPage);?status=open&status=closed),.get('status') 只会返回第一个出现的值 "open",其余同名值均被忽略。
2. 获取同名多值:.getAll(name)
在多选筛选器、标签云或批量查询场景中,同一个键名往往会被传递多次。此时必须使用 .getAll() 接口。它始终返回一个数组:
- 当参数存在时,返回包含所有匹配项字符串的数组;
- 当参数在 URL 中完全不存在时,恒定返回空数组
[],不会返回null。
// 目标 URL: ?tag=javascript&tag=typescript&tag=web
const tags = searchParams.getAll('tag');
console.log(tags);3. 参数存在性判断:.has(name)
如果只需要探测某项标记或开关是否存在(例如 ?debug 或 ?preview=true),可以直接使用 .has()。即使参数没有等号和值,只要键名出现,.has() 就会返回 true。
if (searchParams.has('debug')) {
  console.log('调试模式已激活');
}
4. 批量转换为纯 JavaScript 对象:Object.fromEntries()
URLSearchParams 原生实现了可迭代协议(Iterable)。借助 ES2019 的 Object.fromEntries(),只需一行代码即可把全部参数倾泻为一个扁平键值对对象,极大地简化了将查询参数批量注入表单状态或 Redux Store 的工作。
// 目标 URL: ?search=react&page=3&limit=20
const queryObj = Object.fromEntries(searchParams);
console.log(queryObj);Object.fromEntries() 无法处理多值同名参数。如果 URL 包含多个 tag,后出现的键会直接覆盖先出现的键。若有聚合需求,应使用 for...of 遍历 searchParams.entries() 自定义归集逻辑。
三、自动解码机制与特殊字符边界
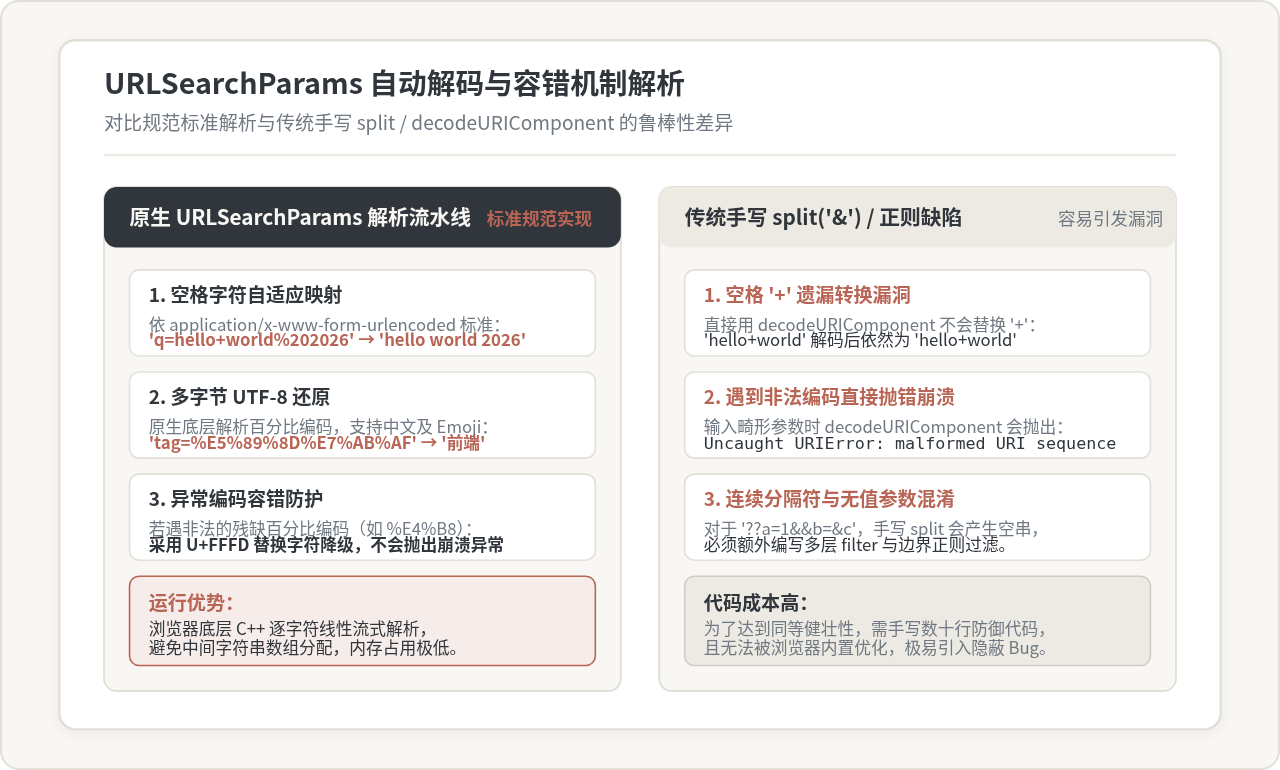
手写 URL 解析逻辑之所以极易引发线上缺陷,根源在于无法标准地处理各类 URL 编码边界。URLSearchParams 遵循标准的 application/x-www-form-urlencoded 规范,天然抹平了以下疑难边界。
1. 加号 + 与空格 %20 的双重解析
在早期的表单提交规范中,空格往往被编码为加号 +,而在标准 RFC 3986 中则编码为 %20。如果使用手写的 decodeURIComponent(),它是无法把 + 还原为空格的,必须外层手动补充正则替换。而 URLSearchParams 内部自动将 + 和 %20 统一映射为空格:
const sp = new URLSearchParams('query=modern+javascript%20toolkit');
console.log(sp.get('query'));2. 中文 UTF-8 百分比编码自动转换
无论键名还是键值,只要包含经 UTF-8 编码的特殊字符或中文,URLSearchParams 均会在读取时完成实时解码,开发者不需要在外层嵌套任何解码函数。
const sp = new URLSearchParams('title=%E6%B7%B1%E5%85%A5%E6%B5%85%E5%87%BA');
console.log(sp.get('title'));3. 空参数、缺省值与缺失参数的准确区分
在设计接口探针或表单重置时,必须严格区分以下三种状态:
- 仅有键名无等号(如
?flag):sp.has('flag')为true,sp.get('flag')返回空字符串""; - 有等号但无内容(如
?flag=):sp.get('flag')返回空字符串""; - 完全没有传递该键:
sp.has('flag')为false,sp.get('flag')返回null。
四、性能权衡与生产环境最佳实践
虽然 URLSearchParams 接口简单直观,但在高频执行链路以及工程封装中,依然存在一些需要权衡的实践考量。
1. 为什么弃用手写正则与 split('&')
开发者常误以为在简单场景下用 split 速度更快,但实际上:
- 内存开销:
split('&')配合split('=')会在 JS 堆内存中频繁分配中间数组与字符串碎片,在密集交互中会触发垃圾回收抖动; - 异常防御:如果 URL 中包含残缺的畸形编码(如
%E4%B8),手写decodeURIComponent会直接抛出未捕获的URIError: malformed URI sequence导致整个页面脚本崩溃;而URLSearchParams在底层由 C++ 直接线性遍历,遇到非法序列会优雅降级为替换字符,保障系统绝对可用。
2. 避免在高频事件中重复构造实例
在 window.onscroll、鼠标移动事件或上万条长列表的 map 循环中,切勿在每次迭代中都执行 new URLSearchParams(window.location.search)。由于当前页面的查询参数并不会在毫秒级内变化,应将其实例化后缓存复用,或在需要响应 URL 变更时再触发重载:
// 错误示范:在循环中反复解析
list.forEach(item => {
  const sp = new URLSearchParams(window.location.search); // 严重损耗性能
  process(item, sp.get('mode'));
});

// 正确示范:提升实例作用域
const sp = new URLSearchParams(window.location.search);
list.forEach(item => {
  process(item, sp.get('mode'));
});
五、工程化通用读取函数封装
基于上述所有边界考虑,在实际业务模块中,可以封装一个精炼、健壮的工具函数,用于安全读取当前或指定 URL 的查询参数:
/**
 * 安全提取 URL 查询参数
 * @param {string} key - 参数名
 * @param {string|null} fallback - 默认回退值
 * @param {string} [customSearch] - 可选的自定义查询字符串,默认当前页面 search
 * @returns {string|null}
 */
function getQueryParam(key, fallback = null, customSearch) {
  const source = customSearch !== undefined
    ? customSearch
    : (typeof window !== 'undefined' ? window.location.search : '');

  const params = new URLSearchParams(source);
  const value = params.get(key);
  return value !== null ? value : fallback;
}

// 使用示例
const keyword = getQueryParam('keyword', '');
const page = Number(getQueryParam('page', '1'));
借助 URLSearchParams 规范,现代前端与 Node.js 服务端在处理查询参数时,不仅代码大幅精简,也彻底根除了因字符编码、重复键名与边界格式带来的隐藏隐患。在需要获取参数时,根据单值或多值诉求,直接调用 .get() 或 .getAll() 即可达到最优的开发与运行效率。
JS互动式表白代码:点击按钮触发隐藏惊喜的实现原理
2026-11-22 09:21:46
JS给hidden类型input赋值的注意事项
2026-11-21 22:58:47
原生JS怎么获取radio单选按钮的选中值
2026-11-21 19:31:14
JS控制下按钮仍不可点击?检查disabled属性与状态同步
2026-11-21 15:19:56
HTML中调用JS函数传递参数的正确写法
2026-11-21 14:18:54