

JS字符串转二进制:TextEncoder与Uint8Array转换指南
深入讲解现代JavaScript中如何使用TextEncoder将字符串转为二进制Uint8Array字节数组,涵盖核心原理、encode与encodeInto操作步骤、UTF-8变长编码长度差异及逆向TextDecoder验证。
在现代 JavaScript 中,将字符串转换为物理二进制字节序列的标准方案是内置的 TextEncoder API。只需一行代码 new TextEncoder().encode(str),即可将任意包含 ASCII、中文或 Emoji 的文本快速转译为 UTF-8 编码规范的 Uint8Array 字节数组。本文将系统拆解从字符串到二进制缓冲区的完整转换流程、底层内存分布模型、高性能原地写入方法以及多字节字符的长度计算陷阱。
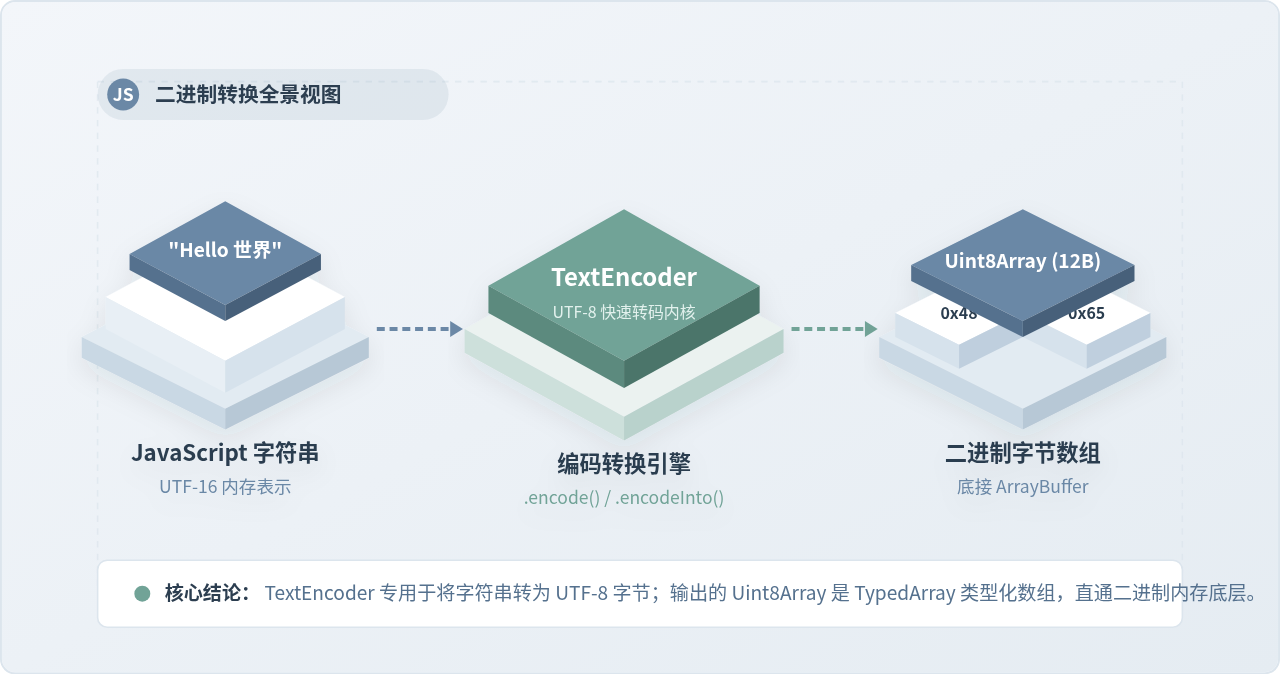
一、核心认知:JS 字符串与二进制数据的本质区别
在深入代码之前,需要明确为什么 JavaScript 中的字符串不能直接等同于二进制字节数组:
- 字符串在 JS 引擎内部的表现形式:JavaScript 规范(ECMAScript)规定字符串以 UTF-16 代码单元(Code Units,每个单元占 16 位/2 字节)序列形式保存在堆内存中。程序中访问的字符长度
str.length,本质上是 UTF-16 代码单元的个数,而非网络传输中通用的物理字节数。 - 网络与文件对二进制的需求:当通过 WebSocket 发送二进制帧、调用 Web Crypto API 生成 SHA-256 哈希散列、操作 WebGL 纹理数据或保存二进制文件时,底层环境要求的是紧凑、连续的无符号 8 位字节(UTF-8 字节流)。
- 类型化数组(TypedArray):
Uint8Array是 JavaScript 提供的 8 位无符号整数视图,它映射在底层的连续内存块ArrayBuffer之上,每一个元素严格对应内存中的一个物理字节(数值范围 0~255)。
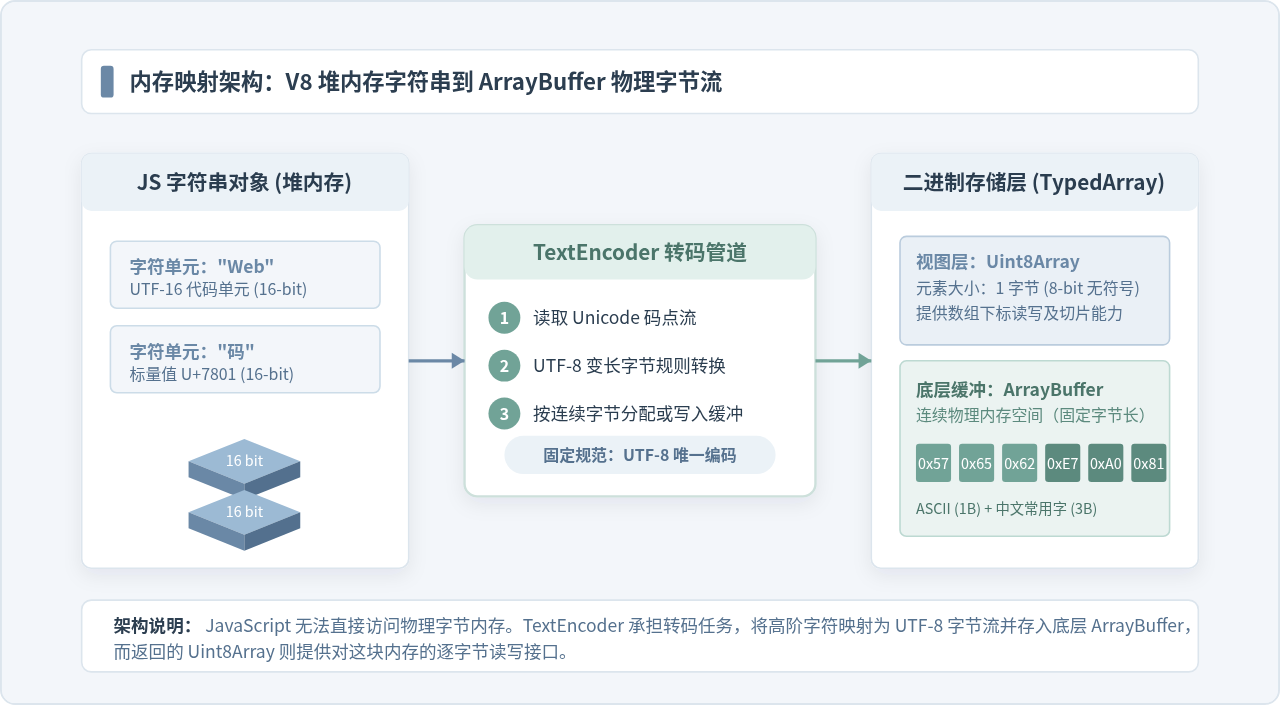
二、标准转换操作:实例化 TextEncoder 与 encode()
TextEncoder 是 WHATWG 编码标准及 W3C 规范中的原生全局对象,目前已被所有主流浏览器、Node.js 11+、Deno 与 Bun 全面支持,无需安装任何额外依赖。
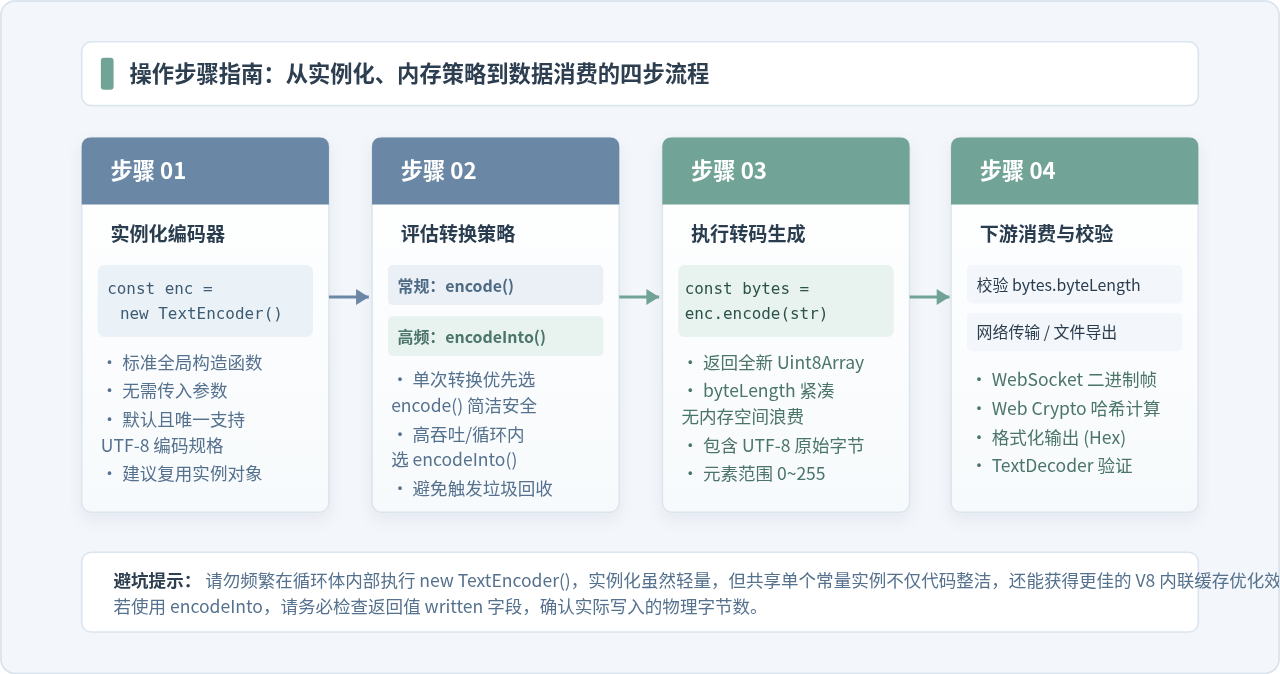
1. 基础转换代码示例
// 步骤 1:创建 TextEncoder 实例
const encoder = new TextEncoder();

// 步骤 2:准备目标文本(包含 ASCII 英文字符与常用中文)
const message = "Hello 世界";

// 步骤 3:执行编码,获取 Uint8Array
const uint8Bytes = encoder.encode(message);

// 输出查看结果
console.log(uint8Bytes);
console.log("字符长度 (str.length):", message.length);
console.log("字节长度 (byteLength):", uint8Bytes.byteLength);Uint8Array(12) [ 72, 101, 108, 108, 111, 32, 228, 184, 150, 231, 149, 140 ]
字符长度 (str.length): 8
字节长度 (byteLength): 12
在上面的示例中,原始字符串 "Hello 世界" 的 str.length 为 8(5 个英文字母 + 1 个空格 + 2 个汉字),但转为二进制后得到的 uint8Bytes.byteLength 为 12。这是因为 UTF-8 编码是一种变长机制:前 6 个 ASCII 字符各占 1 字节,而每个中文常用汉字在 UTF-8 下各占 3 字节(5 + 1 + 3 * 2 = 12)。
2. 查看二进制的不同格式(十进制、十六进制与比特位)
获得 Uint8Array 后,可以根据不同的调试或传输需求将其格式化输出:
// 1. 转为十六进制 Hex 字符串(常用于网络报文调试或密钥展示)
const hexString = Array.from(uint8Bytes)
  .map(byte => byte.toString(16).padStart(2, '0'))
  .join(' ');
console.log("Hex 格式:", hexString);

// 2. 转为 8 位纯二进制位串 (01 序列)
const bitString = Array.from(uint8Bytes)
  .map(byte => byte.toString(2).padStart(8, '0'))
  .join(' ');
console.log("Binary 比特流:", bitString);Hex 格式: 48 65 6c 6c 6f 20 e4 b8 96 e7 95 8c
Binary 比特流: 01001000 01100101 01101100 01101100 01101111 00100000 11100100 10111000 10010110 11100111 10010101 10001100
三、高性能场景:利用 encodeInto() 实现零内存重新分配
默认的 encode() 方法每次被调用时,都会在底层申请分配一个新的 ArrayBuffer 并构造一个全新的 Uint8Array 实例。如果在高频事件监听器、WebSocket 数据吞吐或大型文件切片处理等密集循环中频繁调用,会触发频繁的垃圾回收(GC),造成页面掉帧或服务延迟增加。
为此,标准规范提供了 encodeInto() 方法,允许将字符串直接原地写入到一个已经分配好的 Uint8Array 缓冲切片中。
const encoder = new TextEncoder();
const sourceText = "高性能传输";

// 1. 预先分配一块足够大的定长缓冲区(例如 64 字节)
const destinationBuffer = new Uint8Array(64);

// 2. 将字符串直接原地编码写入到 destinationBuffer
// 返回一个包含 read(读取的字符数)和 written(写入的字节数)的对象
const result = encoder.encodeInto(sourceText, destinationBuffer);

console.log("已读取字符数:", result.read);
console.log("已写入物理字节数:", result.written);

// 3. 截取有效写入区段的视图(共享同一底层 ArrayBuffer,无额外内存开销)
const validDataView = destinationBuffer.subarray(0, result.written);
console.log("有效字节序列:", validDataView);已读取字符数: 5
已写入物理字节数: 15
有效字节序列: Uint8Array(15) [ 233, 171, 152, 230, 128, 167, 232, 131, 189, 228, 188, 160, 232, 190, 147 ]
如果目标 destinationBuffer 的剩余容量不足以容纳整个字符串转码后的 UTF-8 字节,encodeInto() 会在不会切碎多字节字符的前提下尽可能多地写入完整字符,并在 result.read 中返回实际成功读取转换的字符数。因此,预分配容量时应确保预留充足的空间。
四、避坑指南:UTF-8 变长字节与长度计算陷阱
在处理二进制数据时,最容易出现的逻辑 Bug 往往来源于混淆了 str.length 与 uint8Array.byteLength:
- ASCII 字符(0x00 ~ 0x7F):如英文、数字、基本标点,在 UTF-8 中固定占用 1 字节。此时字符数与字节数 1:1 相等。
- 常见中文汉字(基本多语言平面 BMP):如
"中"、"文"、"码",在 UTF-8 中固定占用 3 字节。一个长度为 10 的纯中文字符串,转换后需要 30 个字节。 - Emoji 与生僻字(辅助平面 Supplementary Plane):例如
"🚀"、"🎉",在 JavaScript 字符串中由一对 UTF-16 代理对(Surrogate Pair)表示,导致"🚀".length === 2;但在 UTF-8 编码下,它实际占用 4 个物理字节。
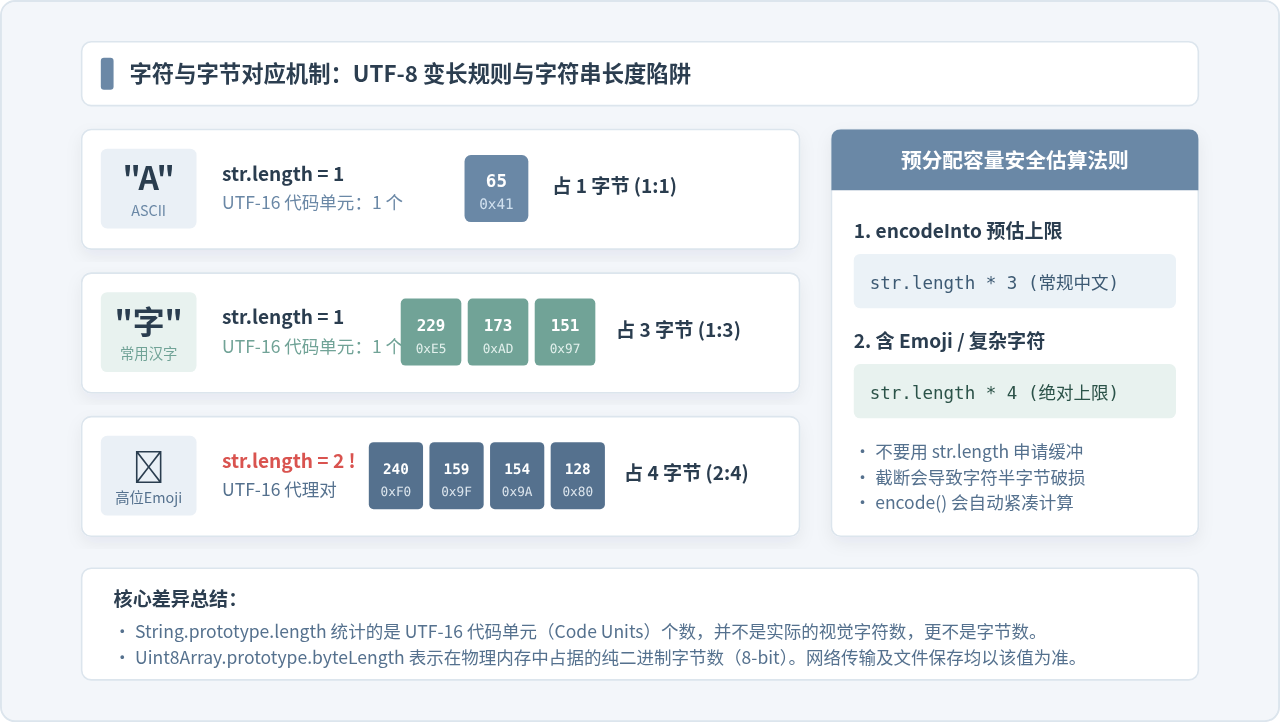
预分配缓冲区的安全估算公式
若需要使用 encodeInto() 对未知用户输入的文本预分配内存空间,可遵循以下安全估算规则:
- 对于常规中文业务文本:安全上限设为
str.length * 3。 - 对于包含表情符号或未知特殊语系的文本:理论最大绝对上限为
str.length * 4(由于高位 Emoji 在 JS 中 length 本身为 2 且对应 4 字节,str.length * 2在纯 Emoji 场景下即够用,但* 3或* 4更为稳妥)。
五、逆向校验与方案对比
1. 逆向还原:使用 TextDecoder 将 Uint8Array 转回字符串
为了确保转换得到的二进制数据准确无误,可以使用成对的 TextDecoder 将其解码回原始字符串进行验证:
const encoder = new TextEncoder();
const decoder = new TextDecoder("utf-8");

const originalStr = "数据流测试 123";
const binaryData = encoder.encode(originalStr);

// 逆向反序列化还原
const decodedStr = decoder.decode(binaryData);
console.log("还原结果一致性:", decodedStr === originalStr); // 输出: true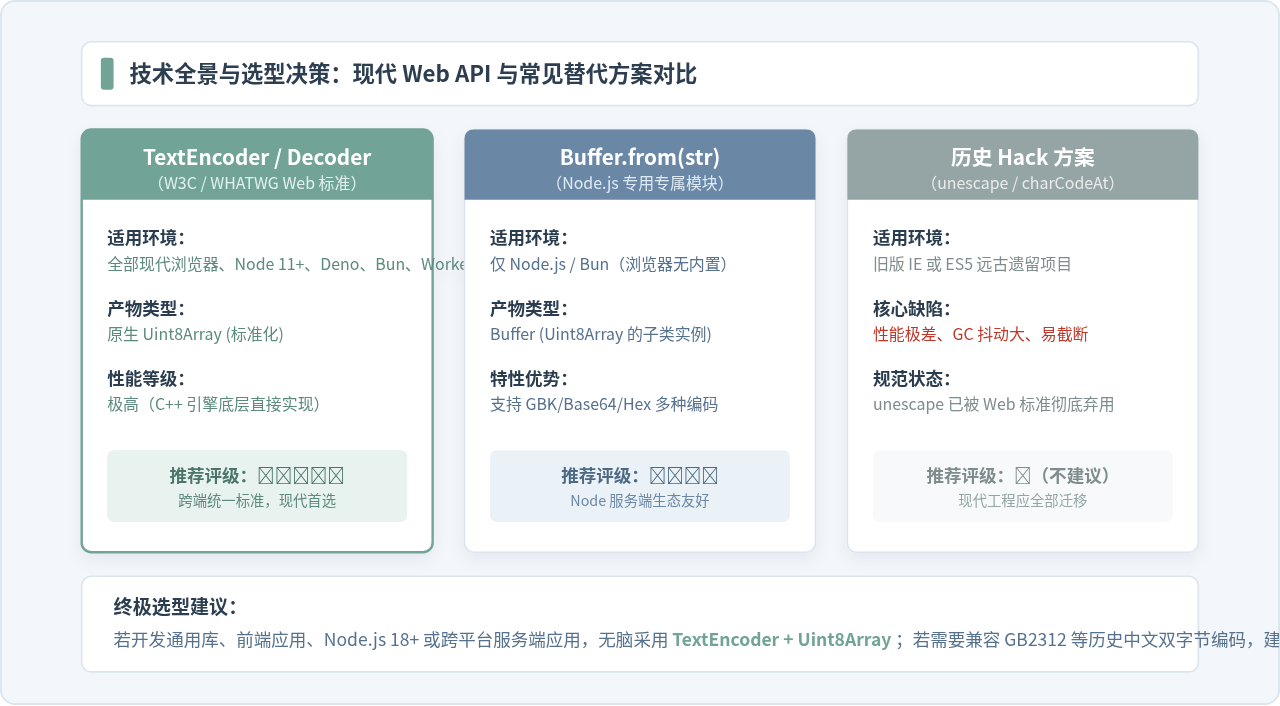
2. 技术选型与历史方案对比
| 方案 | 调用方式 | 适用环境 | 返回值类型 | 优缺点评价 |
|---|---|---|---|---|
| TextEncoder (推荐) | new TextEncoder().encode(str) |
现代浏览器、Node 11+、Deno、Bun | Uint8Array |
官方标准规范,高性能原生引擎实现,跨端通用。 |
| Node.js Buffer | Buffer.from(str, 'utf-8') |
Node.js 服务端生态 | Buffer (继承自 Uint8Array) |
支持多种历史编码(GBK、Hex、Base64),但无法直接在纯前端浏览器环境免垫片运行。 |
| 历史 Hack (已废弃) | unescape(encodeURIComponent(str)) |
老旧浏览器 (IE) | 包装字符串 / 数组 | 已被现代 Web 规范彻底弃用,性能损耗大,存在内存泄漏隐患,切勿在新项目中使用。 |
六、总结与实践建议
将 JavaScript 字符串转为二进制字节是前端处理音视频流、加密通信、文件上传及 WebAssembly 交互的基础设施级操作。在实际工程落地中,请牢记以下三项核心实践原则:
- 唯一默认编码:
TextEncoder规范严格限定且仅支持 UTF-8 编码,不支持在构造函数中传入其他编码格式。若需支持 GBK 等历史字符集,应在解码端使用new TextDecoder('gbk')或借助第三方专用转码库。 - 实例复用:在模块顶层创建单个
const encoder = new TextEncoder()实例供全局函数复用,避免在短生命周期的局部作用域或循环中反复创建对象。 - 区分视图与缓冲:
encode()返回的Uint8Array是一个内存视图。若下游接口需要底层原始内存块(如Worker.postMessage的转移所有权操作),应传递uint8Array.buffer属性。
JavaScript中ArrayBuffer、Blob与Base64的相互转换方法
2026-11-20 19:56:45
JS时间相减为什么是毫秒?理解Date隐式转换与单位换算
2026-11-20 16:06:51
OC与JS交互时JSValue到NSObject的类型转换规则
2026-11-20 10:33:50
NGINX2Root(CVE-2026-123007)排查与升级处置手册:版本自查、热升级与临时缓解
2026-11-20 10:31:56
为什么很多人觉得JavaScript比Python难:弱类型陷阱与DOM操作解析
2026-11-19 21:41:21







