JavaScript汇编器开发中怎么处理二进制数据与指令编码
深入讲解在JavaScript汇编器开发中如何使用ArrayBuffer与DataView高效管理底层二进制数据,利用按位操作实现精确的指令字段拼装、大小端序列化以及标签符号回填重定位。
ArrayBuffer、DataView 与类型化数组(Uint8Array),开发者可以直接操作连续的线性内存字节;借助 JavaScript 的 32 位按位运算符(位移 <<、位或 |、按位与掩码 & 及无符号右移 >>> 0),可以将操作码(Opcode)、寄存器索引和立即数压缩合成为机器字,再通过指定端序(Endianness)写入内存。结合符号表与两遍扫描机制,即可稳定产出精确的机器代码。
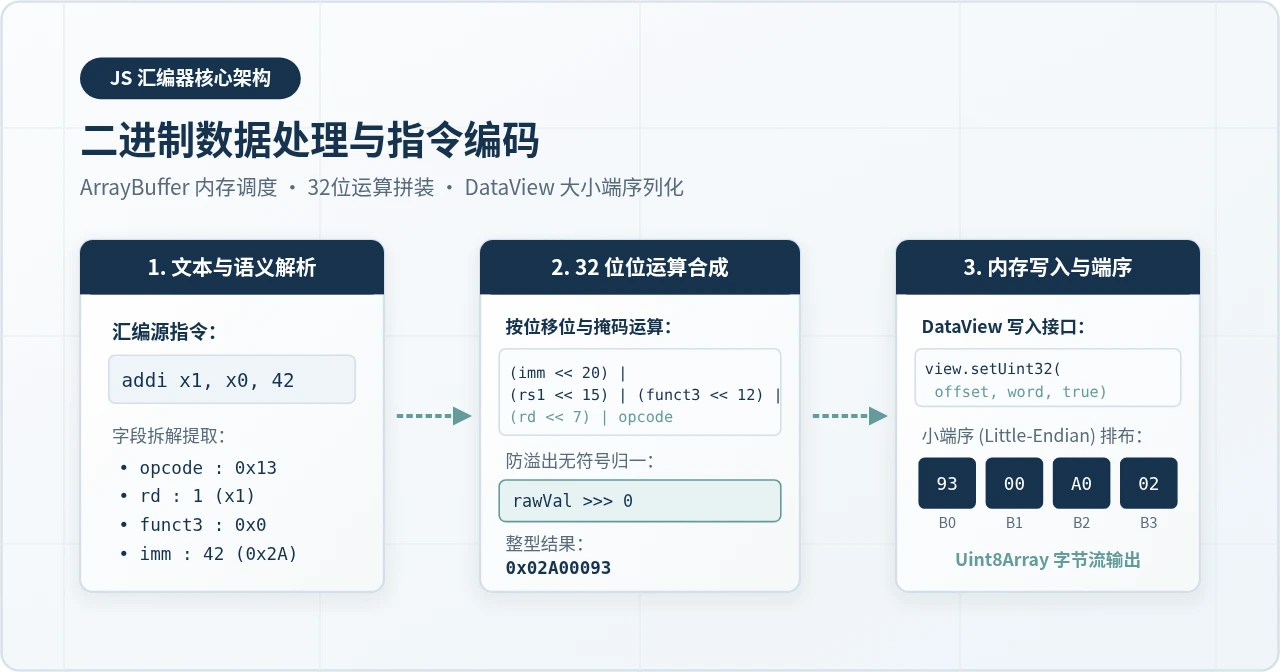
一、JavaScript 底层二进制内存模型:ArrayBuffer、DataView 与 Uint8Array 的分工
开发汇编器不能使用 JavaScript 普通的动态数组(Array)。普通数组内部是由 JS 引擎动态优化的对象数组或散列列表,不仅无法保证物理内存的连续性,还会发生类型拆装箱,造成不可预测的性能开销,更无法控制单字节层面的内存排布。
ECMAScript 规范提供的类型化数组体系包含三组核心构件,它们在汇编器开发中各司其职:
-
ArrayBuffer(底层物理内存块):代表一段固定长度的原始连续二进制内存空间。它本身不具备直接读写其内容的方法,仅仅是一块纯粹的字节承载实体。 -
DataView(多端序读写视图):汇编器最核心的写入工具。与固定类型的Uint32Array相比,DataView允许在缓冲区的任意字节偏移量(Offset)处读写不同宽度的数据(如 8 位、16 位、32 位或 64 位),并且每个读写方法都提供一个littleEndian布尔参数,允许显式指定采用小端序还是大端序,从而摆脱宿主 CPU 架构自身端序的限制。 -
Uint8Array(字节级操作与导出切片):通常用于汇编过程中的单字节写入、缓冲区块拷贝(TypedArray.prototype.set),以及最终截取并导出机器码供外部保存为.bin文件或直接注入模拟器执行。
设计自动扩容的动态字节缓冲区(ByteWriter)
由于汇编源代码的行数和最终生成的二进制体积在开始解析前是未知的,而 ArrayBuffer 一旦创建就拥有固定长度,因此必须设计一个能够自动扩容的字节写入器。
通常采用类似 std::vector 或 ArrayList 的成倍扩容策略:初始分配一段合理大小(如 1024 字节)的 ArrayBuffer,维护一个写入游标(cursor / pc)。当写入指令检测到剩余空间不足时,分配一个容量为原容量 2 倍的新 ArrayBuffer,利用 Uint8Array.prototype.set 将旧数据高速拷贝至新缓冲区,并重置 DataView。汇编完成后,只需调用 subarray(0, cursor) 即可获得紧凑的二进制机器码。
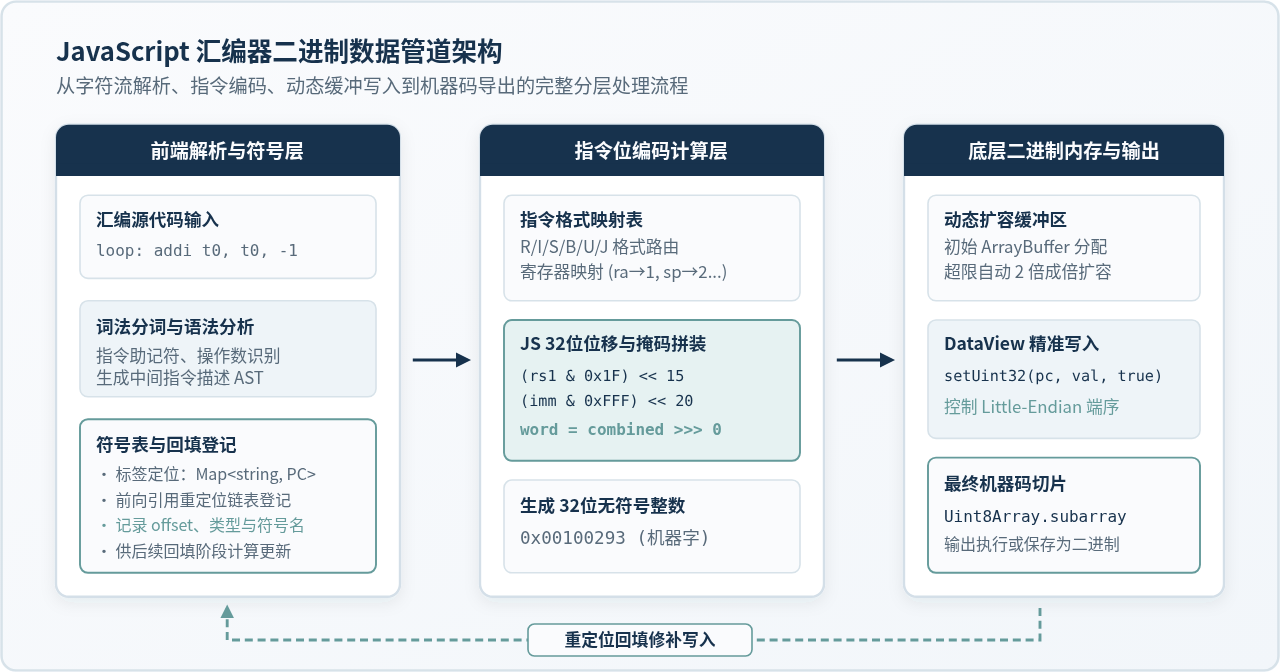
二、指令格式拆解与位运算编码:从汇编语法到机器字
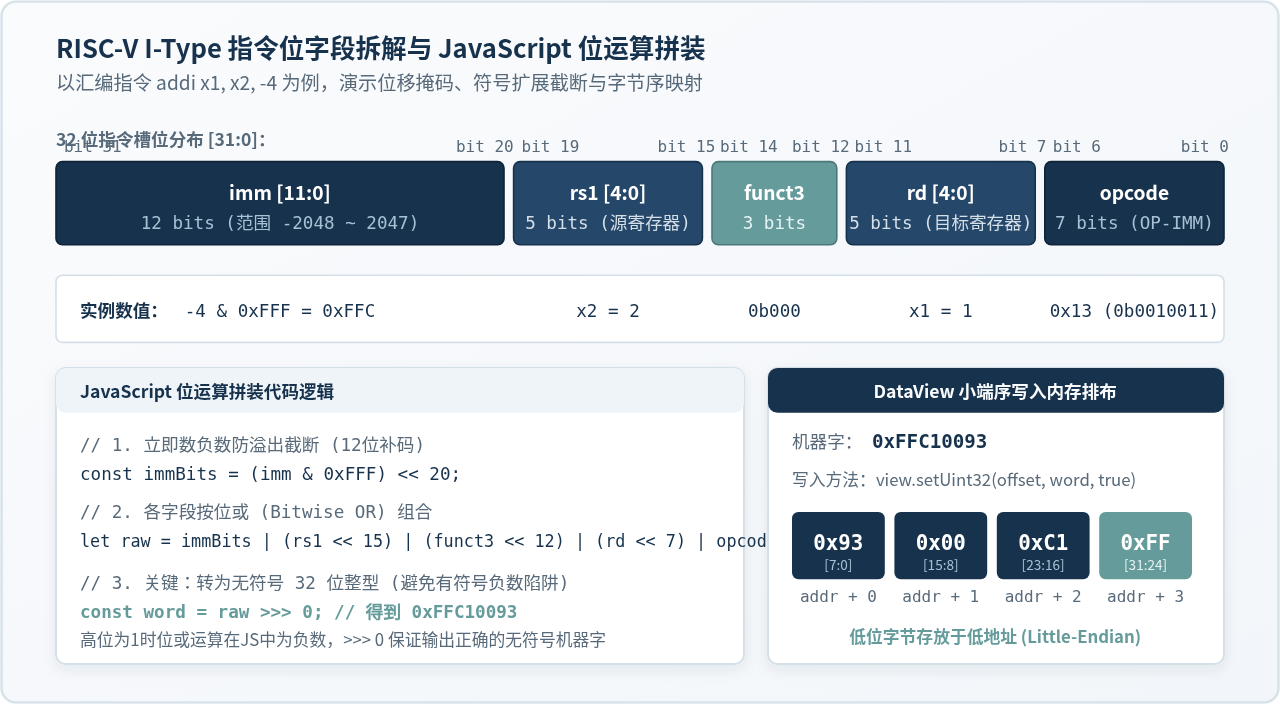
现代精简指令集(以经典的 RISC-V 32I 基础整数指令集为例)具有规整的 32 位定长指令格式。每条 32 位的机器指令都被严格划分为若干个位字段(Bit-fields):
- opcode(操作码):通常占据低 7 位(bit 6..0),定义指令的主类型(如算术运算、加载、分支、跳转)。
- rd(目标寄存器):占据 5 位(bit 11..7),可寻址 x0 到 x31 共 32 个通用寄存器。
- funct3(3 位功能码):占据 3 位(bit 14..12),在相同 opcode 下进一步细分操作(如
add与sub的 funct3 均为 0x0,而sll为 0x1)。 - rs1(第一源操作数寄存器):占据 5 位(bit 19..15)。
- rs2(第二源操作数寄存器):占据 5 位(bit 24..20)。
- funct7 / imm(功能高位或立即数字段):占据高位(bit 31..25 或 bit 31..20)。
位运算字段拼装的核心算式
在 JavaScript 中,将各个字段合成为一个完整的 32 位机器整数,依赖于左移位运算符(<<)与按位或运算符(|):
// 以 RISC-V 的 R-type 指令 (如 add rd, rs1, rs2) 为例:
function encodeR(opcode, funct3, funct7, rd, rs1, rs2) {
  return (
    ((funct7 & 0x7F) << 25) |
    ((rs2 & 0x1F) << 20) |
    ((rs1 & 0x1F) << 15) |
    ((funct3 & 0x07) << 12) |
    ((rd & 0x1F) << 7) |
    (opcode & 0x7F)
  );
}
ECMAScript 规范明确规定:所有按位运算符(<<、>>、|、&、^、~)在执行操作前,都会强制将操作数转为 32 位有符号二进制补码整数(Int32)。
如果一条指令的 bit 31 为 1(例如立即数是负数,或者高位字段最高位为 1),那么连续执行 | 位或运算后,计算结果在 JavaScript 内部将被视作负数。例如 0xFFC10093 会被表示为 -4128621。
虽然 DataView.prototype.setUint32 在底层写入时会自动截断高位只取低 32 位,但如果在打印日志、比较校验或调试时直接使用该负数,极易引起混淆。工程最佳实践是在每次位拼装表达式的最外层追加无符号右移 >>> 0,强制将其转为 [0, 4294967295] 范围内的无符号整数(Uint32)。
负数立即数的符号截断与掩码约束
汇编指令经常使用负数偏移,例如 addi x1, x2, -4。在 JavaScript 中,-4 是 64 位双精度浮点数,执行按位操作时会被转为 32 位带符号整数:
// -4 的 32 位二进制补码为 0xFFFFFFFC
// RISC-V I-Type 指令的立即数槽位仅有 12 位(bit 31..20)
// 必须使用掩码 (imm & 0xFFF) 截取低 12 位,再左移 20 位
const imm12 = -4 & 0xFFF; // 得到 0x00000FFC
const immField = imm12 << 20; // 得到 0xFFC00000 (32 位带符号负数)
如果不进行 & 0xFFF 掩码截断,直接执行 (-4) << 20,高位多余的符号位 1 会在进行位或合并时污染其他低位字段(如 rs1、funct3 等),导致最终生成的机器码全盘错误。
三、端序控制与字节序列化写入实践
把位运算拼装出的 32 位整数写入实际内存时,必须严格遵守目标 CPU 架构的字节序(Endianness)规范。
x86、x86-64 与主流 RISC-V 硬件均采用小端序(Little-Endian),即数据的最低有效字节(LSB)存放在内存的最低地址处。例如 32 位机器字 0xFFC10093 在内存中的 4 个连续字节依次为:
偏移 0: 0x93  (最低有效字节 [7:0])
偏移 1: 0x00  (次低有效字节 [15:8])
偏移 2: 0xC1  (次高有效字节 [23:16])
偏移 3: 0xFF  (最高有效字节 [31:24])
若使用普通的 Uint32Array 直接赋值(如 u32Array[0] = word),写入结果完全取决于当前运行 JavaScript 代码的宿主机器原生端序。虽然现代桌面与服务器 CPU 绝大部分为小端序,但为了保证跨平台、跨环境运行的绝对确定性,汇编器中应统一使用 DataView.prototype.setUint32(offset, word, true)。第三个参数传入布尔值 true,代表显式强制以小端序序列化,即便在罕见的大端序平台(或未来新型虚拟环境)下也能产出完全一致的目标二进制文件。
四、符号解析与跳转指令重定位:两遍扫描与回填机制
汇编语言中普遍存在前向跳转(Forward Reference)。例如在函数开头编写 beq x1, x0, exit 指令时,exit 标签可能定义在后方数百行之外,当前行无法得知 exit 的具体地址,因而无法直接计算出相对偏移。
工程上解决该问题有两种标准范式:两遍扫描(Two-Pass Assembly)与单遍扫描结合回填表(One-Pass with Backpatching)。
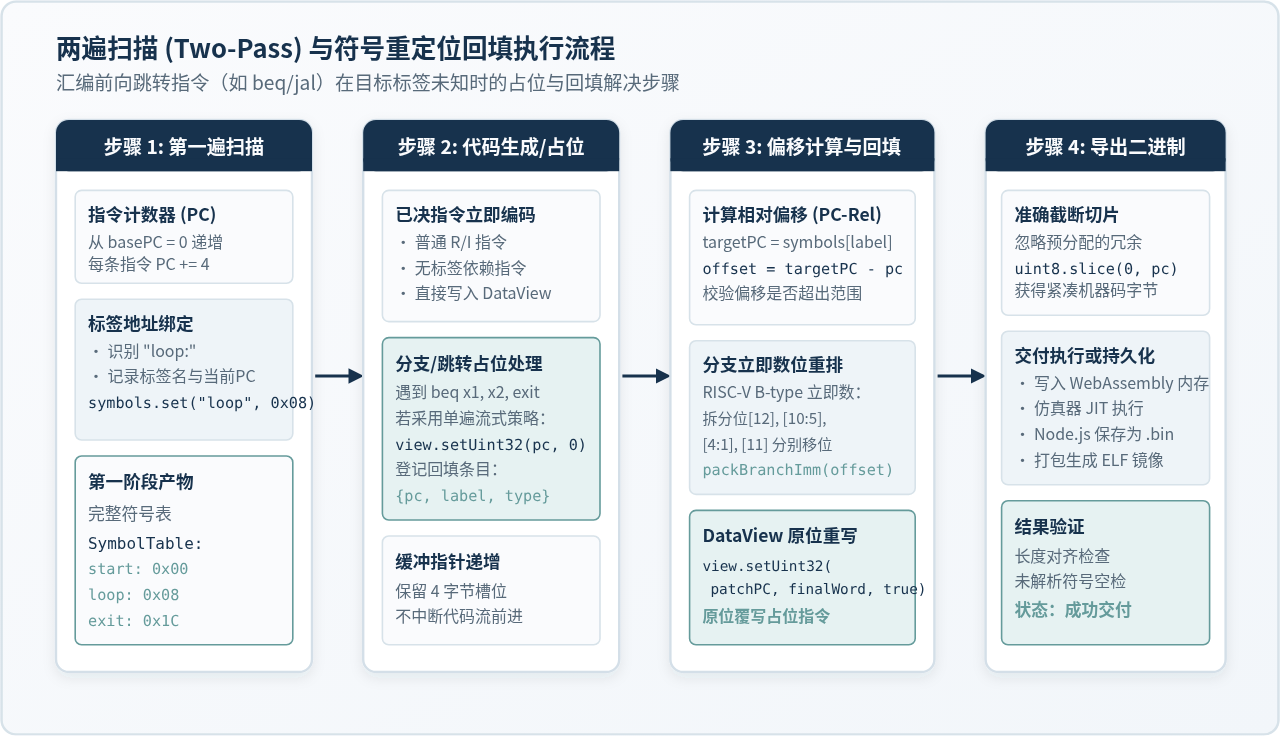
两遍扫描的具体执行步骤
-
第一遍扫描(Pass 1 - 符号收集):
遍历汇编指令行,维护一个程序计数器
currentPC(从 0 开始,每条 32 位指令自增 4)。当遇到类似loop:或exit:的标签时,在符号表(Map<string, number>)中记录symbolTable.set(labelName, currentPC)。第一遍扫描不输出机器码,只提取标签与地址的精确映射。 -
第二遍扫描(Pass 2 - 编码生成):
重置
currentPC = 0,重新逐行读取指令。此时所有标签的绝对 PC 均已存在于符号表中。当遇到跳转或分支指令(如beq x1, x2, label)时,直接计算 PC 相对偏移量offset = targetPC - currentPC,再将其编码为指令内部的立即数字段,直接写入DataView。
在 RISC-V 架构设计中,为了硬件解码器的扇出最简化,B-Type 指令的 12 位相对跳转偏移量(以 2 字节为步长,最低位 bit 0 恒为 0,因此编码 [12:1] 共 12 个 bit)被刻意打散在指令的四个不同区域:
offset[12]位于指令 bit 31offset[10:5]位于指令 bit 30..25offset[4:1]位于指令 bit 11..8offset[11]位于指令 bit 7
在 JavaScript 中回填分支偏移时,必须通过精确的位提取函数将其分别重组到对应槽位:
function packBImm(offset) {
  const b12   = (offset >> 12) & 0x1;
  const b10_5 = (offset >> 5)  & 0x3F;
  const b4_1  = (offset >> 1)  & 0xF;
  const b11   = (offset >> 11) & 0x1;
  return (
    (b12 << 31) |
    (b10_5 << 25) |
    (b4_1 << 8) |
    (b11 << 7)
  ) >>> 0;
}
五、实战实现:编写一个轻量级 RISC-V 32 位汇编器
将上述所有原理融会贯通,下面是一个结构清晰、自包含且可在任何现代 JavaScript(Node.js 或浏览器控制台)中直接运行的汇编器示例。它实现了动态缓冲区管理、指令字典映射、位字段编码以及两遍扫描符号解析。
/**
 * 动态扩容的二进制字节写入器
 */
class ByteWriter {
  constructor(initialCapacity = 1024) {
    this.buffer = new ArrayBuffer(initialCapacity);
    this.view = new DataView(this.buffer);
    this.cursor = 0;
  }

  ensureCapacity(bytesNeeded) {
    if (this.cursor + bytesNeeded <= this.buffer.byteLength) return;
    let newCap = this.buffer.byteLength * 2;
    while (newCap < this.cursor + bytesNeeded) newCap *= 2;

    const newBuffer = new ArrayBuffer(newCap);
    new Uint8Array(newBuffer).set(new Uint8Array(this.buffer));
    this.buffer = newBuffer;
    this.view = new DataView(this.buffer);
  }

  writeUint32LE(val) {
    this.ensureCapacity(4);
    this.view.setUint32(this.cursor, val >>> 0, true);
    this.cursor += 4;
  }

  getBytes() {
    return new Uint8Array(this.buffer, 0, this.cursor);
  }
}

/**
 * RISC-V 寄存器名到索引映射 (x0 ~ x31 及其 ABI 别名)
 */
const REGISTERS = {
  zero: 0, ra: 1, sp: 2, gp: 3, tp: 4, t0: 5, t1: 6, t2: 7,
  s0: 8, fp: 8, s1: 9, a0: 10, a1: 11, a2: 12, a3: 13, a4: 14,
  a5: 15, a6: 16, a7: 17, s2: 18, s3: 19, s4: 20, s5: 21,
  s6: 22, s7: 23, s8: 24, s9: 25, s10: 26, s11: 27, t3: 28,
  t4: 29, t5: 30, t6: 31
};
for (let i = 0; i < 32; i++) REGISTERS[`x${i}`] = i;

function parseReg(regStr) {
  const r = REGISTERS[regStr.trim().toLowerCase()];
  if (r === undefined) throw new Error(`未知的寄存器名称: ${regStr}`);
  return r;
}

/**
 * 指令位编码函数
 */
function encodeR(opcode, funct3, funct7, rd, rs1, rs2) {
  return (
    ((funct7 & 0x7F) << 25) |
    ((rs2 & 0x1F) << 20) |
    ((rs1 & 0x1F) << 15) |
    ((funct3 & 0x07) << 12) |
    ((rd & 0x1F) << 7) |
    (opcode & 0x7F)
  ) >>> 0;
}

function encodeI(opcode, funct3, rd, rs1, imm) {
  const imm12 = imm & 0xFFF;
  return (
    (imm12 << 20) |
    ((rs1 & 0x1F) << 15) |
    ((funct3 & 0x07) << 12) |
    ((rd & 0x1F) << 7) |
    (opcode & 0x7F)
  ) >>> 0;
}

function encodeB(opcode, funct3, rs1, rs2, offset) {
  const b12   = (offset >> 12) & 0x1;
  const b10_5 = (offset >> 5)  & 0x3F;
  const b4_1  = (offset >> 1)  & 0xF;
  const b11   = (offset >> 11) & 0x1;
  return (
    (b12 << 31) |
    (b10_5 << 25) |
    ((rs2 & 0x1F) << 20) |
    ((rs1 & 0x1F) << 15) |
    ((funct3 & 0x07) << 12) |
    (b4_1 << 8) |
    (b11 << 7) |
    (opcode & 0x7F)
  ) >>> 0;
}

/**
 * 核心两遍扫描汇编器
 */
function assemble(source) {
  const lines = source.split('\n');
  const symbols = new Map();
  const parsedInstructions = [];

  // ====== 第一遍扫描 (Pass 1):建立符号表并过滤语句 ======
  let currentPC = 0;
  for (const rawLine of lines) {
    let line = rawLine.replace(/#.*$/, '').trim(); // 移除注释
    if (!line) continue;

    // 解析标签 (如 loop:)
    if (line.includes(':')) {
      const [label, rest] = line.split(':');
      symbols.set(label.trim(), currentPC);
      line = rest ? rest.trim() : '';
      if (!line) continue;
    }

    // 提取助记符与操作数
    const match = line.match(/^([a-zA-Z0-9_]+)\s*(.*)$/);
    if (!match) continue;
    const mnemonic = match[1].toLowerCase();
    const args = match[2] ? match[2].split(',').map(s => s.trim()) : [];

    parsedInstructions.push({ pc: currentPC, mnemonic, args });
    currentPC += 4; // 每条 RV32I 指令固定占据 4 字节
  }

  // ====== 第二遍扫描 (Pass 2):编码指令并解析相对跳转 ======
  const writer = new ByteWriter(parsedInstructions.length * 4);

  for (const inst of parsedInstructions) {
    const { pc, mnemonic, args } = inst;
    let word = 0;

    switch (mnemonic) {
      case 'addi': {
        const rd = parseReg(args[0]);
        const rs1 = parseReg(args[1]);
        const imm = parseInt(args[2], 10);
        word = encodeI(0x13, 0x0, rd, rs1, imm);
        break;
      }
      case 'add': {
        const rd = parseReg(args[0]);
        const rs1 = parseReg(args[1]);
        const rs2 = parseReg(args[2]);
        word = encodeR(0x33, 0x0, 0x00, rd, rs1, rs2);
        break;
      }
      case 'sub': {
        const rd = parseReg(args[0]);
        const rs1 = parseReg(args[1]);
        const rs2 = parseReg(args[2]);
        word = encodeR(0x33, 0x0, 0x20, rd, rs1, rs2);
        break;
      }
      case 'beq': {
        const rs1 = parseReg(args[0]);
        const rs2 = parseReg(args[1]);
        const targetLabel = args[2];
        if (!symbols.has(targetLabel)) {
          throw new Error(`未定义的标签符号: ${targetLabel} 在 PC=0x${pc.toString(16)}`);
        }
        const targetPC = symbols.get(targetLabel);
        const offset = targetPC - pc; // PC 相对寻址
        word = encodeB(0x63, 0x0, rs1, rs2, offset);
        break;
      }
      default:
        throw new Error(`暂不支持的指令助记符: ${mnemonic}`);
    }

    writer.writeUint32LE(word);
  }

  return writer.getBytes();
}
示例运行与十六进制验证
我们可以输入一段简单的计数循环汇编代码,验证其生成的机器码:
// 汇编源程序:初始化 t0 为 10,每轮循环减 1,直到等于 zero 则退出
const asmCode = `
  addi t0, zero, 10
loop:
  addi t0, t0, -1
  beq  t0, zero, exit
  beq  zero, zero, loop
exit:
  addi a0, t0, 0
`;

const machineCode = assemble(asmCode);

// 格式化输出为 16 进制字符串进行验证
const hexString = Array.from(machineCode)
  .map(b => b.toString(16).padStart(2, '0'))
  .join(' ');

console.log("最终输出的二进制机器码字节流 (Little-Endian):");
console.log(hexString);
// 输出示例:
// 13 02 a0 00  (addi t0, zero, 10 -> 0x00a00293)
// 93 02 f2 ff  (addi t0, t0, -1   -> 0xfff28293)
// 63 84 02 00  (beq  t0, zero, 8  -> 0x00028463)
// 63 0c 00 fe  (beq  zero, zero, -8 -> 0xfe000ce3)
// 13 05 02 00  (addi a0, t0, 0    -> 0x00028513)
六、汇编器开发技术决策与避坑总结
在完成指令编码与数据处理逻辑后,我们总结出 JavaScript 汇编器开发中的四大关键维度决策:
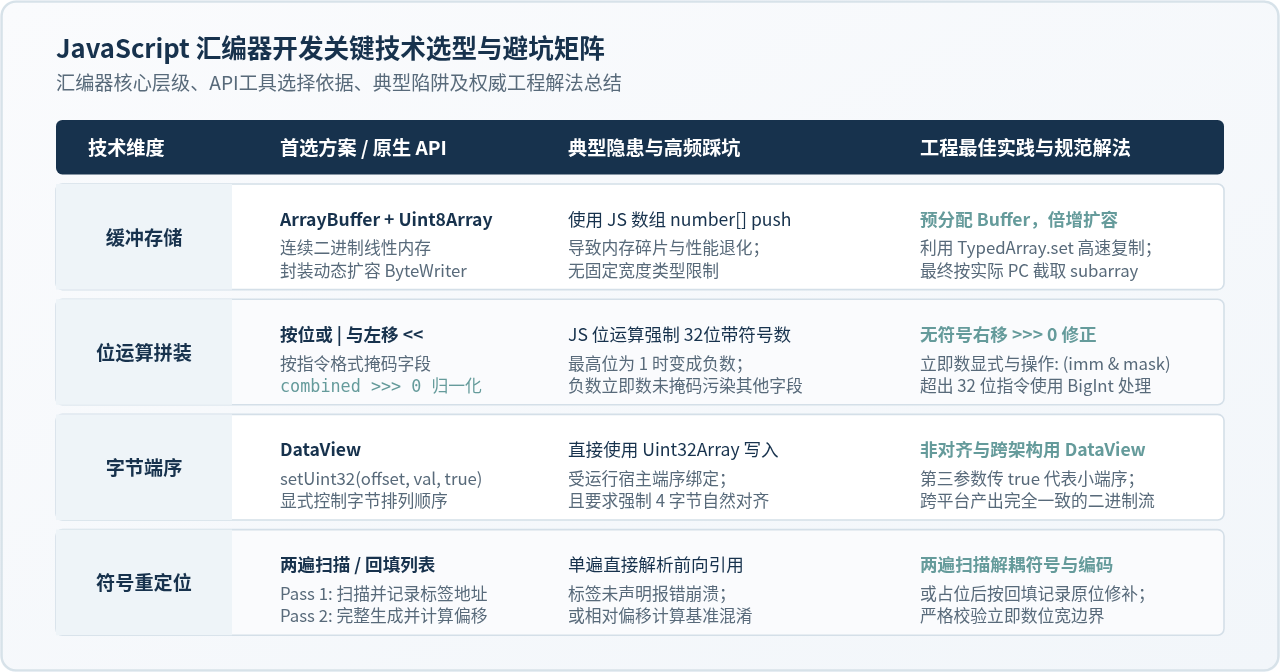
归纳而言,在 JavaScript 中开发高可靠的汇编器需要始终掌握以下三条基准原则:
-
内存结构上:统一采用
ArrayBuffer配合动态扩容包裹类,杜绝原生Array.push带来的类型泛化和重整损耗;对外交互统一使用Uint8Array字节切片。 -
指令运算上:针对每一个位字段进行显式掩码(如
& 0x1F、& 0xFFF),在涉及高位为 1 或负数立即数运算时,在位或拼装外部显式追加>>> 0,消除 32 位带符号整型副作用。 -
字节排布上:序列化阶段坚持使用
DataView.prototype.setUint32(offset, word, true)强约束小端序,消除宿主运行环境原生端序的偶发差异;对前向引用的跳转指令,采用清晰解耦的两遍扫描建立符号表,确保相对偏移的精确重定位。
DBeaver 26.2.5的AI连接范围如何理解,哪些SQL问题得到修复?
2026-11-16 11:03:50
前端JS防止SQL注入的两种实现方式
2026-10-30 05:23:31
jQuery实现元素拖动排序及数据库更新示例
2026-10-28 07:22:28
JS实现无需数据库的县级以上联动行政区域下拉控件
2026-10-27 13:41:08
JavaScript 读写本地 SQLite 数据库:封装类与浏览器 Demo 实践
2026-10-26 11:06:32