

JS大规模数组对比性能优化:从O(n2)到O(n)
针对大规模JavaScript数组在求差集、交集与对象差异比对时容易出现的O(n²)性能瓶颈,本文深入讲解如何利用Set与Map将时间复杂度降至O(n),涵盖基础数据比对、复杂对象Diff、复合主键构造及内存分块策略。
在大规模数据处理与前端状态同步中,数组对比是最基础也是最容易引发性能崩溃的操作。许多开发者直觉编写的 filter 配合 includes 或 some,在百条数据内表现良好,但当数据规模达到上万甚至数十万条时,页面会出现长达数秒的无响应冻结。解决这个问题的核心路径并不复杂:放弃让元素反复进行线性查找,利用 Set 或 Map 预先构建哈希索引,将单次比对的开销由 O(m) 降为 O(1),从而使整体算法从灾难级的 O(n²) 跃升为线性的 O(n)。
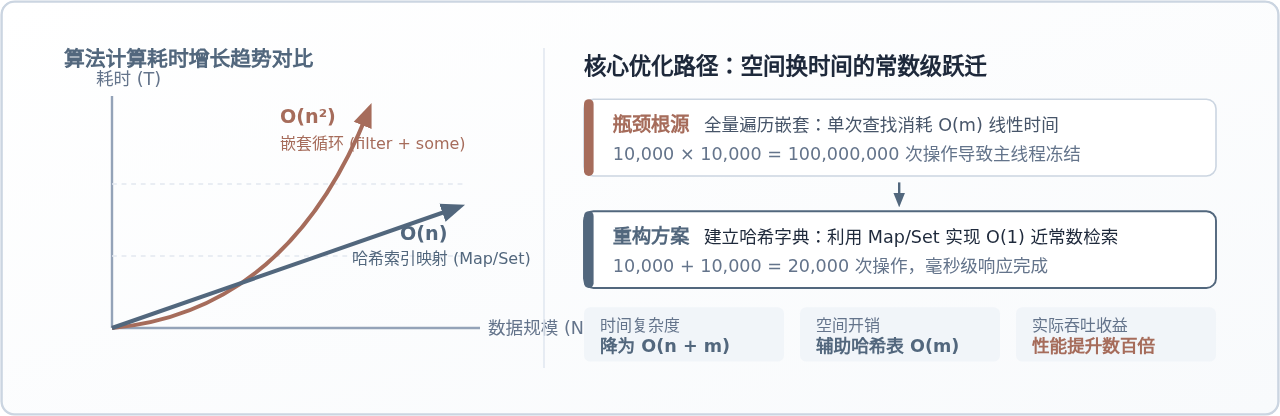
一、性能灾难的根源:双重循环与隐式嵌套
考察一段在业务开发中极为普遍的差集计算代码。假设需要找出存在于 listA 中但不存在于 listB 中的记录:
// 直觉编写的代码:隐藏着 O(N × M) 的双重嵌套
const difference = listA.filter(itemA =>
  !listB.some(itemB => itemB.id === itemA.id)
);
表面上看,这里只有一个 filter 方法调用,似乎非常简明优雅。但在底层执行引擎中,filter 会对 listA 完整遍历 N 次;对于每一次遍历,内部的 some 又会对 listB 执行一次线性扫描(平均扫描 M / 2 次,最坏 M 次)。
当 N = 10,000 且 M = 10,000 时,这行代码将触发多达 100,000,000(1 亿)次 条件判断。JavaScript 是单线程执行的,密集的 CPU 密集型运算会牢牢占据主线程,导致浏览器无法响应任何用户输入,渲染帧率瞬间跌至 0,出现显著的卡顿甚至无响应告警。
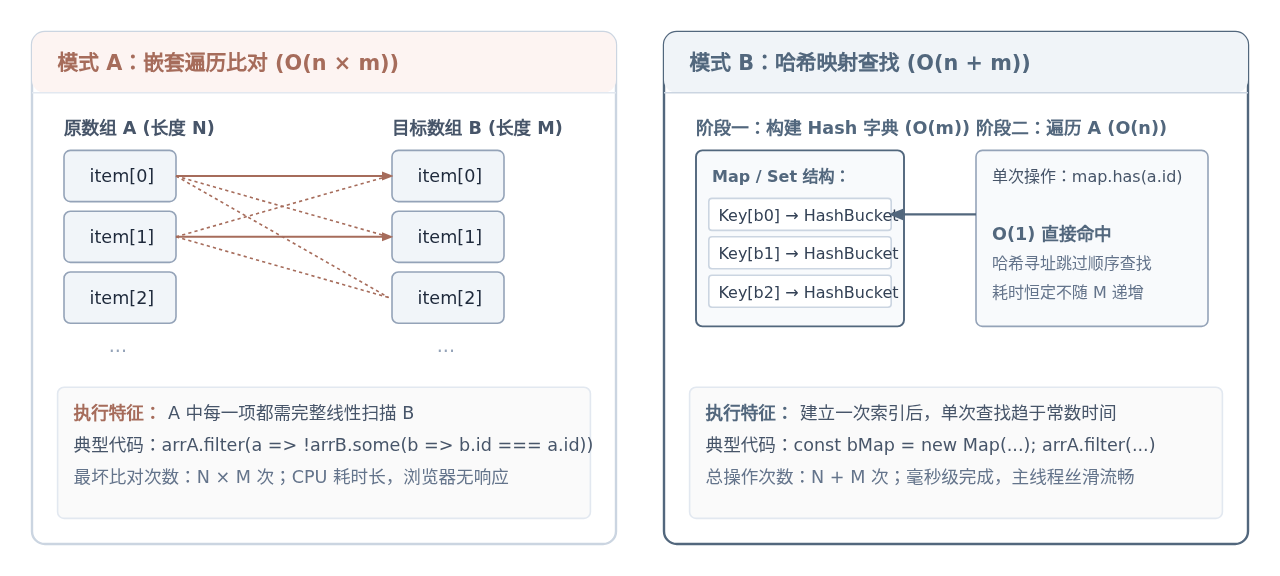
从上图可以直观看到,模式 A 的操作连线呈现网状爆炸。要终结这种指数级的耗时增长,必须打破“每一项都重新扫描目标集合”的循环依赖,将其拆解为独立的两个阶段:先以 O(m) 时间构建一个能瞬间定位的哈希查找表,再以 O(n) 时间进行快速校验。
二、基础标量数组的比对:Set 的集合运算
对于元素为数字、字符串或 Symbol 等基础类型的数组,优化手段最为直接:使用 ES6 提供的原生 Set 数据结构。Set 在底层由哈希表(Hash Table)实现,其 has() 方法在绝大多数情况下具有常数级 O(1) 的时间复杂度。
1. 差集、交集与并集重构示例
// 原始数据准备(以两个包含 10 万随机整数的数组为例)
const arrA = Array.from({ length: 100000 }, () => Math.floor(Math.random() * 200000));
const arrB = Array.from({ length: 100000 }, () => Math.floor(Math.random() * 200000));

// 1. 差集计算 (A - B):仅存在于 A 中的元素
const bSet = new Set(arrB); // O(m) 预处理
const diffA = arrA.filter(x => !bSet.has(x)); // O(n) 单次过滤

// 2. 交集计算 (A ∩ B):同时存在于 A 和 B 的元素
const intersection = arrA.filter(x => bSet.has(x));

// 3. 对称差集 ((A - B) ∪ (B - A)):不同时属于两者的元素
const aSet = new Set(arrA);
const symmetricDiff = [
  ...arrA.filter(x => !bSet.has(x)),
  ...arrB.filter(x => !aSet.has(x))
];
2. 实测性能数据参考
在 V8 引擎(Node.js 20+ / Chrome 最新版)环境下,对比 10 万级整数数组比对的典型耗时表现:
| 实现方案 | 时间复杂度 | 10,000 项数据耗时 | 100,000 项数据耗时 | 主线程表现 |
|---|---|---|---|---|
filter() + includes() |
O(n²) | 约 180 ms | 约 18,500 ms (18.5s) | 严重假死,触发卡顿 |
Set + filter() |
O(n) | 约 2 ms | 约 18 ms | 瞬间完成,无感感知 |
Set.prototype.has() 采用 SameValueZero 比较算法,能够正确识别 NaN(即 NaN === NaN 判定为存在),且 +0 与 -0 视为相等。但如果数组内存储的是对象引用,则只有指向内存同一地址的对象才会命中。
三、复杂对象数组的增量比对(Diff):Map 索引化
真实项目中最普遍的需求是对象数组的比对。例如在前端表格、可视化大屏或数据持久化同步中,需要比对“旧版本数据”与“新拉取数据”,精确归类出:新增项(Added)、修改项(Updated)以及删除项(Deleted)。
针对这类场景,Map 是最优选择。我们以对象的唯一业务主键(如 id 或 uuid)为键,以对象本身为值建立哈希映射,按照标准四步流完成全量 Diff:
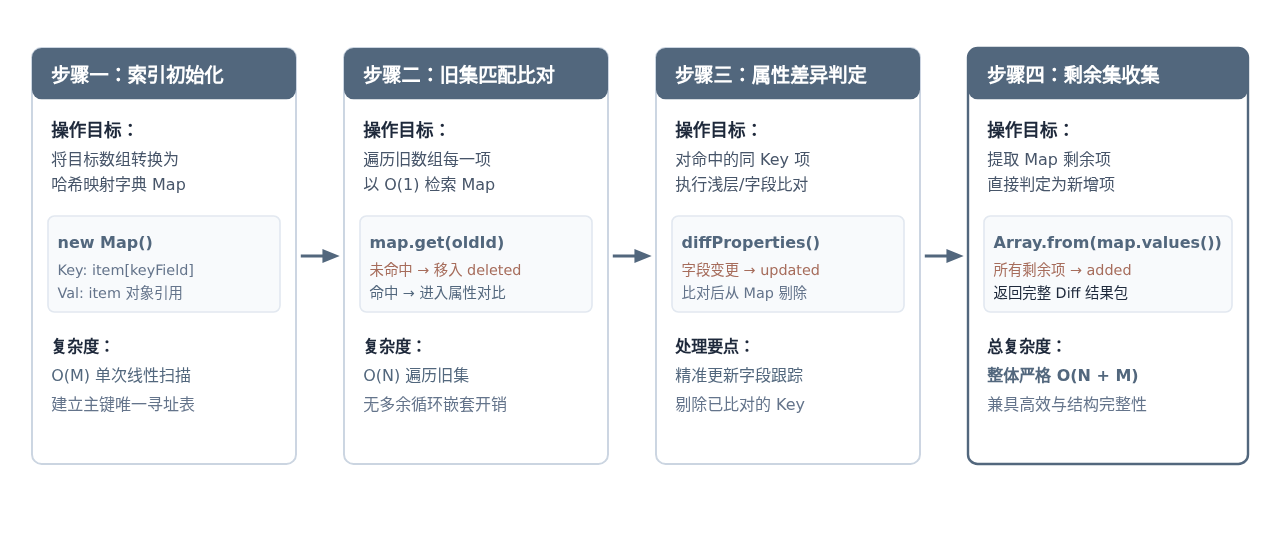
完整且高可用的 Diff 函数实现
/**
 * 高性能对象数组差异比对函数 (O(N + M))
 * @param {Array<Object>} oldList - 旧数据数组
 * @param {Array<Object>} newList - 新数据数组
 * @param {string} keyField - 唯一主键字段名,默认为 'id'
 * @returns {{ added: Array, updated: Array, deleted: Array }}
 */
function diffArrayById(oldList, newList, keyField = 'id') {
  const added = [];
  const updated = [];
  const deleted = [];

  // 步骤一:为新数组建立 Map 索引,键为唯一主键 (耗时 O(M))
  const newMap = new Map();
  for (let i = 0; i < newList.length; i++) {
    const item = newList[i];
    newMap.set(item[keyField], item);
  }

  // 步骤二与三:单次遍历旧数组,校验删除与修改 (耗时 O(N))
  for (let i = 0; i < oldList.length; i++) {
    const oldItem = oldList[i];
    const key = oldItem[keyField];
    const newItem = newMap.get(key);

    if (!newItem) {
      // 新数据中不存在该主键,判定为已删除
      deleted.push(oldItem);
    } else {
      // 命中了相同主键,比对具体属性是否发生变化
      if (hasObjectChanged(oldItem, newItem)) {
        updated.push({ oldItem, newItem });
      }
      // 从 Map 中移除已处理项,方便最后收集新增数据
      newMap.delete(key);
    }
  }

  // 步骤四:Map 中残留的元素,即为旧数据中不存在的新增项 (耗时 O(Remaining))
  for (const remainingItem of newMap.values()) {
    added.push(remainingItem);
  }

  return { added, updated, deleted };
}

/**
 * 字段级浅比对辅助函数 (避免深拷贝或全量序列化)
 */
function hasObjectChanged(objA, objB) {
  const keysA = Object.keys(objA);
  const keysB = Object.keys(objB);

  if (keysA.length !== keysB.length) return true;

  for (let i = 0; i < keysA.length; i++) {
    const key = keysA[i];
    if (objA[key] !== objB[key]) {
      return true;
    }
  }
  return false;
}
在这个实现中,不仅将整体查找完全限制在 O(N + M) 内,还通过在匹配后执行 newMap.delete(key),直接让剩余项的提取变成极其便宜的 Map.prototype.values() 迭代,完全消除了额外的二次过滤逻辑。
四、复合主键与多字段联合比对策略
在分布式系统、多租户或树形组织架构中,很多业务实体并没有单一的数字 ID,而是依赖多字段联合标识唯一性(例如:tenantId + category + recordCode)。
面对复合主键,常见的低效写法是使用 JSON.stringify 把联合字段序列化成字符串作为键:
// 常见性能陷阱:高频序列化导致严重 GC 停顿
const key = JSON.stringify({ tenant: item.tenant, id: item.id }); // 极其缓慢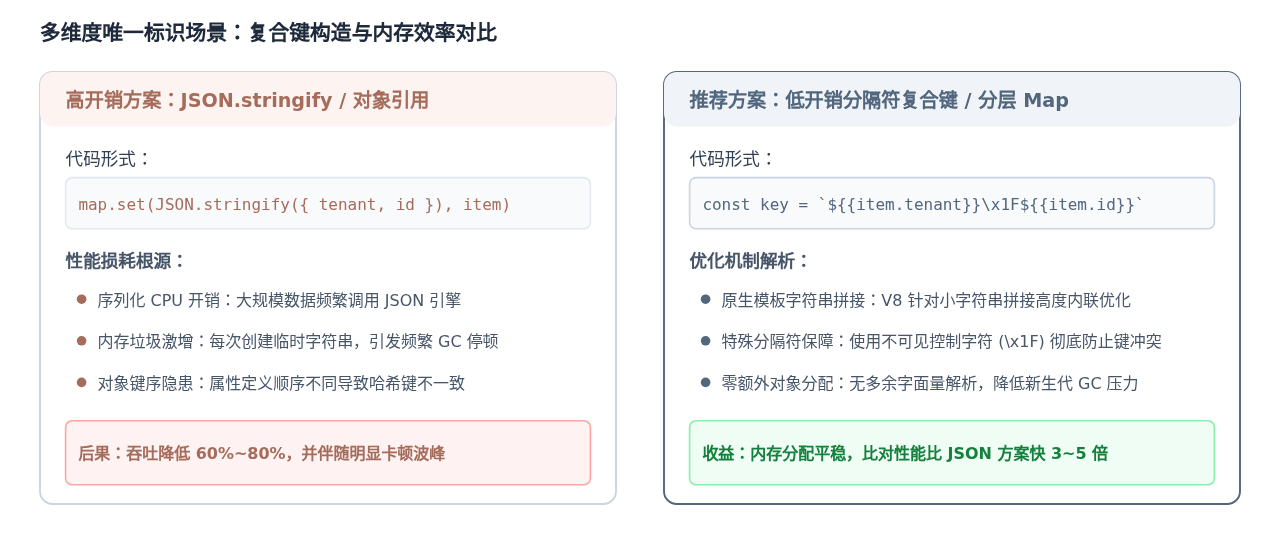
JSON.stringify 在底层需要做词法解析、属性枚举和格式化,单次耗时往往是字符串拼接的 10 倍以上;更严重的是,每一条数据都会产生临时对象与长字符串,在大数据量下会短时间内填满 V8 引擎的新生代内存(New Space),触发高频甚至全量的垃圾回收(Stop-the-World GC)。
推荐方案:单字符控制符紧凑拼接
// 使用不易在业务字段中出现的控制字符作为分隔符(如 ASCII 单元分隔符  或不可见字符)
const SEPARATOR = '\x1F';

function generateCompositeKey(item) {
  return `${item.tenantId}${SEPARATOR}${item.categoryId}${SEPARATOR}${item.code}`;
}

// 在 Map 中直接以紧凑字符串为 Key 进行索引
const compositeMap = new Map();
for (let i = 0; i < dataList.length; i++) {
  const item = dataList[i];
  compositeMap.set(generateCompositeKey(item), item);
}
现代 JavaScript 引擎对模板字符串字面量拼接进行了专门的汇编级内联优化,耗时极低且内存足迹小,能够保证复合主键下的比对性能依然稳稳维持在 O(n)。
五、超大规模数据下的内存与主线程调度
当数组规模继续增大至 20 万甚至 50 万条以上时,算法的时间复杂度虽然已是 O(n),但在前端浏览器单线程环境中,又会面临两个新维度的限制:内存膨胀(Memory Overhead)与帧率卡顿(Long Task)。
1. 避免中间临时数组的无谓分配
函数式编程中的链式调用(如 arr.map().filter().slice())非常优雅,但每一步链式操作都会在内存中实例化一个全新的数组。对于 50 万长度的数组,3 个中间数组就会凭空吃掉上百兆内存。
针对超大数组,应优先采用标准的 for 循环,在一次迭代中就地将数据分派到目标容器中:
// 避免:产生三个庞大的临时中间数组
const result = largeList
  .filter(predicate)
  .map(transform);

// 推荐:单一循环,原地分流
const result = [];
for (let i = 0; i < largeList.length; i++) {
  const item = largeList[i];
  if (predicate(item)) {
    result.push(transform(item));
  }
}
2. 时间切片(Time Slicing)分块调度
即使是 O(n) 的算法,在主线程同步处理 30 万条复杂对象比对也可能耗费 100~200 毫秒,这已经突破了浏览器一帧 16.6ms 的渲染阈值。为了保证用户交互界面的流畅响应,可以引入基于生成器或微任务的分块比对策略:
/**
 * 异步分块比对调度器 (防止单次执行时间过长阻塞 UI 渲染)
 */
async function asyncChunkedDiff(oldList, newList, chunkSize = 5000) {
  const newMap = new Map();

  // 分块构建 Map
  for (let i = 0; i < newList.length; i += chunkSize) {
    const chunk = newList.slice(i, i + chunkSize);
    for (let j = 0; j < chunk.length; j++) {
      const item = chunk[j];
      newMap.set(item.id, item);
    }
    // 让出主线程控制权,给浏览器执行渲染和处理事件的机会
    await yieldToMain();
  }

  const added = [];
  const updated = [];
  const deleted = [];

  // 分块比对旧数据
  for (let i = 0; i < oldList.length; i += chunkSize) {
    const chunk = oldList.slice(i, i + chunkSize);
    for (let j = 0; j < chunk.length; j++) {
      const oldItem = chunk[j];
      const newItem = newMap.get(oldItem.id);
      if (!newItem) {
        deleted.push(oldItem);
      } else {
        if (hasObjectChanged(oldItem, newItem)) {
          updated.push({ oldItem, newItem });
        }
        newMap.delete(oldItem.id);
      }
    }
    await yieldToMain();
  }

  for (const remaining of newMap.values()) {
    added.push(remaining);
  }

  return { added, updated, deleted };
}

function yieldToMain() {
  return new Promise(resolve => {
    if (typeof requestIdleCallback !== 'undefined') {
      requestIdleCallback(() => resolve());
    } else {
      setTimeout(resolve, 0);
    }
  });
}
六、选型决策与优化准则总结
性能优化从来不是盲目堆砌复杂的技巧,而是结合实际数据规模和结构特征,在代码可读性、内存开销与运行效率之间找到最佳平衡点。
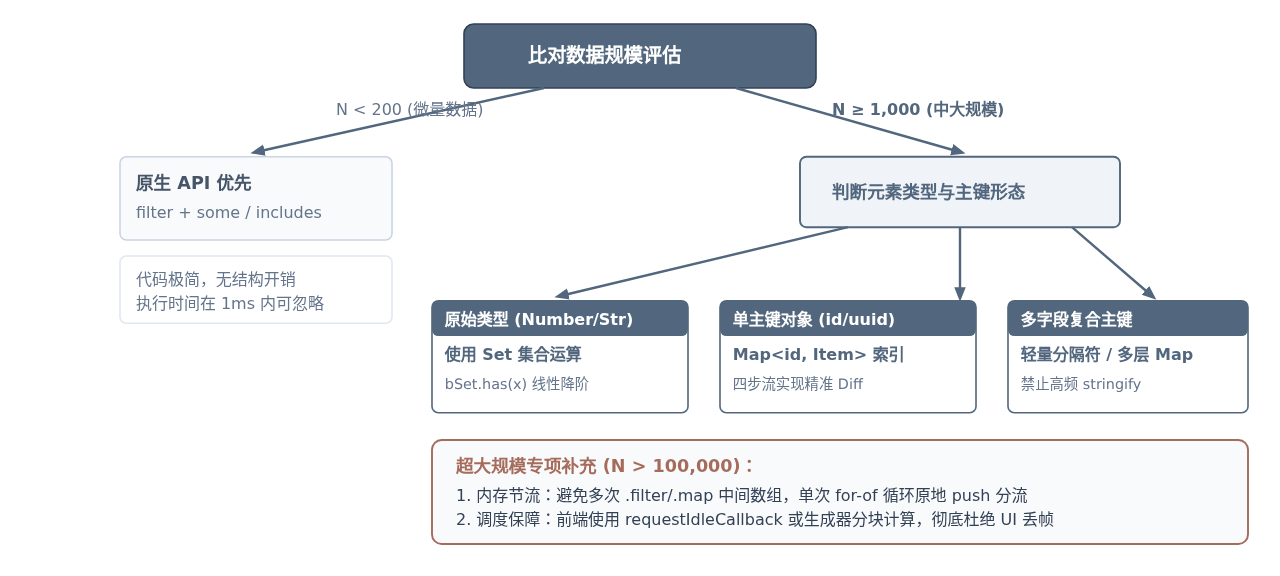
在日常开发与架构设计中,可以牢记以下核心实践准则:
- 审视数据基数:在
N < 200的微型数据集下,原生filter + includes耗时在微秒级别,代码直观且无须额外的哈希表开销,不必过度工程化。 - 识别隐含循环:警惕任何在循环体内部调用的
find、findIndex、indexOf、some或includes,它们是导致代码退化为O(n²)的元凶。 - 标量优先用 Set:纯字符串或数值比对,一条
const set = new Set(arr)即可彻底化解性能瓶颈。 - 对象索引优先用 Map:有唯一标识的对象数组比对,严格通过四阶段流(建表、比对、标记、收尾)完成,效率与逻辑完备性兼得。
- 复合键谨慎序列化:避免高频使用
JSON.stringify,采用控制字符拼接键,把 GC 停顿时间压至最低。 - 海量数据善用切片:面对数十万级别数据,结合原地迭代降低内存分配,利用异步时间切片确保 UI 丝滑顺畅。
JS大数组遍历性能优化:传统for循环 vs 现代API基准测试
2026-11-21 08:25:30
不用eval:JS计算器安全解析数学表达式的替代方案
2026-11-20 19:32:38
JS批量获取标签并遍历操作的技巧
2026-11-19 20:33:14
JS安全替换用户输入HTML标签防止XSS攻击
2026-11-19 20:14:35
JS原生实现数字滚动:requestAnimationFrame与线性插值算法
2026-11-19 19:32:52







