

JS安全替换用户输入HTML标签防止XSS攻击
深入讲解在JavaScript中安全替换与处理用户输入中的HTML标签,防止跨站脚本(XSS)攻击。分析常见正则替换漏洞,提供纯文本五字符实体转义、DOM安全属性应用及富文本白名单过滤的完整实现方案与代码示例。
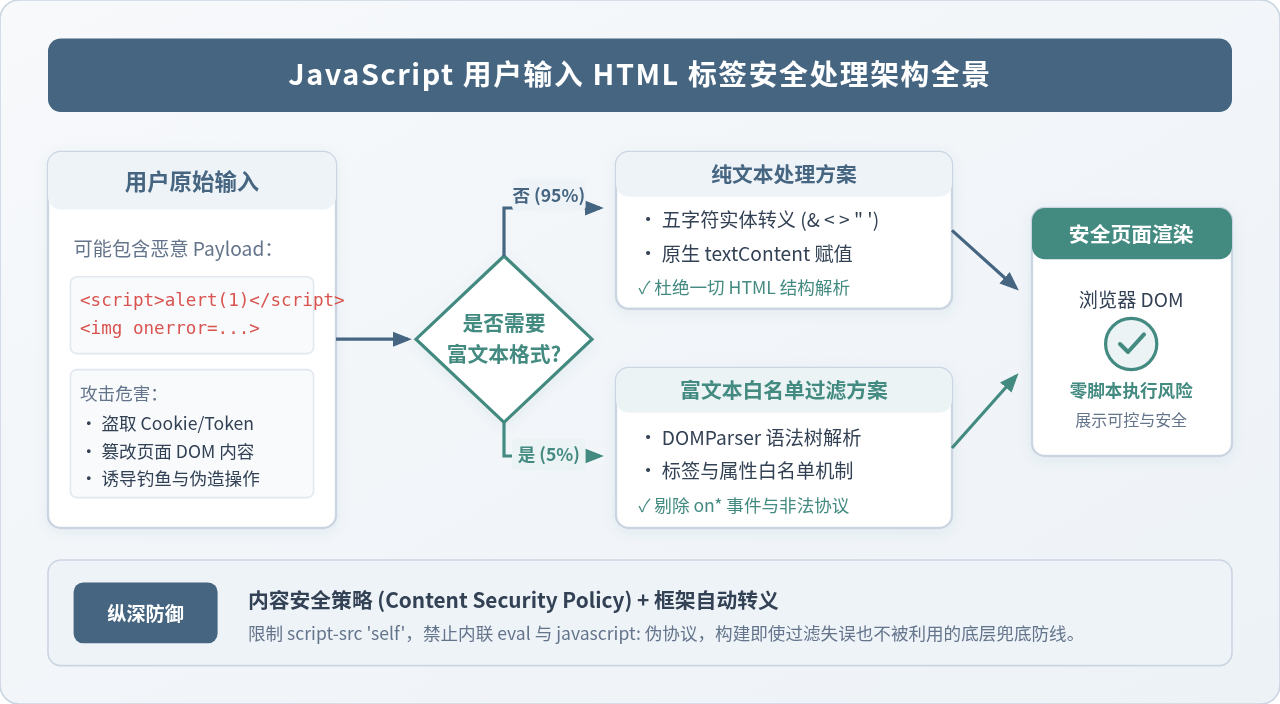
在 Web 前端开发中,处理用户输入中的 HTML 标签主要解决两类需求:一是将用户提交的文本原样安全展示,防止恶意脚本注入;二是允许用户输入受限的富文本格式,同时剔除危险标签和事件属性。安全处理的核心原则是:纯文本展示优先使用字符实体转义或原生 DOM 纯文本属性;富文本展示则必须基于白名单过滤,切忌依赖简单的正则表达式直接剔除标签。本文将针对这两类场景,提供经过安全验证的实现代码、详细操作步骤与注意事项。
一、常见误区:为什么单次正则替换无法阻挡 XSS 攻击
面对跨站脚本(XSS)攻击,许多开发者往往首先想到编写正则表达式来过滤或者替换敏感标签,例如尝试通过替换 <script> 标签来排除风险:
// 常见错误做法:仅替换 script 标签
const unsafeClean = (str) => str.replace(/<script.*?>.*?<\/script>/gi, '');
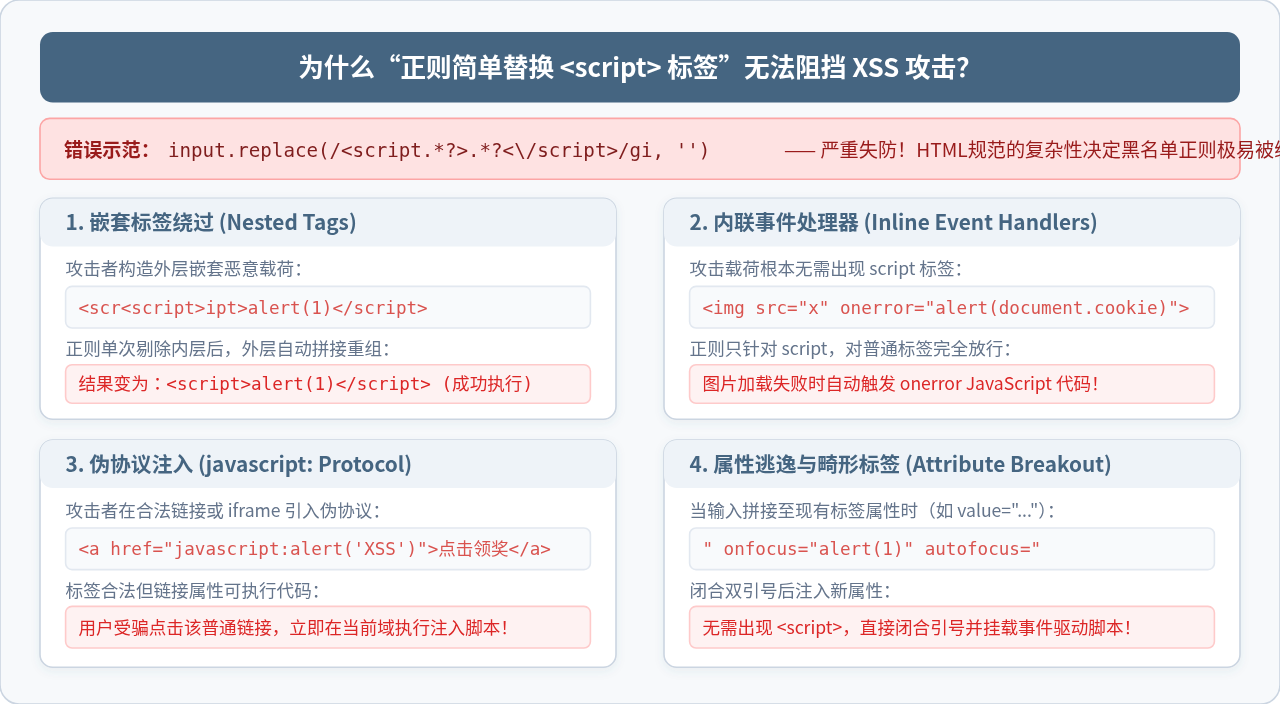
这种看似直观的做法在实际攻防中极易被绕过。HTML 规范的复杂性和浏览器的容错机制,使得黑名单式的正则替换存在严重漏洞:
- 嵌套标签绕过:攻击者可以构造形如
<scr<script>ipt>alert(1)</script>的载荷。单次正则替换移除了内部的<script>后,外层剩余字符重新拼合为有效的<script>alert(1),脚本依旧执行。 - 内联事件处理器绕过:现代 XSS 载荷绝不仅限于
<script>标签。攻击者利用<img src="x" onerror="alert(1)">、<svg onload="alert(1)">或<body onload="...">即可轻松触发脚本执行,正则黑名单根本无法穷举所有合法标签的所有事件。 - 伪协议注入绕过:在链接标签中,形如
<a href="javascript:alert(1)">点击查看</a>的代码并不包含<script>,但当用户点击该链接时,伪协议会立即在当前域名上下文执行攻击脚本。 - 属性引号闭合与逃逸:若输入被直接拼接到现有的 HTML 标签属性内部(如
<input value="USER_INPUT">),攻击者只需输入" onfocus="alert(1)" autofocus=",就能提前闭合属性并注入恶意事件监听器。
二、纯文本场景:五字符实体转义的标准实现
在网站绝大多数业务场景中(约占 95% 以上,如用户昵称、评论正文、表单留言、搜索词等),前端只需要将用户输入当作纯文本显示,不需要支持任何排版标签。
在此场景下,彻底解决 XSS 的最佳策略是将可能引发 HTML 语法结构变动的敏感字符转义为其对应的 HTML 实体编码。浏览器遇到实体编码时,会将其渲染为字面字符,而绝对不会当作 HTML 标签解析或执行。
1. 必须转义的五个核心字符
| 原始字符 | 转义后实体 | 安全防范目的 |
|---|---|---|
& (和号) |
& |
必须最优先转义,防止与后续实体编码冲突造成解析混乱 |
< (左尖括号) |
< |
阻止攻击者声明任何新的 HTML 标签开始 |
> (右尖括号) |
> |
阻止闭合当前标签或属性结构 |
" (双引号) |
" |
阻止在双引号属性值中跳出属性范围(属性逃逸) |
' (单引号) |
' |
阻止在单引号属性值中跳出属性范围 |
2. 标准转义函数与实现代码
编写转义函数时,建议采用单次正则表达式匹配并结合字典映射进行替换。这样既能保证执行性能,又能彻底避免多次替换过程中的“二次转义”问题:
/**
* 安全转义 HTML 敏感字符(纯文本场景标准实现)
* @param {unknown} input 待转义的原始输入
* @return {string} 转义后的安全字符串
*/
function escapeHtml(input) {
if (input === null || input === undefined) {
return '';
}
const str = String(input);
// HTML 五字符转义映射表
const escapeMap = {
'&': '&',
'<': '<',
'>': '>',
'"': '"',
"'": '''
};
// 利用单次正则匹配替换,杜绝二次转义
return str.replace(/[&<>"']/g, (char) => escapeMap[char]);
}str.replace('&', '&').replace('<', '<') 的方式处理,必须将 & 放在最先替换!若先替换 < 为 <,后续替换 & 时便会将 < 错误地重写为 &lt;,破坏页面原有内容。使用上述映射函数则不受此顺序困扰。
执行示例与输出对照:
// 示例 1:恶意脚本注入
const payload1 = '<script>alert("XSS")</script>';
console.log(escapeHtml(payload1));
// 输出:<script>alert("XSS")</script>
// 示例 2:事件型攻击与嵌套
const payload2 = '<img src="x" onerror='alert(1)'>';
console.log(escapeHtml(payload2));
// 输出:<img src="x" onerror='alert(1)'>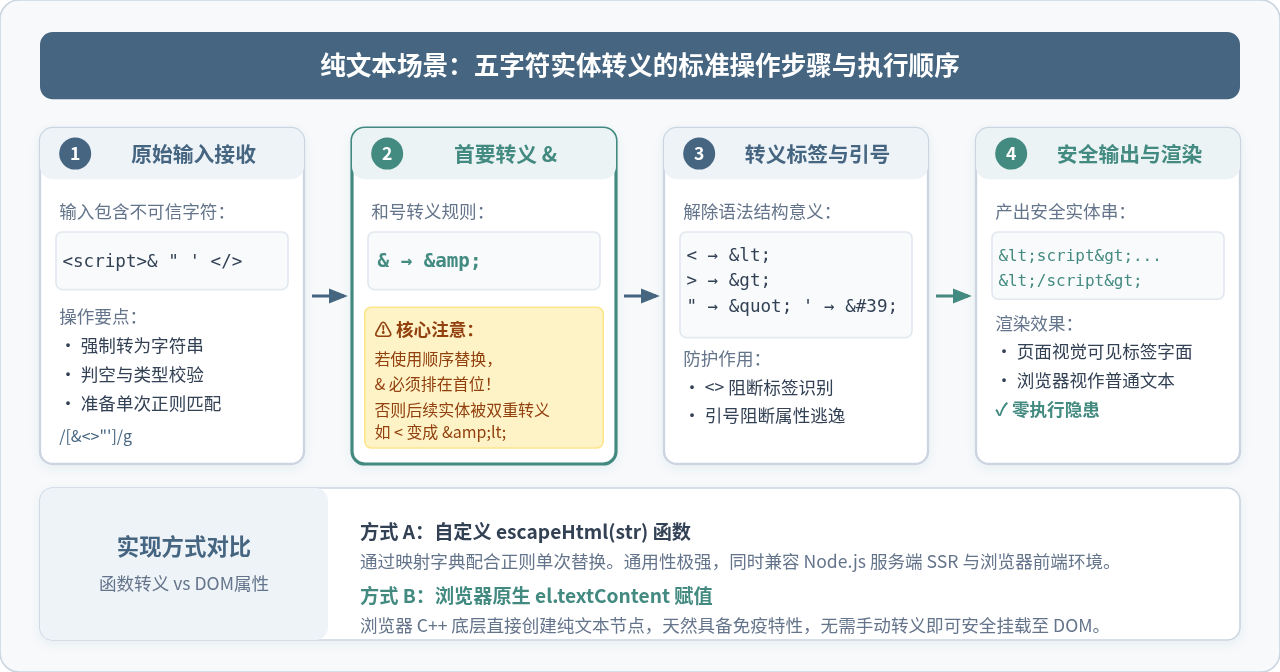
三、方案二:利用浏览器原生 DOM 机制进行安全赋值
在纯前端 JavaScript 开发中,如果目标是直接将用户文本插入到网页某个 DOM 元素中,甚至无需手动调用转义函数。浏览器的原生 DOM API 已经提供了内置的安全机制。
1. 坚决使用 textContent 替代 innerHTML
element.innerHTML 会要求浏览器渲染引擎将字符串当做 HTML 标记来语法解析;而 element.textContent 或 document.createTextNode() 则在浏览器底层的 C++ 层面将数据直接放入文本节点中,完全跳过 HTML 语法解析器:
const userComment = '<img src=x onerror=alert(1)> 这是一条正常评论';

// ❌ 危险做法:直接 innerHTML 赋值导致 XSS
// document.getElementById('comment-box').innerHTML = userComment;

//  安全做法:使用 textContent 原生赋值
const commentContainer = document.getElementById('comment-box');
commentContainer.textContent = userComment;
执行结果:页面将在界面上直接显示文字 <img src=x onerror=alert(1)> 这条评论正常,而不会发出任何图片网络请求,更不会执行任何 JavaScript 代码。
2. 浏览器内存 DOM 辅助转义技巧
在某些需要生成转义字符串的场景中,可以利用离线创建的 div 元素,通过 textContent 写入再通过 innerHTML 读出的方式,让浏览器内核完成原生转义:
function nativeBrowserEscape(str) {
  const div = document.createElement('div');
  div.textContent = str;
  return div.innerHTML;
}适用边界:该技巧仅适用于浏览器环境,在 Node.js 服务端渲染(SSR)或 Web Worker 环境中不可用。且频繁创建 DOM 节点存在微小性能开销,在大规模文本高频渲染时,优先使用正则映射转义函数。
四、富文本场景:基于 DOM 语法树的白名单清洗
当业务明确需要支持用户提交富文本(例如文章发布、论坛发帖、带排版的商品描述),用户必须使用 <p>、<b>、<img> 或 <a> 等排版标签,此时单纯的实体转义会破坏正常排版。
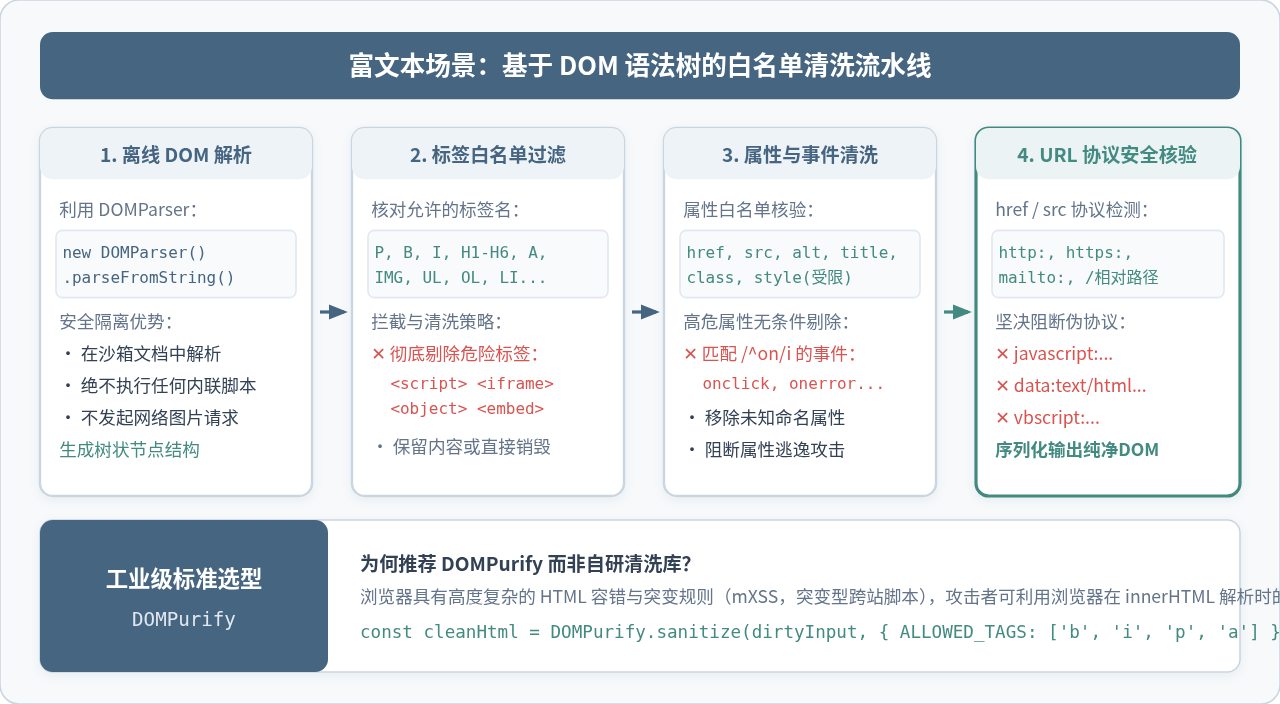
处理富文本的核心法则是白名单过滤(Whitelist Filtering):只放行显式定义允许的标签、属性和协议,其余全部剔除。
1. 富文本白名单清洗的四个关键步骤
- 离线 DOM 解析:使用浏览器内置的
DOMParser将不可信的 HTML 字符串解析为一个隔离的文档片段。在这个过程中,任何内联脚本都不会被触发执行。 - 标签白名单比对:遍历语法树中的所有元素节点。如果当前标签名不在白名单(如
<P>、<STRONG>、<A>、<IMG>)中,则剔除该标签(可根据策略保留其内部子文本)。高危标签如<script>、<iframe>、<object>必须连同内容彻底销毁。 - 属性扫描与事件剔除:遍历放行标签的所有属性。匹配正则
/^on/i的所有事件监听属性(如onclick、onerror、onmouseover)必须无条件删除;仅保留白名单中的属性(如href、title、src、alt)。 - URL 伪协议校验:对
href和src等链接类属性进行严格检查。强制要求协议必须属于http:、https:、mailto:或相对路径,坚决过滤javascript:、data:text/html、vbscript:等可执行伪协议。
2. 生产级标准实现:DOMPurify
虽然基于 DOMParser 可以编写自定义清洗逻辑,但现代浏览器针对畸形 HTML 存在复杂的“突变型跨站脚本(mXSS)”特性。当 DOM 被重新序列化为字符串又被浏览器解析时,可能会发生结构突变,绕过简易过滤。
因此在生产级项目中,强烈建议使用经过安全社区广泛严格审计的行业标准库 DOMPurify:
// 安装命令:npm install dompurify
// 浏览器引入:<script src="dompurify.min.js"></script>
import DOMPurify from 'dompurify';

// 待净化的不可信富文本输入
const dirtyHtml = `
  <p>欢迎阅读本文!<b>这里是加粗文本</b></p>
  <script>alert('恶意脚本')</script>
  <img src="valid.jpg" onerror="alert('窃取Token')" alt="封面图">
  <a href="javascript:alert(1)">恶意诱导链接</a>
  <a href="https://example.com">官方网站</a>
`;

// 执行白名单安全清洗
const cleanHtml = DOMPurify.sanitize(dirtyHtml, {
  // 明确允许保留的标签
  ALLOWED_TAGS: ['p', 'b', 'strong', 'i', 'em', 'a', 'img', 'ul', 'li'],
  // 明确允许保留的属性
  ALLOWED_ATTR: ['href', 'src', 'alt', 'title', 'target'],
  // 自动剔除 javascript: 等不安全伪协议(默认开启)
  ALLOW_DATA_ATTR: false
});

// 安全挂载至页面
document.getElementById('rich-article-body').innerHTML = cleanHtml;
净化后的安全输出结果:
<p>欢迎阅读本文!<b>这里是加粗文本</b></p>
<img src="valid.jpg" alt="封面图">
<a>恶意诱导链接</a>
<a href="https://example.com">官方网站</a>
可以看到:<script> 标签被直接销毁;<img> 标签上的 onerror 事件被剥除;不合法的 javascript: 伪协议链接属性被移除,仅保留文本内容,彻底消除攻击载荷。
五、上下文编码与纵深防御策略
防范 XSS 攻击时,必须牢记编码方式必须与注入上下文严格匹配。HTML 实体转义只对“HTML 正文上下文”有效。如果用户数据被放置在其他位置,单独替换 HTML 标签仍可能导致安全漏洞:
- HTML 属性上下文:如
<input value="USER_INPUT">。此时转义必须包含双引号"和单引号',否则输入一个引号即可实现属性逃逸。 - JavaScript 变量上下文:如
<script>let id = 'USER_INPUT';</script>。此时 HTML 实体转义毫无用处,必须使用针对 JavaScript 的 JSON 序列化(JSON.stringify)或特定字符转义。 - URL 上下文:如
<a href="USER_INPUT">。必须使用encodeURIComponent转义参数,并且必须严格校验协议头部是否为http:或https:。
配置内容安全策略 (CSP) 作为终极防线
在服务器响应头中配置 Content Security Policy (CSP),即使前端过滤代码由于特殊边界情况存在疏漏,浏览器也会在底层直接拒绝执行非受信脚本:
# 在 HTTP 响应头中配置严格的 CSP 策略
Content-Security-Policy: default-src 'self'; script-src 'self'; object-src 'none'; base-uri 'self';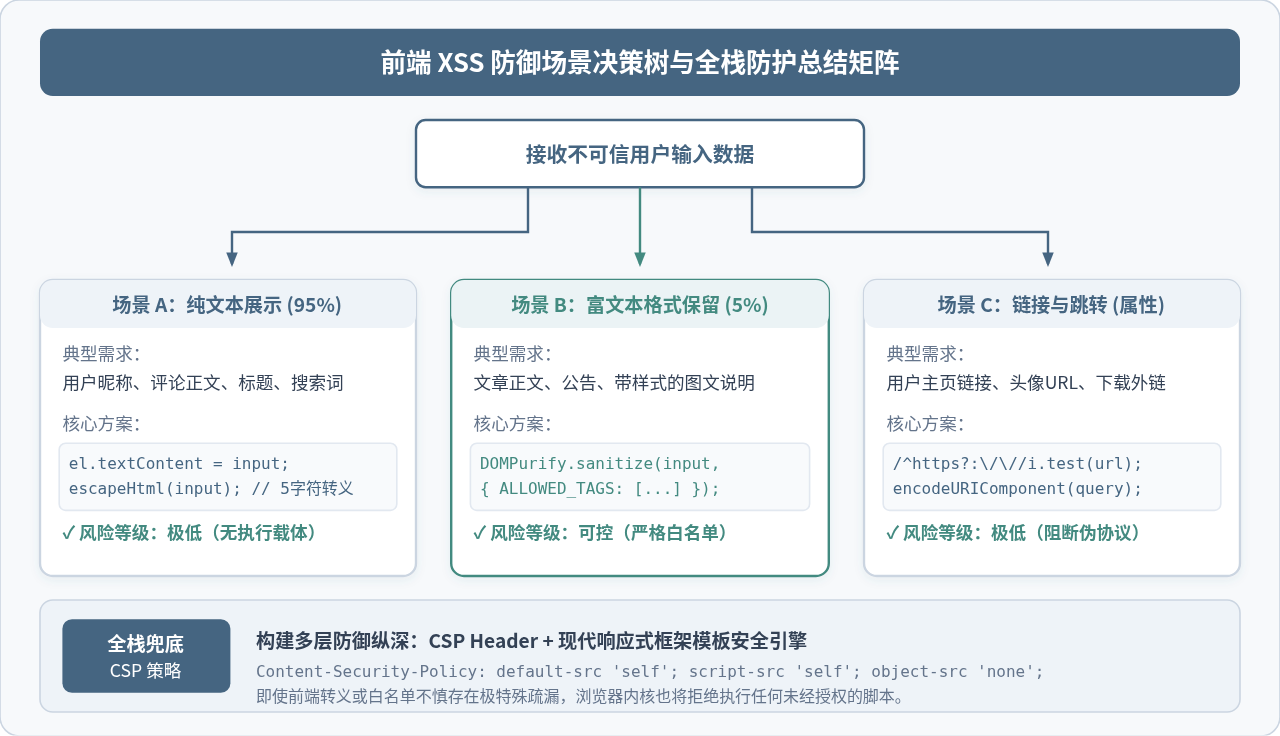
六、总结与落地建议
总结本文关于“JS 安全替换用户输入 HTML 标签防止 XSS 攻击”的核心结论:
- 坚决弃用简单黑名单正则:切勿使用
replace(/<script.*?>/gi, '')这类黑名单正则,它无法抵御嵌套标签、事件属性、伪协议及属性闭合等绕过手法。 - 纯文本场景(首选):如果不需要呈现格式,直接使用原生
element.textContent = input;若需生成安全 HTML 文本,使用单次映射的五字符实体转义函数escapeHtml()。 - 富文本场景(白名单):如果必须支持排版格式,采用基于 DOM 解析的白名单过滤机制,在生产中优先选择成熟审计库
DOMPurify。 - URL 场景严格校验协议:凡涉及链接跳转和资源加载,必须校验协议前缀,阻断
javascript:伪协议。 - 全栈结合 CSP:为网站部署内容安全策略响应头,形成即使应用层出现单点失效也能保障资产安全的纵深防御体系。
JS批量获取标签并遍历操作的技巧
2026-11-19 20:33:14
JS原生实现数字滚动:requestAnimationFrame与线性插值算法
2026-11-19 19:32:52
怎么用dayjs在JS中格式化日期字符串?对比moment.js优势
2026-11-18 21:51:13
JS解析HTML时怎么过滤script标签防止XSS攻击
2026-11-18 17:57:28
JS递归遍历中的尾调用优化与记忆化技术
2026-11-18 16:01:48







