

JS怎么实现忽略大小写的字符串相等比较
详细解析JavaScript中实现忽略大小写字符串相等比较的两种标准方案:统一大小写严格比对法与Intl国际化localeCompare法,分析原理、边界防范与常见误区。
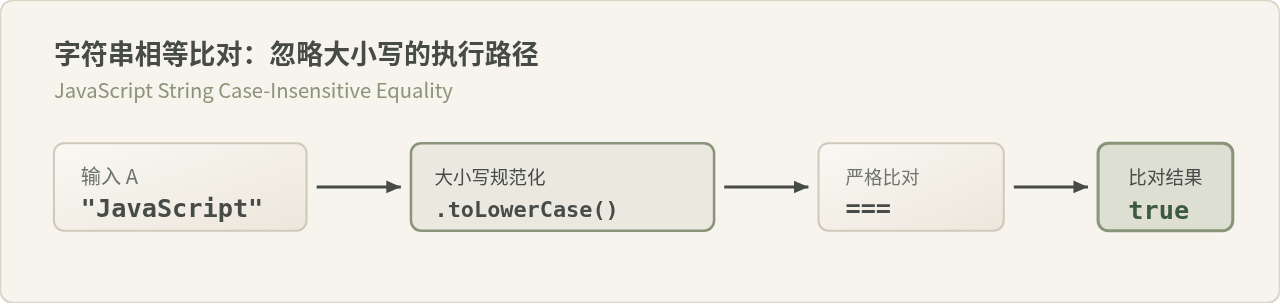
在 JavaScript 中,判断两个字符串在忽略大小写的前提下是否相等,最常用且运行效率最高的方法是将双方统一转换为全小写或全大写后使用严格相等符进行比对(例如 a.toLowerCase() === b.toLowerCase())。而在需要应对多语言环境、包含重音符及变音符号(如法文、德文、西班牙文)的国际化业务场景中,推荐使用原生国际化比较 API a.localeCompare(b, undefined, { sensitivity: 'accent' }) === 0。本文将具体阐述这两种实现方式的完整代码、内部工作机制以及必须防范的边界陷阱。
一、操作步骤与决策流程
在进行具体编码前,了解比对逻辑的流转路径有助于写出安全健壮的代码。实现忽略大小写比对并非单纯调用一次转换方法,完整的流程应当包含空值防御、分支选择与结果输出三个主要环节。
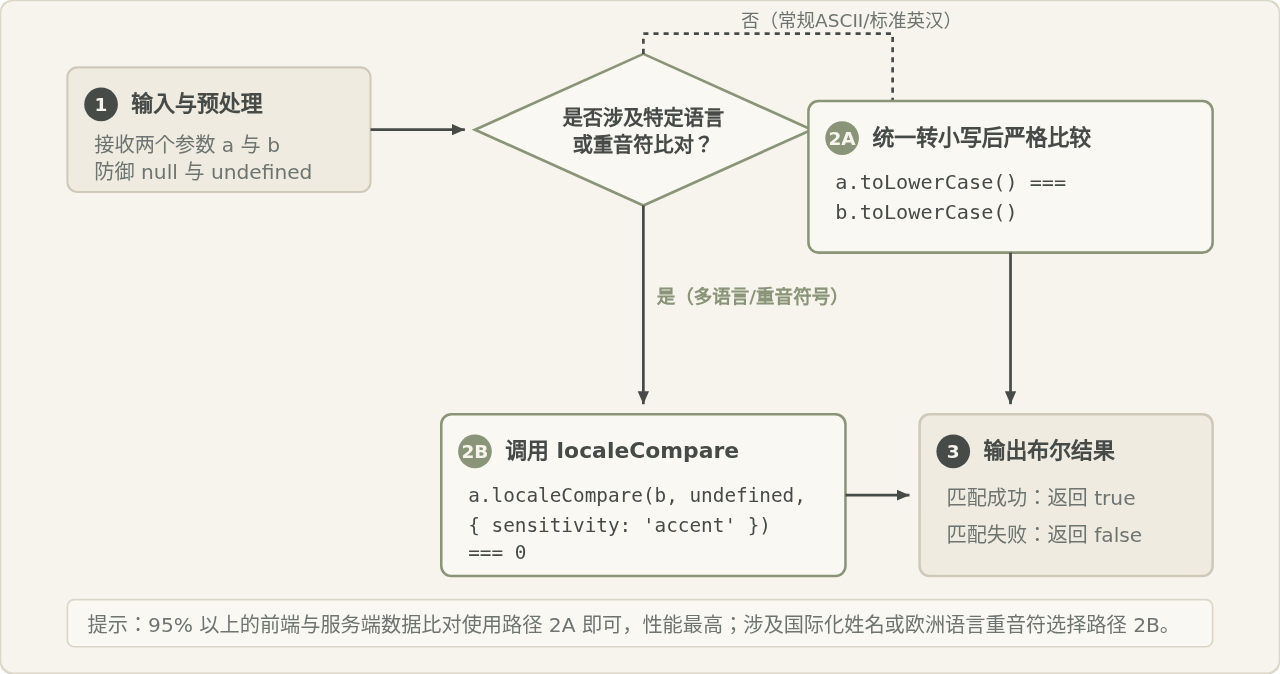
从上述流程图中可以看出,标准业务开发通常按照以下步骤执行:
- 参数有效性校验:直接对
null或undefined调用字符串方法会抛出TypeError异常,因此必须先完成防御性检查。 - 同引用快速短路:若两个变量在未经转换时已经严格全等(
str1 === str2),可直接得出true,避免后续无谓的转换与内存分配。 - 执行规范化比对:根据业务是否依赖语言环境或重音符,决定走向简单大小写转换还是国际化对比。
二、方法一:统一大小写后进行严格比对(性能首选)
这是在前端开发、服务端 Node.js 接口及日常数据校验中使用最广泛的方案。String.prototype.toLowerCase() 与 String.prototype.toUpperCase() 可以将字符串中所有具备对应大小写的字符映射为目标形式。
1. 完整实现代码
function equalsIgnoreCase(str1, str2) {
  // 1. 同引用或相同值短路判断
  if (str1 === str2) {
    return true;
  }

  // 2. 校验参数是否均为字符串类型
  if (typeof str1 !== 'string' || typeof str2 !== 'string') {
    return false;
  }

  // 3. 统一转换为小写后进行严格比较
  return str1.toLowerCase() === str2.toLowerCase();
}
使用示例如下:
console.log(equalsIgnoreCase("Hello", "hello"));       // 示例输出: true
console.log(equalsIgnoreCase("admin@site.com", "Admin@SITE.COM")); // 示例输出: true
console.log(equalsIgnoreCase("test", "other"));       // 示例输出: false
console.log(equalsIgnoreCase(null, "null"));          // 示例输出: false
console.log(equalsIgnoreCase(undefined, undefined));  // 示例输出: true (短路命中)
2. 为什么推荐严格相等(===)而不是宽松相等(==)
当两端经过 .toLowerCase() 转换后,返回的已经是同类型的基本类型字符串。使用 === 可以避免 JavaScript 引擎触发任何隐式类型转换机制,既能保证语义明确,也符合现代 JavaScript 最佳实践。
3. toLowerCase 与 toUpperCase 的选型差异
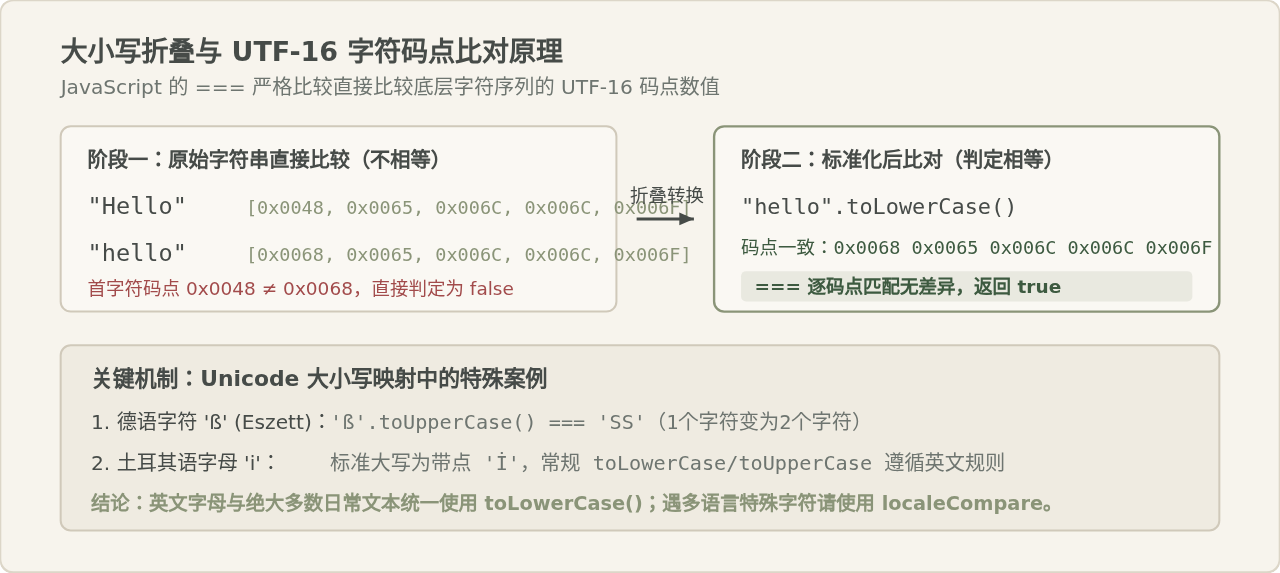
在绝大多数英文字符和中文文本中,调用 toLowerCase() 与 toUpperCase() 没有实质差异。但在 Unicode 规范中,极少数语言字符的大写化与小写化存在不对称现象:
- 例如德语小写字母
ß(Eszett),调用'ß'.toUpperCase()会得到双字符'SS',而'SS'.toLowerCase()得到的是'ss',此时'ß'.toLowerCase() === 'SS'.toLowerCase()将返回false。 - 又如土耳其语中存在带点与不带点的两种
I/i,使用系统默认的转换规则可能与当地读写习惯不符。
对于只处理普通英文字符、邮箱、路由路径、代码标识符的场景,统一使用 toLowerCase() 已完全足够;如需消除特定语言差异,应使用接下来介绍的国际化方案。
三、方法二:使用 localeCompare 进行国际化敏感比对
ECMAScript 国际化 API 提供了 String.prototype.localeCompare() 方法,专门用于处理考虑语言习惯与音标差异的字符串比较。通过设置其第三个参数 options 中的 sensitivity,可以精确控制大小写与重音符号的比较粒度。
1. 完整实现代码
function equalsIgnoreCaseLocale(str1, str2, locale = undefined) {
  if (str1 === str2) {
    return true;
  }

  if (typeof str1 !== 'string' || typeof str2 !== 'string') {
    return false;
  }

  // sensitivity 设为 'accent' 表示忽略大小写但区分重音符
  // 若需同时忽略大小写和重音符,可设为 'base'
  return str1.localeCompare(str2, locale, { sensitivity: 'accent' }) === 0;
}
调用示例:
// 英文与常规字符串
console.log(equalsIgnoreCaseLocale("GitHub", "github")); // 示例输出: true

// 带有重音符号的西欧语言字符
console.log(equalsIgnoreCaseLocale("café", "Café"));     // 示例输出: true (大小写忽略,重音一致)
console.log(equalsIgnoreCaseLocale("cafe", "café"));     // 示例输出: false (accent 模式保留重音区分)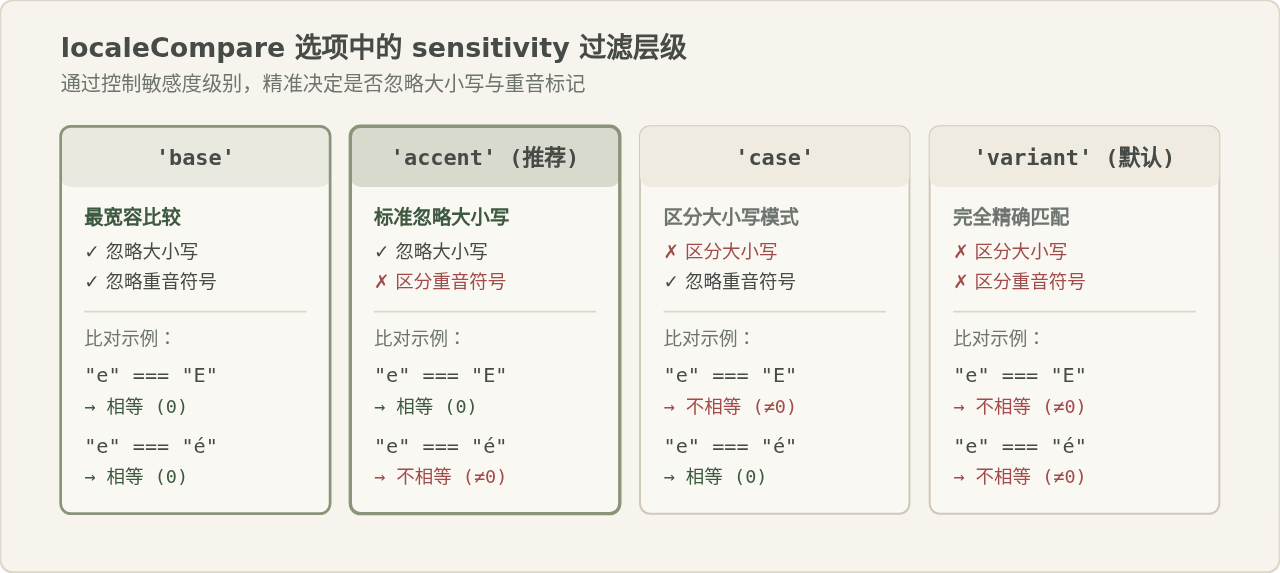
2. sensitivity 各选项含义解析
| 参数值 | 是否区分大小写 | 是否区分重音符号 | 示例比对("e" 与 "E" / "é") |
|---|---|---|---|
'accent'(推荐) |
忽略大小写 | 区分重音 | "e" 与 "E" 相等;"e" 与 "é" 不相等 |
'base' |
忽略大小写 | 忽略重音 | "e" 与 "E" 相等;"e" 与 "é" 亦相等 |
'case' |
区分大小写 | 忽略重音 | "e" 与 "E" 不相等;"e" 与 "é" 相等 |
'variant'(默认值) |
区分大小写 | 区分重音 | 仅完全相同的字形与码点才判定为相等 |
注意:localeCompare 返回值为数字(-1、0、1),其中仅当返回值为 0 时代表两个字符串在此规则下等价,切勿将其误当作布尔值直接放在 if 条件中判断。
四、容易混淆的说法与常见误区辨析
1. 误区一:“使用宽松相等 == 就能自动忽略大小写”
辨析:这是一种常见的认知偏差。JavaScript 的 == 操作符所执行的“宽松转换”仅针对变量类型(例如将数字字符串转换为数值与数字比较),而在双方均为字符串类型时,== 与 === 毫无二致,严格按照每个字符的 Unicode 码点进行对比。'abc' == 'ABC' 的结果始终为 false,它根本不具备大小写折叠功能。
2. 误区二:“使用正则表达式加 i 标识比转小写更简洁”
有些开发者习惯通过构造动态正则来进行比较:
// 存在隐患的写法
function unsafeRegexEquals(str1, str2) {
  return new RegExp(`^${str2}$`, 'i').test(str1);
}辨析:该说法看似合理,因为正则表达式的 i 标识确实代表忽略大小写。但在字符串相等比对的场景下,这种写法存在两大硬伤:
- 正则特殊字符转义缺陷:如果
str2中包含正则元字符(如.、*、?、+、$、(、[等),正则表达式会将其视为匹配语法而非纯文本。例如当str2为"c++"时,未经转义直接构造会直接报错或产生错误的匹配结果。 - 性能损耗显著:动态创建
RegExp实例涉及正则语法解析与引擎编译,开销往往比单纯调用toLowerCase()高出数倍至数十倍。因此,除非本身就是正则匹配需求,否则单纯对比相等切忌使用动态正则。
3. 误区三:“忽略了 null 或 undefined 造成的空指针崩溃”
在处理表单提交、URL Query 参数或外部 API 返回的数据时,字段经常可能为 null、undefined 或数值类型。直接链式调用 val.toLowerCase() 将直接引发运行时异常 TypeError: Cannot read properties of null/undefined。在生产级代码中,务必像前文封装示例一样,优先完成类型校验或使用可选链操作符(str1?.toLowerCase() === str2?.toLowerCase())。
五、综合方案对比与选型建议
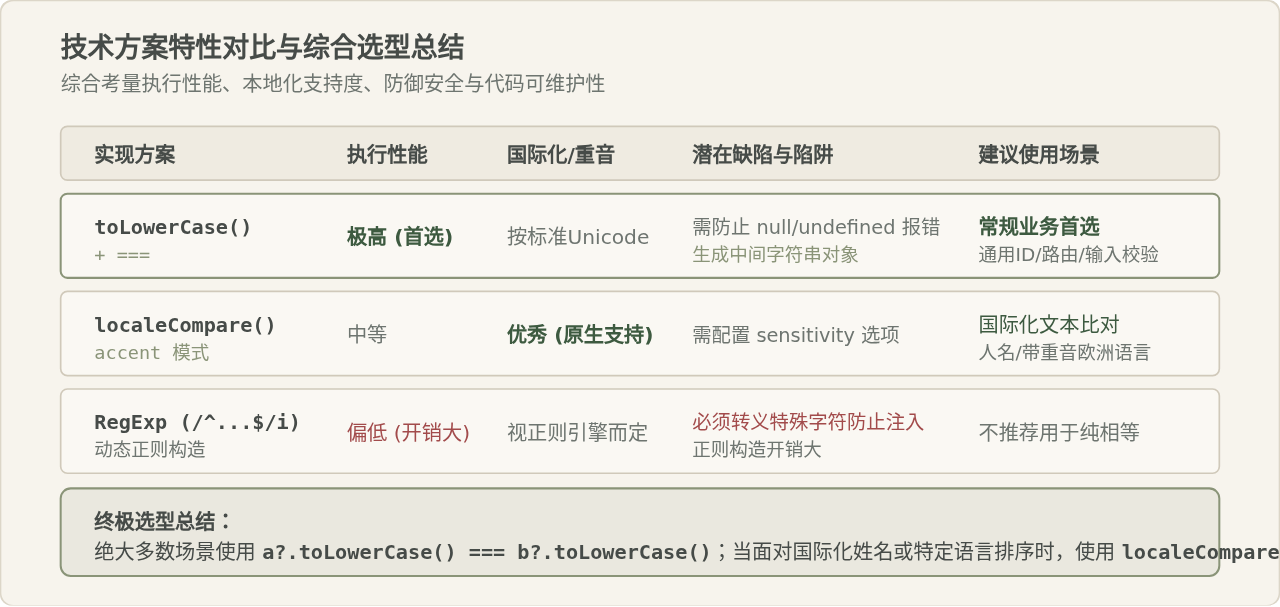
根据不同的工程场景,建议遵循以下选型原则:
- 通用业务场景(首选):处理普通英文标签、邮箱地址、验证码、路由路径时,统一使用
str1.toLowerCase() === str2.toLowerCase(),配合适当的非空校验。该方案兼容性达 100%,内存分配可控,且在 V8 及各大 JS 引擎中执行速度最快。 - 国际化多语言场景:当系统服务于跨国用户,需要比对欧洲语言姓名、法语带重音地址或德语专有名词时,使用
str1.localeCompare(str2, undefined, { sensitivity: 'accent' }) === 0。 - 大量重复数据排序或查找:若需对海量字符串进行频繁的比对或排序,可预先通过
Intl.Collator构造比较器实例复用,避免每次重复初始化配置开销。
JS中Object.create()怎么基于原型创建对象
2026-11-20 21:03:28
JavaScript箭头函数与普通函数的this区别
2026-11-20 20:57:16
怎么封装兼容webkit/moz前缀的JS全屏函数
2026-11-20 20:35:38
JavaScript导出PDF中文乱码怎么解决?jsPDF引入自定义字体教程
2026-11-20 20:14:15
JS浅拷贝与深拷贝的区别:引用传递与值复制详解
2026-11-20 18:33:44







