

前端JS加密与后端解密不匹配怎么解决
针对前端JavaScript加密与Java、Node.js、Python等后端解密不匹配的常见报错,系统梳理密文损坏、密钥派生、IV偏移量、填充方式及字符编码五大根源,并提供标准排查步骤与对齐代码示例。
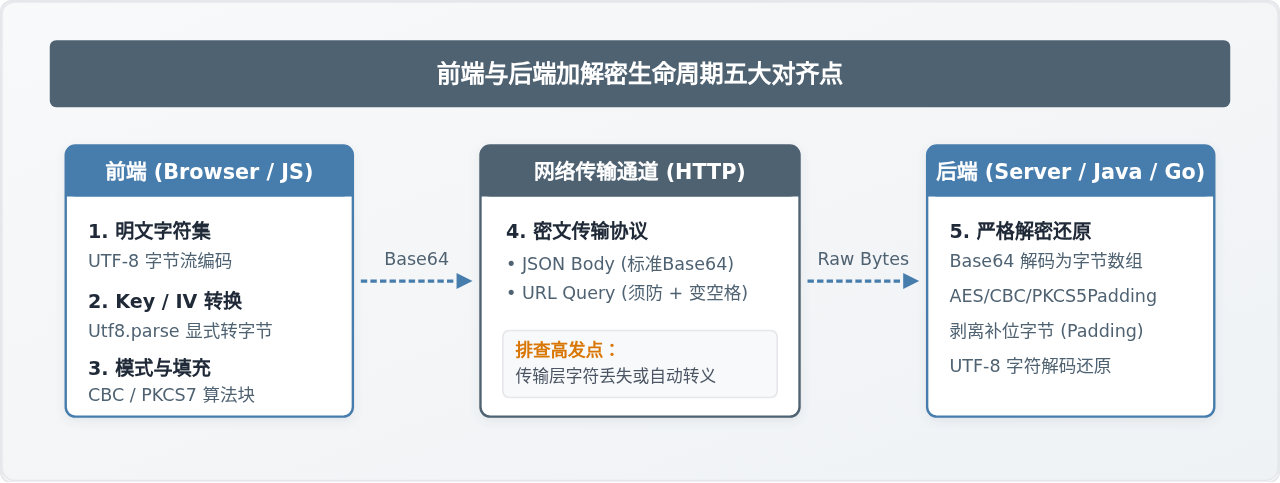
解密不匹配的典型报错与现象
当两端加解密配置存在微小偏差时,后端解密通常直接抛出异常,或得到看似完成但无法阅读的字符乱码。常见现象可归为三类:
- 填充错误(BadPaddingException / Padding is incorrect):后端(如 Java)抛出
javax.crypto.BadPaddingException: Given final block not properly padded,或 Node.js 提示bad decrypt。这表明密钥错误、IV错误、密文被截断,或是后端按 PKCS5Padding 剥离填充块时,末尾块的字节校验失败。 - 块长度非法(IllegalBlockSizeException):提示密文长度不是 16 字节(AES 块大小)的整数倍。常见于 Base64 字符串少字符、URL 传参导致特殊符号丢失,或前端未做填充导致密文块残缺。
- 解密无报错但内容乱码:解密过程正常返回字符串,但前 16 个字符是不可读乱码,后续内容完全正常;或者整串内容皆为乱码。前者通常是 初始向量(IV)不一致(CBC 模式特性,IV 仅直接影响第一个块的异或结果),后者通常是 字符编码不对(如 UTF-8 与 ISO-8859-1 混淆)或密钥完全不匹配。
导致不匹配的五大核心根源
加密算法在数学上是严密的,两端即使使用相同的算法名(如“AES”),若底层实现约定的上下文不同,计算结果必然不一致。
1. 字符串转密钥的字节方式不一致(KDF 陷阱)
这是使用 CryptoJS 时最容易出现的隐蔽陷阱。在 CryptoJS 中,CryptoJS.AES.encrypt(data, key) 如果第二个参数直接传入一个字符串(如 "1234567812345678"),CryptoJS 默认不会将其视为原始的 16 字节密钥,而是将其当作“口令(Passphrase)”,自动运行一次内部的 OpenSSL 风格密钥派生算法(EVP_BytesToKey),生成随机 Salt 并派生出真正的 Key 和 IV。而后端代码如果直接把字符串作为 16 字节的原始 Key(如 Java 的 new SecretKeySpec(key.getBytes(), "AES")),两端密钥物理上完全不同,解密必然失败。
2. 填充标准命名差异与混淆(PKCS5 vs PKCS7)
AES 的数据块固定为 128 位(16 字节)。在密码学定义中,PKCS#5 规范针对 8 字节块,而 PKCS#7 针对 1 到 255 字节块。Java 的加密服务提供者由于历史命名规范,标准字面量写作 AES/CBC/PKCS5Padding,但在 AES 的 16 字节分组下,其实际填充逻辑与标准 PKCS#7 完全相同。若前端使用了 ZeroPadding(末尾补零)而后端使用 PKCS5Padding,在明文长度刚好或解密去除填充时便会产生末尾空字节或填充校验异常。
3. 初始向量(IV)的处理差异
在 CBC 模式下,IV 必须是与块大小相同的 16 字节。常见问题包括:前端没有传递 IV(使用全 0 默认填充),后端设置了自定义 IV;或者 IV 也被误当成字符串未转换为字节数组解析。此外,IV 若在前端加密时随机生成,必须与密文一同传递给后端(例如拼在密文头部或独立字段传递)。
4. 密文传输中的网络转义(+ 变空格)
AES 密文通常输出为 Base64 字符串,其中包含字符 +、/ 和 =。如果密文通过 HTTP GET 请求的 URL 参数传递,或者通过 application/x-www-form-urlencoded 表单提交,未经 encodeURIComponent 处理的 + 符号在服务端会被 Web 框架(如 Spring MVC、Express)自动解析为空格。空格不是合法的 Base64 字符,后端做 Base64 解码时会直接导致字节丢失或密文损坏。
5. 字符集编码不一致
中文字符在 UTF-8 编码下占用 3 个字节,在 GBK 编码下占用 2 个字节。如果前端加密前将明文转换为 UTF-8 字节,而后端解密得到字节后使用系统默认编码(如 Windows 下的 GBK)还原为字符串,就会产生乱码。
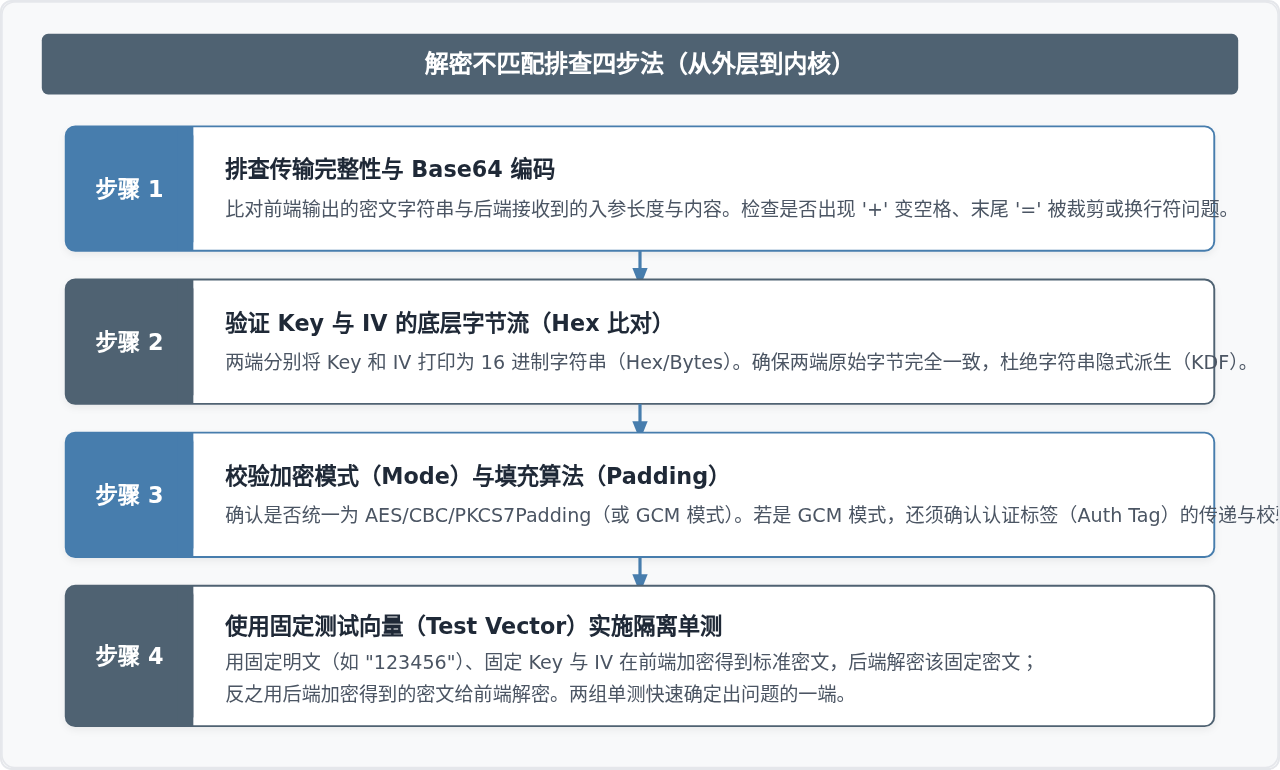
排查与解决具体步骤
步骤一:排查传输完整性与字符转义
排查的第一步永远是核对两端的数据收发是否一致。在前端加密完成后,使用 console.log("Ciphertext:", ciphertext) 打印原始 Base64 密文;在后端接收接口入口处打印入参。
+ 会被很多后端框架自动解码为空格 。必须使用 encodeURIComponent(ciphertext) 转义,或改用 POST 配合 JSON 格式传递请求体。
步骤二:显式解析 Key 与 IV,杜绝隐式派生
在前端使用 crypto-js 时,切勿将普通字符串直接传给 CryptoJS.AES.encrypt。必须显式使用 CryptoJS.enc.Utf8.parse() 或 CryptoJS.enc.Hex.parse() 将字符串解析为 WordArray 字节对象。
同理,后端也必须以相同的字符集提取字节。例如 16 位的密钥 "1234567890123456",在 Java 中使用 keyStr.getBytes(StandardCharsets.UTF_8)。两端打印各自的 Hex 编码进行比对:
// 前端验证 Hex
console.log("Key Hex:", CryptoJS.enc.Hex.stringify(keyWordArray));
// 若为 16 字节密钥,其 Hex 字符串长度必须正好为 32 位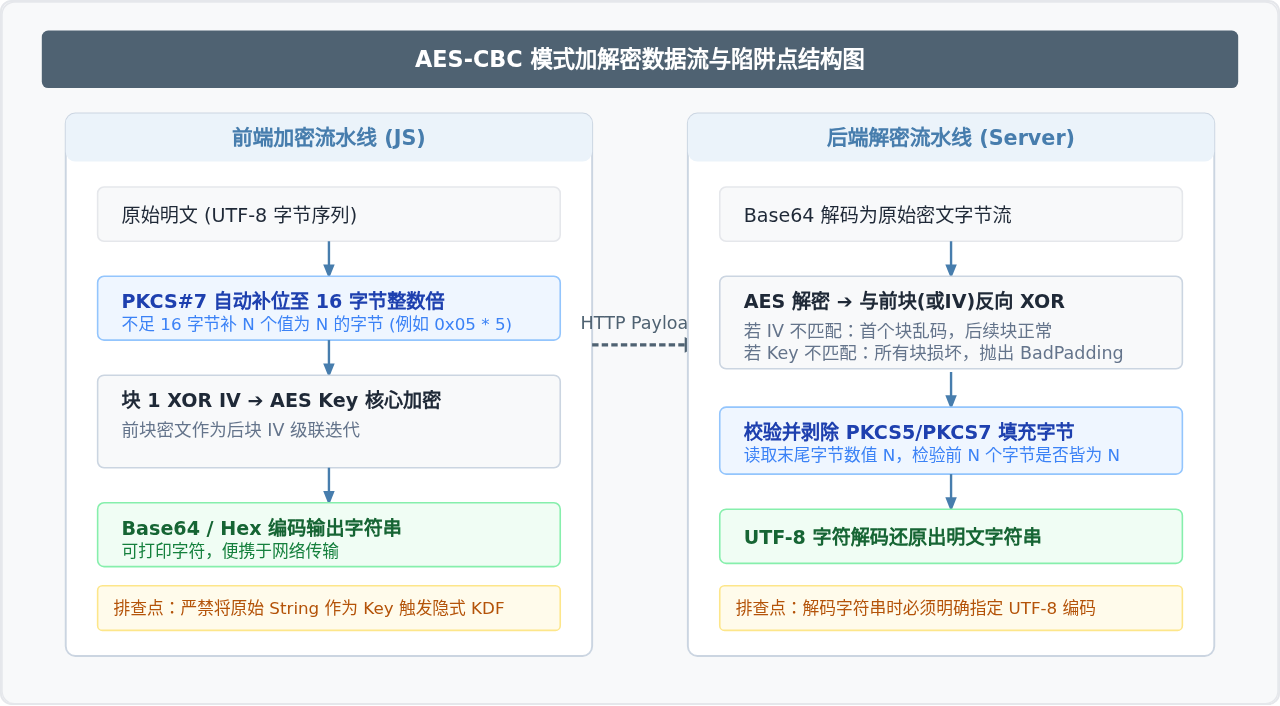
步骤三:前后端标准对齐实现示例
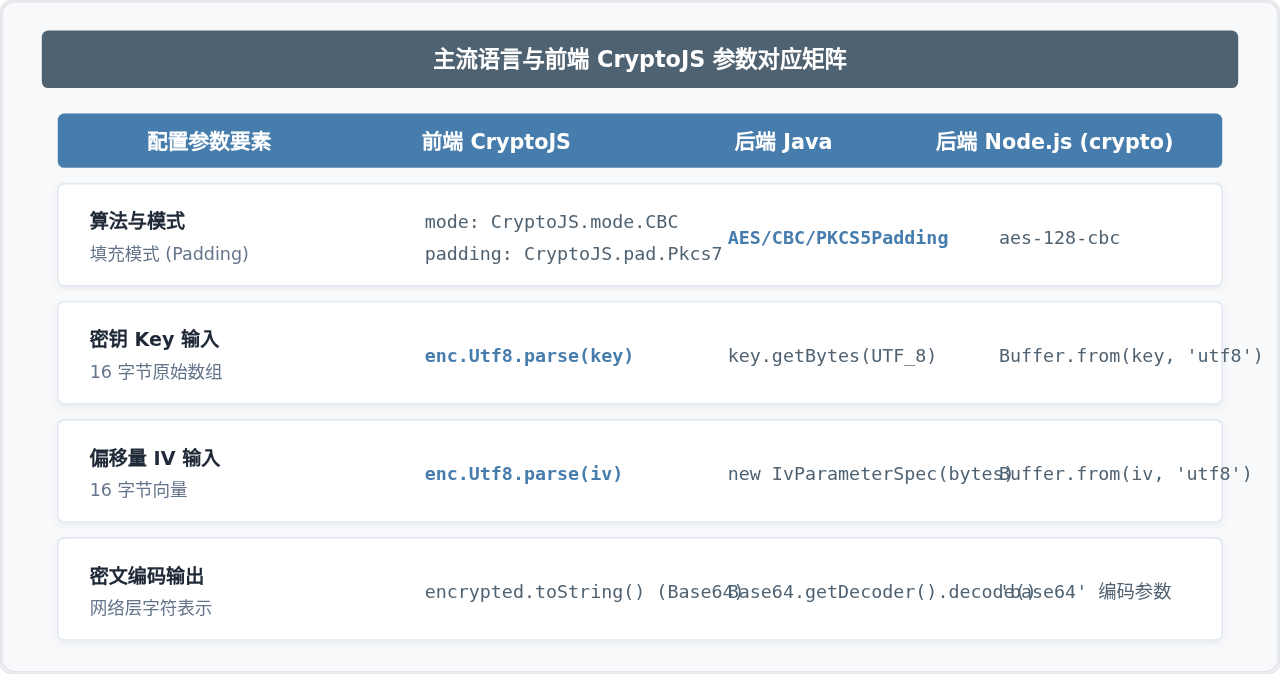
为确保加解密一致性,推荐使用工业界最成熟的 AES-128-CBC 或 AES-256-CBC,并统一使用 PKCS7 填充与 UTF-8 编码。以下是前后端完全对齐的生产级代码实现:
1. 前端代码实现(使用 CryptoJS)
// 前端加密函数 (依赖 crypto-js)
import CryptoJS from 'crypto-js';

// 双方约定:16 字节密钥与 16 字节 IV
const SECRET_KEY_STR = '1234567890123456';
const SECRET_IV_STR  = '6543210987654321';

export function encryptAES(plainText) {
    // 关键点 1:必须使用 Utf8.parse 显式转换为 WordArray 字节对象
    const key = CryptoJS.enc.Utf8.parse(SECRET_KEY_STR);
    const iv  = CryptoJS.enc.Utf8.parse(SECRET_IV_STR);

    // 关键点 2:指定 mode 为 CBC,padding 为 Pkcs7
    const encrypted = CryptoJS.AES.encrypt(plainText, key, {
        iv: iv,
        mode: CryptoJS.mode.CBC,
        padding: CryptoJS.pad.Pkcs7
    });

    // 关键点 3:输出标准的 Base64 字符串
    return encrypted.toString();
}

// 示例运行
const cipher = encryptAES("测试中文字符串123");
console.log("密文结果:", cipher);
2. 后端 Java 代码实现(Spring Boot / JDK 标准库)
import javax.crypto.Cipher;
import javax.crypto.spec.IvParameterSpec;
import javax.crypto.spec.SecretKeySpec;
import java.nio.charset.StandardCharsets;
import java.util.Base64;

public class AesUtil {
    private static final String KEY = "1234567890123456";
    private static final String IV  = "6543210987654321";

    public static String decryptAES(String base64CipherText) throws Exception {
        // 关键点 1:Base64 解码,还原原始密文字节流
        byte[] cipherBytes = Base64.getDecoder().decode(base64CipherText);

        // 关键点 2:统一 UTF-8 字节转换 Key 和 IV
        SecretKeySpec keySpec = new SecretKeySpec(KEY.getBytes(StandardCharsets.UTF_8), "AES");
        IvParameterSpec ivSpec = new IvParameterSpec(IV.getBytes(StandardCharsets.UTF_8));

        // 关键点 3:Java 的 AES/CBC/PKCS5Padding 等同于标准 PKCS7Padding
        Cipher cipher = Cipher.getInstance("AES/CBC/PKCS5Padding");
        cipher.init(Cipher.DECRYPT_MODE, keySpec, ivSpec);

        byte[] decryptedBytes = cipher.doFinal(cipherBytes);

        // 关键点 4:明文字节按 UTF-8 转字符串
        return new String(decryptedBytes, StandardCharsets.UTF_8);
    }
}
3. 后端 Node.js 代码实现(官方原生 crypto 模块)
const crypto = require('crypto');

const KEY = '1234567890123456';
const IV  = '6543210987654321';

function decryptAES(base64CipherText) {
    // 关键点:使用 aes-128-cbc 算法
    const decipher = crypto.createDecipheriv(
        'aes-128-cbc',
        Buffer.from(KEY, 'utf8'),
        Buffer.from(IV, 'utf8')
    );
    // Node.js crypto 默认开启 PKCS7 padding (setAutoPadding(true))
    let decrypted = decipher.update(base64CipherText, 'base64', 'utf8');
    decrypted += decipher.final('utf8');
    return decrypted;
}
RSA 非对称加密场景的常见不匹配原因
如果业务采用的是“前端 RSA 公钥加密,后端 RSA 私钥解密”,不匹配的成因通常更为集中:
- 公钥格式不兼容(PKCS#1 vs PKCS#8):前端常见的
jsencrypt库通常要求 PKCS#1 标准的 PEM 格式(带-----BEGIN RSA PUBLIC KEY-----),而后端 Java 原生的KeyFactory.getInstance("RSA")默认只支持X.509 / PKCS#8(带-----BEGIN PUBLIC KEY-----)。两端密钥互换时需确认格式头或进行转换。 - 填充模式差异(PKCS1Padding vs OAEP):前端 JS 库默认多使用
RSA/ECB/PKCS1Padding。若后端配置了现代安全性更高的RSA/ECB/OAEPWithSHA-256AndMGF1Padding,会导致解密报错。两端必须指定同一种填充机制。 - 单次加密长度超限:RSA 算法不能直接加密任意长度的文本。对于 2048 位的密钥(256 字节),在 PKCS#1 填充下,单次最大加密明文长度为
256 - 11 = 245 字节。超出长度时必须分段加密、分段解密后再拼装。若未分段直接加密长文本,前端会截断或直接报错。
如何验证问题已经彻底解决
完成参数调整后,按以下三道防线执行闭环验证,确保系统在线上高并发及边界字符下稳定工作:
- 固定测试向量验证:使用固定短语
"test-hello-world"、全英文、全数字、全中文(如"中文字符与Emoji表情符号🔒")分别测试。若中文出现异常而英文正常,则能精准锁定是 UTF-8 字节编码或截断问题。 - 多块临界长度测试:构造明文长度正好为 15 字节、16 字节、17 字节、31 字节、32 字节的边界数据。这能直接检验 PKCS#7 填充逻辑在刚好填满一个分组时是否正确补入整整 16 个
0x10字节并被后端正常剥离。 - 特殊网络字符传递测试:在密文中包含
+、/、=符号,通过真实的 HTTP 请求调用接口,确认传输通道未引入反序列化或 URL 转义破损。
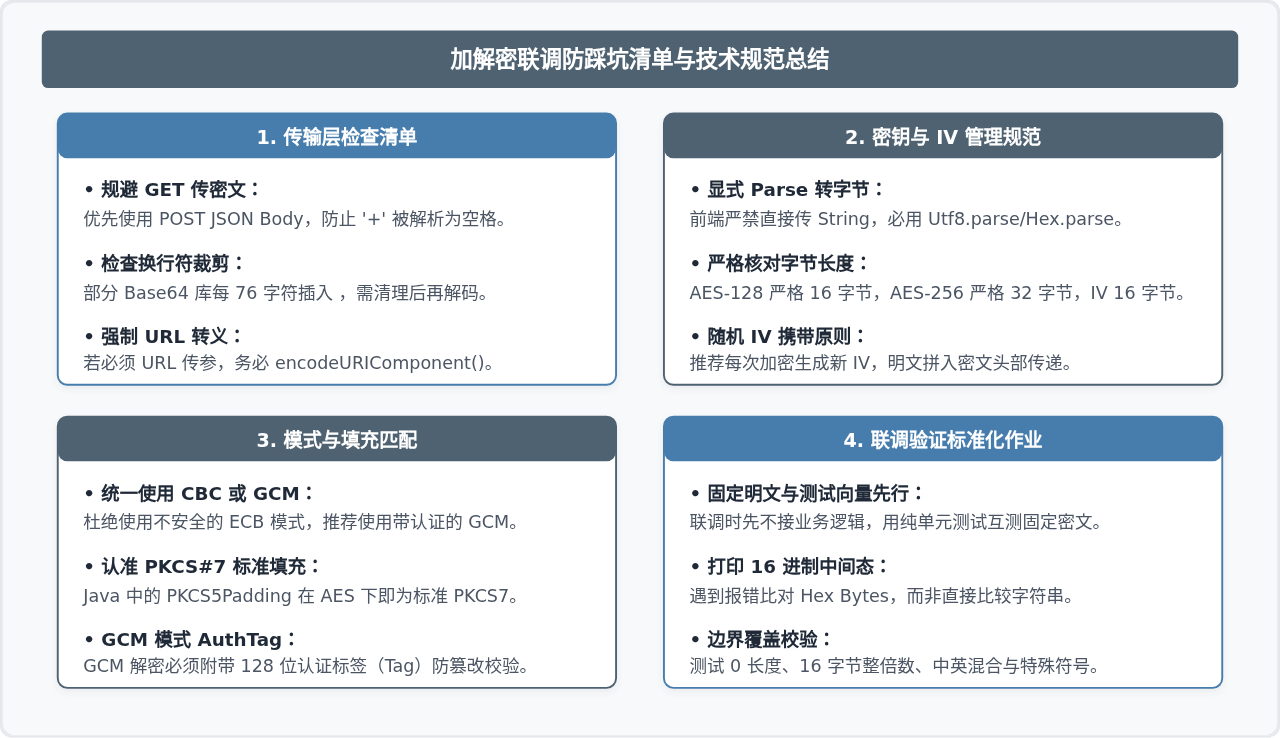
前后端加解密联调的核心在于“对齐协议与消除隐式默认行为”。在业务开发中,应将算法名称(如 AES-128-CBC)、填充规则(PKCS#7)、Key/IV 字符集(UTF-8)、传输编码(Base64)写入架构规范接口文档,并在两端封装统一的加解密工具类,避免因各库默认值差异引发线上故障。
JS中toLocaleString与Intl.DateTimeFormat格式化日期的用法区别
2026-11-19 21:56:17
JS与Java后端AES加解密结果不一致怎么解决
2026-11-19 15:45:16
提升JS二维码识别率:Canvas图像预处理与解码参数优化
2026-11-19 08:25:44
JavaScript个人网站怎么优化首屏加载速度
2026-11-18 17:27:45
主流JS混淆工具对比:javascript-obfuscator与Terser
2026-11-18 16:33:08







