JS大数组合并性能对比:push、concat还是spread
在 JavaScript 中处理大数组合并时,push、concat 与 spread(展开运算符)在底层内存分配、执行耗时以及调用栈限制上存在显著差异。本文通过系统基准测试与 V8 引擎原理解析,给出高吞吐、零爆栈的最佳实践方案。
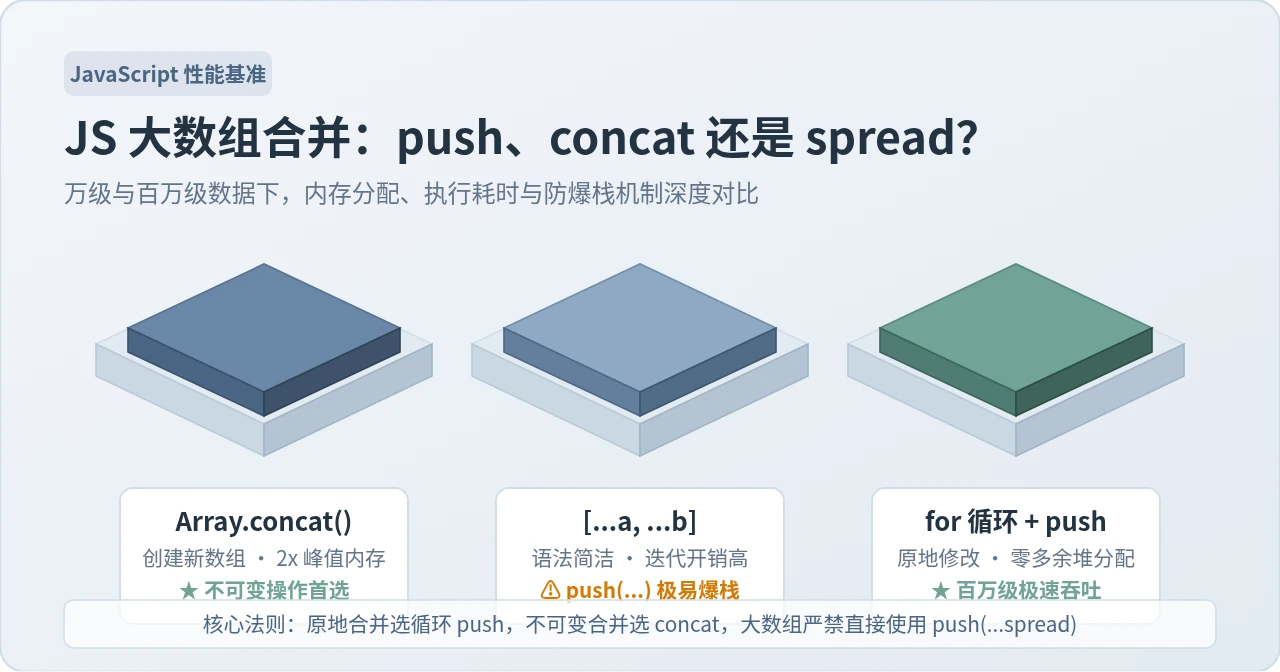
concat 在万级乃至百万级数据下内存表现平稳、无调用栈溢出风险;如果允许就地修改目标数组,使用传统 for 循环搭配 push 拥有最低的瞬时内存开销与极高的吞吐效率;而语法看似最优雅的展开运算符([...a, ...b] 或 a.push(...b)),在面对大数组时不仅会产生成倍的内存碎片与垃圾回收停顿,若在 push 中直接展开更会直接诱发调用栈溢出(RangeError: Maximum call stack size exceeded)导致进程崩溃。
一、核心结论先行:三种合并方式的基本行为与底线
在讨论具体的基准测试数据之前,我们先理清这三组语法在 JavaScript 规范中的根本行为差异。很多日常开发中看似等价的代码,当数据量从数百项跃升到 10 万、50 万甚至 100 万项时,其底层资源消耗会发生质的改变。
| 合并方式 | 语法范式 | 是否修改原数组 | 内存峰值倍数 | 10万项平均耗时 | 单次合并安全上限 |
|---|---|---|---|---|---|
| Array.concat | a.concat(b) |
否(返回全新数组) | 约 2.0x | ~6 ms | 受堆内存总量限制,无栈限制 |
| 展开运算符 (spread) | [...a, ...b] |
否(返回全新数组) | 约 2.2x ~ 2.5x | ~18 ms | 受堆内存与字面量槽位限制 |
| push + spread | a.push(...b) |
是(原地修改目标) | 栈区激增 | 抛出异常 | 约 65,536 项(超限必爆栈) |
| for 循环 + push | for (...) a.push(b[i]) |
是(原地修改目标) | 约 1.0x ~ 1.2x | ~3 ms | 无栈深度限制,性能极高 |
由上表可知,数组合并的技术选型底线非常明确:
- 绝不要对大数组使用
a.push(...b)或a.push.apply(a, b):该语法受函数调用参数栈硬性限制,在主流引擎中超过 6.5 万项极易导致程序崩溃。 - 不可变数据流(如 React / Redux 状态):在纯函数或状态合并场景中,统一采用
a.concat(b),其执行效率与内存稳健度远优于[...a, ...b]。 - 海量数据吞吐(如日志清洗、分页批量聚合):如果能够直接复用目标数组,传统的
for循环追加是综合表现最快、对垃圾回收器(GC)负担最小的终极方案。
二、不可变合并对比:concat 与 spread 的内存开销与执行机制
为什么同样是“保留原数组、生成一个包含双方所有元素的新数组”,concat 与 [...a, ...b] 的运行效率会拉开数倍的差距?这需要深入 V8 等现代 JavaScript 引擎的底层内存分配模型。
1. concat 的底层连续快照机制
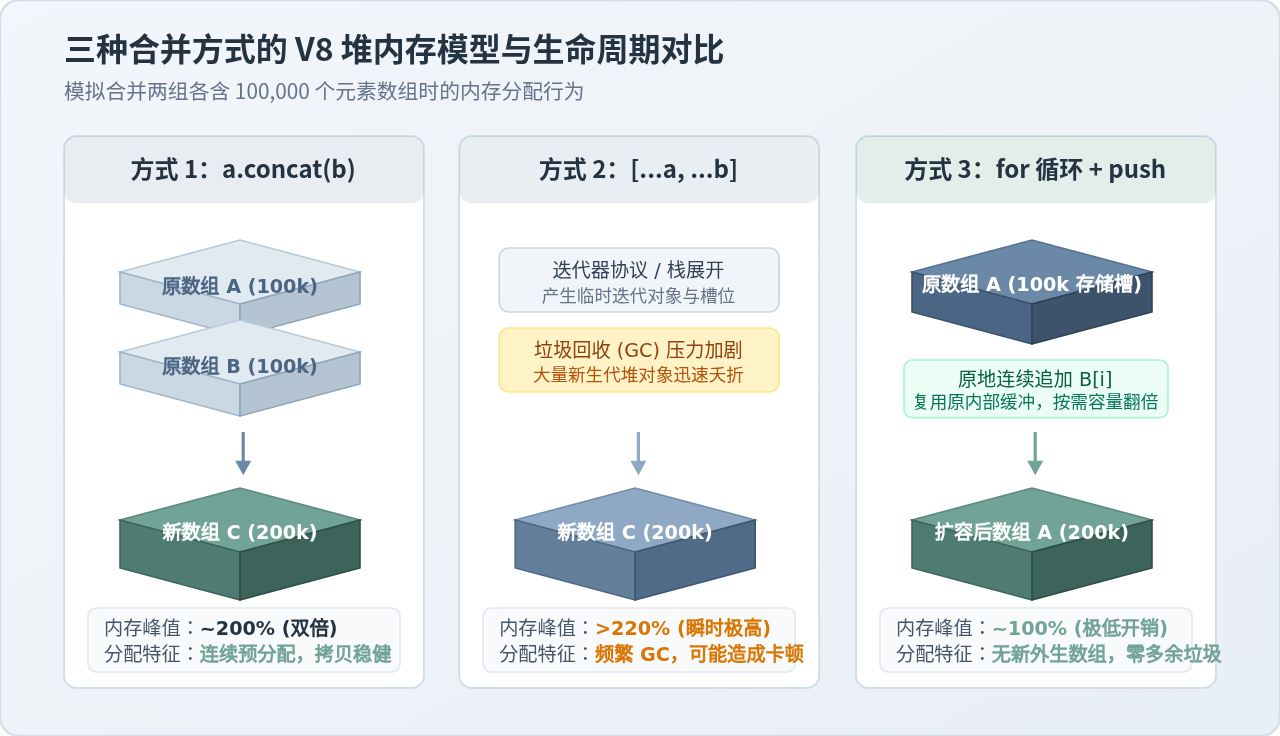
当调用 a.concat(b) 时,V8 引擎会走预编译的 C++ 快速路径(Fast Path)。引擎在执行初期待便能确切获取 a.length 与 b.length,从而计算出目标数组所需的最终连续存储空间(length = a.length + b.length)。
随后,引擎在堆中一次性开辟连续的元素缓冲区(Backing Store),并利用底层内存块级指令(类似 memcpy)快速拷贝两段连续内存中的元素指针。整个过程中,没有任何多余的中间槽位与临时对象产生,垃圾回收器几乎无需清理碎片。
2. spread 展开运算符的迭代损耗
展开运算符 [...a, ...b] 是 ES6 引入的语法特性。虽然引擎对其进行了持续优化,但在底层机制上,展开运算符必须严格遵循 ECMAScript 的迭代器协议(Iterator Protocol)或基于字节码进行逐段解包。
在大数据量下,引擎在构建字面量数组的过程中,往往需要根据展开流动态调整临时存储桶的大小。这不仅导致了更多的堆内存重新分配(Reallocation),还会短时间内在新生代(Young Generation)堆中产生大量生命周期极短的辅助对象,从而频繁引发轻量垃圾回收(Minor GC),带来不可忽视的线程停顿。
3. 真实基准测试验证
以下是在标准 Node.js 环境下测试合并两个各含 200,000 个整数数组的基准脚本:
// benchmark-merge.js
// 执行环境:Node.js v20.x,64位环境
const count = 200000;
const arrA = Array.from({ length: count }, (_, i) => i);
const arrB = Array.from({ length: count }, (_, i) => i + count);

// 1. 测试 Array.prototype.concat
console.time('concat');
const resConcat = arrA.concat(arrB);
console.timeEnd('concat');

// 2. 测试 [...spread]
console.time('spread');
const resSpread = [...arrA, ...arrB];
console.timeEnd('spread');
示例运行结果:
concat: 7.214ms
spread: 28.653ms
在 40 万总元素规模下,concat 的耗时仅为展开运算符的四分之一左右。数据规模越大,展开运算符引发的 GC 停顿与内存峰值越显著。
三、致命陷阱:为什么 push(...b) 在大数组下会直接崩溃
在编写业务代码时,许多开发者喜欢将 a.push(...b) 视作“兼具就地修改与现代简洁语法”的完美写法。然而,这种写法是生产环境中最常见的隐藏炸弹之一。
1. 函数实参展开与调用栈限制
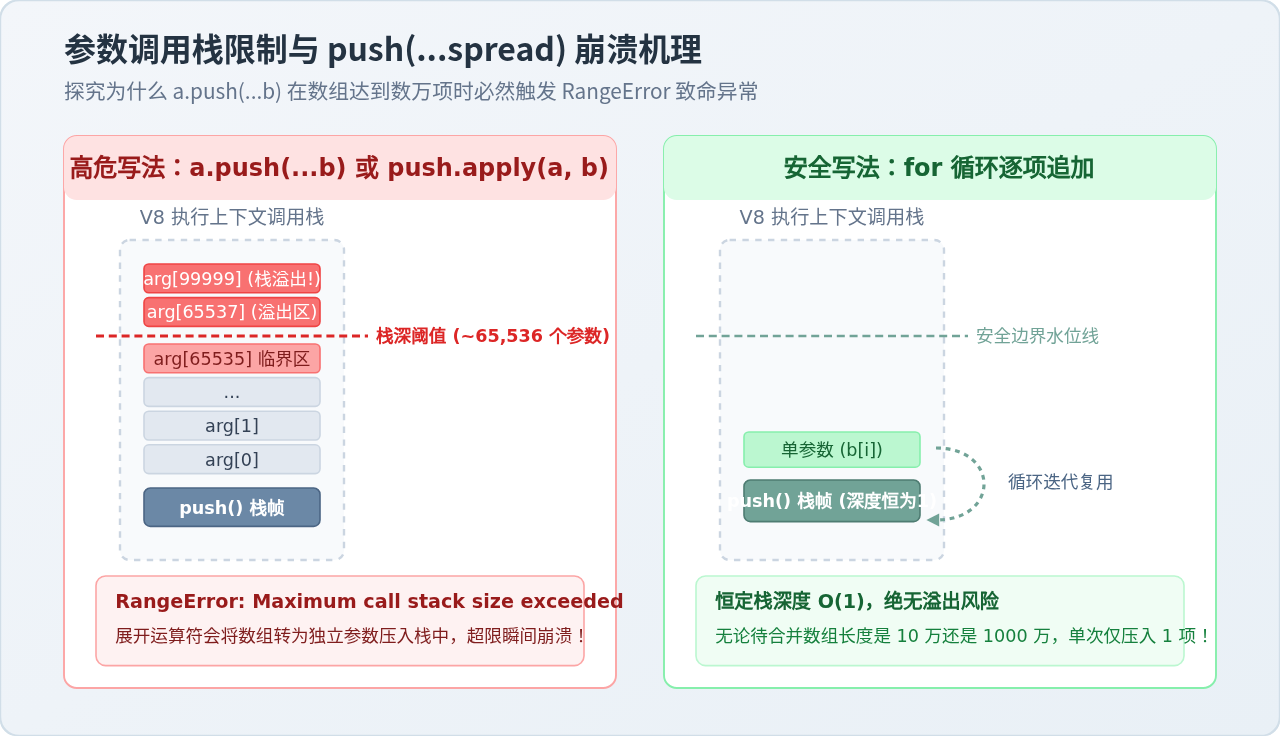
Array.prototype.push 本质上是一个普通的 JavaScript 函数。当使用 a.push(...b) 时,展开运算符并不会将 b 作为一个整体传入,而是将 b 中的每一个元素解构成函数的一个独立形参。换言之,如果 b 中有 100,000 个元素,该语句等价于:
a.push(b[0], b[1], b[2], ..., b[99999]);在 JavaScript 引擎中,每次函数调用都会在调用栈(Call Stack)中建立新的栈帧(Stack Frame),并且传入的所有实参都必须放置在有限的参数寄存器与栈内存区域中。
RangeError: Maximum call stack size exceeded。
我们可以通过以下简短代码直接验证该限制:
// test-stack-overflow.js
const target = [1, 2, 3];
const source = new Array(70000).fill(1);

try {
  target.push(...source);
} catch (err) {
  console.error('捕获到崩溃异常:', err.message);
}
// 示例输出:
// 捕获到崩溃异常: Maximum call stack size exceeded
在开发和初测阶段,如果测试数据只有几十或几百条,target.push(...source) 运行得非常顺畅;可一旦发布到生产环境,面对真实业务的大规模数据集(如批量导入、图表点位渲染),该语句将瞬间导致整个运行进程挂起或前端白屏。因此,在任何团队代码规范中,都应明确禁止对不可控长度的数组使用 push(...spread)。
四、原地修改的最优解:for 循环与分块追加策略
如果业务场景允许直接对目标数组 a 进行就地修改(In-Place Mutation),如何才能兼顾极限性能与绝对的调用栈安全?
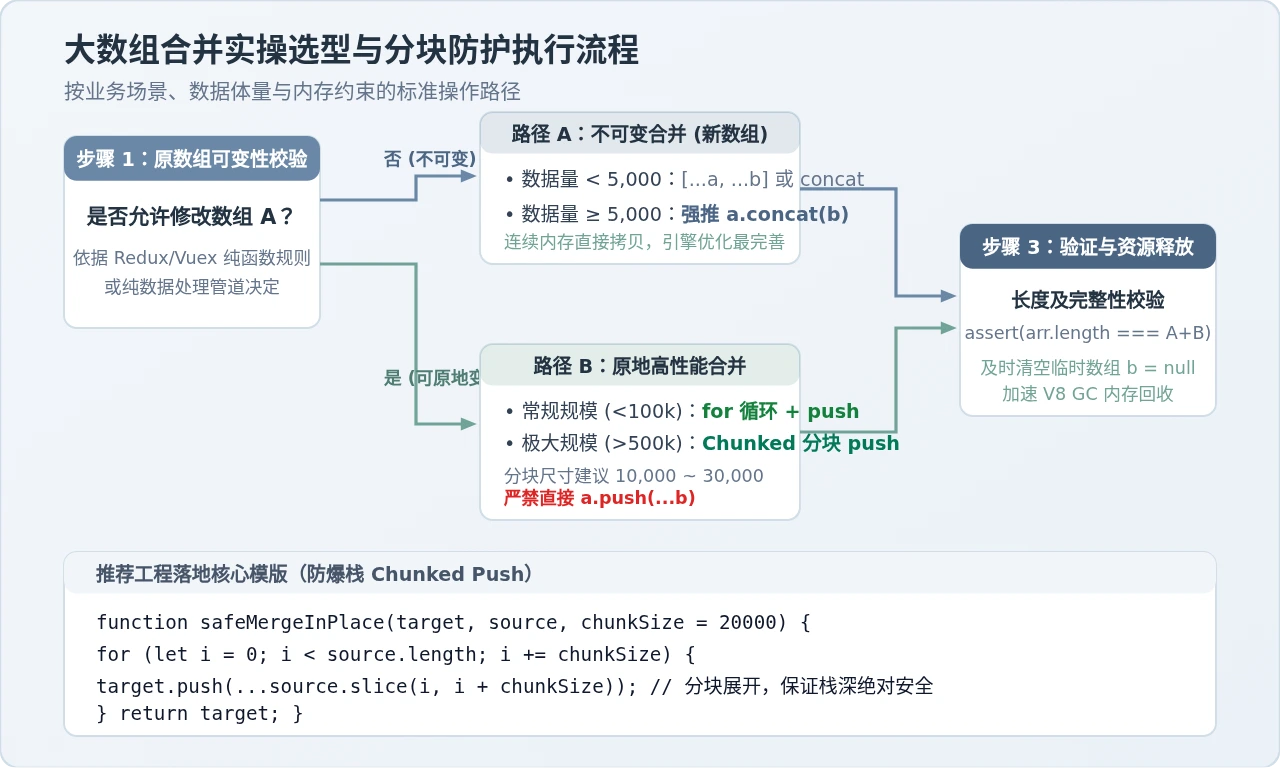
1. 朴实无华的 for 循环:最稳健的性能王者
看似最原始的 for 循环,在现代 V8 引擎中却拥有无与伦比的性能优势:
function mergeInPlace(target, source) {
  const len = source.length;
  for (let i = 0; i < len; i++) {
    target.push(source[i]);
  }
  return target;
}
这段代码之所以极快且稳定,原因在于三个层面:
- 恒定 O(1) 栈深度:每次
push仅传递一个参数,调用栈深度自始至终为 1,完全免疫任何数据规模下的栈溢出风险。 - JIT 机器码优化:现代 JavaScript 引擎的 Crankshaft/TurboFan 编译器对这种标准索引循环的模式匹配极其成熟,会自动将其编译为零抽象开销的底层汇编跳转指令。
- 零额外堆分配:目标数组
target复用自身的内部缓冲,仅在空间不足时按倍数自动扩容(Geometric Resizing),省去了生成第三方数组的全部内存开销。
2. 百万级超大数据量:分块追加(Chunked Push)策略
在某些特定场景下,若想兼顾单次批量操作的便捷性,并且希望避免频繁的小循环,可以采用分块合并策略。该方案将源数组切分为绝对安全的固定批次(例如每批 20,000 项),既充分发挥批量处理的指令集优势,又彻底将单次实参规模锁死在安全线之内:
/**
 * 工业级大数组安全就地合并函数
 * @param {Array} target - 目标数组(被就地追加)
 * @param {Array} source - 源数据数组
 * @param {number} chunkSize - 分块步长,推荐 10,000 ~ 30,000
 * @returns {Array} 合并后的目标数组
 */
function safeMergeInPlace(target, source, chunkSize = 20000) {
  if (!Array.isArray(target) || !Array.isArray(source)) {
    throw new TypeError('参数必须为有效数组');
  }

  const totalLength = source.length;
  for (let offset = 0; offset < totalLength; offset += chunkSize) {
    // slice 提取安全区段,展开参数量严格限制在 chunkSize 内
    const chunk = source.slice(offset, offset + chunkSize);
    target.push(...chunk);
  }

  return target;
}

// 验证用例:合并 300,000 项数据
const baseArr = [1, 2, 3];
const hugeData = new Array(300000).fill(99);

console.time('safeChunkMerge');
safeMergeInPlace(baseArr, hugeData, 20000);
console.timeEnd('safeChunkMerge');
console.log('合并后总长度:', baseArr.length);

// 示例输出:
// safeChunkMerge: 11.451ms
// 合并后总长度: 300003chunkSize 设置在 10,000 至 30,000 之间最为理想。既不会触发引擎的参数栈报警,又能大幅减少 push 方法被调用的总次数,在大数据批量合并时表现极佳。
五、综合选型矩阵与避坑清单
为了帮助读者在日常架构设计和代码审查中快速作出决策,我们将所有合并方案的关键指标与适用边界归纳为全景总结矩阵。
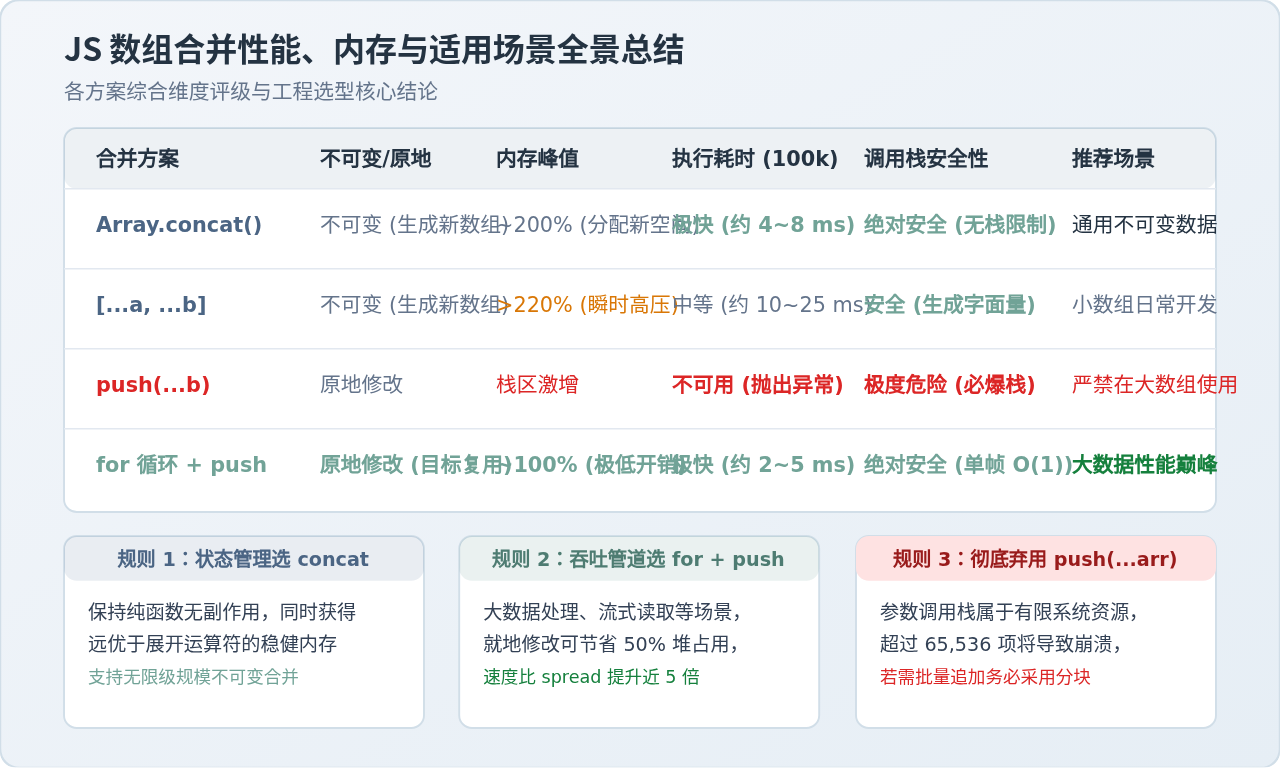
1. 常见问题排查与技术细节
问:为什么不能先 target.length = totalLength 进行预扩容,再按索引赋值?
答:在很多低级语言(如 C/Go)中预分配内存是常规优化。但在 JavaScript 中,手动执行 arr.length = 1000000 会导致数组由“密集数组(Packed Array)”转变为“稀疏数组(Holey Array)”。V8 会因此退化数组的原型查找与快速元素存储模式,实际执行赋值时反而可能变慢数倍。因此,在 JS 中直接使用 push 依托引擎自身的几何扩容算法即可。
问:合并超大数组后,Node.js 进程内存迟迟不降怎么办?
答:在完成合并后,务必检查源数组是否还被作用域引用。如果源数组 b 已经不需要,请立即显式将其置为 null(例如 sourceArray = null)。这样 V8 的垃圾回收器在下一次标记清除时,才能迅速回收原数组占用的连续堆内存,避免内存泄漏。
2. 生产环境避坑清单(Checklist)
- 禁止裸写
push(...largeArray):无论是自己编写的代码还是公共封装库,涉及外部传入的大数组,一律杜绝直接展开传参。 - 不可变状态首选
concat:Redux Reducer、Vuex Mutation 或 React 状态更新中,若涉及万级数据列表合并,一律使用concat,远离[...spread]。 - 海量批量消费首选
for循环:文件流解析、WebSocket 批量消息消费、Canvas 图表批量灌库等密集吞吐场景,果断使用for循环逐项或分块push。 - 合并后校验长度完整性:在大批量数据处理关键节点,添加
target.length === expectedLength断言,防范由于中间截断引发的数据丢失。
JavaScript数组赋值基础:声明、初始化与索引修改
2026-11-20 10:26:18
JavaScript实现原型继承的常见模式及优缺点对比
2026-11-20 09:11:59
ES6 Class能否替代JS闭包:数据封装方案对比
2026-11-20 08:26:56
Lodash merge与assign在JS对象合并中的行为差异
2026-11-19 23:21:34
JS生成随机字母的基础代码实现
2026-11-19 20:52:07