

为什么JS获取兄弟节点会返回文本节点或null
深入解析在JavaScript中获取兄弟节点时返回文本节点或null的根本原因,系统对比Node与Element两套遍历接口,并给出清晰的安全排查与防御式编程方案。
#text)是因为使用了广义节点属性 previousSibling 或 nextSibling,浏览器会将 HTML 标签之间的回车换行与缩进空格解析为文本节点;而返回 null 则是因为当前节点已处于同级排列的首尾边界,或者属于未挂载至 DOM 树中的游离节点。只要理解底层 DOM 树的构造规律并选用针对元素的专用 API,就能准确规避这两种意外。
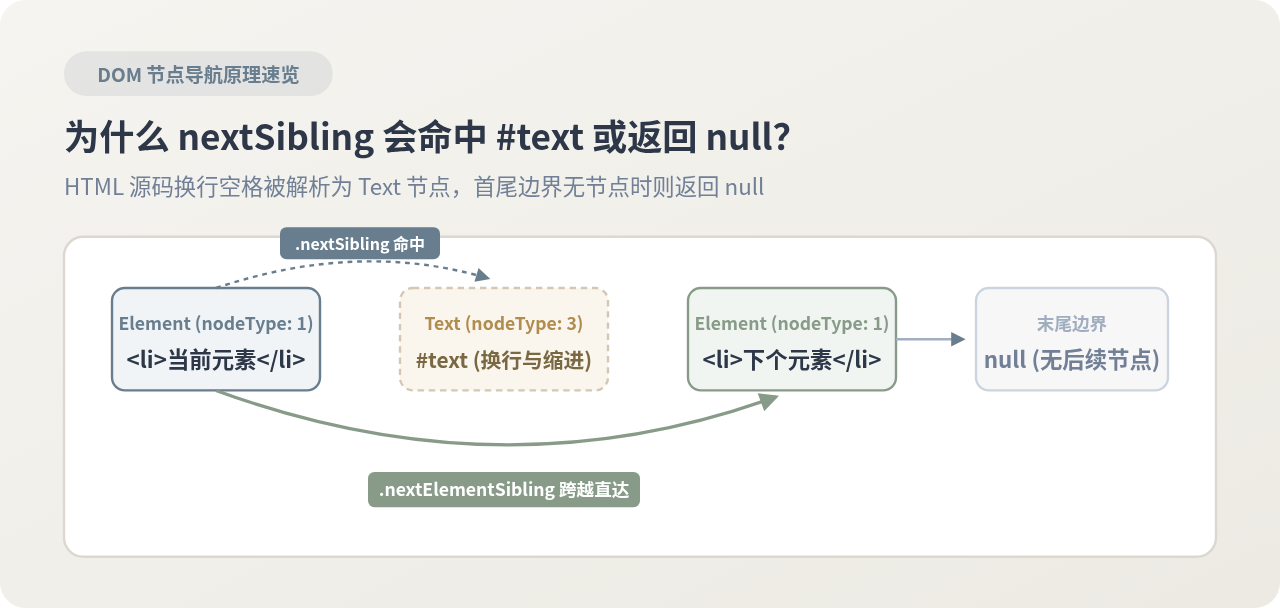
一、为什么会返回文本节点:不可见的空白符与 DOM 树解析规则
初学 DOM 操作时,开发者最常编写的 HTML 结构往往具有清晰的缩进和换行。例如下面这段常见的无序列表代码:
<ul>
  <li id="item1">第一项</li>
  <li id="item2">第二项</li>
</ul>
直觉上,#item1 的“下一个兄弟”理应是 #item2。但如果在 JavaScript 中执行以下代码:
const item1 = document.getElementById('item1');
console.log(item1.nextSibling);
控制台输出的却往往是一个 #text 对象,展开其内容会发现是 "
"。为什么浏览器没有直接返回下一个 <li> 标签?
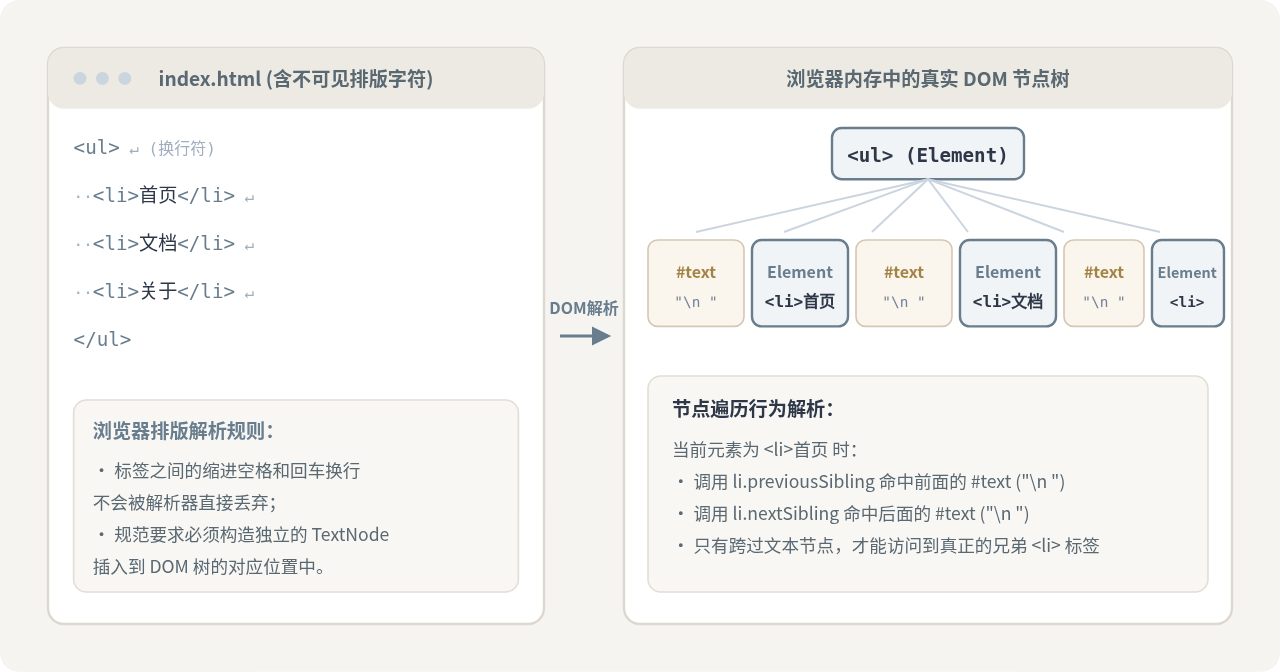
根本原因在于浏览器的 HTML 解析规范。在 DOM 规范中,页面所有的内容都是由不同类型的 Node 节点构成的:普通的 HTML 标签是元素节点(nodeType: 1),而标签之间出现的纯文字、空格、制表符(Tab)和换行符,全部都会被解析为文本节点(TextNode,nodeType: 3)。
在上述 HTML 源码中,<li id="item1"> 结束标签闭合后,我们敲击了回车键换行,并在新的一行敲下了两个空格以实现缩进。这段不可见的字符序列 "
" 在浏览器构建 DOM 树时,被忠实地转化为了一个文本节点,并插入在两个 <li> 元素之间。由于 nextSibling 是 Node 接口上的属性,它的职责是严格返回在 DOM 树中相邻的下一个“节点”(无论类型),因此它命中的自然就是紧挨着的空白文本节点。
二、两套遍历体系的差异:Node 接口与 Element 接口
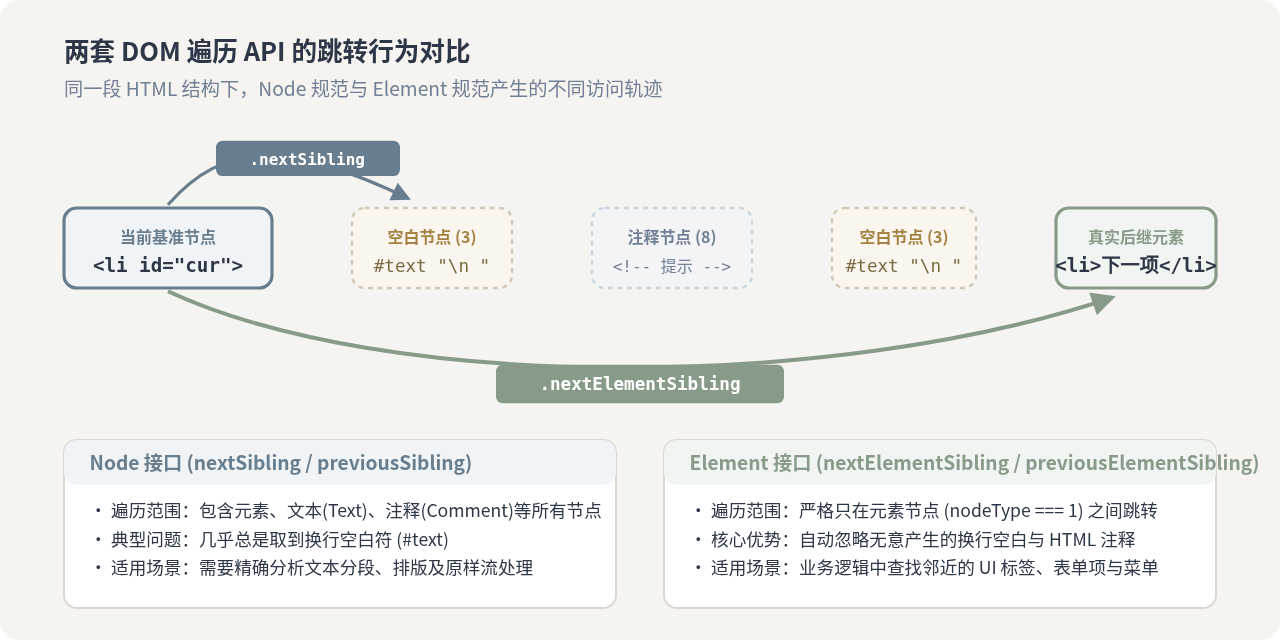
很多开发者容易混淆“节点(Node)”与“元素(Element)”的概念。在 W3C DOM 标准中,Element 继承自 Node,即所有的元素都是节点,但节点并不只有元素,它还涵盖了文本节点、注释节点(Comment)以及文档片段等。
为了在不同粒度下操作 DOM,现代 DOM 规范分别提供了两套导航属性:
| 导航维度 | Node 级属性(广义节点) | Element 级属性(仅 HTML 元素) |
|---|---|---|
| 向后查找兄弟 | node.nextSibling |
element.nextElementSibling |
| 向前查找兄弟 | node.previousSibling |
element.previousElementSibling |
| 遍历范围 | 包含元素、文本、注释、空白符 | 严格仅限 nodeType === 1 的 HTML 标签 |
| 典型返回值 | 非常容易返回 #text 或 #comment |
直接返回相邻的 HTML 元素标签或 null |
如果编写 JavaScript 业务逻辑的初衷是查找“下一个标签”,那么使用 nextElementSibling 即可彻底避免拿到空白文本节点。它在遍历时会自动跳过一切空白字符与 HTML 注释,直达下一个合法的标签元素。
三、为什么会返回 null:边界条件与空状态判定
除了返回文本节点,兄弟节点查询返回 null 也是高频出现的现象。无论是 nextSibling 还是 nextElementSibling,当出现以下两种情况时,均会按规范返回 null:
-
到达了兄弟排列的边界:
当一个元素是其父容器内的第一个子元素时,执行
previousElementSibling前面已无任何同级元素,因此返回null;同理,当元素是父容器内的最后一个子元素时,执行nextElementSibling后面没有后继元素,也会返回null。 -
节点尚未插入 DOM 树(游离节点):
如果通过
document.createElement('div')新建了一个元素,但在尚未将其appendChild或append挂载到具体父节点之前,它的parentNode为null,此时读取其任何兄弟属性也都会返回null。
null 本身并不是程序报错,而是浏览器在明确告知“当前方向上已经没有更多兄弟”。程序出现崩溃往往是因为开发者假设兄弟节点一定存在,直接使用了链式点语法,例如 el.nextElementSibling.classList.add('active')。当 nextElementSibling 为 null 时,访问 null.classList 便会抛出致命的 TypeError: Cannot read properties of null。
四、兄弟节点安全获取与异常排查流程
在实际项目中检索兄弟节点,可以遵循清晰的排查与防护流程:先确定查询目的并选择对应 API,再对返回值实施非空断言或安全访问。
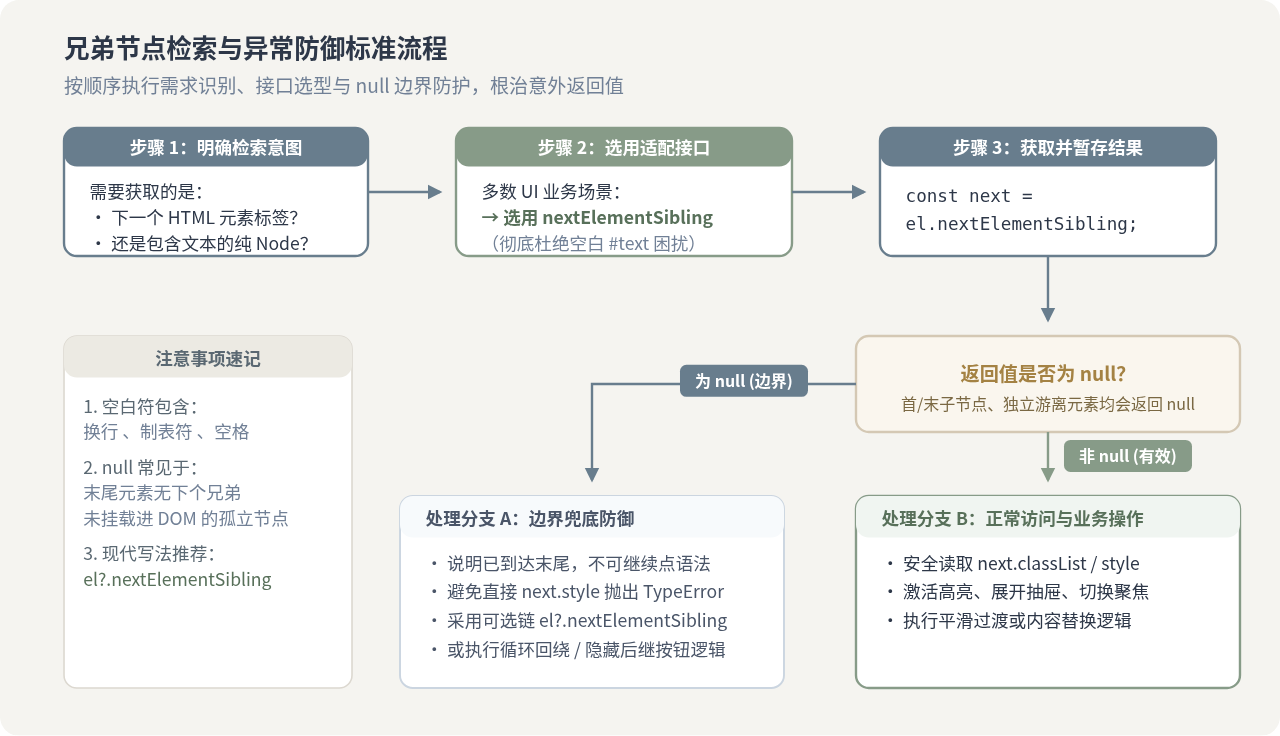
具体的操作步骤分为四步:
-
步骤 1:明确当前业务需求。
如果是做折叠菜单、选项卡切换、表单字段校验联动等 UI 交互,目标对象始终是页面中的标签元素,应当直接放弃
nextSibling,全量采用nextElementSibling。 -
步骤 2:对获取到的兄弟引用进行边界检查。
在访问其属性或样式之前,始终做判空处理,或使用现代 JavaScript 的可选链操作符(Optional Chaining
?.)。 -
步骤 3:定义边界状态的回退逻辑。
当拿到
null时,明确当前交互是需要循环回绕(如轮播图下一张跳到第一张),还是禁用按钮(如列表最后一项不可继续下移)。
五、实用代码示例与防御式编程
下面通过两组典型代码对比,演示易错写法与健壮写法的实际差异。
1. 脆弱写法(易踩文本节点与 null 崩溃)
// 错误示范:极易命中 #text,且末尾元素直接报错
function activateNextTab(currentTab) {
  const next = currentTab.nextSibling;
  // 如果存在换行符,next 是 #text,text 没有 classList 属性,直接报错
  next.classList.add('active');
}
2. 健壮写法(结合 Element API 与可选链)
// 推荐写法:跳过空白节点,且安全处理 null 边界
function activateNextTab(currentTab) {
  const nextElement = currentTab.nextElementSibling;

  if (!nextElement) {
    console.log('已到达末尾,当前无后续标签元素');
    return;
  }

  // 安全进行属性变更
  currentTab.classList.remove('active');
  nextElement.classList.add('active');
}
如果只需要读取下一个兄弟元素的文本内容或属性,利用现代 JavaScript 的可选链更为简短:
// 如果 nextElementSibling 为 null,返回 undefined 而不会中断执行
const nextTitle = currentTab.nextElementSibling?.textContent?.trim() ?? '无后续内容';
六、核心结论与选型全景速查
掌握兄弟节点检索的核心在于搞清楚“DOM 节点树中的实体类型”与“边界返回规则”。下方的全景图总结了导致这两种返回值的根本原因与对应的最佳实践方案:
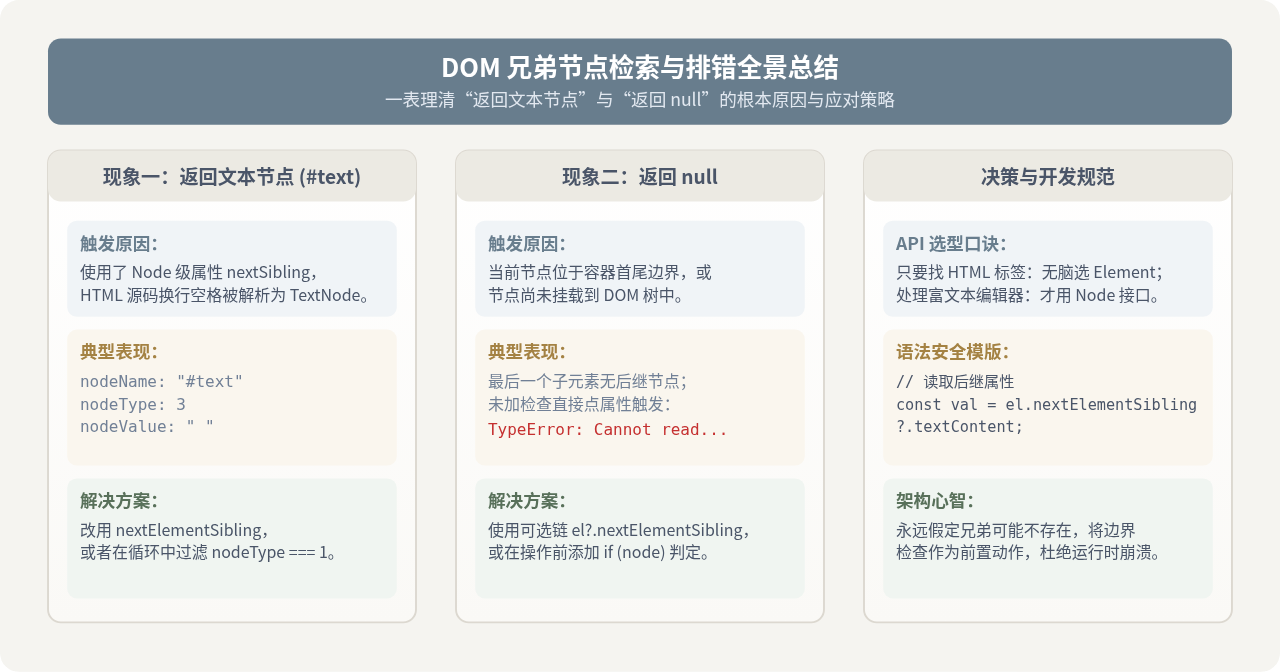
在实际编码中,只要牢记“绝大多数业务场景使用 nextElementSibling / previousElementSibling 代替 nextSibling / previousSibling”,就能从源头上消除文本节点的干扰;同时在操作节点前加上 null 检查或可选链,即可构建出稳定可靠的 DOM 操作逻辑。
JS中className与classList修改class的区别及最佳实践
2026-11-20 10:44:05
用JavaScript实现网页深色模式颜色切换
2026-11-19 23:24:07
JavaScript直接操作用户界面的常见方式有哪些
2026-11-19 21:23:34
怎么替代 JavaScript alert:构建自定义模态框组件
2026-11-19 19:55:43
JavaScript怎么计算设备真实物理像素分辨率
2026-11-19 18:40:54







